
Quantization چیست؟ آموزش کوانتیزهسازی مدلهای هوش مصنوعی با Python
Quantization چگونه حجم و حافظه موردنیاز مدل هوش مصنوعی را کاهش میدهد؟ در این آموزش، تفاوت ۴ و ۸ بیت، GGUF، bitsandbytes و QLoRAرا میشناسید و با کد عملی کیفیت و هزینه اجرای مدل را بررسی میکنید. عنوان متا:

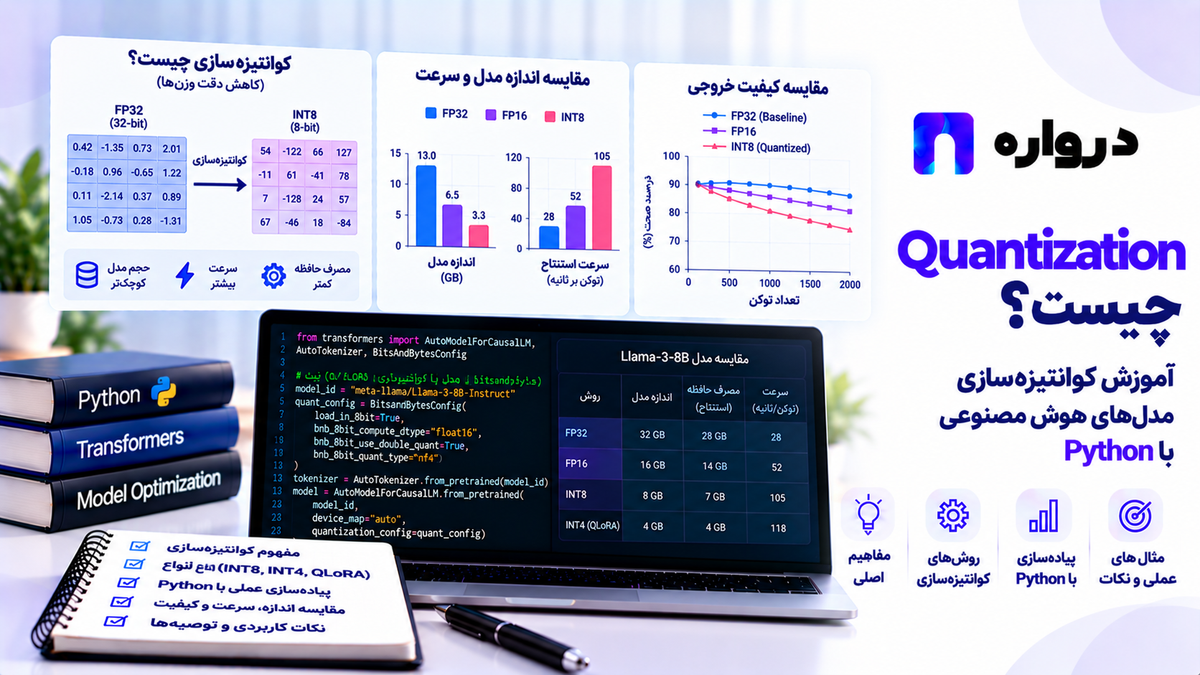
اجرای یک مدل بزرگ ممکن است به حافظهای بیش از ظرفیت دستگاه شما نیاز داشته باشد. حتی اگر مدل در حافظه جا بگیرد، هزینه نگهداری چند نسخه از آن و پردازش همزمان درخواستها میتواند بالا باشد.
Quantization یا کوانتیزهسازی یکی از روشهای کاهش هزینه اجرای مدل است. ایده اصلی این است که بعضی عددهای مورد استفاده مدل، مانند وزنها، با نمایش کمدقتتری ذخیره یا پردازش شوند. برای مثال، بهجای ذخیره برخی وزنها با دقت ۱۶ بیتی، از یک نمایش فشردهتر ۸ یا ۴ بیتی استفاده شود.
اما نتیجه را نباید فقط از روی تعداد بیت قضاوت کرد:
- اندازه فایل مدل ممکن است کاهش یابد.
- مصرف حافظه هنگام اجرا ممکن است کاهش یابد.
- سرعت ممکن است بهتر شود، تغییر نکند یا حتی در یک پیکربندی خاص کمتر شود.
- کیفیت پاسخ ممکن است تا حدی تغییر کند.
- حافظه موردنیاز برای اجزایی غیر از وزنها همچنان باقی میماند.
در این مقاله، روشهای رایج کوانتیزهسازی را توضیح میدهیم، با NumPy یک نمونه ساده از تبدیل وزنها را میسازیم و سپس مسیرهای عملی اجرای مدل ۴ و ۸ بیتی با bitsandbytes و فرمت GGUF را بررسی میکنیم.
Quantizationدر هوش مصنوعی یعنی چه؟
وزنهای یک شبکه عصبی معمولاً بهصورت عددهای اعشاری ذخیره میشوند. کوانتیزهسازی شیوه نمایش بخشی از این عددها را تغییر میدهد تا حافظه یا هزینه محاسباتی کمتری لازم باشد.
این تبدیل معمولاً تقریبی است. وقتی بازهای پیوسته از مقدارها با تعداد محدودتری کد عددی نمایش داده میشود، پس از بازسازی ممکن است مقدارها دقیقاً برابر مقدار اصلی نباشند.
هدف عملی این است که کاهش حافظه و هزینه اجرا به دست آید، در حالی که افت کیفیت برای کاربرد نهایی قابل قبول باقی بماند.
کوانتیزهسازی به یک روش واحد اشاره نمیکند. روشها از نظر موارد زیر تفاوت دارند:
- کدام بخش مدل فشرده میشود؟
- وزنها با چه دقتی ذخیره میشوند؟
- محاسبات با چه دقتی انجام میشوند؟
- مقیاس تبدیل برای کل مدل، هر لایه یا گروههای کوچکتر تعیین میشود؟
- تبدیل پس از آموزش انجام میشود یا هنگام آموزش در نظر گرفته شده است؟
- سختافزار و موتور اجرا از آن فرمت پشتیبانی میکنند یا خیر؟
وزن، Activation و KV Cache چه تفاوتی دارند؟
برای فهم نتیجه کوانتیزهسازی، باید منابع اصلی مصرف حافظه را جدا کنیم.
وزنهای مدل
وزنها پارامترهای آموختهشده مدل هستند. مدلهای بزرگ تعداد بسیار زیادی وزن دارند؛ بنابراین کاهش حافظه آنها میتواند اثر مهمی داشته باشد.
Activation
Activationها مقدارهای میانی محاسبهشده هنگام اجرای شبکه هستند. روشی که فقط وزنها را فشرده میکند، لزوماً حافظه همه مقدارهای میانی را به همان نسبت کاهش نمیدهد.
KV Cache
در بسیاری از مدلهای زبانی مولد، هنگام تولید متن اطلاعاتی از توکنهای پردازششده برای استفاده در مراحل بعدی نگهداری میشود. این حافظه با طول ورودی، طول پاسخ و تعداد درخواستهای همزمان مرتبط است.
بنابراین اگر یک روش Weight-only Quantization باشد، از کاهش حجم وزنها نباید نتیجه گرفت کل حافظه اجرای سرویس به همان نسبت کم میشود. حافظه KV Cache و سایر اجزا را جداگانه اندازه بگیرید.
تفاوت FP32، FP16، BF16، INT8 و ۴ بیت
| نمایش | برداشت کلی | نکته |
|---|---|---|
| FP32 | عدد اعشاری ۳۲ بیتی | دقت بیشتر و حافظه بالاتر برای وزنها |
| FP16 | عدد اعشاری ۱۶ بیتی | نمایش فشردهتر از FP32 |
| BF16 | عدد اعشاری ۱۶ بیتی با ویژگی عددی متفاوت | در سختافزار سازگار کاربرد دارد |
| INT8 | نمایش عددی ۸ بیتی در یک طرح کوانتیزهسازی | نیازمند مقیاس و روش محاسبه سازگار |
| ۴ بیت | خانوادهای از نمایشها و روشهای فشردهتر | کیفیت و سرعت بسیار وابسته به روش و موتور اجرا |
این جدول به معنای آن نیست که هر مدل «۴ بیتی» دقیقاً نصف یک مدل «۸ بیتی» روی دیسک جا میگیرد. مقیاسهای تبدیل، اطلاعات جانبی، لایههایی که با دقت بالاتر نگه داشته شدهاند و شیوه بستهبندی نیز فضا مصرف میکنند.
برای نمونه، مستندات ابزار کوانتیزهسازی llama.cpp نشان میدهد بعضی فرمتهای موسوم به ۴ بیتی در عمل بهطور میانگین بیش از چهار بیت برای هر وزن مصرف میکنند. GitHub
Weight-only Quantizationچیست؟
در Weight-only Quantization تمرکز اصلی بر فشردهسازی وزنهای مدل است. مقدارهای میانی ممکن است همچنان با دقت دیگری محاسبه شوند.
این روش برای مدلهایی که انتقال وزن از حافظه به پردازنده یا GPU بخش مهمی از محدودیت اجراست، میتواند ارزش بررسی داشته باشد. اما اثر واقعی آن به سختافزار، اندازه Batch، طول متن، موتور اجرا و نوع لایهها وابسته است.
مستندات torchao، از جمله پیکربندی Int8WeightOnlyConfig، نمونههایی برای اعمال کوانتیزهسازی فقط روی وزنها ارائه میکند. torchao 0.17 documentation
Post-Training Quantization یا PTQچیست؟
Post-Training Quantization یعنی ابتدا مدل با روش معمول آموزش داده شود و سپس برای اجرا به نمایش کمدقتتری تبدیل شود.
مزیت آن این است که در بعضی روشها نیازی به آموزش دوباره کامل مدل ندارید. بااینحال، ممکن است برای انتخاب پارامترهای تبدیل یا بررسی کیفیت به داده نماینده نیاز باشد.
روند عملی معمول:
- یک مدل مبنا با کیفیت مشخص انتخاب کنید.
- نسخه کوانتیزهشده بسازید.
- کیفیت دو نسخه را روی مجموعه ارزیابی یکسان مقایسه کنید.
- مصرف حافظه و زمان پاسخ را روی سختافزار مقصد بسنجید.
- تنها در صورت مناسب بودن هر دو نتیجه، نسخه جدید را وارد محصول کنید.
Quantization-Aware Training یا QATچیست؟
در Quantization-Aware Training، اثر دقت محدود در فرایند آموزش یا تنظیم مدل لحاظ میشود. هدف این است که مدل با شرایطی نزدیکتر به اجرای کمدقت سازگار شود.
این روش ممکن است زمانی ارزش بررسی داشته باشد که تبدیل پس از آموزش، افت کیفیت نامطلوبی ایجاد میکند. در مقابل، اجرای آن پیچیدهتر از یک تبدیل ساده پس از آموزش است و باید با ابزار و سختافزار هدف هماهنگ باشد.
مستندات torchao برای QAT جریانهای کاری و پیکربندیهای جداگانهای ارائه میکند. torchao 0.17 documentation
آیا کوانتیزهسازی همیشه مدل را سریعتر میکند؟
خیر. کاهش حافظه و افزایش سرعت دو نتیجه متفاوتاند.
برای مثال، سرعت ممکن است به این عوامل وابسته باشد:
- آیا سختافزار دستورهای مناسب برای محاسبات کمدقت دارد؟
- آیا موتور اجرا از فرمت انتخابی بهخوبی پشتیبانی میکند؟
- آیا وزنها هنگام اجرا مرتباً به دقت بالاتر تبدیل میشوند؟
- اندازه Batch چقدر است؟
- گلوگاه در انتقال وزنهاست یا در بخش دیگری از محاسبه؟
- متن ورودی و خروجی چقدر طولانیاند؟
- چند درخواست همزمان اجرا میشود؟
حتی در بنچمارکهای منتشرشده torchao نیز برتری سرعت میان پیکربندیهای کمدقت یکسان نیست. بنابراین نتیجه سختافزار یا مدل دیگر را به محیط خود تعمیم ندهید. torchao 0.17 documentation
آزمایش آموزشی: کوانتیزهسازی ۸ بیتی وزنها باNumPy
پیش از استفاده از ابزارهای مدل زبانی، یک مثال کوچک میسازیم تا مفهوم روشن شود.
در این مثال:
- یک آرایه از وزنهای اعشاری میسازیم.
- آنها را به کدهای ۸ بیتی تبدیل میکنیم.
- مقدار تقریبی وزنها را بازسازی میکنیم.
- اندازه داده و اختلاف عددی را مقایسه میکنیم.
این کد یک موتور استنتاج سریع برای مدل زبانی نیست. هدف آن نشاندادن اثر تبدیل بر ذخیرهسازی و خطای عددی است.
نصبNumPy
pip install numpyساخت وزنها و تبدیل اولیه
import numpy as np


rng = np.random.default_rng(
    42
)

weights = rng.normal(
    size=(
        1024,
        1024,
    )
).astype(
    np.float32
)

largest_absolute_value = (
    float(
        np.max(
            np.abs(
                weights
            )
        )
    )
)

scale = (
    largest_absolute_value
    / 127.0
    if largest_absolute_value
    > 0
    else 1.0
)

quantized = np.clip(
    np.rint(
        weights
        / scale
    ),
    -127,
    127,
).astype(
    np.int8
)

reconstructed = (
    quantized.astype(
        np.float32
    )
    * scale
)

mean_absolute_difference = (
    np.mean(
        np.abs(
            weights
            - reconstructed
        )
    )
)

print(
    "FP32 weight bytes:",
    weights.nbytes,
)

print(
    "INT8 codes + scale bytes:",
    quantized.nbytes
    + np.float32(
        scale
    ).nbytes,
)

print(
    "Mean absolute difference:",
    mean_absolute_difference,
)
در این آرایه آموزشی، خود کدهای ۸ بیتی حدود یکچهارم فضای وزنهای ۳۲ بیتی را میگیرند. اما این فقط اندازه همین آرایه است. اندازه یک مدل واقعی به ساختار فایل، مقدارهای جانبی و بخشهایی که کوانتیزه نشدهاند نیز وابسته است.
مقیاس مشترک یا مقیاس جداگانه؟
در مثال قبل برای تمام وزنها از یک مقیاس مشترک استفاده کردیم. اگر یک ردیف مقدارهای بزرگتری از ردیفهای دیگر داشته باشد، ممکن است این انتخاب دقت بازسازی برخی ردیفها را کاهش دهد.
اکنون برای هر ردیف یک مقیاس جداگانه میگیریم:
row_scales = ( np.max( np.abs( weights ), axis=1, keepdims=True, ) / 127.0)row_scales = np.where( row_scales == 0, 1.0, row_scales,)quantized_by_row = np.clip( np.rint( weights / row_scales ), -127, 127,).astype( np.int8)reconstructed_by_row = ( quantized_by_row.astype( np.float32 ) * row_scales)rowwise_difference = (در یک اجرای این مثال، مقیاس جداگانه برای هر ردیف، اختلاف میانگین بازسازی را کمتر کرد. در عوض باید مقیاسهای بیشتری ذخیره شود.
روشهای واقعی میتوانند از تبدیلهای پیشرفتهتر، گروهبندی وزنها و نگهداری بعضی بخشها با دقت بالاتر استفاده کنند. همچنین خطای بازسازی وزن معادل افت کیفیت پاسخ مدل نیست؛ کیفیت باید روی خروجی و وظیفه واقعی سنجیده شود.
کوانتیزهسازی ۸ بیتی مدل با Transformers وbitsandbytes
کتابخانه bitsandbytes در کنار Hugging Face Transformers امکان بارگذاری برخی مدلهای سازگار با تنظیمات ۸ یا ۴ بیتی را فراهم میکند. مستندات رسمی Transformers از BitsAndBytesConfig برای تعریف این تنظیمات استفاده میکند. Hugging Face
برای اجرای نمونه زیر به این موارد نیاز دارید:
- محیط و سختافزار سازگار با نسخههای نصبشده
- دسترسی به فایلهای یک مدل سازگار، بهصورت محلی یا از منبع مجاز
- حافظه کافی برای همان مدل و طول متن آزمایشی
نصب بستهها:
pip install torch transformers accelerate bitsandbytesشناسه یا مسیر مدل را مشخص کنید:
export MODEL_ID_OR_PATH="/path/to/your/compatible/model"بارگذاری ۸ بیتی:
import os

from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
)


model_id = os.environ[
    "MODEL_ID_OR_PATH"
]

tokenizer = (
    AutoTokenizer.from_pretrained(
        model_id
    )
)

int8_config = (
    BitsAndBytesConfig(
        load_in_8bit=True,
    )
)

model_8bit = (
    AutoModelForCausalLM
    .from_pretrained(
        model_id,
        quantization_config=(
            int8_config
        ),
        device_map="auto",
        dtype="auto",
    )
)

print(
    "Reported model footprint:",
    model_8bit
    .get_memory_footprint(),
)
پشتیبانی دقیق به معماری مدل، نسخه کتابخانهها و دستگاه اجرا بستگی دارد. همچنین اگر بخشی از مدل روی CPU قرار گیرد، همه وزنها الزاماً با همان دقت ۸ بیتی در حافظه CPU ذخیره نمیشوند؛ مستندات bitsandbytes رفتار Offload را جداگانه توضیح میدهد. Hugging Face
بارگذاری ۴ بیتی مدل
برای مدلی که با محیط شما سازگار است میتوان پیکربندی ۴ بیتی را آزمایش کرد:
import osimport torchfrom transformers import ( AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig,)if not torch.cuda.is_available(): raise RuntimeError( "This example requires " "a compatible CUDA GPU." )model_id = os.environ[ "MODEL_ID_OR_PATH"]tokenizer = ( AutoTokenizer.from_pretrained( model_id ))compute_dtype = ( torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16)four_bit_config = ( BitsAndBytesConfig(این مثال مدل را روی یک GPU قرار میدهد؛ باید تمام بخشهای لازم مدل در حافظه آن جا شوند. اگر مدل جا نمیشود، مدل کوچکتر یا راهبرد استقرار مناسب دیگری انتخاب کنید.
NF4 یکی از گزینههای پشتیبانیشده در bitsandbytes است که با پژوهش QLoRA ارتباط دارد. مستندات Hugging Face میان تنظیمات مورد استفاده برای آموزش و استنتاج تمایز میگذارد؛ بنابراین استفاده از یک تنظیم صرفاً به دلیل رایج بودن نام آن، جای مقایسه تجربی را نمیگیرد. Hugging Face
یک پیشبینی آزمایشی
پس از بارگذاری مدل سازگار:
prompt = ( "سه کاربرد عملی " "هوش مصنوعی در " "پشتیبانی مشتری را " "به فارسی نام ببر.")inputs = tokenizer( prompt, return_tensors="pt",).to( "cuda:0")with torch.inference_mode(): output_ids = ( model_4bit.generate( **inputs, max_new_tokens=80, do_sample=False, ) )print( tokenizer.decode( output_ids[0], skip_special_tokens=True, ))برای مدل گفتوگویی، ممکن است لازم باشد از قالب گفتوگوی مخصوص همان مدل استفاده کنید. یک Prompt خام برای همه معماریها روش ارزیابی مناسبی نیست.
اگر هدف مقایسه نسخه ۴ بیتی و نسخه پردقت همان مدل است، متن ورودی، قالب گفتوگو، تنظیمات تولید و نسخه داده را یکسان نگه دارید.
GGUF چیست و چه ارتباطی با Quantizationدارد؟
GGUF فرمتی برای نگهداری مدل و اطلاعات مرتبط با آن در ابزارهایی مانند llama.cpp است. فایل GGUF میتواند مدل را در دقتها و طرحهای کوانتیزهسازی مختلف نگه دارد.
بنابراین GGUFنام یک سطح دقت نیست. دو فایل GGUF ممکن است از نظر نوع نمایش وزنها، اندازه و کیفیت تفاوت داشته باشند.
مستندات llama.cpp بیان میکند این ابزار مدلهای مورد استفاده خود را در قالب GGUF میخواند. ابزار جداگانه llama-quantize نیز برای ساخت برخی نسخههای کوانتیزهشده از فایل ورودی مناسب ارائه شده است. GitHub
نمونه تبدیل یک مدل GGUF بهQ4_K_M
اگر فایل GGUF پردقت و سازگار را از قبل در اختیار دارید و نسخه مناسب llama.cpp را ساختهاید، نمونه دستور زیر یک فایل خروجی با تنظیم Q4_K_M تولید میکند:
./build/bin/llama-quantize \
  model-f16.gguf \
  model-Q4_K_M.gguf \
  Q4_K_M
دستور را برای هر فایل نامرتبط اجرا نکنید. معماری مدل، نسخه ابزار، فضای دیسک و حافظه لازم برای تبدیل باید بررسی شود. راهنمای رسمی llama.cpp نیز درباره نیاز به حافظه و فضای فایل هنگام کوانتیزهکردن مدلهای بزرگ توضیح میدهد. GitHub
پس از تبدیل، نسخه پردقت و نسخه کوانتیزهشده را روی پرسشها و شرایط اجرای یکسان آزمایش کنید.
Q4_K_Mیعنی چه؟
Q4_K_M یکی از نامهای طرح کوانتیزهسازی در اکوسیستم llama.cpp است. حروف و اعداد نام فرمت، اطلاعاتی درباره خانواده روش تبدیل میدهند؛ اما برای تصمیم عملی کافی نیستند.
بهخصوص تصور نکنید هر وزن فایل نهایی دقیقاً چهار بیت فضا مصرف میکند. خود راهنمای ابزار، مقدار مؤثر بیت بهازای وزن و اندازه فایل را جداگانه گزارش میکند. GitHub
برای انتخاب میان Q4، Q5، Q6 و Q8 باید روی همان مدل و سختافزار این موارد را مقایسه کنید:
- اندازه فایل
- مصرف RAM یاVRAM
- کیفیت پاسخ
- زمان آمادهشدن مدل
- زمان پردازش ورودی
- سرعت تولید خروجی
- توان پردازش درخواست همزمان
تفاوت GGUF وbitsandbytes
| معیار | GGUF در ابزارهایی مانند llama.cpp | bitsandbytes با Transformers |
|---|---|---|
| نقطه شروع معمول | فایل مدل سازگار با جریان GGUF | مدل سازگار با Transformers |
| شکل استفاده | فایل مدل با فرمت و نوع کوانتیزهسازی مشخص | تنظیم بارگذاری مدل با BitsAndBytesConfig |
| گزینههای اجرا | وابسته به موتور و پشتیبانی مدل | وابسته به PyTorch، Transformers و پشتیبانی سختافزار |
| کاربرد آموزشی | استفاده از فایل خروجی برای استنتاج | استنتاج و بعضی جریانهای تنظیم پارامترهای اضافی |
| انتخاب نهایی | آزمون کیفیت و عملکرد در محیط مقصد | آزمون کیفیت و عملکرد در محیط مقصد |
هیچیک بهصورت کلی «بهتر» نیست. معماری مدل، زیرساخت موجود، محدودیت دستگاه و روش توسعه محصول تعیین میکند کدام مسیر مناسبتر است.
Quantization و QLoRAچه نسبتی دارند؟
QLoRA روشی برای تنظیم مدلهای بزرگ با بهرهگیری از یک مدل پایه کوانتیزهشده و پارامترهای قابلآموزش اضافی است. پژوهش اصلی QLoRA، نمایش NF4، کوانتیزهسازی دوباره برخی ثابتهای مرتبط و راهکارهایی برای مدیریت فشار حافظه را معرفی کرده است. arxiv.org
تفاوت را روشن نگه دارید:
- کوانتیزهسازی برای استنتاج: هدف، اجرای مدل با محدودیت حافظه یا هزینه است.
- QLoRAبرای تنظیم مدل: هدف، فراهمکردن امکان آموزش پارامترهای اضافی با مصرف حافظه مناسبتر است.
صرف بارگذاری یک مدل با load_in_4bit=True به معنی انجام Fine-tuning یا QLoRA نیست. برای آموزش به داده، تنظیمات آموزشی و اجزای قابلآموزش مناسب نیاز دارید.
Quantization و Knowledge Distillationچه تفاوتی دارند؟
در مقاله تقطیر دانش مدل باPyTorch یک مدل کوچکتر را با راهنمایی مدل بزرگتر آموزش دادیم.
در کوانتیزهسازی معمولاً هدف این است که نمایش عددی یک مدل برای اجرا تغییر کند؛ هرچند در برخی طرحها آموزش نیز در فرایند دخیل است.
| پرسش | Quantization | Knowledge Distillation |
|---|---|---|
| آیا معمولاً معماری جدیدی برای دانشآموز میسازیم؟ | خیر | بله |
| چه چیزی تغییر میکند؟ | نمایش یا محاسبه کمدقتتر | وزنهای یک مدل آموزشدیده با راهنمایی معلم |
| آیا ممکن است بدون آموزش کامل دوباره انجام شود؟ | در بعضی روشها بله | آموزش دانشآموز لازم است |
| آیا میتوان دو روش را ترکیب کرد؟ | بله | بله |
برای مثال، میتوان یک دانشآموز کوچکتر آموزش داد و سپس کوانتیزهسازی همان دانشآموز را نیز بررسی کرد. کیفیت باید بعد از هر دو مرحله ارزیابی شود.
چرا مقدار بیت بهتنهایی کیفیت را مشخص نمیکند؟
دو نسخه «۴ بیتی» ممکن است تفاوت زیادی داشته باشند، چون:
- الگوریتم کوانتیزهسازی آنها متفاوت است.
- اندازه گروههای وزن متفاوت است.
- بعضی لایهها با دقت بالاتر باقی ماندهاند.
- داده مورد استفاده برای کالیبراسیون یا ساخت آمار متفاوت بوده است.
- نسخه اصلی مدل یکسان نبوده است.
- موتور اجرا از طرح یکی بهتر پشتیبانی میکند.
بنابراین جمله «مدل ۴ بیتی کیفیتش را حفظ میکند» بدون نام مدل، روش تبدیل، مجموعه ارزیابی و معیار کیفیت، ادعای دقیقی نیست.
چگونه افت کیفیت مدل کوانتیزهشده را بسنجیم؟
برای کاربرد متن فارسی، یک مجموعه ارزیابی متناسب با محصول بسازید. نمونهها میتوانند شامل موارد زیر باشند:
- پرسشهای رایج کاربران
- متنهای فارسی با نیمفاصله و شکلهای نوشتاری متفاوت
- درخواستهای طولانی
- استخراج اطلاعات از متن
- دستهبندی پیامهای نزدیک به هم
- پرسشهایی که پاسخ «اطلاعات کافی ندارم» میخواهند
- خروجیهای ساختاریافتهای که باید قالب مشخصی داشته باشند
برای هر نسخه مدل، شرایط را ثابت نگه دارید:
- همان ورودی
- همان قالبPrompt
- همان تنظیمات تولید
- همان محدودیت طول پاسخ
- همان معیار ارزیابی
- همان مجموعه نمونههای مستقل
صرف خواندن چند پاسخ نمونه کافی نیست. نرخ خطای قالب، خطای واقعیت، خطای طبقهبندی و موارد مهم کسبوکار را جداگانه گزارش کنید.
چه معیارهای عملکردی را ثبت کنیم؟
برای استقرار یک مدل زبانی، دستکم این موارد مفیدند:
| معیار | دلیل |
|---|---|
| اندازه فایل | هزینه نگهداری و انتقال مدل |
| حافظه هنگام بارگذاری | آیا مدل در دستگاه جا میشود؟ |
| اوج حافظه در اجرا | رفتار با متن بلند و درخواست همزمان |
| زمان تا شروع پاسخ | تجربه کاربر در تعامل |
| سرعت پردازش Prompt | اثر ورودیهای بلند |
| سرعت تولید خروجی | زمان رسیدن به پاسخ کامل |
| توان عملیاتی همزمان | ظرفیت سرویس |
| کیفیت پاسخ | حفظ کاربردپذیری مدل |
| هزینه هر درخواست | تصمیم اقتصادی نهایی |
این معیارها را روی همان CPU یا GPU موردنظر، با طول متن و بار نزدیک به شرایط واقعی اندازه بگیرید.
Quantizationدر مدلهای چندوجهی
در مدلهایی که تصویر، صدا یا ویدئو را نیز پردازش میکنند، همه اجزا لزوماً با یک روش کوانتیزه نمیشوند. ممکن است بخش زبانی فشرده شود، اما بخش بینایی یا پروژهکننده میان دو بخش با دقت دیگری باقی بماند.
پس هنگام بررسی اندازه و سرعت یک مدل چندوجهی مشخص کنید:
- کدام بخشها فشرده شدهاند؟
- کیفیت هر نوع ورودی چگونه تغییر کرده است؟
- آیا فایلهای کمکی جداگانه لازماند؟
- آیا موتور اجرا همه قابلیتهای مدل را پشتیبانی میکند؟
نتیجه یک آزمایش متنی را بهطور خودکار به تحلیل تصویر یا صوت تعمیم ندهید.
چه زمانی اجرای مدل محلی کوانتیزهشده مناسب است؟
این مسیر ارزش بررسی دارد اگر:
- به اجرای محلی یا در زیرساخت اختصاصی نیاز دارید.
- حجم استفاده میتواند هزینه نگهداری مدل را توجیه کند.
- سختافزار و تیم لازم برای استقرار و پایش را دارید.
- کیفیت نسخه کوانتیزهشده روی داده شما کافی است.
- میخواهید رفتار زمان پاسخ و ظرفیت را در محیط خود مدیریت کنید.
در مقابل، اگر هنوز مدل مناسب وظیفه را انتخاب نکردهاید یا حجم درخواست مشخص نیست، آزمایش چند مدل آماده از طریق API ممکن است تصمیمگیری اولیه را سریعتر کند. این انتخاب باید بر اساس کیفیت، هزینه کل و نیاز عملیاتی انجام شود.
اشتباهات رایج درQuantization
فرض اینکه مدل ۴ بیتی همیشه نصف مدل ۸ بیتی است
اطلاعات جانبی، لایههای فشردهنشده و فرمت فایل نیز فضا مصرف میکنند. اندازه واقعی را اندازه بگیرید.
یکیدانستن اندازه فایل و مصرفVRAM
حافظه اجرا به وزنها، مقدارهای میانی، KV Cache، بار همزمان و سربار موتور بستگی دارد.
فرض افزایش قطعی سرعت
اگر سختافزار یا پیادهسازی از فرمت انتخابی بهره کافی نبرد، سرعت ممکن است بهتر نشود.
ارزیابی فقط با چندPrompt
چند پاسخ خوب، حفظ کیفیت روی دستهبندی، استخراج اطلاعات یا پیامهای دشوار فارسی را ثابت نمیکند.
مقایسه دو مدل با تنظیمات متفاوت تولید
اگر دما، طول خروجی یا قالب گفتوگو یکسان نباشد، نمیتوان تفاوت پاسخ را فقط به کوانتیزهسازی نسبت داد.
انتخاب فرمت صرفاً بر اساس نام Q4 یاQ8
روش دقیق، نسخه ابزار و سختافزار مقصد بر نتیجه اثر دارند.
نادیدهگرفتن حقوق استفاده و شرایط مدل
پیش از تبدیل و استقرار، شرایط استفاده از مدل اصلی و دادههای مربوط به آن را بررسی کنید.
نداشتن نسخه مبنا
فایل مدل پردقت و نتایج ارزیابی آن را نگه دارید تا بتوانید افت یا بهبود نسخههای بعدی را بررسی کنید.
پرسشهای متداول
Quantizationدر هوش مصنوعی چیست؟
روشی برای نمایش یا پردازش بخشی از مقدارهای مدل با دقت عددی کمتر است تا مصرف حافظه یا هزینه اجرا کاهش یابد.
کوانتیزهسازی ۴ بیتی یعنی چه؟
به خانوادهای از روشها اشاره دارد که بخشی از وزنها را با نمایش نزدیک به چهار بیت ذخیره میکنند. مصرف واقعی هر وزن و اندازه نهایی فایل به روش و اطلاعات جانبی بستگی دارد.
آیا مدل ۴ بیتی کیفیتش را از دست میدهد؟
ممکن است کیفیت بعضی وظایف تغییر کند. مقدار این تغییر به مدل، روش تبدیل و نوع داده بستگی دارد و باید روی مجموعه ارزیابی مستقل سنجیده شود.
GGUFچیست؟
فرمتی برای نگهداری مدل و اطلاعات مرتبط با آن در ابزارهایی مانند llama.cpp است. GGUF بهخودیخود معادل یک دقت خاص نیست.
تفاوت GGUF و Q4_K_M چیست؟
GGUFفرمت فایل است؛ Q4_K_M نام یک طرح کوانتیزهسازی در اکوسیستم llama.cpp است.
تفاوت INT8 و FP16 چیست؟
یکی از نمایشهای رایج کوانتیزهسازی از عددهای ۸ بیتی استفاده میکند؛ FP16 یک نمایش اعشاری ۱۶ بیتی است. کیفیت و سرعت آنها فقط بر اساس تعداد بیت تعیین نمیشود.
آیا Quantization همان QLoRA است؟
خیر. QLoRA روشی برای تنظیم مدل با بهرهگیری از مدل پایه کوانتیزهشده و پارامترهای آموزشی اضافی است. کوانتیزهسازی میتواند صرفاً برای استنتاج نیز استفاده شود.
آیا Quantization همان تقطیر دانش است؟
خیر. در تقطیر دانش یک مدل دانشآموز با کمک معلم آموزش میبیند. در کوانتیزهسازی نمایش عددی بخشی از مدل تغییر میکند.
آیا بدون GPU میتوان مدل کوانتیزهشده اجرا کرد؟
بسته به مدل، فرمت و موتور اجرا، بله؛ بعضی جریانهای کاری برای CPU مناسباند. اما نمونه bitsandbytes چهار بیتی این مقاله برای محیط CUDA سازگار نوشته شده است.
جمعبندی
Quantizationمیتواند اندازه وزنهای مدل و در شرایط مناسب هزینه اجرای آن را کاهش دهد. اما «کمتر شدن تعداد بیت» بهتنهایی درباره کیفیت پاسخ، سرعت، حافظه کل سرویس یا هزینه واقعی هر درخواست تصمیم نمیگیرد.
در مثال NumPy دیدیم که تبدیل وزنها به نمایش ۸ بیتی، فضای خودِ وزنها را کاهش میدهد و همزمان اختلافی عددی ایجاد میکند. سپس دو مسیر کاربردی را شناختیم: بارگذاری مدلهای سازگار با bitsandbytes و ساخت فایل کوانتیزهشده GGUF برای ابزارهایی مانند llama.cpp.
برای انتخاب نسخه مناسب، مدل اصلی و نسخههای کوانتیزهشده را با داده فارسی مرتبط با محصول، تنظیمات یکسان و سختافزار مقصد مقایسه کنید. اندازه فایل، کیفیت، زمان پاسخ، مصرف حافظه و ظرفیت همزمان را کنار هم ببینید.
اگر پیش از سرمایهگذاری روی اجرای محلی میخواهید کیفیت چند مدل هوش مصنوعی را برای کاربردتان مقایسه کنید، خدمات و زیرساخت درواره را در darvareh.ir بررسی کنید.
مقالات مرتبط
- تقطیر دانش مدل باPyTorch
- Fine-tuning مدل زبانی با LoRA و QLoRA
- اجرای مدل هوش مصنوعی محلی باOllama
- آموزش LM Studio و API مدل محلی
- بهینهسازی هزینه عامل هوش مصنوعی
- ارزیابی مدل هوش مصنوعی وEvals
- PyTorchچیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- مستندات رسمی Hugging Face دربارهbitsandbytes Hugging Face
- راهنمای رسمی llama.cpp برای کوانتیزهسازیGGUF GitHub
- مستندات مدلها و فرمت GGUF درllama.cpp GitHub
- مستندات torchao درباره استنتاج کوانتیزهشده torchao 0.17 documentation
- مستندات Int8WeightOnlyConfig درtorchao torchao 0.17 documentation
- مقاله اصلیQLoRA arxiv.org
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



