
Knowledge Distillation چیست؟ آموزش تقطیر دانش مدل با PyTorch
چگونه میتوان دانش یک مدل بزرگ را به مدلی کوچکتر منتقل کرد؟ در این آموزش، Knowledge Distillation، مدل معلم و دانشآموز، Soft Targets و Temperature را میشناسید و یک آزمایش کامل را با PyTorch اجرا میکنید.

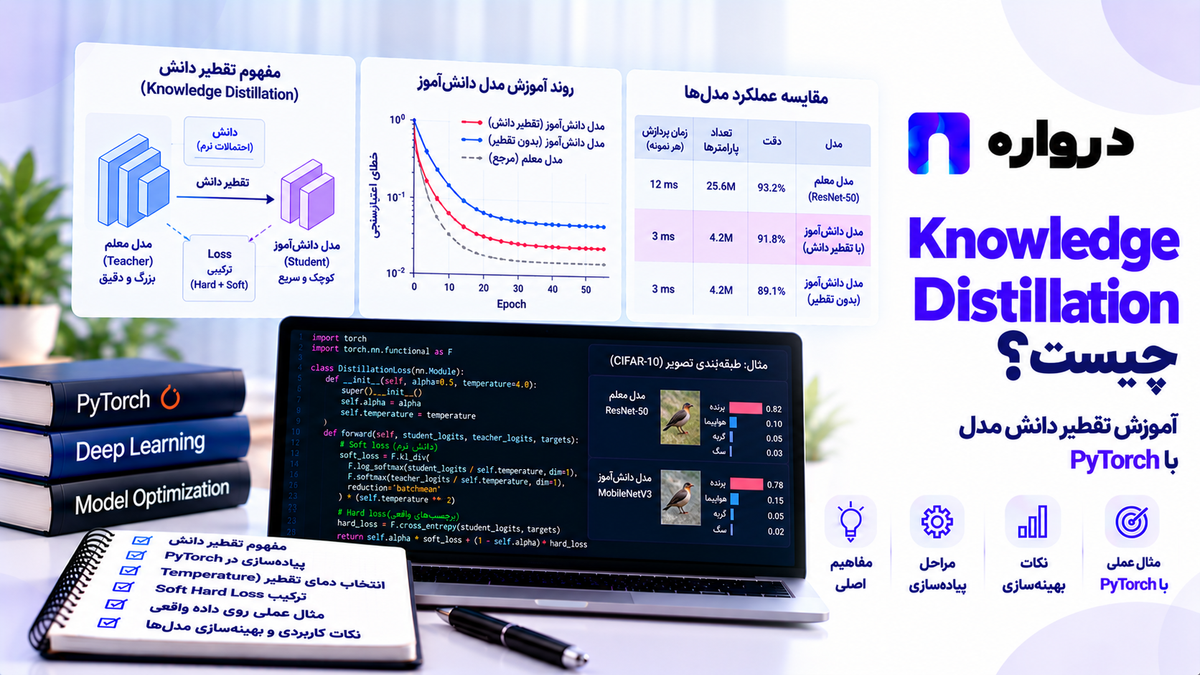
مدل بزرگ ممکن است کیفیت خوبی داشته باشد، اما اجرای آن برای هر درخواست پرهزینه یا کند باشد. در مقابل، یک مدل کوچکتر سریعتر و سبکتر است، ولی اگر آن را فقط با برچسبهای معمول آموزش دهیم، ممکن است بخشی از کیفیت مدل بزرگ را به دست نیاورد.
Knowledge Distillation یا تقطیر دانش روشی برای آموزش مدل کوچکتر با کمک یک مدل آموزشدیده بزرگتر است. مدل بزرگ را Teacherیا معلم و مدل کوچک را Studentیا دانشآموز مینامند.
معلم فقط پاسخ نهایی را به دانشآموز نمیدهد. در شکل کلاسیک این روش، اطلاعات موجود در خروجی نرمترِ کلاسها نیز وارد آموزش میشود. برای مثال، اگر تصویر یک کفش ورزشی باشد، مدل معلم ممکن است علاوه بر احتمال بالای کلاس «کفش ورزشی»، به کلاس «بوت» نیز احتمالی بیشتر از کلاس «کیف» بدهد. این رابطه میان کلاسها میتواند برای آموزش دانشآموز مفید باشد.
مقاله Distilling the Knowledge in a Neural Network از آثار اصلی معرفی و صورتبندی این ایده است. راهنمای رسمی PyTorch نیز آزمایشی عملی برای ترکیب برچسب واقعی و خروجی نرم مدل معلم ارائه میکند. research.google
در این مقاله، مفاهیم را توضیح میدهیم و سپس سه مدل را روی Fashion-MNIST مقایسه میکنیم:
- مدل معلم بزرگتر
- مدل دانشآموز که فقط با برچسب واقعی آموزش میبیند
- همان معماری دانشآموز که با کمک معلم آموزش میبیند
در پایان، دقت، تعداد پارامترها و زمان اجرای پیشبینی را جداگانه بررسی میکنیم.
تقطیر دانش چگونه کار میکند؟
فرایند معمول چنین است:
- یک مدل معلم روی مسئله آموزش میبیند.
- معماری کوچکتری برای دانشآموز انتخاب میشود.
- ورودیهای آموزشی به هر دو مدل داده میشوند.
- خروجی معلم برای راهنمایی دانشآموز استفاده میشود.
- فقط وزنهای دانشآموز تغییر میکنند.
- دانشآموز روی داده مستقل ارزیابی میشود.
در زمان استقرار، هدف بسیاری از پروژهها این است که فقط دانشآموز اجرا شود. بااینحال، صرف انجام تقطیر تضمین نمیکند دانشآموز همکیفیت معلم شود یا در سختافزار واقعی سریعتر پاسخ دهد. هر دو موضوع باید اندازهگیری شوند.
مدل معلم چیست؟
مدل معلم شبکهای است که پیش از تقطیر آموزش دیده و قرار است اطلاعاتی فراتر از برچسب قطعی در اختیار دانشآموز بگذارد.
معلم میتواند:
- شبکهای بزرگتر از دانشآموز باشد.
- معماری متفاوتی داشته باشد.
- با داده بیشتری آموزش دیده باشد.
- حاصل ترکیب چند مدل باشد.
- مدلی باشد که اجرای مستقیم آن در محصول از نظر هزینه یا زمان مناسب نیست.
بزرگتر بودن معلم بهتنهایی کافی نیست. اگر پیشبینیهایش اشتباه یا نامناسب باشند، دانشآموز ممکن است همان خطاها را نیز یاد بگیرد.
مدل دانشآموز چیست؟
دانشآموز مدلی است که برای محدودیتهای کاربرد نهایی طراحی میشود؛ برای مثال:
- حافظه کمتر
- زمان پاسخ کمتر
- اجرای آسانتر رویCPU
- توان عملیاتی بیشتر
- هزینه کمتر برای تعداد زیاد درخواست
گاهی هدف، کوچکترین مدل ممکن نیست. ممکن است دانشآموزی کمی بزرگتر، کیفیت بسیار بهتری ارائه کند و همچنان در محدودیت عملیاتی محصول جا بگیرد.
Hard Label و Soft Targetچه تفاوتی دارند؟
Hard Label یا برچسب قطعی تنها کلاس درست را مشخص میکند. برای نمونه، تصویر ورودی در Fashion-MNIST برچسب «پیراهن» دارد.
Soft Target خروجی نرم مدل معلم برای چندین کلاس است. این خروجی نشان میدهد معلم کلاسها را با چه شدت نسبی محتمل میداند.
در مثال تصویری، برچسب قطعی فقط میگوید «این نمونه پیراهن است». خروجی معلم ممکن است نشان دهد مدل میان «پیراهن»، «کت» و «تیشرت» چه نسبتی میبیند.
این اطلاعات همیشه مفید نیست. اگر معلم کلاسهای مشابه را بهطور نادرست تفکیک کند، خروجی نرم آن نیز میتواند دانشآموز را در جهت اشتباه هدایت کند.
Temperatureدر تقطیر دانش چیست؟
در تقطیر خروجی مدل، از پارامتری به نام Temperature یا دما استفاده میشود. دما بر میزان نرم بودن توزیع خروجی کلاسها اثر میگذارد.
به زبان ساده، تنظیم دما میتواند باعث شود تفاوت میان کلاسهایی که در حالت عادی احتمال بسیار کمی دارند بهتر دیده شود. مقدار دما یک تنظیم آزمایشی است؛ عددی که در یک مقاله یا مثال مناسب بوده، لزوماً برای داده شما بهترین نیست.
در پیادهسازی رایج، هر دو خروجی معلم و دانشآموز با همان دما برای بخش تقطیر پردازش میشوند. راهنمای رسمی PyTorch همچنین اثر دما را هنگام وزندهی به Loss تقطیر در کد لحاظ میکند. PyTorch Tutorials 2.14.0+cu130 documentation
تابع Loss درKnowledge Distillation
آموزش دانشآموز معمولاً دو منبع راهنمایی دارد:
- برچسب واقعی: آیا دانشآموز کلاس درست را پیشبینی میکند؟
- خروجی معلم: آیا رفتار خروجی دانشآموز به رفتار معلم نزدیک است؟
در نتیجه Loss نهایی از ترکیب دو بخش ساخته میشود:
CrossEntropyLossبرای برچسبهای واقعی- یک Loss برای نزدیککردن خروجی نرم دانشآموز به خروجی نرم معلم؛ در این مقاله از
KL Divergenceاستفاده میکنیم.
وزن هر بخش باید آزمایش شود. اگر تأثیر معلم بیش از اندازه زیاد شود، دانشآموز ممکن است خطاهای معلم را بیشتر تقلید کند. اگر تأثیر آن بسیار کم باشد، تفاوت روش با آموزش معمولی ناچیز خواهد بود.
در مستندات PyTorch، برای kl_div استفاده از reduction="batchmean" بهعنوان گزینه منطبق با تعریف این معیار توضیح داده شده است. PyTorch main documentation
تفاوت تقطیر دانش وFine-tuning
این دو روش مسئلههای متفاوتی را حل میکنند:
| ویژگی | تقطیر دانش | Fine-tuning |
|---|---|---|
| نقطه شروع رایج | یک معلم و یک دانشآموز | یک مدل از پیش آموزشدیده |
| کاری که انجام میشود | آموزش دانشآموز با کمک رفتار معلم | تنظیم وزنهای مدل موجود برای داده یا وظیفه جدید |
| هدف رایج | دستیابی به مدل مناسبتر برای اجرا | سازگارکردن مدل با وظیفه یا دامنه |
| نیاز به معلم جداگانه | معمولاً بله | لزوماً خیر |
| اندازه مدل خروجی | به معماری دانشآموز بستگی دارد | معمولاً از معماری مدل مبنا پیروی میکند |
میتوان این روشها را نیز ترکیب کرد. برای مثال، معلم را برای یک حوزه تخصصی تنظیم و سپس از خروجی آن برای آموزش دانشآموز استفاده کرد.
تفاوت تقطیر دانش، Quantization وPruning
| روش | تغییر اصلی |
|---|---|
| Knowledge Distillation | آموزش یک مدل دانشآموز با راهنمایی مدل معلم |
| Quantization | نمایش و محاسبه با دقت عددی متفاوت |
| Pruning | حذف یا کماثرکردن بخشی از وزنها یا ساختار مدل |
تقطیر دانش معمولاً یک فرایند آموزشی برای مدل دانشآموز است. Quantization و Pruning میتوانند روی مدل موجود نیز اعمال شوند. این روشها در بعضی پروژهها قابل ترکیباند، ولی اثر هر مرحله بر کیفیت و سرعت باید جداگانه سنجیده شود. مستندات PyTorch برای Pruning و Quantization نمونههای عملی ارائه میکند. PyTorch Tutorials 2.14.0+cu130 documentation
آموزش عملی تقطیر دانش باPyTorch
در مثال زیر از Fashion-MNIST استفاده میکنیم؛ دیتاستی شامل تصویرهای خاکستری پوشاک با ده کلاس.
برای اینکه مقایسه قابل فهم باشد:
- معلم یک شبکه تماممتصل بزرگتر است.
- دانشآموز یک شبکه تماممتصل کوچکتر است.
- دو نسخه دانشآموز از وزنهای اولیه یکسان آغاز میکنند.
- یکی فقط با برچسب واقعی آموزش میبیند.
- دیگری از برچسب واقعی و خروجی معلم استفاده میکند.
این مثال آموزشی است. نتیجه آن نباید به کیفیت تقطیر مدلهای زبانی بزرگ یا دادههای صنعتی تعمیم داده شود.
نصب کتابخانهها
pip install torch torchvisionبرای استفاده از GPU، نسخه مناسب PyTorch و TorchVision را طبق راهنمای نصب رسمی متناسب با سیستم خود انتخاب کنید.
واردکردن کتابخانهها و تنظیم اجرا
import copy
import time

import torch

from torch import nn
from torch.nn import functional as F
from torch.utils.data import (
    DataLoader,
    random_split,
)

from torchvision import (
    datasets,
    transforms,
)


torch.manual_seed(42)

device = torch.device(
    "cuda"
    if torch.cuda.is_available()
    else "cpu"
)

print("Device:", device)
بارگذاریFashion-MNIST
transform = transforms.ToTensor()

full_train_dataset = (
    datasets.FashionMNIST(
        root="data",
        train=True,
        download=True,
        transform=transform,
    )
)

test_dataset = (
    datasets.FashionMNIST(
        root="data",
        train=False,
        download=True,
        transform=transform,
    )
)

split_generator = (
    torch.Generator()
    .manual_seed(42)
)

train_dataset, (
    validation_dataset
) = random_split(
    full_train_dataset,
    [
        54_000,
        6_000,
    ],
    generator=split_generator,
)

BATCH_SIZE = 128


def make_train_loader(
    seed: int,
) -> DataLoader:
    generator = (
        torch.Generator()
        .manual_seed(seed)
    )

    return DataLoader(
        train_dataset,
        batch_size=BATCH_SIZE,
        shuffle=True,
        generator=generator,
        num_workers=0,
    )


validation_loader = DataLoader(
    validation_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
    num_workers=0,
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
    num_workers=0,
)

print(
    "Training samples:",
    len(train_dataset),
)

print(
    "Validation samples:",
    len(validation_dataset),
)

print(
    "Test samples:",
    len(test_dataset),
)
مجموعه Test در انتخاب تعداد Epoch و تنظیمات تقطیر استفاده نمیشود. آن را برای مقایسه نهایی نگه میداریم.
ساخت مدل معلم
class TeacherNet(nn.Module):
    def __init__(self):
        super().__init__()

        self.network = nn.Sequential(
            nn.Flatten(),

            nn.Linear(
                28 * 28,
                512,
            ),
            nn.ReLU(),

            nn.Linear(
                512,
                256,
            ),
            nn.ReLU(),

            nn.Linear(
                256,
                10,
            ),
        )

    def forward(
        self,
        images: torch.Tensor,
    ) -> torch.Tensor:
        return self.network(
            images
        )
خروجی مدل شامل ده Logit است؛ هر مقدار به یک کلاس مربوط میشود. برای CrossEntropyLoss لازم نیست پیش از ارسال Logitها، خودمان Softmax اعمال کنیم.
ساخت مدل دانشآموز
class StudentNet(nn.Module): def __init__(self): super().__init__() self.network = nn.Sequential( nn.Flatten(), nn.Linear( 28 * 28, 64, ), nn.ReLU(), nn.Linear( 64, 10, ), ) def forward( self, images: torch.Tensor, ) -> torch.Tensor: return self.network( images )دانشآموز لایهها و پارامترهای کمتری دارد. اما کاهش تعداد پارامترها بهتنهایی نشان نمیدهد زمان پاسخ در سختافزار موردنظر حتماً به همان نسبت کم میشود.
تابع ارزیابی مشترک
برای هر سه مدل از یک تابع ارزیابی استفاده میکنیم:
def evaluate_accuracy( model: nn.Module, data_loader: DataLoader,) -> float: model.eval() correct = 0 total = 0 with torch.inference_mode(): for images, labels in ( data_loader ): images = images.to( device ) labels = labels.to( device ) logits = model( images ) predictions = ( logits.argmax( dim=1 ) ) correct += ( predictions .eq(labels) .sum() .item()Accuracyیک نقطه شروع است. در کاربرد واقعی، خطا را به تفکیک کلاس و شرایط مختلف داده نیز بررسی کنید.
آموزش معمولی مدل معلم
در هر Epoch، عملکرد Validation را میسنجیم و بهترین وزنها را بر اساس آن نگه میداریم:
def train_with_labels(
    model: nn.Module,
    train_loader: DataLoader,
    epochs: int,
    learning_rate: float = 0.001,
) -> nn.Module:
    model = model.to(
        device
    )

    optimizer = (
        torch.optim.AdamW(
            model.parameters(),
            lr=learning_rate,
        )
    )

    criterion = (
        nn.CrossEntropyLoss()
    )

    best_accuracy = -1.0

    best_state = copy.deepcopy(
        model.state_dict()
    )

    for epoch in range(
        epochs
    ):
        model.train()

        total_loss = 0.0
        total_samples = 0

        for images, labels in (
            train_loader
        ):
            images = images.to(
                device
            )

            labels = labels.to(
                device
            )

            optimizer.zero_grad()

            logits = model(
                images
            )

            loss = criterion(
                logits,
                labels,
            )

            loss.backward()

            optimizer.step()

            batch_size = (
                labels.size(0)
            )

            total_loss += (
                loss.item()
                * batch_size
            )

            total_samples += (
                batch_size
            )

        validation_accuracy = (
            evaluate_accuracy(
                model,
                validation_loader,
            )
        )

        if (
            validation_accuracy
            > best_accuracy
        ):
            best_accuracy = (
                validation_accuracy
            )

            best_state = (
                copy.deepcopy(
                    model.state_dict()
                )
            )

        print(
            f"Epoch "
            f"{epoch + 1:02d} | "
            f"Train loss: "
            f"{total_loss / total_samples:.4f} | "
            f"Validation accuracy: "
            f"{validation_accuracy:.4f}"
        )

    model.load_state_dict(
        best_state
    )

    return model
آموزش معلم:
teacher = train_with_labels(
    model=TeacherNet(),
    train_loader=(
        make_train_loader(
            seed=7
        )
    ),
    epochs=10,
)

teacher_validation_accuracy = (
    evaluate_accuracy(
        teacher,
        validation_loader,
    )
)

print(
    "Teacher validation accuracy:",
    teacher_validation_accuracy,
)
پیش از آغاز تقطیر، بررسی کنید معلم واقعاً کیفیت مناسبی دارد. اگر دانشآموز بدون معلم عملکردی نزدیک یا بهتر به دست میآورد، ارزش هزینه اضافی تقطیر باید با دقت سنجیده شود.
آموزش دانشآموز بدون تقطیر
ابتدا یک نمونه دانشآموز میسازیم. سپس دو نسخه مستقل از همین مقدار اولیه وزنها ایجاد میکنیم تا مقایسه آموزش معمول و تقطیر منصفانهتر باشد.
initial_student = (
    StudentNet()
)

student_supervised = (
    copy.deepcopy(
        initial_student
    )
)

student_distilled = (
    copy.deepcopy(
        initial_student
    )
)
آموزش نسخه معمولی:
student_supervised = (
    train_with_labels(
        model=(
            student_supervised
        ),
        train_loader=(
            make_train_loader(
                seed=42
            )
        ),
        epochs=8,
    )
)

print(
    "Supervised student "
    "validation accuracy:",
    evaluate_accuracy(
        student_supervised,
        validation_loader,
    ),
)
این مدل Baselineاصلی دانشآموز است. اگر نسخه تقطیرشده بهتر عمل کند، تفاوت را باید با این مدل هممعماری مقایسه کنیم، نه فقط با معلم بزرگتر.
تابع Loss تقطیر دانش
اکنون Loss مشترک برچسب واقعی و خروجی معلم را میسازیم:
def distillation_loss(
    student_logits: torch.Tensor,
    teacher_logits: torch.Tensor,
    labels: torch.Tensor,
    temperature: float = 2.0,
    teacher_weight: float = 0.25,
) -> torch.Tensor:
    if temperature <= 0:
        raise ValueError(
            "Temperature must "
            "be positive."
        )

    if not (
        0.0
        <= teacher_weight
        <= 1.0
    ):
        raise ValueError(
            "teacher_weight must "
            "be between 0 and 1."
        )

    label_loss = (
        F.cross_entropy(
            student_logits,
            labels,
        )
    )

    student_log_probs = (
        F.log_softmax(
            student_logits
            / temperature,
            dim=1,
        )
    )

    teacher_probs = (
        F.softmax(
            teacher_logits
            / temperature,
            dim=1,
        )
    )

    soft_target_loss = (
        F.kl_div(
            student_log_probs,
            teacher_probs,
            reduction=(
                "batchmean"
            ),
        )
        * (
            temperature
            * temperature
        )
    )

    return (
        (1.0 - teacher_weight)
        * label_loss
        + teacher_weight
        * soft_target_loss
    )
در این کد:
- بخش برچسب واقعی با Logitهای معمول دانشآموز محاسبه میشود.
- خروجی معلم و دانشآموز برای بخش تقطیر با دمای یکسان پردازش میشوند.
- گرادیان فقط باید وزنهای دانشآموز را تغییر دهد.
- وزن ۰٫۲۵ برای راهنمایی معلم یک تنظیم آموزشی است، نه مقدار بهینه عمومی.
آموزش دانشآموز با کمک معلم
def train_distilled_student(
    teacher: nn.Module,
    student: nn.Module,
    train_loader: DataLoader,
    epochs: int = 8,
    learning_rate: float = 0.001,
    temperature: float = 2.0,
    teacher_weight: float = 0.25,
) -> nn.Module:
    teacher = teacher.to(
        device
    )

    student = student.to(
        device
    )

    teacher.eval()

    optimizer = (
        torch.optim.AdamW(
            student.parameters(),
            lr=learning_rate,
        )
    )

    best_accuracy = -1.0

    best_state = copy.deepcopy(
        student.state_dict()
    )

    for epoch in range(
        epochs
    ):
        student.train()

        total_loss = 0.0
        total_samples = 0

        for images, labels in (
            train_loader
        ):
            images = images.to(
                device
            )

            labels = labels.to(
                device
            )

            optimizer.zero_grad()

            with torch.no_grad():
                teacher_logits = (
                    teacher(
                        images
                    )
                )

            student_logits = (
                student(
                    images
                )
            )

            loss = (
                distillation_loss(
                    student_logits=(
                        student_logits
                    ),
                    teacher_logits=(
                        teacher_logits
                    ),
                    labels=labels,
                    temperature=(
                        temperature
                    ),
                    teacher_weight=(
                        teacher_weight
                    ),
                )
            )

            loss.backward()

            optimizer.step()

            batch_size = (
                labels.size(0)
            )

            total_loss += (
                loss.item()
                * batch_size
            )

            total_samples += (
                batch_size
            )

        validation_accuracy = (
            evaluate_accuracy(
                student,
                validation_loader,
            )
        )

        if (
            validation_accuracy
            > best_accuracy
        ):
            best_accuracy = (
                validation_accuracy
            )

            best_state = (
                copy.deepcopy(
                    student.state_dict()
                )
            )

        print(
            f"Epoch "
            f"{epoch + 1:02d} | "
            f"Train loss: "
            f"{total_loss / total_samples:.4f} | "
            f"Validation accuracy: "
            f"{validation_accuracy:.4f}"
        )

    student.load_state_dict(
        best_state
    )

    return student
اجرای آموزش:
student_distilled = (
    train_distilled_student(
        teacher=teacher,
        student=(
            student_distilled
        ),
        train_loader=(
            make_train_loader(
                seed=42
            )
        ),
        epochs=8,
        temperature=2.0,
        teacher_weight=0.25,
    )
)
معلم با eval() در حالت ارزیابی قرار دارد و خروجی آن داخل torch.no_grad() محاسبه میشود. بنابراین آموزش بهدنبال تغییر وزنهای معلم نیست. راهنمای رسمی PyTorch نیز از همین اصل برای آموزش دانشآموز استفاده میکند. PyTorch Tutorials 2.14.0+cu130 documentation
ارزیابی نهایی هر سه مدل رویTest
پس از پایان انتخاب وزنها با Validation، عملکرد هر مدل را روی Test میسنجیم:
test_results = {
    "Teacher": (
        evaluate_accuracy(
            teacher,
            test_loader,
        )
    ),

    "Student without KD": (
        evaluate_accuracy(
            student_supervised,
            test_loader,
        )
    ),

    "Student with KD": (
        evaluate_accuracy(
            student_distilled,
            test_loader,
        )
    ),
}

for name, accuracy in (
    test_results.items()
):
    print(
        f"{name:20s} | "
        f"Test accuracy: "
        f"{accuracy:.4f}"
    )
کد، نتیجه واقعی محیط اجرای شما را چاپ میکند؛ عددی برای آن از پیش فرض نمیکنیم.
سه مقایسه مهماند:
- آیا معلم واقعاً از دانشآموز معمولی بهتر است؟
- آیا تقطیر کیفیت دانشآموز را در این اجرا تغییر داده است؟
- آیا کیفیت نسخه کوچکتر برای کاربرد نهایی کافی است؟
اگر نسخه تقطیرشده بهبود نداشت، ابتدا صحت کد و کیفیت معلم را بررسی کنید. سپس میتوان وزن Loss، دما، ظرفیت دانشآموز، تعداد Epoch و تنوع داده آموزش را باValidation آزمایش کرد.
مقایسه تعداد پارامترهای معلم و دانشآموز
def count_parameters(
    model: nn.Module,
) -> int:
    return sum(
        parameter.numel()
        for parameter
        in model.parameters()
    )


teacher_parameters = (
    count_parameters(
        teacher
    )
)

student_parameters = (
    count_parameters(
        student_distilled
    )
)

print(
    "Teacher parameters:",
    teacher_parameters,
)

print(
    "Student parameters:",
    student_parameters,
)
دو نسخه دانشآموز معماری یکسان دارند؛ بنابراین تعداد پارامترهایشان یکسان است. تقطیر بهتنهایی معماری دانشآموز را کوچکتر نمیکند، بلکه تلاش میکند همان معماری کوچک را بهتر آموزش دهد.
اندازهگیری زمان پیشبینی
برای انتخاب عملی، دقت کافی نیست. زمان اجرا را روی همان دستگاه و با اندازه Batch یکسان اندازه بگیرید:
def benchmark_batch(
    model: nn.Module,
    images: torch.Tensor,
    repeats: int = 100,
) -> float:
    model.eval()

    images = images.to(
        device
    )

    with torch.inference_mode():
        for _ in range(10):
            model(
                images
            )

        if (
            device.type
            == "cuda"
        ):
            torch.cuda.synchronize()

        start = (
            time.perf_counter()
        )

        for _ in range(
            repeats
        ):
            model(
                images
            )

        if (
            device.type
            == "cuda"
        ):
            torch.cuda.synchronize()

        elapsed = (
            time.perf_counter()
            - start
        )

    return (
        elapsed
        / repeats
    )


images, _ = next(
    iter(
        test_loader
    )
)

for name, model in [
    (
        "Teacher",
        teacher,
    ),
    (
        "Student",
        student_distilled,
    ),
]:
    seconds_per_batch = (
        benchmark_batch(
            model,
            images,
        )
    )

    print(
        name,
        "seconds per batch:",
        seconds_per_batch,
    )
این اندازهگیری یک آزمایش ساده روی یکBatch است. برای تصمیم استقرار باید زمان پاسخ را با بار واقعی، تعداد درخواستهای همزمان، اندازه Batch عملیاتی و همان سختافزار مقصد بسنجید.
روی GPU نیز هماهنگسازی پیش و پس از اندازهگیری مهم است؛ در غیر این صورت، اجرای ناهمزمان میتواند زمان گزارششده را گمراهکننده کند.
چگونه بفهمیم تقطیر موفق بوده است؟
بهجای یک عدد Accuracy، چند معیار را کنار هم بگذارید:
| معیار | پرسش |
|---|---|
| کیفیت روی داده مستقل | آیا دانشآموز برای کاربرد شما کافی است؟ |
| اختلاف با دانشآموز معمولی | آیا تقطیر واقعاً ارزشی اضافه کرده است؟ |
| اندازه مدل | فایل و پارامترهای مدل چقدر کوچک شدهاند؟ |
| زمان پاسخ | پیشبینی روی سختافزار مقصد چقدر طول میکشد؟ |
| توان عملیاتی | در هر واحد زمان چند درخواست پردازش میشود؟ |
| مصرف حافظه | مدل در اجرا چه مقدار حافظه نیاز دارد؟ |
| خطا به تفکیک کلاس | آیا بهبود کلی، افت یک کلاس مهم را پنهان کرده است؟ |
| هزینه آموزش | تولید خروجی معلم و آموزش دانشآموز چقدر هزینه داشته است؟ |
موفقیت به محدودیت محصول بستگی دارد. در یک سامانه، کاهش زمان پاسخ با افت جزئی دقت پذیرفتنی است؛ در سامانه دیگر همان افت ممکن است قابل قبول نباشد.
خطا به تفکیک کلاس را بررسی کنید
Accuracyکلی میتواند کاهش عملکرد روی یک کلاس را پنهان کند. برای بررسی اولیه، برچسبها و پیشبینیها را جمعآوری کنید:
from sklearn.metrics import (
    classification_report,
)


def collect_predictions(
    model: nn.Module,
    data_loader: DataLoader,
):
    model.eval()

    true_labels = []
    predicted_labels = []

    with torch.inference_mode():
        for images, labels in (
            data_loader
        ):
            logits = model(
                images.to(
                    device
                )
            )

            predictions = (
                logits.argmax(
                    dim=1
                )
            )

            true_labels.extend(
                labels.tolist()
            )

            predicted_labels.extend(
                predictions
                .cpu()
                .tolist()
            )

    return (
        true_labels,
        predicted_labels,
    )


true_labels, (
    student_predictions
) = collect_predictions(
    student_distilled,
    test_loader,
)

print(
    classification_report(
        true_labels,
        student_predictions,
        digits=4,
    )
)
اگر داده نامتوازن باشد یا بعضی کلاسها اهمیت بیشتری داشته باشند، معیارها را مطابق همان نیاز تنظیم کنید.
تأثیر دما و وزن معلم را چگونه آزمایش کنیم؟
میتوانید چند ترکیب از دما و وزن راهنمایی معلم را روی Validation مقایسه کنید؛ مثلاً چند مقدار محدود برای هرکدام.
اما قواعد ارزیابی را حفظ کنید:
- هر آزمایش با معماری مشخص و ثبتشده اجرا شود.
- Testدر انتخاب تنظیمات استفاده نشود.
- بذر تصادفی و بودجه آموزش ثبت شود.
- دانشآموز معمولی در مقایسه باقی بماند.
- علاوه بر دقت، هزینه و زمان پاسخ نیز اندازهگیری شود.
تغییر دما و وزن Loss دو اثر متفاوت دارند. دما شکل خروجی نرم را تغییر میدهد؛ وزن معلم سهم Loss تقطیر در آموزش را تنظیم میکند. بهینه بودن یکی را نمیتوان مستقل از دیگری فرض کرد.
آیا برای تقطیر حتماً به برچسب واقعی نیاز داریم؟
خیر. در بعضی طراحیها، از دادههای بدون برچسب استفاده میشود و معلم برای آنها خروجی تولید میکند. سپس دانشآموز بر اساس خروجی معلم آموزش میبیند.
اما اگر برچسب واقعی نیز موجود باشد، میتوان آن را وارد آموزش کرد؛ همان کاری که در مثال این مقاله انجام دادیم.
در استفاده از داده بدون برچسب، به این موارد توجه کنید:
- داده باید به محیط استفاده واقعی نزدیک باشد.
- خروجی اشتباه معلم میتواند منتقل شود.
- نمونههای تکراری یا نامناسب ممکن است هزینه تولید خروجی را بالا ببرند.
- مجموعه ارزیابی مستقل و دارای برچسب معتبر همچنان لازم است.
تقطیر دانش برای مدلهای زبانی
در مدلهای زبانی نیز میتوان مدل بزرگتر را برای کمک به آموزش مدل کوچکتر به کار گرفت. بااینحال، روش عملی به نوع دسترسی شما به معلم بستگی دارد.
دسترسی به Logit یا توزیع خروجی
اگر خروجیهای عددی مناسب مدل معلم برای توکنها در دسترس باشد، امکان طراحی تقطیر مبتنی بر توزیع خروجی وجود دارد. پیادهسازی آن از مثال طبقهبندی تصویر پیچیدهتر است؛ بهویژه اگر معلم و دانشآموز توکنساز یا واژگان متفاوتی داشته باشند.
دسترسی فقط به متن پاسخ
اگر معلم از طریق API فقط پاسخ متنی میدهد، همچنان میتوانید از آن برای ساخت داده آموزشی، پاسخهای نمونه یا برچسبهای پیشنهادی کمک بگیرید. اما این حالت همان تقطیر مبتنی بر Logit وSoft Target که در مثال PyTorch اجرا کردیم نیست.
در این مسیر باید کیفیت داده تولیدشده را بررسی کنید، نمونههای اشتباه را کنار بگذارید و دانشآموز را روی پرسشهای مستقل و واقعی ارزیابی کنید.
ارزیابی در کاربرد واقعی
برای مثال، اگر هدف دستهبندی پیامهای فارسی است، تنها شباهت پاسخ دانشآموز به معلم کافی نیست. باید دید:
- برچسبها در نمونههای واقعی چقدر درستاند؟
- موارد مبهم چگونه مدیریت میشوند؟
- عملکرد روی موضوعات جدید چگونه است؟
- هزینه تولید داده و اجرای دانشآموز در مجموع چقدر است؟
- آیا نگهداری مدل اختصاصی از استفاده مستقیم از API بهصرفهتر است؟
استفاده از API درواره بهعنوان بخشی از آزمایش
اگر میخواهید خروجی یک مدل در دسترس از طریق API را برای پیشنهاد برچسب یا تهیه نمونه آموزشی آزمایش کنید، ابتدا شناسه مدل مناسب و قابلیتهای فعلی آن را در درواره بررسی کنید.
کد زیر صرفاً الگوی گرفتن یک برچسب پیشنهادی از پاسخ متنی است؛ Logitمعلم تولید نمیکند و جایگزین کد تقطیر احتمالاتی بخش PyTorch نیست:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ[
"DARVAREH_API_KEY"
],
base_url=(
"https://api.darvareh.ir/v1"
),
)
allowed_labels = {
"فروش",
"پشتیبانی",
"مالی",
}
message = (
"برای پیگیری وضعیت "
"سفارشم راهنمایی میخواهم."
)
response = (
client.chat.completions.create(
model=os.environ[
"DARVAREH_MODEL_ID"
],
messages=[
{
"role": "system",
"content": (
"پیام را فقط در "
"یکی از دستههای "
"فروش، پشتیبانی "
"یا مالی قرار بده. "
"فقط نام دسته را "
"بنویس."
),
},
{
"role": "user",
"content": message,
},
],
)
)
suggested_label = (
response.choices[0]
.message.content
.strip()
)
if (
suggested_label
not in allowed_labels
):
raise ValueError(
"The model returned "
"an unexpected label."
)
print(
suggested_label
)برای استفاده در داده آموزشی، یک پاسخ معتبر از نظر قالب الزاماً برچسب درست نیست. مجموعهای از نمونهها را با برچسب انسانی یا معیار مستقل بررسی کنید و هزینه درخواستهای API را نیز در محاسبه پروژه لحاظ کنید.
چه زمانی تقطیر دانش ارزش بررسی دارد؟
تقطیر زمانی میتواند مفید باشد که:
- معلم کیفیت مناسبی برای مسئله دارد.
- اجرای مستقیم معلم برای حجم درخواست شما پرهزینه یا کند است.
- یک معماری دانشآموز مناسب برای محیط استقرار وجود دارد.
- داده کافی برای آموزش و ارزیابی دارید.
- کاهش هزینه اجرای مداوم، هزینه آموزش و نگهداری دانشآموز را توجیه میکند.
اگر تعداد درخواستها کم است یا وظیفه مرتب تغییر میکند، استفاده مستقیم از مدل آماده ممکن است از نظر زمان توسعه و نگهداری مناسبتر باشد. این تصمیم با اندازهگیری کیفیت و هزینه واقعی گرفته میشود.
محدودیتها و خطاهای رایج
معلم ضعیف یا نامتناسب با دامنه
دانشآموز میتواند بخشی از خطاها و سوگیریهای معلم را تقلید کند. کیفیت معلم را روی داده همان کاربرد بسنجید.
مقایسهنکردن با دانشآموز معمولی
اگر دانشآموز فقط با برچسب واقعی همان کیفیت را میگیرد، هزینه تقطیر ممکن است ارزشی نداشته باشد.
استفاده از Test برای تنظیم دما
دما، وزن Loss و معماری را روی Validation انتخاب کنید. Test را برای ارزیابی نهایی نگه دارید.
فرض برابری اندازه کمتر و سرعت بیشتر
زمان اجرا به معماری، سختافزار، کتابخانه، اندازه Batch و سربار سرویس وابسته است. آن را در محیط هدف اندازه بگیرید.
تغییر ناخواسته وزنهای معلم
در آموزش کلاسیک دانشآموز، معلم باید در حالت ارزیابی باشد و محاسبه خروجی آن نباید گرادیان لازم برای بهروزرسانی وزنهایش بسازد.
توجه صرف به Accuracy میانگین
ممکن است عملکرد یک کلاس مهم افت کند. گزارش تفکیکی تهیه کنید.
فرض اینکه پاسخ متنی API همان Soft Target است
برای تقطیر مبتنی بر توزیع خروجی، دسترسی مناسب به خروجیهای عددی لازم است. پاسخ متنی میتواند برای ساخت نمونه آموزشی مفید باشد، اما روش و محدودیتهای متفاوتی دارد.
نادیدهگرفتن هزینه آموزش
مدل کوچکتر ممکن است در زمان اجرا ارزانتر باشد، اما تولید خروجی معلم برای مجموعه بزرگ و چندین دور آزمایش نیز هزینه دارد.
پرسشهای متداول
Knowledge Distillationچیست؟
روشی برای آموزش یک مدل دانشآموز با کمک خروجی یا نمایشهای یک مدل معلم است. هدف معمول، بهبود عملکرد مدلی است که برای محیط اجرا مناسبتر طراحی شده است.
مدل Teacher و Student چه تفاوتی دارند؟
Teacher مدلی است که پیشتر آموزش دیده و دانشآموز را راهنمایی میکند. Studentمدلی است که در فرایند تقطیر آموزش میبیند و ممکن است کوچکتر یا سریعتر باشد.
Soft Targetچیست؟
خروجی نرم مدل معلم برای چند کلاس است که اطلاعات بیشتری از برچسب قطعی یک کلاس در اختیار فرایند آموزش میگذارد.
Temperatureچه کاری انجام میدهد؟
شکل توزیع خروجی معلم و دانشآموز را در بخش تقطیر تغییر میدهد. مقدار مناسب باید با آزمایش انتخاب شود.
آیا دانشآموز میتواند از معلم بهتر شود؟
در بعضی آزمایشها ممکن است دانشآموز روی یک معیار یا مجموعه داده عملکرد بهتری نشان دهد، اما این نتیجه تضمینشده نیست. روش، داده و استقلال ارزیابی را بررسی کنید.
آیا تقطیر دانش همان Quantization است؟
خیر. تقطیر، دانشآموز را با کمک معلم آموزش میدهد. Quantization شیوه نمایش و محاسبه عددی مدل را تغییر میدهد.
آیا برای تقطیر به GPU نیاز داریم؟
مثالهای کوچک میتوانند روی CPU اجرا شوند، اما آموزش معلم بزرگ و محاسبه خروجی آن برای داده زیاد با GPU سریعتر خواهد بود. نیاز واقعی به اندازه مدل و داده بستگی دارد.
آیا بدون دسترسی به وزنهای معلم میتوان تقطیر کرد؟
اگر معلم خروجی قابل استفاده ارائه کند، برخی روشهای آموزش دانشآموز ممکن است. دسترسی فقط به پاسخ متنی با دسترسی به Logitها یکسان نیست و روش ارزیابی جداگانه میخواهد.
جمعبندی
تقطیر دانش راهی برای آموزش مدل دانشآموز با کمک یک مدل معلم است. در روش کلاسیک، دانشآموز علاوه بر برچسب واقعی، از خروجی نرم معلم نیز یاد میگیرد. دما و وزن بخش تقطیر تعیین میکنند این راهنمایی چگونه وارد آموزش شود.
در مثال PyTorch، یک معلم بزرگتر و دو نسخه هممعماری از دانشآموز ساختیم: یکی با آموزش معمولی و دیگری با تقطیر دانش. مقایسه این دو نسخه نشان میدهد آیا خود فرایند تقطیر برای معماری کوچکتر ارزش ایجاد کرده است یا خیر.
برای تصمیم عملی، دقت تنها معیار نیست. کیفیت به تفکیک کلاس، زمان پاسخ، مصرف حافظه، توان عملیاتی و هزینه تولید داده معلم را نیز باید در محیط واقعی اندازه گرفت.
اگر میخواهید پیش از آموزش و نگهداری مدل اختصاصی، کیفیت مدلهای آماده را برای کاربرد خود بسنجید یا از خروجی آنها برای ساخت مجموعه آزمایشی استفاده کنید، مدلها و خدمات هوش مصنوعی درواره را در darvareh.ir بررسی کنید.
مقالات مرتبط
- PyTorch چیست؟ آموزش یادگیری عمیق با Python
- Transfer Learning و Fine-tuning با PyTorch
- Fine-tuning مدل زبانی با LoRA و QLoRA
- Early Stoppingو ذخیره بهترین مدل
- بیشبرازش و کمبرازش در یادگیری ماشین
- ارزیابی مدل هوش مصنوعی وEvals
- بهینهسازی هزینه عامل هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- مقاله اصلیDistilling the Knowledge in a Neural Network research.google
- راهنمای رسمی Knowledge Distillation درPyTorch PyTorch Tutorials 2.14.0+cu130 documentation
- مستندات KL Divergence درPyTorch PyTorch main documentation
- مستندات دیتاست Fashion-MNIST درTorchVision Torchvision 0.28 documentation
- راهنمای Pruning درPyTorch PyTorch Tutorials 2.14.0+cu130 documentation
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



