
داده گمشده چیست؟ آموزش مدیریت Missing Values با Python و scikit-learn
مقادیر خالی دیتاست را حذف کنیم یا جایگزین؟ در این آموزش، انواع داده گمشده، روشهای Median و KNN، شاخص گمشدگی و مدلهای دارای پشتیبانی مستقیم از NaN را میشناسید و با Python آنها را بدون نشت داده مقایسه میکنید.

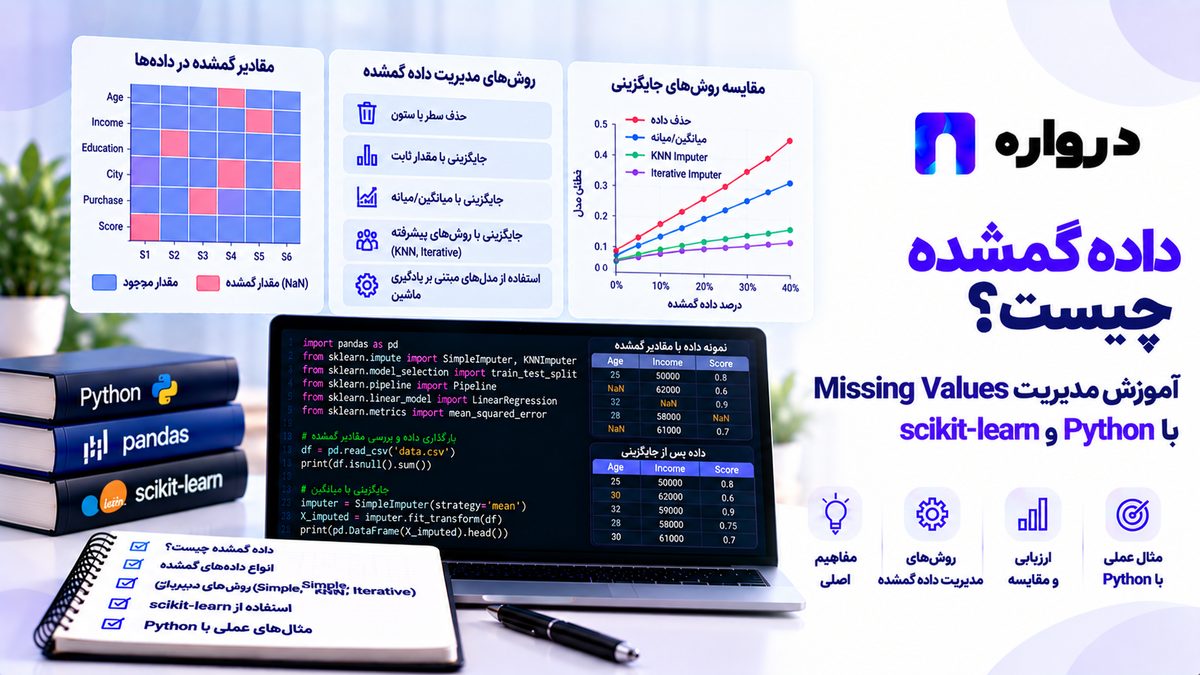
در یک دیتاست واقعی، بهندرت همه خانهها کاملاند. شاید کاربر یک فیلد فرم را پر نکرده باشد، ارتباط با یک سرویس قطع شده باشد، حسگر چند دقیقه داده ثبت نکرده باشد یا اطلاعات یک ویژگی فقط برای بعضی مشتریان جمعآوری شده باشد.
اولین واکنش معمولاً این است: «خانههای خالی را با میانگین پر کنیم.» اما این تصمیم همیشه مناسب نیست. گاهی خودِ خالی بودن یک فیلد اطلاعات مهمی دارد. گاهی مقدار صفر با مقدار نامعلوم اشتباه گرفته شده است. گاهی نیز محاسبه میانگین روی کل دیتاست باعث نشت اطلاعات مجموعه آزمون میشود.
Missing Values یا دادههای گمشده، مقدارهایی هستند که برای برخی مشاهدهها یا ویژگیها در اختیار نداریم. مدیریت درست آنها به سه پرسش وابسته است:
- چرا مقدار ثبت نشده است؟
- در زمان استفاده واقعی، کدام اطلاعات برای جایگزینی آن در دسترساند؟
- کدام روش روی داده مستقل به عملکرد بهتر و قابلاتکاتری میرسد؟
در این مقاله، روشهای تشخیص و مدیریت داده گمشده را بررسی میکنیم و سپس با Python چهار راهکار را در شرایط یکسان مقایسه میکنیم: جایگزینی با میانه، میانه همراه با شاخص گمشدگی، KNNImputer و مدلی که مقدار گمشده را مستقیم میپذیرد.
داده گمشده چه شکلهایی دارد؟
در Python و ابزارهای تحلیل داده، مقدار گمشده ممکن است به شکلهای مختلفی دیده شود:
np.nanبرای بسیاری از دادههای عددیpd.NAدر برخی نوعدادههایpandasNaTبرای تاریخ یا زمان گمشدهNoneدر بعضی ستونها- رشته خالی مانند
"" - کدهای قراردادی مانند
-1یا"نامشخص"
موارد آخر همیشه بهصورت خودکار «گمشده» شناخته نمیشوند. برای مثال، ممکن است یک سامانه مقدار 9999 را به معنای «اطلاعات ثبت نشده» ذخیره کند. اگر معنای این مقدار را ندانید، مدل آن را یک عدد واقعی در نظر میگیرد.
مستندات pandas توضیح میدهد که نمایش مقدار گمشده به نوع داده بستگی دارد و ابزارهایی مانند isna، dropna و fillna برای کار با آنها فراهم شدهاند. pandas 3.0.6 documentation
صفر با داده گمشده فرق دارد
این تفاوت در بسیاری از پروژهها تعیینکننده است:
| مقدار | معنای احتمالی |
|---|---|
تعداد سفارش 0 | میدانیم هیچ سفارشی ثبت نشده است |
| تعداد سفارش گمشده | نمیدانیم چند سفارش ثبت شده است |
مدت انتظار 0 | پاسخ بدون انتظار ثبت شده است |
| مدت انتظار گمشده | زمان انتظار اندازهگیری نشده است |
جایگزینی بیبررسی همه مقدارهای خالی با صفر میتواند الگوی نادرستی به مدل بدهد.
چرا داده گمشده ایجاد میشود؟
چند علت رایج عبارتاند از:
- فیلد فرم اختیاری بوده است.
- کاربر از ثبت یک نوع اطلاعات صرفنظر کرده است.
- حسگر یا سامانه جمعآوری داده در دسترس نبوده است.
- اطلاعات هنوز تولید نشده است.
- داده در یکی از مراحل انتقال حذف شده است.
- یک ویژگی فقط برای گروه خاصی از نمونهها تعریف میشود.
- مقدار ثبت شده، اما در هنگام اتصال چند جدول پیدا نشده است.
- بعضی رکوردها از نسخه قدیمی محصول آمدهاند که آن فیلد را نداشته است.
تشخیص علت اهمیت دارد؛ زیرا «نامعلوم بودن موقت»، «تعریفنشدن ویژگی» و «خطای ثبت داده» الزاماً نباید یکسان پردازش شوند.
MCAR، MAR و MNARچیست؟
در مباحث آماری، سه توصیف شناختهشده برای سازوکار گمشدن داده وجود دارد. این دستهبندی با کارهای دونالد روبین درباره استنباط از داده ناقص مرتبط است. Oxford Academic
MCAR:گمشدن کاملاً تصادفی
Missing Completely at Random یعنی احتمال گمشدن مقدار به مقدار واقعی آن یا اطلاعات مشاهدهشده مرتبط نیست.
برای مثال، اگر یک نقص تصادفی ثبت داده باعث شود تعدادی از ردیفها بدون ارتباط با ویژگیهای کاربران حذف شوند، ممکن است این وضعیت به MCAR نزدیک باشد.
در عمل نباید بدون بررسی چنین فرضی را پذیرفت.
MAR:گمشدن وابسته به دادههای مشاهدهشده
Missing at Random در معنای آماری آن یعنی پس از در نظر گرفتن اطلاعات مشاهدهشده مناسب، احتمال گمشدن به مقدارِ مشاهدهنشده وابستگی بیشتری ندارد.
نام MAR ممکن است گمراهکننده باشد؛ این حالت به معنای «کاملاً تصادفی بودن» گمشدن داده نیست.
برای مثال، ممکن است احتمال خالی ماندن یک فیلد به نسخه فرم ثبتنام وابسته باشد و نسخه فرم در داده موجود باشد.
MNAR:گمشدن وابسته به مقدار مشاهدهنشده
Missing Not at Random زمانی مطرح میشود که حتی پس از در نظر گرفتن دادههای مشاهدهشده، احتمال گمشدن همچنان با مقدار خودِ اطلاعات گمشده مرتبط باشد.
برای مثال، در یک نظرسنجی ممکن است افراد دارای پاسخهای خاص بیشتر از پاسخدادن به همان سؤال خودداری کنند. در چنین شرایطی، جایگزینی ساده با میانگین میتواند تصویر داده را منحرف کند.
نکته مهم: صرفاً از روی جدول ناقص نمیتوان با قطعیت سازوکار گمشدن را تعیین کرد. شناخت فرایند جمعآوری داده و بررسی با متخصص حوزه لازم است.
اولین قدم: اندازه و الگوی گمشدگی را ببینید
پیش از انتخاب روش جایگزینی، این پرسشها را پاسخ دهید:
- در هر ستون چه سهمی از مقدارها گمشدهاند؟
- چند ردیف دستکم یک مقدار گمشده دارند؟
- آیا گمشدگی در یک دوره زمانی خاص بیشتر است؟
- آیا نسخه محصول یا منبع داده بر آن اثر دارد؟
- آیا چند ستون معمولاً با هم خالی میشوند؟
- آیا گمشدگی در گروههای مختلف کاربران متفاوت است؟
برای بررسی اولیه درpandas:
import pandas as pd


missing_count = (
    dataframe
    .isna()
    .sum()
)

missing_rate = (
    dataframe
    .isna()
    .mean()
    .mul(100)
)

missing_report = (
    pd.DataFrame(
        {
            "missing_count": missing_count,
            "missing_percent": missing_rate,
        }
    )
    .sort_values(
        "missing_percent",
        ascending=False,
    )
)

print(missing_report)
isna() فقط مقدارهایی را تشخیص میدهد که pandas آنها را واقعاً گمشده میشناسد. اگر دیتاست از کدهایی مانند "N/A"، رشته خالی یا -999 استفاده میکند، باید معنای آنها را پیش از تحلیل مشخص کنید.
روشهای اصلی مدیریت داده گمشده
۱. اصلاح مشکل در منبع داده
اگر مقدار بهدلیل خطای انتقال یا اتصال جدول گمشده است، بهترین راه ممکن است اصلاح مسیر تولید داده باشد.
جایگزینی آماری، خطای یک JOIN اشتباه یا نقص ثبت رویداد را حل نمیکند. در چنین مواردی ابتدا باید مشخص شود آیا داده اصلی قابل بازیابی است یا خیر.
۲. حذف ردیفهای ناقص
اگر تعداد ردیفهای ناقص کم باشد و حذف آنها نتیجه را منحرف نکند، حذف میتواند گزینهای ساده باشد:
complete_rows = (
    dataframe.dropna()
)
اما این روش ممکن است:
- بخش مهمی از نمونهها را حذف کند.
- ترکیب گروههای داده را تغییر دهد.
- نمونههای دشوارتر یا کمدسترسیتر را بیشتر کنار بگذارد.
- تعداد نمونههای آموزش را بیش از حد کم کند.
حذف ردیفها یک تصمیم مدلسازی است، نه صرفاً یک دستور پاکسازی.
۳. حذف ستونهای ناقص
اگر ستونی مقدار گمشده بسیار زیادی دارد و در زمان استفاده عملی نیز بهندرت موجود است، حذف آن میتواند بررسی شود.
بااینحال، درصد گمشدگی بهتنهایی معیار کافی نیست. یک ویژگی که فقط برای ۲۰ درصد نمونهها موجود است ممکن است برای همان گروه ارزش بالایی داشته باشد. همچنین باید دید آیا نبود آن ویژگی خود حامل اطلاعات است یا خیر.
۴. جایگزینی با مقدار ثابت
برای بعضی ویژگیها میتوان مقدار ثابتی مانند "نامشخص" تعریف کرد. این روش برای داده دستهای رایجتر است.
برای داده عددی، مقدار ثابت باید با دقت انتخاب شود. اگر 0 در داده یک مقدار واقعی و معنادار است، استفاده از آن برای «نامعلوم» ممکن است دو وضعیت متفاوت را مخلوط کند.
۵. جایگزینی با میانگین، میانه یا پرتکرارترین مقدار
SimpleImputer در scikit-learn روشهای سادهای مانند موارد زیر را فراهم میکند:
mean: میانگینmedian: میانهmost_frequent: پرتکرارترین مقدارconstant: مقدار ثابت
برای ویژگی عددی با مقدارهای بسیار بزرگ یا توزیع نامتقارن، میانه میتواند نقطه شروع مناسبتری از میانگین باشد. این یک قاعده قطعی نیست؛ روش را باید بر اساس داده و عملکرد نهایی مقایسه کرد. scikit-learn 1.9.0 documentation
۶. جایگزینی بر اساس همسایهها باKNN
KNNImputer برای تخمین یک مقدار گمشده از نمونههای مشابه استفاده میکند.
این روش ممکن است رابطه میان چند ویژگی را بهتر از جایگزینی مستقل هر ستون در نظر بگیرد، اما:
- به تعریف فاصله وابسته است.
- با تفاوت مقیاس ویژگیها حساس میشود.
- میتواند روی داده بزرگ پرهزینه باشد.
- تضمین نمیکند از روش ساده بهتر شود.
۷. جایگزینی چندمتغیره یاIterative Imputation
IterativeImputer بهصورت تکراری از سایر ویژگیها برای تخمین ویژگیهای ناقص استفاده میکند. این روش انعطاف بیشتری دارد، اما هزینه و پیچیدگی بیشتری نیز به همراه میآورد.
در مستندات scikit-learn، دسترسی به آن همچنان به فعالسازی بخش experimental وابسته است؛ بنابراین پیش از استفاده، نسخه کتابخانه و محدودیتهای API را بررسی کنید. scikit-learn 1.9.1 documentation
برای بسیاری از مسئلههای پیشبینی، ابتدا باید یک مبنای ساده با میانه یا مقدار پرتکرار ساخت و سپس بررسی کرد روش پیچیدهتر واقعاً بهبود میدهد یا خیر.
۸. استفاده از مدلی که NaN را مستقیم میپذیرد
برخی مدلها میتوانند هنگام آموزش و پیشبینی با مقدار گمشده کار کنند. برای مثال، HistGradientBoostingClassifier در scikit-learn از مقدارهای NaN پشتیبانی مستقیم دارد. scikit-learn 1.9.0 documentation
پشتیبانی مستقیم از NaN به معنای حلشدن مسئله کیفیت داده نیست. همچنان باید علت گمشدن، تغییر الگو در زمان و سازگاری داده آموزش با محیط واقعی بررسی شود.
شاخص گمشدگی یا Missing Indicator چیست؟
گاهی خودِ «خالی بودن» یک ویژگی برای مدل مفید است.
فرض کنید مقدار «نوع دستگاه» در نسخه قدیمی یک برنامه ثبت نمیشده، اما در نسخه جدید موجود است. اگر نسخه برنامه با الگوی استفاده کاربران ارتباط داشته باشد، خالی بودن این ستون نیز ممکن است اطلاعاتی به مدل بدهد.
Missing Indicator یک ستون دودویی میسازد که مشخص میکند مقدار اصلی موجود بوده است یا خیر.
در SimpleImputer میتوان این گزینه را فعال کرد:
from sklearn.impute import SimpleImputer


imputer = SimpleImputer(
    strategy="median",
    add_indicator=True,
)
البته ممکن است شاخص گمشدگی در یک دیتاست مفید و در دیتاست دیگر بیاثر یا گمراهکننده باشد. آن را روی داده مستقل ارزیابی کنید.
نکته اجرایی: وقتی add_indicator=True است، این شاخصها برای ویژگیهایی ساخته میشوند که هنگام fit گمشدگی داشتهاند. اگر ستونی فقط پس از استقرار شروع به گمشدن کند، باید رفتار Pipeline و پایش داده را جداگانه بررسی کرد. scikit-learn 1.9.0 documentation
آموزش عملی: مقایسه روشها باPython
در مثال زیر یک مسئله طبقهبندی ساختگی میسازیم و بخشی از ویژگیها را گمشده قرار میدهیم. سپس چهار مسیر را مقایسه میکنیم:
- میانه + رگرسیون لجستیک
- میانه + شاخص گمشدگی + رگرسیون لجستیک
- مقیاسبندی + KNN Imputation + رگرسیون لجستیک
- مدل درختی با پشتیبانی مستقیم ازNaN
هدف، آموزش روش مقایسه منصفانه است. نتایج داده ساختگی را نباید به یک دیتاست واقعی تعمیم داد.
نصب کتابخانهها
pip install numpy pandas scikit-learn matplotlibساخت داده ناقص
import numpy as npimport pandas as pdfrom sklearn.datasets import ( make_classification,)RANDOM_STATE = 42X_complete, y = ( make_classification( n_samples=1800, n_features=12, n_informative=6, n_redundant=2, weights=[ 0.70, 0.30, ], random_state=RANDOM_STATE, ))feature_names = [ f"feature_{index}" for index in range( X_complete.shape[1] )]rng = np.random.default_rng( RANDOM_STATE)missing_mask = (در این مثال عمداً گمشدگی همه ستونها یکسان نیست. در داده واقعی باید سازوکار گمشدن از مسیر جمعآوری اطلاعات بررسی شود؛ ساخت مصنوعی بالا صرفاً برای آزمایش روشهای جایگزینی است.
بررسی الگوی اولیه
missing_percent = ( X.isna() .mean() .mul(100) .sort_values( ascending=False ))print( missing_percent)rows_with_missing = ( X.isna() .any(axis=1) .mean())print( "Rows with at least one " "missing value:", rows_with_missing,)اگر نرخ گمشدگی در یک ستون بسیار متفاوت است، علت را بررسی کنید. حتی توزیع گمشدگی در دورههای مختلف میتواند مهمتر از درصد کلی آن باشد.
تفکیک Train، Validation وTest
پیش از آموزش جایگزینکننده، داده را تفکیک میکنیم:
from sklearn.model_selection import (
    train_test_split,
)


X_development, (
    X_test
), y_development, (
    y_test
) = train_test_split(
    X,
    y,
    test_size=0.20,
    stratify=y,
    random_state=RANDOM_STATE,
)

X_train, (
    X_val
), y_train, (
    y_val
) = train_test_split(
    X_development,
    y_development,
    test_size=0.25,
    stratify=y_development,
    random_state=RANDOM_STATE,
)

print(
    "Train:",
    len(X_train),
)

print(
    "Validation:",
    len(X_val),
)

print(
    "Test:",
    len(X_test),
)جایگزینکردن مقدارهای خالی پیش از این تفکیک میتواند اطلاعات مجموعه Validation و Test را وارد آمار آموزش کند. مستندات scikit-learn توصیه میکند تفکیک پیش از مراحل پیشپردازشِ یادگیرنده انجام شود و برای جلوگیری از نشت از Pipeline استفاده شود. scikit-learn.org
ساخت چهار مسیر مقایسه
from sklearn.ensemble import ( HistGradientBoostingClassifier,)from sklearn.impute import ( KNNImputer, SimpleImputer,)from sklearn.linear_model import ( LogisticRegression,)from sklearn.pipeline import ( make_pipeline,)from sklearn.preprocessing import ( StandardScaler,)models = { "Median": make_pipeline( SimpleImputer( strategy="median", ), StandardScaler(), LogisticRegression( max_iter=1000, random_state=RANDOM_STATE, ), ), "Median + Indicator": ( make_pipeline(در مسیرKNN، StandardScaler پیش از KNNImputer آمده است تا مقیاس ستونها در محاسبه فاصله نقش نامتناسب نداشته باشد. مستندات scikit-learn تصریح میکند StandardScaler مقدارهای NaN را هنگام یادگیری آمار نادیده میگیرد و هنگام تبدیل، آنها را حفظ میکند؛ بنابراین مرحله بعدی هنوز مقدارهای گمشده را میبیند. scikit-learn 1.8.0 documentation
در داده واقعی با ویژگیهای عددی و دستهای، معمولاً باید برای هر نوع ستون مسیر مناسب جداگانه ساخت؛ نمونه آن را پایینتر میبینیم.
آموزش و ارزیابی رویValidation
در این مثال از ROC AUC و Average Precision استفاده میکنیم. چون سهم کلاس مثبت ۳۰ درصد است، بررسی عملکرد کلاس مثبت در کنار ROC AUC مفید است.
from sklearn.metrics import ( average_precision_score, roc_auc_score,)validation_results = {}for name, model in models.items(): model.fit( X_train, y_train, ) probabilities = ( model.predict_proba( X_val )[:, 1] ) roc_auc = ( roc_auc_score( y_val, probabilities, ) ) average_precision = ( average_precision_score( y_val, probabilities, ) ) validation_results[ nameاز پیش نمیتوان گفت کدام روش بهترین خواهد بود. ممکن است جایگزینی ساده با میانه از KNN بهتر عمل کند یا مدل دارای پشتیبانی مستقیم از NaN برنده شود. نتیجه به ساختار داده، الگوی گمشدگی و مدل نهایی بستگی دارد.
مستندات SimpleImputer نیز یادآوری میکند که جایگزینی ساده همراه با یک یادگیرنده مناسب میتواند در برخی مسئلهها همسطح یا بهتر از روشهای پیچیدهتر عمل کند. scikit-learn 1.8.0 documentation
انتخاب روش و ارزیابی نهایی
برای مثال، روش دارای بیشترین Average Precision روی Validation را انتخاب میکنیم:
best_name = max(
    validation_results,
    key=lambda name: (
        validation_results[
            name
        ]["average_precision"]
    ),
)

best_model = (
    models[
        best_name
    ]
)

print(
    "Selected approach:",
    best_name,
)
اکنون فقط یک بار روی Test مستقل ارزیابی میکنیم:
from sklearn.metrics import (
    classification_report,
)


test_probabilities = (
    best_model.predict_proba(
        X_test
    )[:, 1]
)

test_predictions = (
    test_probabilities
    >= 0.5
).astype(int)

print(
    "Test ROC AUC:",
    roc_auc_score(
        y_test,
        test_probabilities,
    ),
)

print(
    "Test Average Precision:",
    average_precision_score(
        y_test,
        test_probabilities,
    ),
)

print(
    classification_report(
        y_test,
        test_predictions,
        digits=4,
        zero_division=0,
    )
)
آستانه ۰٫۵ در این کد فقط برای گزارش نمونهای برچسبهاست. اگر هزینه از دست دادن کلاس مثبت و هزینه هشدار اشتباه متفاوت است، آستانه را رویValidation و متناسب با هدف عملی انتخاب کنید.
همچنین اگر چند روش روی Validation اختلاف بسیار کوچکی دارند، برای تصمیم مهم باید پایداری نتیجه را روی تقسیمهای مناسب دیگر یا بازههای زمانی مستقل بررسی کرد.
آیا پس از انتخاب، باید مدل را دوباره آموزش داد؟
برای استقرار معمولاً میتوان روش انتخابشده را با دادههای توسعه مجاز، یعنی Train و Validation، دوباره آموزش داد. اما در این صورت باید همان روش ثابتشده را نگه دارید و ارزیابی آن نسخه را با یک مجموعه مستقل انجام دهید. از Test برای تغییر دوباره انتخابها استفاده نکنید.
در کد آموزشی بالا، برای شفافیت ارزیابی، مدل آموزشدیده روی Train را مستقیم روی Test سنجیدیم.
اگر مقدار گمشده را با pandas پر کنیم، چه خطری دارد؟
دستور زیر برای تحلیل سریع راحت است، اما اگر پیش از تفکیک داده اجرا شود، میانه کل دیتاست را یاد میگیرد:
# برای ارزیابی مدل، این ترتیب اشتباه است.
filled_all = X.fillna(
    X.median()
)
روش درست آن است که آماری مانند میانه فقط از Train یاد گرفته شود و همان مقدار برای Validation، Test و داده عملیاتی به کار رود.
استفاده از Pipeline این رفتار را در کنار مدل نگه میدارد و احتمال اختلاف میان کد آموزش و کد پیشبینی را کاهش میدهد.
جایگزینی داده دستهای
برای ستونهایی مانند نوع درخواست، کانال ارتباطی یا شهر، جایگزینی عددی با میانه معنا ندارد. یک مسیر رایج این است:
- مقدار گمشده را با پرتکرارترین دسته یا یک دسته «نامشخص» جایگزین کنید.
- دستهها را برای مدل عددی رمزگذاری کنید.
- همه مراحل را داخل Pipeline قرار دهید.
نمونه با ColumnTransformer:
from sklearn.compose import (
    ColumnTransformer,
)

from sklearn.impute import (
    SimpleImputer,
)

from sklearn.linear_model import (
    LogisticRegression,
)

from sklearn.pipeline import (
    Pipeline,
)

from sklearn.preprocessing import (
    OneHotEncoder,
    StandardScaler,
)


numeric_columns = [
    "ticket_count",
    "waiting_hours",
]

categorical_columns = [
    "request_channel",
    "product_group",
]

numeric_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy="median",
            ),
        ),
        (
            "scaler",
            StandardScaler(),
        ),
    ]
)

categorical_pipeline = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(
                strategy=(
                    "most_frequent"
                ),
            ),
        ),
        (
            "encoder",
            OneHotEncoder(
                handle_unknown=(
                    "ignore"
                ),
            ),
        ),
    ]
)

preprocessor = ColumnTransformer(
    transformers=[
        (
            "numeric",
            numeric_pipeline,
            numeric_columns,
        ),
        (
            "categorical",
            categorical_pipeline,
            categorical_columns,
        ),
    ]
)

mixed_data_model = Pipeline(
    steps=[
        (
            "preprocessor",
            preprocessor,
        ),
        (
            "classifier",
            LogisticRegression(
                max_iter=1000,
            ),
        ),
    ]
)
این قطعه یک قالب برای دیتاست جدولی واقعی با ستونهای نامبرده است. روی دیتاست ساختگی بخش قبل اجرا نمیشود، چون آن دیتاست چنین ستونهایی ندارد.
اگر مقدار «نامشخص» از نظر کسبوکار با دستههای شناختهشده تفاوت مهمی دارد، استفاده از دسته ثابت بهجای پرتکرارترین مقدار نیز ارزش آزمایش دارد.
چه زمانی حذف ردیف بهتر از Imputation است؟
حذف ردیف میتواند زمانی قابل دفاع باشد که:
- سهم ردیفهای ناقص بسیار کم باشد.
- علت گمشدگی را بررسی کرده باشید.
- حذف، گروه مهمی از نمونهها را نامتناسب کنار نگذارد.
- در زمان استفاده واقعی نیز سیاست برخورد با چنین ردیفهایی مشخص باشد.
مثلاً اگر در زمان استقرار برای هر درخواست ناقص مجبورید باز هم پیشبینی تولید کنید، مدلی که فقط با حذف درخواستهای ناقص ارزیابی شده، مسئله واقعی را بهطور کامل حل نمیکند.
چه زمانی شاخص گمشدگی مفید است؟
شاخص گمشدگی ممکن است مفید باشد وقتی فرایند خالیماندن یک فیلد با نتیجه مورد پیشبینی رابطه دارد.
اما این رابطه باید با دقت تفسیر شود. شاید شاخص فقط نسخه فعلی فرم یا یک اختلال موقت سامانه را شناسایی میکند. اگر فرایند ثبت داده تغییر کند، رابطه آن با برچسب نیز ممکن است از بین برود.
بنابراین علاوه بر ارزیابی کلی، بررسی کنید:
- نرخ گمشدگی در زمان چگونه تغییر میکند؟
- آیا برای گروههای مختلف یکسان است؟
- اگر فرم یا سرویس جمعآوری داده تغییر کند، مدل چه رفتاری خواهد داشت؟
داده گمشده در سری زمانی
در سری زمانی، جایگزینی مقدار خالی با «مقدار بعدی» میتواند به معنی استفاده از آینده باشد. حتی پرکردن با میانگین کل دوره نیز برای ارزیابی آینده خطر نشت اطلاعات دارد.
بسته به مسئله، گزینهها میتوانند شامل موارد زیر باشند:
- حفظ مقدار گمشده و استفاده از مدلی که آن را میپذیرد
- استفاده از آخرین مقدار در دسترس تا زمان پیشبینی
- مدلسازی جداگانه قطع ثبت داده
- حذف دورههایی که داده معتبر ندارند
- بازسازی داده از منبع اصلی
همچنین باید روشن شود روزی که هیچ رویدادی رخ نداده با روزی که داده آن ثبت نشده چه تفاوتی دارد. برای طراحی آزمون زمانی، مقاله پیشبینی سری زمانی باPython را نیز ببینید.
آیا IterativeImputer همیشه دقیقتر است؟
خیر. این روش از روابط بین ویژگیها برای تخمین مقادیر استفاده میکند، اما اگر این روابط در داده کمنمونه ناپایدار باشند یا پس از استقرار تغییر کنند، پیچیدگی بیشتر الزاماً به پیشبینی بهتر منجر نمیشود.
افزون بر این، باید میان دو هدف فرق گذاشت:
- پیشبینی هدف نهایی: بهترین روش، روشی است که کیفیت مدل نهایی را روی داده مستقل بهتر کند.
- بازسازی خودِ مقدار گمشده: باید کیفیت مقدار بازسازیشده و فرضهای آماری آن جداگانه سنجیده شود.
ممکن است روشی در بازسازی یک ستون بهتر باشد، اما برای پیشبینی هدف اصلی مزیت عملی ایجاد نکند.
داده کاملاً گمشده در یک ستون
اگر یک ستون در Train هیچ مقدار مشاهدهشدهای ندارد، محاسبه میانگین یا میانه آن ممکن نیست.
پیش از مدلسازی باید تصمیم بگیرید:
- آیا این ستون باید از ورودی حذف شود؟
- آیا داده آن از منبع دیگری قابل بازیابی است؟
- آیا در آینده مقدارهای واقعی آن ظاهر خواهند شد؟
- آیا لازم است ساختار ستون در خروجی پیشپردازش حفظ شود؟
در scikit-learn گزینه keep_empty_features برای برخی Imputerها به حفظ ستونهایی که هنگام fit کاملاً گمشده بودهاند کمک میکند. معنای مقدار جایگزین و اثر آن بر مدل باید آگاهانه بررسی شود. scikit-learn 1.9.0 documentation
داده گمشده در محصول وAPI
در یک سرویس واقعی، همه دادههای ناقص لزوماً باید به مدل سپرده شوند. گاهی پاسخ درست در سطح محصول تعریف میشود:
- درخواست از کاربر برای تکمیل یک فیلد ضروری
- ادامه فرایند با یک مقدار پیشفرض شفاف
- ارجاع پرونده به بررسی انسانی
- نمایش اینکه پیشبینی با داده ناقص انجام شده است
- توقف تصمیم خودکار وقتی اطلاعات لازم در دسترس نیست
برای مثال، اگر مدل اولویت درخواست پشتیبانی را تعیین میکند، مشخص کنید در نبود متن پیام یا شناسه محصول چه اقدامی باید انجام شود. جایگزینی عددی نمیتواند نبود اطلاعات اصلی مسئله را جبران کند.
اشتباهات رایج در مدیریت داده گمشده
پرکردن تمام ستونها با صفر
صفر ممکن است یک مقدار واقعی باشد. این کار میتواند «نامعلوم» و «واقعاً صفر» را مخلوط کند.
محاسبه میانه روی کل دیتاست
اگر میانه از Validation و Test نیز تأثیر بگیرد، ارزیابی دیگر کاملاً مستقل نیست.
حذف همه ردیفهای ناقص بدون بررسی
ممکن است حجم زیادی از داده یا یک گروه مشخص را کنار بگذارید و توزیع نمونهها تغییر کند.
استفاده از KNN بدون توجه به مقیاس
اگر یک ستون در بازه میلیون و دیگری در بازه صفر تا یک باشد، فاصلهسنجی میتواند تحت تأثیر مقیاس قرار بگیرد.
فرض اینکه Imputation مقدار واقعی را بازیابی میکند
مقدار جایگزین یک برآورد یا قاعده پردازشی است. اگر مقدار واقعی ثبت نشده، معمولاً نمیدانیم همان عدد چه بوده است.
ارزیابی فقط روی داده کامل
اگر محصول در عمل داده ناقص دریافت میکند، آزمون فقط روی ردیفهای کامل تصویر مناسبی از عملکرد واقعی نمیدهد.
نادیده گرفتن تغییر فرایند ثبت داده
ممکن است پس از تغییر فرم یا نسخه اپلیکیشن، نرخ گمشدگی یک ستون کاهش یا افزایش یابد. مدل باید پس از این تغییر دوباره پایش شود.
چگونه کیفیت راهکار را بعد از استقرار پایش کنیم؟
در کنار معیارهای عملکرد مدل، این شاخصها را ثبت کنید:
- درصد مقدارهای گمشده در هر ستون
- درصد درخواستهای دارای دستکم یک مقدار گمشده
- تغییر نرخ گمشدگی به تفکیک زمان و نسخه محصول
- نرخ گمشدگی به تفکیک منبع داده
- سهم پیشبینیهای انجامشده با داده ناقص
- عملکرد مدل برای نمونههای کامل و ناقص بهصورت جداگانه
- تعداد نمونههایی که بهدلیل نبود داده به بررسی انسانی ارجاع شدهاند
اگر نرخ گمشدگی ناگهان افزایش یافت، پیش از بازآموزی مدل، مسیر جمعآوری و انتقال داده را بررسی کنید.
پرسشهای متداول
Missing Valuesچیست؟
مقادیر مربوط به برخی خانههای دیتاست است که موجود، ثبت یا قابل استفاده نیستند. علت گمشدن باید بررسی شود.
NaN در Pythonبه چه معناست؟
NaN یکی از نمایشهای رایج مقدار عددی ناموجود یا نامعتبر است. در pandas بسته به نوع ستون، نمایشهای دیگری مانند pd.NA و NaT نیز وجود دارند.
داده گمشده را حذف کنیم یا جایگزین؟
پاسخ ثابت وجود ندارد. میزان و علت گمشدگی، هدف تحلیل، شرایط استقرار و نتیجه ارزیابی مستقل تعیین میکنند کدام راه مناسبتر است.
میانگین بهتر است یا میانه؟
برای داده عددی نامتقارن یا دارای مقدارهای بسیار بزرگ، میانه میتواند نقطه شروع مناسبی باشد. برای انتخاب نهایی، هر روش را در Pipeline و روی داده مستقل ارزیابی کنید.
KNNImputerچیست؟
روشی برای جایگزینی مقدارهای گمشده با استفاده از نمونههای نزدیک است. کیفیت آن به ویژگیها، مقیاس، تعریف فاصله و ساختار داده وابسته است.
Missing Indicatorچه کاربردی دارد؟
اطلاعات «موجود بودن یا نبودن مقدار» را بهصورت ویژگی جداگانه به مدل میدهد. مفید بودن آن باید آزمایش شود.
آیا همه مدلهای scikit-learn مقدار NaN را میپذیرند؟
خیر. بعضی مدلها به جایگزینی مقدار نیاز دارند. برخی دیگر، مانند HistGradientBoostingClassifier، پشتیبانی مستقیم از NaN دارند.
آیا جایگزینی داده قبل از Train/Test Split اشتباه است؟
اگر روش جایگزینی پارامترهایی مانند میانگین، میانه یا همسایهها را از داده یاد بگیرد، انجام آن پیش از تفکیک میتواند موجب نشت اطلاعات شود. ابتدا تقسیم کنید و مرحله جایگزینی را داخل Pipeline قرار دهید.
MCAR، MAR و MNARرا میتوان از روی درصد داده گمشده تشخیص داد؟
خیر. درصد گمشدگی بهتنهایی سازوکار آن را مشخص نمیکند. شناخت فرایند ثبت داده و بررسی فرضهای آماری لازم است.
جمعبندی
مدیریت داده گمشده از دستور fillna آغاز نمیشود؛ ابتدا باید بفهمید چه چیزی، چرا و در چه زمانی گمشده است. صفر با نامعلوم فرق دارد و یک مقدار خالی ممکن است ناشی از رفتار کاربر، نقص فنی یا ساختار خود فرایند باشد.
در مثال Python، چهار روش را با تفکیک Train، Validation و Test مقایسه کردیم. جایگزینی با میانه یک مبنای ساده فراهم کرد؛ شاخص گمشدگی امکان استفاده از الگوی نبود داده را داد؛ KNN از نمونههای نزدیک استفاده کرد؛ و یک مدل درختی مقدار NaN را مستقیم دریافت کرد.
بهترین روش را باید بر اساس هدف نهایی و ارزیابی مستقل انتخاب کرد. در محصول واقعی نیز لازم است نرخ گمشدگی، تغییر فرایند ثبت داده و عملکرد روی نمونههای ناقص بهطور پیوسته بررسی شود.
از داده ناقص تا قابلیت هوشمند قابل استفاده
اگر در حال ساخت تحلیل پیام، دستهبندی درخواست یا قابلیتهای هوشمند برای محصول خود هستید، کیفیت داده ورودی و رفتار سامانه در مواجهه با فیلدهای خالی را از ابتدا تعریف کنید. در کنار مدل، مشخص کنید کدام موارد باید تکمیل شوند و کدام موارد به بررسی انسانی نیاز دارند.
برای آشنایی با خدمات و زیرساخت هوش مصنوعی درواره و بررسی راههای افزودن قابلیتهای هوشمند به محصول، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- نشت داده در یادگیری ماشین و پیشگیری باPipeline
- آموزش تحلیل داده باPandas
- آموزش scikit-learn باPython
- مهندسی ویژگی و انتخاب ویژگی
- پیشبینی سری زمانی با SARIMA وProphet
- داده نامتوازن وSMOTE
- ارزیابی مدل هوش مصنوعی وEvals
- آموزش استفاده از API هوش مصنوعی
منابع
- مستندات pandas درباره داده گمشده pandas 3.0.6 documentation
- مستندات SimpleImputer درscikit-learn scikit-learn 1.9.0 documentation
- مستندات ابزارهای Imputation درscikit-learn scikit-learn 1.9.1 documentation
- مستندات HistGradientBoostingClassifier و پشتیبانی ازNaN scikit-learn 1.9.0 documentation
- مستندات scikit-learn درباره خطاهای رایج و نشت داده scikit-learn.org
- مقاله اصلی Rubin درباره استنباط از داده ناقص Oxford Academic
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



