
FlashAttention چیست؟ آموزش Attention سریع و کمحافظه با PyTorch
FlashAttention چیست و چگونه اجرای Attention را سریعتر و کمحافظهتر میکند؟ در این آموزش، تفاوت آن با Attention معمولی، نقش حافظه GPU، ارتباطش با KV Cache و روش بررسی و بنچمارک آن با PyTorchرا میآموزید.

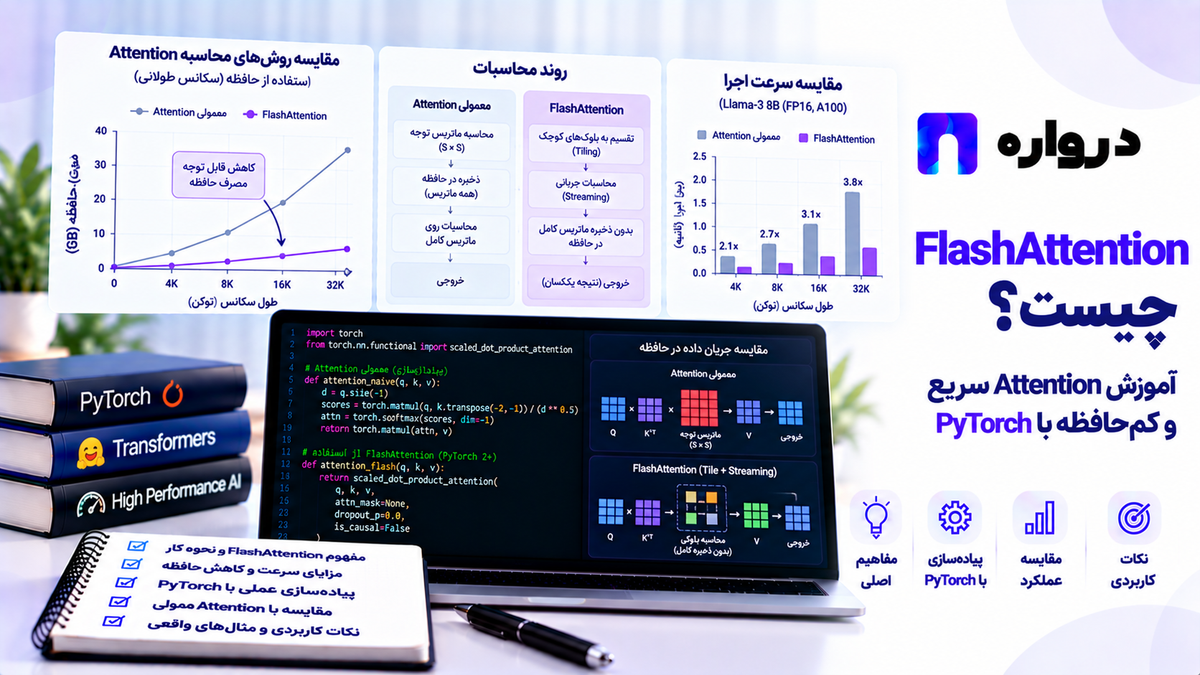
FlashAttention روشی برای اجرای کارآمدتر عملیات Attention در مدلهای Transformer است. ایده اصلی آن این است که دادهها در بلوکهای مناسب پردازش شوند و رفتوآمد پرهزینه میان بخشهای مختلف حافظه GPU کاهش یابد.
در پیادهسازی ساده Attention، معمولاً ماتریس بزرگی از ارتباط میان توکنها ساخته و در حافظه GPU نگهداری میشود. با افزایش طول متن، این ماتریس بزرگتر میشود. FlashAttention محاسبه را به شکلی سازماندهی میکند که نیاز به نگهداری کامل این ماتریس در حافظه اصلی GPU کاهش یابد.
نتیجه میتواند مصرف حافظه کمتر و اجرای سریعتر باشد؛ اما میزان بهبود به مدل، طول دنباله، نوع عملیات، سختافزار و پیادهسازی بستگی دارد.
FlashAttention الگوریتمی برای تقریبزدن پاسخ مدل یا حذف دلخواه بخشی از Attentionنیست. نسخه اصلی آن برای محاسبه Attention دقیق، با سازماندهی متفاوت عملیات و جابهجایی داده طراحی شده است. البته «دقیق» در اینجا به معنای یکسانبودن بیتبهبیت نتایج همه پیادهسازیهای ممیز شناور نیست. arxiv.org
در این مقاله بررسی میکنیم:
- Attentionمعمولی کجا حافظه زیادی مصرف میکند؟
- FlashAttentionچگونه این مسئله را مدیریت میکند؟
- تفاوت FlashAttention و KV Cache چیست؟
- FlashAttention-2چه تغییری ایجاد کرد؟
- چگونه با PyTorch مسیر اجرای Attention را انتخاب کنیم؟
- چگونه سرعت و حافظه را بدون نتیجهگیری نادرست بسنجیم؟
برای فهم FlashAttention، ابتدا Attention را بشناسیم
در Transformer، سازوکار Attention به مدل کمک میکند هنگام پردازش یک توکن، اطلاعات توکنهای دیگر را با وزنهای متفاوت در نظر بگیرد.
برای اجرای آن، از نمایشهایی به نامهای زیر استفاده میشود:
- Query
- Key
- Value
بهصورت مفهومی، Query هر موقعیت با Key موقعیتهای مجاز مقایسه میشود. نتیجه این مقایسه تعیین میکند اطلاعات Value هر موقعیت چه سهمی در خروجی داشته باشد.
برای توضیح مفصل ساختار مدل، مقاله معماری Transformer وSelf-Attention را ببینید.
مشکل پیادهسازی ساده Attention چیست؟
فرض کنید ورودی مدل شامل تعداد زیادی توکن باشد. در پیادهسازی مستقیم، برای محاسبه ارتباط موقعیتها، یک ماتریس از امتیازهای Attention ساخته میشود.
اگر طول دنباله دو برابر شود، تعداد ارتباطهای ممکن در این ماتریس میتواند بسیار بیشتر از دو برابر شود. در مدلهای بزرگ یا ورودیهای طولانی، نگهداری این دادههای میانی فشار قابل توجهی به حافظه وارد میکند.
هزینه فقط محاسبه نیست. دادههای میانی ممکن است چند بار میان حافظه اصلی GPU و واحدهای محاسباتی جابهجا شوند.
مقاله اصلی FlashAttention نشان میدهد که توجه به هزینه خواندن و نوشتن حافظه، در کنار تعداد عملیات محاسباتی، برای طراحی Attention سریع اهمیت دارد. arxiv.org
FlashAttentionبه زبان ساده چگونه کار میکند؟
FlashAttentionکار را به بخشهای کوچکتر یا بلوکها تقسیم میکند.
بهجای آنکه کل ماتریس بزرگ Attention ساخته و در حافظه اصلی GPU ذخیره شود، بخشهایی از Query، Key و Value بهصورت بلوکی پردازش میشوند. اطلاعات لازم برای ادامه محاسبه نیز به شکلی نگهداری میشود که بتوان نتیجه نهایی Attention را به دست آورد.
هدف این طراحی، کاهش انتقال داده میان حافظه پرظرفیت اما کندتر GPU و حافظه کوچکتر و سریعتر نزدیک به واحدهای محاسباتی است.
یک تشبیه ساده: اگر برای پردازش یک پرونده بزرگ، هر بار مجبور باشید همه برگهها را از بایگانی بیاورید و دوباره برگردانید، زمان زیادی صرف جابهجایی میشود. پردازش گروهی برگهها، همراه با نگهداری خلاصه وضعیت محاسبه، میتواند رفتوآمد را کمتر کند.
این تشبیه جای توضیح فنی الگوریتم را نمیگیرد، اما دلیل تمرکز FlashAttention بر حافظه را روشن میکند.
آیا FlashAttention ماتریس Attention را حذف میکند؟
FlashAttentionنیاز به محاسبه ارتباطهای لازم را بهطور جادویی از بین نمیبرد. تغییر مهم این است که ماتریس کامل امتیازها و احتمالهای Attention مانند پیادهسازی ساده، بهعنوان داده میانی بزرگ در حافظه اصلی GPU نگهداری نمیشود.
بنابراین باید میان دو مفهوم تفاوت گذاشت:
- تعداد محاسبات لازم برای مسئلهAttention
- مقدار حافظه و جابهجایی داده لازم برای اجرای آن
FlashAttentionعمدتاً با سازماندهی بهتر محاسبات و انتقال داده، هزینه اجرایی را بهبود میدهد.
«IO-Aware»به چه معناست؟
در عنوان مقاله اصلی FlashAttention عبارت IO-Aware آمده است.
منظور این است که طراحی الگوریتم فقط تعداد عملیات ریاضی را نمیسنجد؛ بلکه هزینه انتقال داده میان سطوح مختلف حافظه را نیز در نظر میگیرد.
در GPU، محل قرارگیری داده مهم است. یک الگوریتم ممکن است تعداد محاسبات مشابهی با روش دیگر داشته باشد، اما چون داده را کمتر جابهجا میکند، سریعتر اجرا شود.
پژوهش اصلی FlashAttention همین نقش جابهجایی داده را در عملکرد Attention بررسی میکند. arxiv.org
تفاوت Attention معمولی وFlashAttention
| معیار | پیادهسازی مستقیم Attention | FlashAttention |
|---|---|---|
| سازماندهی محاسبه | ساخت دادههای میانی بزرگ | پردازش بلوکی |
| نگهداری ماتریس کامل Attention | معمولاً در پیادهسازی ساده انجام میشود | در مسیر اصلی الگوریتم لازم نیست |
| رفتوآمد میان سطوح حافظه | ممکن است زیاد باشد | برای کاهش آن طراحی شده است |
| مصرف حافظه میانی | در متن طولانی میتواند بالا باشد | معمولاً کمتر |
| سرعت واقعی | وابسته به پیادهسازی | وابسته به اندازه مسئله و سختافزار |
| سازگاری با همه ورودیها | به پیادهسازی بستگی دارد | به محدودیت کرنل و محیط اجرا بستگی دارد |
این مقایسه درباره پیادهسازی ساده است. همه مسیرهای Attention بدون FlashAttention الزاماً ماتریس کامل را به همان شکل ذخیره نمیکنند؛ پیادهسازیهای کمحافظه دیگری نیز وجود دارند.
آیا FlashAttention پاسخ مدل را تغییر میدهد؟
FlashAttention برای محاسبه همان عملیات Attentionطراحی شده است، نه تغییر هدف مدل.
بااینحال، پیادهسازیهای متفاوت عملیات ممیز شناور ممکن است خروجیهایی با اختلاف عددی کوچک تولید کنند. ترتیب جمعزدن، نوع داده و کرنل اجرایی میتوانند روی این اختلاف اثر بگذارند.
مستندات PyTorch نیز توضیح میدهد که خروجی scaled_dot_product_attention بسته به Backend انتخابشده ممکن است از نظر عددی یکسان نباشد. بنابراین برای مقایسه خروجیها معمولاً از تلورانس عددی استفاده میشود، نه مقایسه بیتبهبیت. PyTorch main documentation
برای محصول واقعی، علاوه بر مقایسه عددی خروجی لایه، کیفیت مدل را روی وظیفه نهایی نیز ارزیابی کنید.
FlashAttention-2چیست؟
FlashAttention-2 نسخهای از این خانواده است که با تغییر در تقسیم کار و موازیسازی، استفاده مؤثرتری از منابع GPU را هدف میگیرد.
اصل مسئله همچنان اجرای کارآمد Attention است، اما جزئیات زمانبندی و توزیع عملیات بهبود یافتهاند. مقاله FlashAttention-2 این تغییرها را در چارچوب افزایش کارایی محاسبات Attention توضیح میدهد. arxiv.org
هنگام خواندن نام نسخهها باید دقت کرد: وجود نام FlashAttention-2 در مستندات یک کتابخانه به این معنی نیست که تمام مدلها، نوع دادهها، ماسکها و GPUها در هر شرایطی از همان مسیر استفاده میکنند.
آیا FlashAttention فقط هنگام آموزش کاربرد دارد؟
خیر. Attention هم هنگام آموزش و هم هنگام اجرای مدل استفاده میشود.
FlashAttentionمیتواند در هر دو حوزه مفید باشد، اما معیارهای ارزیابی متفاوتاند:
هنگام آموزش
- زمان اجرایForward
- زمان اجرایBackward
- حافظه موردنیاز برای گرادیانها و دادههای میانی
- اندازه Batch قابل اجرا
- زمان آموزش کامل
هنگام استنتاج
- زمان پردازش ورودی
- فاصله زمانی تولید توکنها
- حافظه مصرفی
- تعداد درخواستهای همزمان
- زمان پاسخ نهایی
سریعترشدن یک فراخوانی Attention بهتنهایی ثابت نمیکند کل آموزش یا کل سرویس به همان نسبت سریعتر شده است.
تفاوت FlashAttention وKV Cache
این دو مفهوم مرتبطاند، اما کار متفاوتی انجام میدهند.
FlashAttention به شیوه اجرای عملیات Attention میپردازد.
KV Cache نمایشهای Key و Value توکنهای پردازششده را برای استفاده در گامهای بعدی تولید نگه میدارد.
| ویژگی | FlashAttention | KV Cache |
|---|---|---|
| مسئله اصلی | اجرای کارآمد عملیات Attention | جلوگیری از محاسبه دوباره Key و Value گذشته |
| تمرکز | کرنل محاسباتی و جابهجایی داده | نگهداری وضعیت دنباله |
| اثر حافظه | کاهش برخی دادههای میانی | مصرف حافظه برای ذخیره وضعیت گذشته |
| مرحله کاربرد | آموزش و استنتاج، بسته به پیادهسازی | عمدتاً تولید خودبازگشتی در استنتاج |
یک موتور استنتاج میتواند از هر دو استفاده کند. FlashAttention جای KV Cache را نمیگیرد و KV Cache نیز نیاز به اجرای خود عملیات Attention را حذف نمیکند.
برای توضیح کاملتر، مقاله KV Cacheدر مدلهای زبانی را بخوانید.
تفاوت FlashAttention وPagedAttention
این دو نام نیز گاهی با هم اشتباه گرفته میشوند.
FlashAttention درباره روش محاسبه Attention و مدیریت دادههای میانی آن است.
PagedAttention به مدیریت بلوکی حافظه KV Cache در سرویسدهی مدلهای زبانی مربوط است.
این دو میتوانند در یک سامانه کنار هم به کار روند، اما به یک مسئله واحد پاسخ نمیدهند. هنگام بررسی ادعای «Attention سریع»، مشخص کنید صحبت از کرنل محاسبه است یا از مدیریت حافظه درخواستهای همزمان.
آیا FlashAttention محدودیت طول Context را حذف میکند؟
خیر. کاهش مصرف حافظه میتواند اجرای بعضی دنبالههای بلندتر را عملیتر کند، اما طول Context قابل پشتیبانی مدل فقط با تغییر کرنل Attention تعیین نمیشود.
عوامل دیگر نیز مهماند:
- معماری و آموزش مدل
- روش نمایش موقعیت توکنها
- محدودیت نرمافزار اجرا
- حافظه لازم برای وزنهای مدل وKV Cache
- محدودیتهای اعلامشده سرویس
- کیفیت عملکرد مدل روی متنهای بلند
بنابراین «امکان اجرای Attention کمحافظهتر» را نباید با «توانایی مدل در فهم قابل اعتماد هر متن بسیار بلند» یکسان دانست.
آیا FlashAttention همیشه سریعتر است؟
خیر. نتیجه به ویژگیهای کار وابسته است.
برای ورودیهای کوچک، هزینه ثابت فراخوانی کرنل و جزئیات اجرا ممکن است مزیت مورد انتظار را محدود کند. برای بعضی سختافزارها یا ترکیبهای نوع داده و شکل Tensor نیز مسیر FlashAttention ممکن است در دسترس نباشد.
حتی اگر یک لایه سریعتر شود، کل برنامه ممکن است بیشتر وقتش را در بخش دیگری صرف کند؛ مانند:
- بارگذاری داده
- شبکه
- پیشپردازش متن
- لایههای دیگر مدل
- صف درخواستها
- تبدیل خروجی به متن
به همین علت باید هم ریزآزمایشAttention و هم بنچمارک مدل یا سرویس کامل انجام شود.
پشتیبانی سختافزاری چه اهمیتی دارد؟
کرنلهای سریع Attention برای تواناییهای مشخص سختافزار و نوع داده طراحی میشوند. پشتیبانی میتواند با تغییر نسخه PyTorch، درایور، CUDA و GPU عوض شود.
مخزن رسمی flash-attention محدودیتهای نصب و پشتیبانی محیطهای مختلف را مستند میکند. هنگام انتخاب روش اجرا، نسخههای فعلی همان مخزن و مستندات PyTorch را بررسی کنید. GitHub
نصب موفق یک بسته نیز ثابت نمیکند تمام فراخوانیهای مدل از کرنل Flash استفاده میکنند. شکل ورودی و پارامترهای فراخوانی همچنان مهماند.
PyTorch SDPAچیست؟
در PyTorch، تابع scaled_dot_product_attention یک رابط برای اجرای عملیات Attention است. بسته به دستگاه و ویژگیهای ورودی، PyTorch میتواند Backend مناسب را انتخاب کند.
مستندات PyTorch میگوید این تابع در محیطهای سازگار قادر است از کرنلهای بهینه استفاده کند و برای کنترل Backend نیز ابزار sdpa_kernel را ارائه میدهد. PyTorch main documentation
فراخوانی SDPA لزوماً به معنی اجرای FlashAttention نیست. برای بررسی دقیق، باید Backend را در شرایط آزمایش مشخص کنید یا از ابزارهای پروفایلگیری استفاده کنید.
آموزش عملی FlashAttention باPyTorch
در این مثال سه مسیر را مقایسه میکنیم:
- پیادهسازی آموزشی و مستقیمAttention
- Backend ریاضی تابع SDPA
- Backend FlashAttention،فقط اگر در محیط قابل اجرا باشد
مثال روی CPU نیز بخشهای آموزشی را اجرا میکند؛ ولی برای آزمایش Backend Flash به GPU و محیط سازگار نیاز است.
نصبPyTorch
راهنمای نصب متناسب با سیستمعامل و GPU خود را از صفحه رسمی نصبPyTorch دریافت کنید.
در محیطی که PyTorch از قبل نصب شده است، کدهای بعدی به بسته جداگانه flash-attn نیاز ندارند؛ از رابط SDPA خود PyTorch استفاده میکنیم.
ساخت داده نمونه
Tensorهای Query، Key و Value را با شکل یکسان میسازیم. دادهها ساختگیاند؛ هدف فقط بررسی عملیات Attentionاست.
import timeimport torchfrom torch import nnfrom torch.nn import functional as Ffrom torch.nn.attention import ( SDPBackend, sdpa_kernel,)torch.manual_seed(42)device = torch.device( "cuda" if torch.cuda.is_available() else "cpu")dtype = ( torch.float16 if device.type == "cuda" else torch.float32)batch_size = 2num_heads = 4sequence_length = 1024head_dim = 64shape = ( batch_size, num_heads, sequence_length,برای حفظ سادگی، در این نمونه طول Query و Key یکسان است. در اجرای واقعی هنگام تولید توکن، این طولها میتوانند متفاوت باشند.
پیادهسازی آموزشیAttention
کد زیر محاسبات را به شکل مستقیم و قابل مشاهده انجام میدهد. این روش برای فهم و مقایسه آموزشی مناسب است، اما نباید آن را راهکار بهینه استقرار دانست.
def naive_causal_attention(
    query,
    key,
    value,
):
    scale = query.size(-1) ** -0.5

    scores = (
        query
        @ key.transpose(-2, -1)
    ) * scale

    query_length = query.size(-2)
    key_length = key.size(-2)

    causal_mask = torch.ones(
        (
            query_length,
            key_length,
        ),
        dtype=torch.bool,
        device=query.device,
    ).tril()

    scores = scores.masked_fill(
        ~causal_mask,
        float("-inf"),
    )

    probabilities = torch.softmax(
        scores,
        dim=-1,
    )

    return probabilities @ value
اینجا scores و probabilities دادههای میانی بزرگی هستند. با طولانیترشدن دنباله، این بخش میتواند حافظه زیادی مصرف کند.
محدوده مثال: ماسک ساده بالا برای حالت طول برابر Query و Key نوشته شده است. برای Decode با طولهای متفاوت، آن را بدون بررسی قواعد موقعیت و ماسک مدل مقصد تعمیم ندهید.
اجرای SDPA با Backend ریاضی
اکنون همان نوع عملیات را از طریق رابط PyTorch اجرا میکنیم:
with torch.inference_mode(): naive_output = ( naive_causal_attention( query, key, value, ) ) with sdpa_kernel( SDPBackend.MATH ): math_output = ( F.scaled_dot_product_attention( query, key, value, is_causal=True, dropout_p=0.0, ) )print( "Naive output:", tuple(naive_output.shape),)print( "Math output:", tuple(math_output.shape),)dropout_p=0.0 در این آزمایش مهم است. طبق مستندات PyTorch، تابع SDPA بر اساس مقداری که به dropout_p میدهید Dropout را اعمال میکند؛ صرف قرارگرفتن کد در حالت ارزیابی، این پارامتر را خودکار صفر نمیکند. PyTorch main documentation
مقایسه عددی دو خروجی
خروجیها را با تلورانس مقایسه میکنیم:
comparison_atol = ( 2e-2 if dtype == torch.float16 else 1e-5)comparison_rtol = ( 2e-2 if dtype == torch.float16 else 1e-5)maximum_difference = ( naive_output - math_output).abs().max().item()print( "Maximum absolute difference:", maximum_difference,)print( "Close within tolerance:", torch.allclose( naive_output, math_output, atol=comparison_atol, rtol=comparison_rtol, ),)اگر نتیجه خارج از تلورانس بود، نوع داده، ماسک، مقیاسدهی و شکل Tensorها را بررسی کنید. مقایسه در float16 به اختلافهای گردکردن حساستر است.
اجرای اجباری Backend Flash در صورت پشتیبانی
برای اینکه ناخواسته مسیر دیگری را به نام FlashAttention گزارش نکنیم، Backend Flash را بهطور مشخص درخواست میکنیم:
flash_output = None

if device.type == "cuda":
    try:
        with torch.inference_mode():
            with sdpa_kernel(
                SDPBackend.FLASH_ATTENTION
            ):
                flash_output = (
                    F.scaled_dot_product_attention(
                        query,
                        key,
                        value,
                        is_causal=True,
                        dropout_p=0.0,
                    )
                )

        print(
            "Flash backend executed."
        )

    except RuntimeError as error:
        print(
            "Flash backend is not available "
            "for this environment or input:"
        )

        print(error)

else:
    print(
        "Flash backend benchmark skipped: "
        "CUDA is unavailable."
    )
اگر اجرای Backend Flash شکست بخورد، این لزوماً خطای کد شما نیست. PyTorch برای کرنلهای بهینه محدودیتهای ورودی دارد و در صورت نبودن مسیر سازگار میتواند دلیل را گزارش کند. PyTorch main documentation
اگر اجرا موفق بود، خروجی را بررسی کنید:
if flash_output is not None: flash_difference = ( math_output - flash_output ).abs().max().item() print( "Maximum math/flash difference:", flash_difference, ) print( "Close within tolerance:", torch.allclose( math_output, flash_output, atol=comparison_atol, rtol=comparison_rtol, ), )یک اختلاف کوچک عددی با تغییر Backend انتظارپذیر است. معیار کیفیت نهایی، رفتار مدل کامل روی داده واقعی نیز هست.
بنچمارک زمان اجرا
برای اندازهگیری زمان GPU باید منتظر تکمیل عملیات غیرهمزمان آن بمانیم. کد زیر هر مسیر را چند بار گرم و سپس اندازهگیری میکند:
def synchronize_device(): if device.type == "cuda": torch.cuda.synchronize()def benchmark( operation, warmup=10, repeats=30,): with torch.inference_mode(): for _ in range(warmup): operation() synchronize_device() start = time.perf_counter() for _ in range(repeats): operation() synchronize_device() elapsed_seconds = ( time.perf_counter() - start ) return ( elapsed_seconds / repeats * 1000 )عملیات آزمایشی را تعریف میکنیم:
def run_naive(): return naive_causal_attention( query, key, value, )def run_math(): with sdpa_kernel( SDPBackend.MATH ): return ( F.scaled_dot_product_attention( query, key, value, is_causal=True, dropout_p=0.0, ) )def run_flash(): with sdpa_kernel( SDPBackend.FLASH_ATTENTION ): return ( F.scaled_dot_product_attention( query, key, value, is_causal=True, dropout_p=0.0, ) )اکنون زمان را بسنجید:
repeats = ( 30 if device.type == "cuda" else 5)for name, operation in ( ("naive", run_naive), ("math_sdpa", run_math),): milliseconds = benchmark( operation, warmup=3, repeats=repeats, ) print( f"{name}: " f"{milliseconds:.4f} ms" )if flash_output is not None: milliseconds = benchmark( run_flash, warmup=10, repeats=30, ) print( "flash_sdpa:", f"{milliseconds:.4f} ms", )این آزمایش زمان یک عملیات Attention را میسنجد، نه زمان تولید کامل پاسخ مدل زبانی. نتایج آن را بدون آزمون مدل واقعی به سرویس محصول تعمیم ندهید.
سنجش مقدماتی حافظهGPU
اگر CUDA در دسترس است، میتوان بیشترین حافظه تخصیصیافته در اجرای هر عملیات را اندازه گرفت.
برای مقایسه دقیقتر، هر حالت را در یک فرایند مستقل و با شرایط یکسان اجرا کنید. قطعه کد زیر یک بررسی مقدماتی در همان فرایند است:
def peak_memory_mib(operation): if device.type != "cuda": return None torch.cuda.synchronize() torch.cuda.reset_peak_memory_stats() with torch.inference_mode(): output = operation() torch.cuda.synchronize() peak_bytes = ( torch.cuda.max_memory_allocated() ) del output return peak_bytes / ( 1024 * 1024 )if device.type == "cuda": print( "Naive peak MiB:", peak_memory_mib( run_naive ), ) print( "Math SDPA peak MiB:", peak_memory_mib( run_math ),این عدد حافظه خالص ماتریس Attention نیست. Query، Key، Value، خروجیها و Tensorهای دیگری که هنوز در فرایند نگهداری میشوند نیز در حافظه تخصیصیافته حضور دارند. بنابراین برای گزارش رسمی، اجرای جداگانه هر سناریو و استفاده از ابزارهای پروفایلگیری مناسبتر است.
چرا اندازه دنباله در بنچمارک مهم است؟
FlashAttentionبرای همه اندازههای ورودی مزیت یکسانی ندارد.
در آزمایش، چند طول دنباله را مقایسه کنید؛ مثلاً:
- متن کوتاه
- متن با طول معمول محصول
- متن بلند
- طول نزدیک به مرز عملیاتی سرویس
همچنین Batch، تعداد سرهای Attention و اندازه هر سر را متناسب با مدل واقعی انتخاب کنید.
اگر آزمایش فقط با یک شکل Tensor انجام شود، نتیجه آن برای شکلهای دیگر قطعی نیست.
Mask در FlashAttentionچه نقشی دارد؟
در مدلهای مولد، Causal Mask مانع میشود یک موقعیت هنگام تولید متن به توکنهای آینده دسترسی داشته باشد.
در رابط SDPA میتوان برای این حالت از is_causal=True استفاده کرد. ماسکهای دیگر نیز بسته به مدل و هدف ممکناند، اما همه ترکیبهای ماسک لزوماً با همه کرنلهای بهینه سازگار نیستند.
یک ظرافت مهم درPyTorch: در scaled_dot_product_attention، مقدار True در ماسک بولی به معنی مجازبودن مشارکت آن موقعیت در Attention است. این قرارداد با بعضی رابطهای دیگر PyTorch، مانند key_padding_mask در MultiheadAttention، تفاوت دارد. هنگام انتقال کد، معنای ماسک را بررسی کنید. PyTorch main documentation
آیا برای استفاده از FlashAttention باید بسته flash-attn نصب کنیم؟
همیشه خیر.
اگر از torch.nn.functional.scaled_dot_product_attention استفاده میکنید، PyTorch در محیطهای سازگار میتواند Backend بهینه را انتخاب کند. این مسیر با نصب و استفاده مستقیم از بسته مستقل flash-attn یکسان نیست.
انتخاب مسیر مناسب به پروژه بستگی دارد:
| مسیر | مناسب برای |
|---|---|
| SDPA در PyTorch | استفاده از رابط استاندارد PyTorch و انتخاب Backend سازگار |
بسته مستقل flash-attn | پروژههایی که به رابطها یا قابلیتهای مشخص همان بسته نیاز دارند |
| موتور استنتاج آماده | ارائه مدل و مدیریت درخواستهای واقعی در مقیاس سرویس |
پیش از نصب بسته مستقل، پشتیبانی نسخهها و GPU را در مخزن رسمیFlashAttention بررسی کنید.
FlashAttentionدر مدلهای آماده چگونه فعال میشود؟
در مدل آماده، پاسخ به کتابخانه و پیادهسازی همان مدل وابسته است. بعضی مدلها از SDPA استفاده میکنند؛ برخی مسیر اجرایی یا تنظیم اختصاصی دارند.
برای اطمینان از Backend مورد استفاده:
- مستندات مدل و کتابخانه را بررسی کنید.
- نسخه PyTorch و وابستگیها را ثبت کنید.
- با ورودی نماینده، مدل را پروفایل کنید.
- خروجی و عملکرد مدل را پس از تغییر مسیر اجرا مقایسه کنید.
صرف دیدن عبارت «FlashAttention enabled» در یک فایل پیکربندی، برای اثبات اینکه تمام فراخوانیها از همان کرنل استفاده کردهاند کافی نیست.
FlashAttention و مدلهای دارای GQA
برخی مدلها از Grouped Query Attention یا GQA استفاده میکنند؛ در این حالت تعداد سرهای Query و سرهای Key/Value میتواند متفاوت باشد.
پشتیبانی از این ساختار در یک کرنل، به نسخه نرمافزار و شرایط ورودی وابسته است. مستندات SDPA در PyTorch برای enable_gqa محدودیتهای مشخصی ذکر میکند. بنابراین اگر مدل شما GQA دارد، آزمون با Tensorهایی که تعداد سرهایشان همگی برابر است، سازگاری حالت واقعی مدل را ثابت نمیکند. PyTorch main documentation
تفاوت FlashAttention باSparse Attention
FlashAttentionمعمول برای اجرای کارآمد Attention دقیق طراحی شده است.
Sparse Attention با تعریف الگویی انتخابی، بعضی ارتباطهای میان موقعیتها را اصلاً محاسبه نمیکند. این تغییر میتواند هزینه عملیات را تحت شرایطی کاهش دهد، اما الگوی توجه مدل را نیز عوض میکند.
برخی پژوهشها و پیادهسازیها ممکن است ایده پردازش بلوکی را با الگوهای تنک ترکیب کنند. بااینحال، نباید از نام FlashAttention نتیجه گرفت که مدل خودکار فقط به بخشی از توکنها توجه میکند.
تفاوت FlashAttention وQuantization
Quantization دقت عددی نمایش وزنها یا دادهها را تغییر میدهد.
FlashAttention ترتیب و نحوه اجرای Attention و مدیریت دادههای میانی را بهینه میکند.
این دو میتوانند در یک سامانه کنار هم حضور داشته باشند، اما سازگاری نوع داده و کرنل باید بررسی شود. برای آشنایی با کاهش دقت مدل، مقاله Quantizationچیست؟ را ببینید.
FlashAttentionچه زمانی بیشترین ارزش بررسی را دارد؟
این روش بهویژه زمانی ارزش آزمون دارد که:
- Attentionسهم بزرگی از زمان اجرای مدل داشته باشد.
- طول دنبالهها قابل توجه باشد.
- دادههای میانی Attention فشار حافظه ایجاد کنند.
- GPUو نوع داده از کرنل سازگار پشتیبانی کنند.
- اندازهگیری واقعی امکان مقایسه قبل و بعد را بدهد.
اگر گلوگاه اصلی، زمان شبکه یا صف سرویس باشد، بهینهکردن کرنل Attention ممکن است تغییر محدودی در تجربه کاربر ایجاد کند.
روش درست ارزیابی روی مدل واقعی
برای تصمیم استقرار، چهار سطح اندازهگیری را جدا کنید.
۱. درستی عددی
خروجی لایه Attention را با مسیر مرجع و تلورانس مناسب مقایسه کنید.
۲. کیفیت کاربردی
مدل کامل را روی مجموعه ارزیابی مرتبط با محصول اجرا کنید؛ از جمله نمونههای فارسی، ورودی بلند و موارد دشوار.
۳. عملکرد فنی
زمان اجرای مدل، زمان تا نخستین توکن، سرعت تولید و حافظه مصرفی را بسنجید.
۴. عملکرد سرویس
تعداد درخواستهای همزمان، صف، توان عملیاتی و زمان پاسخ کاربران را اندازه بگیرید.
بهبود در سطح اول یا سوم، بهتنهایی تضمینکننده بهبود همه سطوح نیست.
اشتباهات رایج دربارهFlashAttention
تصور اینکه FlashAttention یک مدل زبانی است
FlashAttentionروش اجرای بخشی از محاسبات مدل است؛ بهتنهایی یک مدل گفتوگو یا تولید متن نیست.
فرض اینکه همه محاسبات Transformer را سریع میکند
اثر مستقیم آن بر عملیات Attention است. سهم سایر بخشهای مدل همچنان وجود دارد.
فرض اینکه نیاز به حافظه را از بین میبرد
دادههای میانی Attention میتوانند کمحافظهتر مدیریت شوند، اما وزنهای مدل، KV Cache، گرادیانها و سایر دادهها همچنان حافظه لازم دارند.
یکسان دانستن FlashAttention باKV Cache
اولی روش اجرای Attention است؛ دومی وضعیت Key و Value توکنهای قبلی را نگه میدارد.
گزارش سرعت Flash بدون بررسی Backend واقعی
SDPA ممکن است بر اساس شرایط، Backend دیگری انتخاب کند. برای آزمایش Flash،مسیر را مشخص و نتیجه اجرا را بررسی کنید.
مقایسه زمان GPU بدون همگامسازی
عملیات GPU معمولاً غیرهمزمان است. اندازهگیری بدون همگامسازی میتواند زمان نادرست بدهد.
مقایسه خروجیها با برابری بیتبهبیت
تفاوتهای کوچک ممیز شناور میان کرنلها ممکن است طبیعی باشد. تلورانس مناسب و ارزیابی مدل کامل لازم است.
تعمیم نتیجه یک GPU به همه سختافزارها
پشتیبانی و کارایی به دستگاه، نسخه نرمافزار و شکل ورودی وابسته است.
نتیجهگیری درباره مدل کامل از بنچمارک یک لایه
زمان پاسخ محصول شامل مراحل و هزینههایی فراتر از یک عملیات Attention است.
پرسشهای متداول
FlashAttentionچیست؟
FlashAttention روشی برای اجرای کارآمدتر Attention است که با پردازش بلوکی و کاهش رفتوآمد داده میان سطوح حافظه GPU،مصرف حافظه میانی و در شرایط مناسب زمان اجرا را کاهش میدهد.
آیا FlashAttention دقت مدل را کم میکند؟
هدف الگوریتم اصلی، محاسبه همان Attention است. بااینحال، Backendهای متفاوت ممکن است اختلاف عددی کوچک داشته باشند؛ کیفیت مدل کامل باید ارزیابی شود.
آیا FlashAttention برای متن فارسی فایده دارد؟
سازوکار آن به زبان متن وابسته نیست، بلکه به شکل دنباله و اجرای Attention مربوط است. میزان فایده عملی برای درخواستهای فارسی را باید روی مدل و بار واقعی اندازه گرفت.
آیا FlashAttention طول Context مدل را افزایش میدهد؟
میتواند اجرای بعضی ورودیهای بلندتر را از نظر حافظه عملیتر کند، اما محدودیت معماری، تنظیمات سرویس و کیفیت فهم متن بلند را خودکار تغییر نمیدهد.
آیا FlashAttention روی CPU اجرا میشود؟
مسیر Flash بهینه مورد بحث در این مقاله به محیط GPU سازگار وابسته است. کد آموزشی Attention و Backend ریاضی SDPA را میتوان روی CPU نیز اجرا کرد.
FlashAttention و FlashAttention-2چه تفاوتی دارند؟
FlashAttention-2با تغییر تقسیم کار و موازیسازی، کارایی اجرای الگوریتم را بهبود میدهد. نتیجه واقعی به پیادهسازی و سختافزار بستگی دارد.
آیا FlashAttention جای KV Cache را میگیرد؟
خیر. این دو به بخشهای متفاوتی از اجرای مدل مربوطاند و ممکن است همزمان استفاده شوند.
آیا باید بسته flash-attn نصب کنم؟
برای استفاده از SDPA در PyTorch لزوماً نه. نصب بسته مستقل زمانی مطرح است که پروژه به قابلیت یا رابط مشخص آن نیاز داشته باشد و محیط اجرا با آن سازگار باشد.
از کجا بفهمم مدل واقعاً از FlashAttention استفاده میکند؟
مستندات مسیر اجرا و محدودیتها را بررسی کنید و با Backend اجباری یا ابزار پروفایلگیری، اجرای کرنل موردنظر را در شرایط واقعی تأیید کنید.
جمعبندی
FlashAttentionبا تمرکز بر چگونگی جابهجایی و پردازش داده درGPU، عملیات Attention را کارآمدتر اجرا میکند. مزیت اصلی آن در مقایسه با پیادهسازی ساده، پرهیز از نگهداری دادههای میانی بسیار بزرگ و کاهش رفتوآمد حافظه است.
این روش میتواند برای آموزش و استنتاج مفید باشد، اما افزایش سرعت همیشگی یا یکسان نیست. نوع GPU، شکل Tensor، طول دنباله، نوع داده، ماسک و Backend واقعی نتیجه را تعیین میکنند.
اگر محصول شما از مدلهای زبانی استفاده میکند، اثر بهینهسازی داخلی مدل را در کنار زمان شبکه، صف درخواست، طول ورودی و کیفیت خروجی بسنجید. برای شروع اتصال محصول به مدلهای مختلف بدون راهاندازی مستقیم زیرساخت استنتاج، خدمات و API درواره را در darvareh.ir بررسی کنید و زمان پاسخ و کیفیت مدلها را با درخواستهای واقعی خود مقایسه کنید.
مقالات مرتبط
- Transformer و Self-Attentionچیست؟
- KV Cacheدر مدلهای زبانی چیست؟
- پنجره زمینه یا Context Window چیست؟
- آموزش vLLM و ارائه مدل زبانی
- Quantizationمدل هوش مصنوعی
- Inferenceدر هوش مصنوعی چیست؟
- آموزش PyTorch برای یادگیری عمیق
- آموزش استفاده از API هوش مصنوعی
منابع
- مقاله اصلیFlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- مقالهFlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- مستندات
scaled_dot_product_attentionدرPyTorch - مستندات
sdpa_kernelدرPyTorch - آموزش رسمی SDPA درPyTorch
- مخزن رسمیFlashAttention
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات نسخه ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



