
KV Cache چیست؟ راهنمای کش در مدلهای زبانی و کاهش زمان تولید پاسخ
KV Cache چیست و چرا در تولید پاسخ مدلهای زبانی اهمیت دارد؟ در این آموزش، سازوکار ذخیره کلیدها و مقدارهای Attention، اثر آن بر سرعت و حافظه، انواع Cache و تفاوت آن با Prefix Caching را بررسی میکنیم و با Pythonیک آزمایش عملی میسازیم.

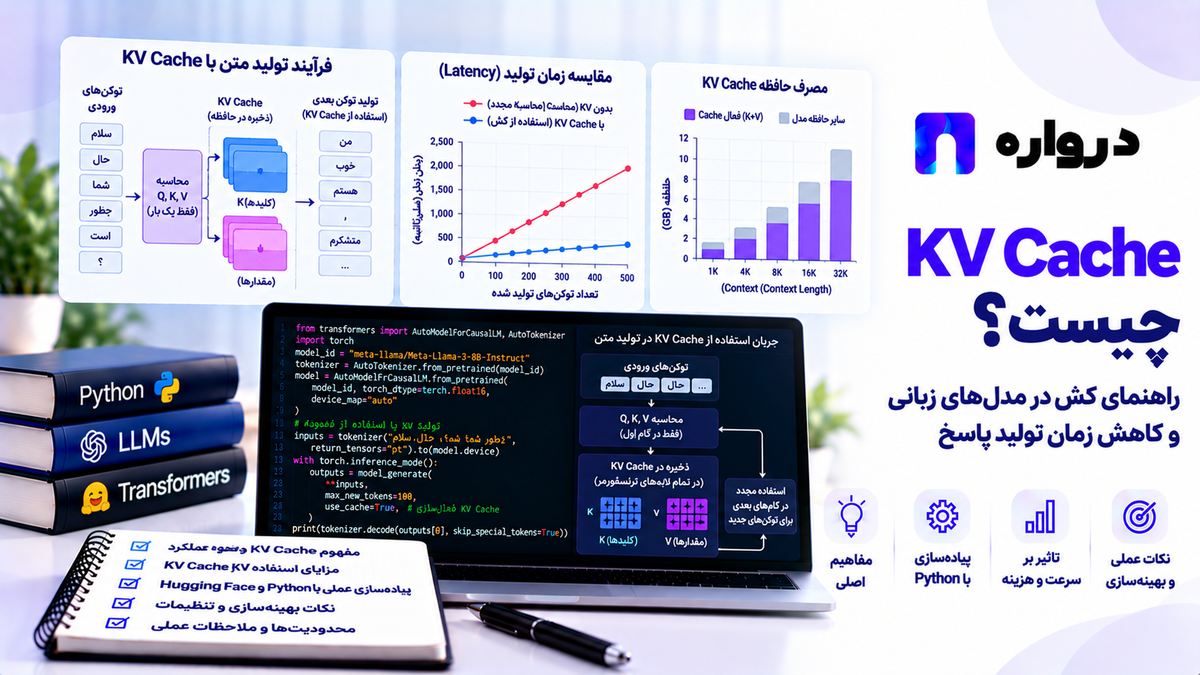
KV Cache یا «کش کلید و مقدار» یکی از سازوکارهای مهم در اجرای مدلهای زبانی مولد است. این کش بخشی از محاسبات مربوط به توکنهای قبلی را نگه میدارد تا مدل هنگام تولید توکن بعدی مجبور نباشد همان بخش را دوباره محاسبه کند.
وقتی از یک مدل زبانی میخواهید متنی تولید کند، پاسخ معمولاً توکنبهتوکن ساخته میشود. مدل برای تولید هر توکن جدید باید به بخشهای مرتبط از متن قبلی توجه کند. بدون کش، پردازش دوباره اطلاعات توکنهای پیشین میتواند هزینه اجرا را افزایش دهد.
KV Cacheبه کاهش این محاسبات تکراری کمک میکند؛ اما در مقابل، حافظه مصرف میکند. هرچه متن ورودی، پاسخ و تعداد درخواستهای همزمان بیشتر شوند، مدیریت این حافظه مهمتر میشود.
در این مقاله میخوانید:
- KV Cacheدقیقاً چه چیزی را ذخیره میکند؟
- تفاوت مرحلههای Prefill و Decode چیست؟
- چرا فعالکردن کش همیشه به معنی کاهش هزینه کل نیست؟
- Dynamic Cache و Static Cacheچه تفاوتی دارند؟
- Prefix Caching چه ارتباطی با KV Cacheدارد؟
- چگونه استفاده از کش را در Python آزمایش کنیم؟
- هنگام انتخاب مدل یا زیرساخت API به چه معیارهایی توجه کنیم؟
KV Cacheبه زبان ساده چیست؟
فرض کنید مدل در حال نوشتن جملهای است و تاکنون چندین توکن تولید کرده است. برای انتخاب توکن بعدی، مدل باید از اطلاعات متن قبلی استفاده کند.
در لایههای Attention، برای توکنها نمایشهایی به نام Query، Key و Value ساخته میشود. هنگام تولید توکنهای بعدی، نمایشهای Key و Value مربوط به توکنهای قبلی همچنان موردنیازند.
KV Cacheاین نمایشهای قبلی را نگه میدارد. بنابراین مدل میتواند در گام بعدی از مقادیر ذخیرهشده استفاده کند و عمدتاً نمایشهای مربوط به توکن تازه را محاسبه کند.
مستندات Transformers توضیح میدهد که کشکردن Key و Value از محاسبه دوباره آنها برای توکنهای پیشین در فرایند تولید خودبازگشتی جلوگیری میکند. این سازوکار برای استنتاج به کار میرود. Hugging Face
یک مثال مفهومی
فرض کنید ورودی مدل این است:
«سه مزیت استفاده از API هوش مصنوعی را توضیح بده.»
مدل پاسخ را بهتدریج تولید میکند:
- «یکی»
- «از»
- «مزیتها»
- «کاهش»
- «زمان»
- «توسعه»
- و ادامه پاسخ
وقتی مدل میخواهد توکن ششم را تولید کند، متن درخواست و توکنهای اول تا پنجم را در زمینه خود دارد. نمایشهای Key و Value مربوط به این توکنهای قبلی میتوانند از KV Cache خوانده شوند.
کش، حافظه دائمی مدل نیست. محتوای آن به درخواست، دنباله توکنها و وضعیت اجرای همان مدل وابسته است.
KV در KV Cacheبه چه معناست؟
KVمخفف دو واژه است:
- Key: نمایشی که برای سنجش ارتباط اطلاعات در Attention به کار میرود.
- Value: اطلاعاتی که با توجه به نتیجه Attention در محاسبه خروجی مشارکت میکند.
Query نیز در Attention نقش دارد، اما در تولید خودبازگشتی معمولاً دلیل اصلی نگهداری وضعیت توکنهای قبلی، استفاده دوباره از Key و Valueآنهاست.
برای فهم کاربردی KV Cache لازم نیست تمام محاسبات Attention را دستی انجام دهید. نکته اصلی این است که نمایشهای قابل استفاده مجدد توکنهای قبلی ذخیره میشوند.
برای آشنایی با خود سازوکار Attention، مقاله معماری Transformer وSelf-Attention را ببینید.
تفاوت Prefill و Decode چیست؟
اجرای یک درخواست تولید متن معمولاً دو بخش مهم دارد.
Prefill:پردازش ورودی
در مرحله Prefill، مدل توکنهای متن ورودی را پردازش میکند و وضعیت لازم برای آغاز تولید پاسخ را میسازد.
اگر درخواست شامل یک دستور طولانی، چند پیام قبلی یا یک سند بزرگ باشد، این مرحله ممکن است سهم قابل توجهی از زمان انتظار تا نخستین توکن را تشکیل دهد.
Decode:تولید توکنهای پاسخ
در مرحله Decode، مدل توکنهای جدید را یکییکی تولید میکند. در این مرحله، استفاده از Key و Value توکنهای قبلی اهمیت زیادی دارد.
| مرحله | کار اصلی | معیار مرتبط |
|---|---|---|
| Prefill | پردازش توکنهای ورودی | زمان تا نخستین توکن |
| Decode | تولید تدریجی توکنهای خروجی | فاصله زمانی میان توکنهای خروجی |
| کل درخواست | پردازش ورودی و تکمیل پاسخ | زمان پاسخ نهایی |
این تفکیک کمک میکند علت کندی را دقیقتر پیدا کنید. اگر ورودیهای بسیار طولانی دارید، بهبود مرحله Decode بهتنهایی ممکن است مشکل اصلی را برطرف نکند.
KV Cacheچگونه به سرعت کمک میکند؟
در تولید خودبازگشتی، مدل بعد از تولید هر توکن دوباره اجرا میشود. وقتی کش فعال است، لازم نیست نمایشهای Key و Value تمام توکنهای پیشین در هر گام از ابتدا ساخته شوند.
در نتیجه، محاسبات تکراری مربوط به این نمایشها کاهش مییابد. بااینحال، مدل همچنان باید توجه توکن تازه به زمینه موجود را محاسبه کند و بخشهای دیگر شبکه را اجرا کند.
پس عبارت دقیقتر این است:
KV Cacheبخشی از محاسبات تکراری تولید متن را حذف میکند؛ کل هزینه توجه به متنهای طولانی را از بین نمیبرد.
اثر آن بر زمان واقعی به طول متن، معماری مدل، سختافزار، تعداد درخواستهای همزمان و پیادهسازی موتور استنتاج بستگی دارد.
آیا KV Cache همیشه فعال است؟
در بسیاری از ابزارهای تولید متن، استفاده از کش رفتار معمول است؛ اما نباید این موضوع را برای همه مدلها، نسخهها و مسیرهای اجرایی فرض کرد.
برای نمونه، در Transformers میتوان در فراخوانی generate() مقدار use_cache را تعیین کرد. این کتابخانه همچنین چند راهبرد برای نگهداری کش در اختیار میگذارد. Hugging Face
فعال یا غیرفعالکردن کش را باید در کنار پشتیبانی مدل و ابزار اجرا بررسی کنید.
KV Cacheچه چیزی را ذخیره نمیکند؟
اشتباهات رایجی درباره معنای «کش» وجود دارد. KV Cache معمولاً موارد زیر نیست:
- فایل وزنهای آموزشدیده مدل
- تاریخچه دائمی تمام کاربران
- پایگاه داده مکالمات محصول
- کش آماده پاسخهای نهایی
- حافظهای که هر مدل دیگری بتواند بدون سازگاری از آن استفاده کند
وزنهای مدل و KV Cache دو نوع داده متفاوتاند. وزنهای مدل حاصل آموزشاند؛ KV Cache در زمان پردازش یک دنباله ساخته میشود.
چرا KV Cache حافظه زیادی مصرف میکند؟
برای توکنهایی که باید در زمینه فعلی نگه داشته شوند، وضعیت Key و Value در لایههای مرتبط ذخیره میشود.
مصرف حافظه به عواملی مانند این موارد وابسته است:
- تعداد لایههای مدل
- ساختار Attention و تعداد سرهایKV
- اندازه نمایشهای Key وValue
- دقت عددی ذخیرهسازی
- طول زمینه هر درخواست
- تعداد درخواستهای همزمان
- روش مدیریت و اشتراکگذاری کش در موتور استنتاج
به همین علت، مدلی که وزنهایش در حافظه دستگاه جا میشود، ممکن است با افزایش طول درخواستها یا تعداد کاربران همزمان با محدودیت حافظه روبهرو شود.
مثال مفهومی
یک سرویس را در نظر بگیرید که همزمان به چند کاربر پاسخ میدهد. هر کاربر ممکن است متن ورودی و توکنهای تولیدشده متفاوتی داشته باشد.
موتور استنتاج باید وضعیت لازم برای ادامه تولید هر درخواست را مدیریت کند. بنابراین ظرفیت عملی سرویس فقط با اندازه فایل وزنهای مدل تعیین نمیشود.
تفاوت وزن مدل و حافظهKV Cache
| ویژگی | وزنهای مدل | KV Cache |
|---|---|---|
| زمان ایجاد | عمدتاً هنگام آموزش یا آمادهسازی مدل | هنگام پردازش درخواست |
| محتوا | پارامترهای آموختهشده | وضعیت Key و Value توکنهای پردازششده |
| وابستگی به متن کاربر | معمولاً ندارد | دارد |
| تغییر هنگام تولید پاسخ | معمولاً ثابت | با پیشرفت تولید تغییر میکند |
| امکان اشتراک میان درخواستها | وزن مدل برای درخواستها مشترک است | اشتراک کش فقط در شرایط سازگار و با سازوکار مشخص ممکن است |
این تفاوت توضیح میدهد چرا بررسی اندازه مدل بهتنهایی برای برآورد ظرفیت یک سرویس کافی نیست.
Dynamic Cacheچیست؟
در Dynamic Cache، فضای کش همراه با افزایش طول دنباله رشد میکند. این روش با طولهای متغیر ورودی و خروجی سازگار است.
در مستنداتTransformers، DynamicCache راهبرد پیشفرض برای بسیاری از مدلها معرفی شده است. البته در معماریهایی با الگوهایی مانند Sliding Window Attention، رفتار رشد کش میتواند با کش متناظر با همه توکنهای گذشته متفاوت باشد. Hugging Face
مزیت اصلی Dynamic Cache انعطاف در برابر طول درخواست است. در مقابل، تغییر شکل کش هنگام رشد میتواند استفاده از بعضی روشهای بهینهسازی مبتنی بر شکل ثابت را محدود کند.
Static Cacheچیست؟
Static Cache فضای موردنیاز را تا یک ظرفیت مشخص از پیش اختصاص میدهد.
این کار میتواند با بعضی مسیرهای بهینهسازی اجرا سازگارتر باشد، اما اگر فضای زیادی از پیش رزرو شود و استفاده نشود، حافظه هدر میرود.
در انتخاب Static Cache باید به طول درخواستهای واقعی توجه کرد. تنظیم آن بر اساس طول بسیار بزرگی که فقط بهندرت رخ میدهد، میتواند برای درخواستهای معمول بهصرفه نباشد.
مستندات Transformers قابلیتها و محدودیتهای Dynamic و Static Cache را جداگانه توضیح میدهد. Hugging Face
Offloaded Cacheچیست؟
در Offloaded Cache بخشی از دادههای کش، بهجای ماندن دائمی در حافظه GPU، میان GPU و حافظه دیگر جابهجا میشود.
این روش میتواند در موقعیتهایی که حافظه GPU محدود است کمک کند، ولی انتقال داده نیز هزینه دارد و ممکن است زمان تولید را افزایش دهد.
بنابراین انتخاب آن به پرسش عملی زیر وابسته است:
آیا امکان اجرای درخواستهای بزرگتر یا بیشتر، ارزش هزینه انتقال داده و تغییر زمان پاسخ را دارد؟
Transformers برای برخی راهبردهای کش، گزینههای Offloadingارائه میکند و به هزینه احتمالی انتقال داده نیز اشاره میکند. Hugging Face
Quantized KV Cacheچیست؟
در Quantized KV Cache، دادههای کش با دقت عددی پایینتری نمایش داده میشوند تا مصرف حافظه کاهش یابد.
این کار با Quantizationوزنهای مدل مرتبط است، اما همان عملیات نیست:
- Quantizationوزنها نمایش پارامترهای مدل را تغییر میدهد.
- Quantization کش نمایش وضعیت Key و Valueتولیدشده هنگام اجرا را تغییر میدهد.
کاهش حافظه همیشه به معنای کاهش زمان پاسخ نیست. تبدیل دادهها و عملیات مرتبط با نمایش کمدقت ممکن است سربار داشته باشد. مستندات Transformers نیز هشدار میدهد که در متنهای کوتاه و زمانی که حافظه کافی وجود دارد، کش کمدقت میتواند از نظر تأخیر نتیجه نامطلوبتری داشته باشد. Hugging Face
برای بررسی سبکسازی وزنهای مدل، مقاله Quantizationمدل هوش مصنوعی را مطالعه کنید.
مقایسه راهبردهای رایجKV Cache
| راهبرد | ایده اصلی | مزیت بالقوه | محدودیت مهم |
|---|---|---|---|
| Dynamic | رشد همراه با دنباله | انعطاف در طول درخواست | مدیریت شکلهای متغیر |
| Static | رزرو ظرفیت از پیش | سازگاری با برخی بهینهسازیها | احتمال رزرو حافظه بدون استفاده |
| Offloaded | انتقال بخشی از کش از GPU | کاهش فشار بر حافظه GPU | سربار انتقال |
| Quantized | ذخیره کش با دقت کمتر | کاهش مصرف حافظه | هزینه تبدیل و امکان تغییر رفتار عددی |
| Paged | مدیریت کش در بلوکها | استفاده بهتر از حافظه در سرویسدهی | وابستگی به موتور استنتاج |
این جدول مقایسه مفهومی است. جزئیات پشتیبانی هر روش به نسخه کتابخانه، مدل و سختافزار بستگی دارد.
PagedAttention چه ارتباطی با KV Cacheدارد؟
در سرویسدهی به تعداد زیادی درخواست، تنها حجم کش مهم نیست؛ نحوه اختصاص و آزادسازی حافظه نیز اهمیت دارد.
روش PagedAttention و سامانه vLLM برای مدیریت KV Cache از ایده تقسیم آن به بلوکها استفاده میکنند. مقاله اصلی vLLM توضیح میدهد که این طراحی با هدف کاهش اتلاف حافظه و امکان مدیریت و اشتراک منعطفتر کش میان درخواستها توسعه یافته است. arxiv.org
از دید کاربردی، PagedAttention بخشی از طراحی موتور استنتاج است. لازم نیست هنگام هر فراخوانی API خودتان بلوکهای حافظه را مدیریت کنید؛ ولی اگر زیرساخت مدل را اجرا میکنید، این موضوع بر ظرفیت و کارایی سرویس اثر میگذارد.
برای آشنایی بیشتر با موتور اجرا، مقاله آموزش vLLM و ارائه مدل با API سازگار را ببینید.
Prefix Caching چیست و چه تفاوتی با KV Cacheدارد؟
تا اینجا درباره استفاده مجدد از Key و Value توکنهای قبلی در طول تولید یک دنباله صحبت کردیم.
Prefix Caching یک گام دیگر برمیدارد: اگر درخواستهای مختلف پیشوند یکسانی داشته باشند و موتور اجرا شرایط لازم را فراهم کند، میتوان از وضعیت پردازششده آن پیشوند در درخواستهای بعدی نیز استفاده کرد.
برای مثال، چند درخواست ممکن است با یک دستور سیستمی طولانی و یک سند ثابت شروع شوند و فقط پرسش انتهایی آنها متفاوت باشد. در چنین شرایطی، استفاده دوباره از پردازش بخش مشترک میتواند هزینه مرحله Prefill را کاهش دهد.
مستندات vLLM نمونه استفاده از Automatic Prefix Caching را برای درخواستهایی با بخش آغازین مشترک توضیح میدهد. vLLM
تفاوت در یک نگاه
| مفهوم | محدوده استفاده مجدد | اثر اصلی مورد انتظار |
|---|---|---|
| KV Cache معمول در تولید | توکنهای قبلی دنباله جاری | کاهش محاسبه تکراری هنگام Decode |
| Prefix Caching | پیشوند مشترک درخواستهای سازگار | کاهش پردازش دوباره پیشوند در Prefill |
| کش پاسخ برنامه | پاسخ نهایی برای ورودی تعریفشده | حذف فراخوانی مدل در صورت برخورد معتبر |
این سه روش ممکن است در یک سامانه کنار هم وجود داشته باشند، اما کار یکسانی انجام نمیدهند.
آیا جابهجایی ترتیب پیامها بر Prefix Caching اثر دارد؟
بله. استفاده دوباره از یک پیشوند به یکسانبودن واقعی بخش قابل کش ورودی و قواعد موتور اجرا وابسته است.
اگر دستور ثابت شما در هر درخواست تغییر کند، یا اطلاعات متغیر را در ابتدای متن قرار دهید، احتمال استفاده دوباره از یک پیشوند مشترک کاهش مییابد.
برای طراحی درخواستهایی با بخش ثابت بزرگ، بهتر است ساختار پیامها را پایدار نگه دارید و داده متغیر را در جای مناسب قرار دهید. البته این یک توصیه طراحی است؛ وجود Prefix Caching در یک سرویس یا API مشخص باید از مستندات همان سرویس بررسی شود.
آموزش عملی: آزمایش KV Cache باTransformers
در مثال زیر یک مدل کوچک را بارگذاری میکنیم و تولید متن را با کش فعال و غیرفعال مقایسه میکنیم.
این آزمایش برای فهم رفتار API و اندازهگیری محلی است. مدل انتخابشده کوچک است؛ بنابراین نتیجه زمانسنجی آن معیار مناسبی برای پیشبینی عملکرد مدلهای بزرگ در سرورهای تخصصی نیست.
نصب
pip install torch transformersمدل در نخستین اجرا باید دانلود شود. برای این مرحله به اینترنت و فضای ذخیرهسازی کافی نیاز دارید.
بارگذاری مدل وTokenizer
import time

import torch

from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
)


MODEL_ID = (
    "HuggingFaceTB/"
    "SmolLM2-135M-Instruct"
)

device = torch.device(
    "cuda"
    if torch.cuda.is_available()
    else "cpu"
)

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID
)

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID
).to(device)

model.eval()

prompt = (
    "Explain three practical benefits "
    "of using an AI API in a product."
)

inputs = tokenizer(
    prompt,
    return_tensors="pt",
).to(device)

print("Device:", device)

print(
    "Input tokens:",
    inputs["input_ids"].shape[-1],
)
در این آزمایش از متن انگلیسی استفاده شده تا تمرکز روی سازوکار کش و زمان اجرا باشد. نتیجه آن درباره کیفیت پاسخ فارسی مدل چیزی نشان نمیدهد.
تابع تولید و اندازهگیری زمان
برای اندازهگیری روی GPU، پیش از شروع و پس از پایان زمانسنجی منتظر تکمیل عملیات دستگاه میمانیم.
def synchronize_if_needed():
    if device.type == "cuda":
        torch.cuda.synchronize()


def run_generation(use_cache):
    synchronize_if_needed()

    start = time.perf_counter()

    with torch.inference_mode():
        output_ids = model.generate(
            **inputs,
            max_new_tokens=48,
            min_new_tokens=48,
            do_sample=False,
            use_cache=use_cache,
            pad_token_id=tokenizer.eos_token_id,
        )

    synchronize_if_needed()

    elapsed_seconds = (
        time.perf_counter()
        - start
    )

    prompt_length = (
        inputs["input_ids"]
        .shape[-1]
    )

    new_token_ids = output_ids[
        0,
        prompt_length:,
    ]

    generated_text = tokenizer.decode(
        new_token_ids,
        skip_special_tokens=True,
    )

    return {
        "elapsed_seconds": elapsed_seconds,
        "new_tokens": len(new_token_ids),
        "text": generated_text,
        "token_ids": new_token_ids.cpu(),
    }
min_new_tokens و max_new_tokens در این آزمایش برابرند تا شمار توکنهای تولیدی در دو حالت یکسان باشد. این تنظیم برای مقایسه آزمایشگاهی است و معمولاً لازم نیست در محصول واقعی طول پاسخ را به این شکل ثابت کنید.
گرمکردن و اجرای آزمایش
# اجرای گرمکننده؛ در نتایج گزارش نمیشود.
_ = run_generation(
use_cache=True
)
results = {}
for cache_enabled in (
False,
True,
):
measurements = []
for _ in range(3):
result = run_generation(
use_cache=cache_enabled
)
measurements.append(
result["elapsed_seconds"]
)
label = (
"cache_on"
if cache_enabled
else "cache_off"
)
results[label] = {
"median_seconds": sorted(
measurements
)[len(measurements) // 2],
"last_run": result,
}
for label, value in results.items():
print(
label,
"median seconds:",
round(
value["median_seconds"],
4,
),
)
print(
"Same token IDs:",
torch.equal(
results["cache_off"]
["last_run"]
["token_ids"],
results["cache_on"]
["last_run"]
["token_ids"],
),
)نتیجه را چگونه تفسیر کنیم؟
اگر زمان حالت کشدار کمتر بود، آزمایش نشان میدهد این تنظیم در همین محیط و همین ورودی مفید بوده است.
اگر تفاوت کم بود یا نتیجه برعکس شد، به این موارد توجه کنید:
- مدل بسیار کوچک است.
- تعداد توکنهای خروجی محدود است.
- زمان بارگذاری و گرمشدن با اجرای اصلی فرق دارد.
- CPU و GPUرفتار یکسانی ندارند.
- برنامههای دیگر روی دستگاه در حال اجرا هستند.
- هزینههای ثابت Python در آزمایش کوچک محسوساند.
مقایسه شناسه توکنها نیز یک بررسی مفید است؛ بااینحال، تفاوتهای عددی وابسته به سختافزار و پیادهسازی ممکن است در بعضی مدلها و شرایط به انتخاب متفاوت یک توکن منجر شوند. برای ارزیابی عملی، چند ورودی و چند طول پاسخ را بررسی کنید.
آزمایش طولهای متفاوت پاسخ
اثر کش را میتوان در طولهای مختلف خروجی بررسی کرد. برای انجام این کار، تابع تولید را بهگونهای تغییر دهید که تعداد توکنهای خروجی را دریافت کند:
def benchmark_length(
    new_tokens,
    use_cache,
):
    synchronize_if_needed()

    start = time.perf_counter()

    with torch.inference_mode():
        output = model.generate(
            **inputs,
            max_new_tokens=new_tokens,
            min_new_tokens=new_tokens,
            do_sample=False,
            use_cache=use_cache,
            pad_token_id=tokenizer.eos_token_id,
        )

    synchronize_if_needed()

    elapsed = (
        time.perf_counter()
        - start
    )

    return (
        elapsed,
        output.shape[-1],
    )


for length in (
    16,
    32,
    64,
):
    for enabled in (
        False,
        True,
    ):
        elapsed, total_tokens = (
            benchmark_length(
                new_tokens=length,
                use_cache=enabled,
            )
        )

        print(
            "new_tokens:",
            length,
            "| use_cache:",
            enabled,
            "| seconds:",
            round(elapsed, 4),
            "| total_tokens:",
            total_tokens,
        )
این خروجیها را نتیجه قطعی درباره همه مدلها تلقی نکنید. آزمایش مفیدتر برای استقرار باید با مدل، سختافزار، طول درخواست و الگوی ترافیک واقعی انجام شود.
انتخاب راهبرد کش درTransformers
اگر مدل و نسخه ابزار مورد استفاده پشتیبانی کنند، میتوانید هنگام تولید، راهبرد کش را با cache_implementation مشخص کنید.
نمونه استفاده ازStatic Cache:
with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=48,
        do_sample=False,
        cache_implementation="static",
        pad_token_id=tokenizer.eos_token_id,
    )

print(
    tokenizer.decode(
        output_ids[0],
        skip_special_tokens=True,
    )
)
از این مثال نباید نتیجه گرفت Static Cache همیشه سریعتر از Dynamic Cache است. باید زمان اجرا و حافظه مصرفی هر دو روش را روی محیط خود اندازه گرفت. همچنین سازگاری راهبردهای کش به مدل و نسخه Transformers وابسته است. Hugging Face
چگونه مصرف حافظه GPU را بررسی کنیم؟
اگر آزمایش را روی CUDA اجرا میکنید، میتوانید حافظه تخصیصیافته و بیشترین مصرف مشاهدهشده در اجرای آزمایش را بررسی کنید:
if device.type == "cuda":
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats()

    result = run_generation(
        use_cache=True
    )

    peak_bytes = (
        torch.cuda
        .max_memory_allocated()
    )

    print(
        "Peak allocated GPU memory (MiB):",
        round(
            peak_bytes
            / (1024 * 1024),
            2,
        ),
    )
این عدد فقط اندازه KV Cache نیست. حافظه وزنهای مدل، Tensorهای موقت و بخشهای دیگر اجرا نیز در اندازهگیری حضور دارند.
برای مقایسه قابل اعتماد، هر حالت را در شرایط مشابه و ترجیحاً در فرایند تازه اجرا کنید. آزادکردن کش تخصیصدهنده CUDA نیز لزوماً تمام وضعیتهای حافظه فرایند را به نقطه شروع یک اجرای تازه برنمیگرداند.
KV Cacheدر مکالمههای چندمرحلهای
در یک گفتوگو، هر پیام تازه ممکن است همراه بخشی از پیامهای پیشین به مدل داده شود.
دو موضوع را باید از هم جدا کرد:
- مدیریت تاریخچه گفتوگو در برنامه: کدام پیامها برای درخواست بعدی ارسال شوند؟
- مدیریت KV Cache در موتور مدل: وضعیت Attention متن پردازششده چگونه نگهداری یا استفاده مجدد شود؟
حتی اگر برنامه تاریخچه گفتوگو را در پایگاه داده ذخیره کند، به این معنا نیست که KV Cache مدل نیز میان درخواستها نگهداری شده است.
برعکس، اگر موتور مدل از Prefix Caching پشتیبانی کند، باز هم باید مشخص شود کدام بخش از پیامهای ارسالی واقعاً پیشوند مشترک درخواستهاست.
ارتباط KV Cache با طولContext
افزایش طول Context میتواند کاربرد مدل را گسترش دهد؛ مثلاً برای خواندن سندهای بزرگ یا ادامه گفتوگوهای طولانی مفید است. اما طول قابل پشتیبانی مدل، بهتنهایی نشان نمیدهد اجرای آن با آن طول ارزان یا سریع خواهد بود.
هنگام طراحی محصول، این موارد را جداگانه بررسی کنید:
- طول معمول ورودیها
- طول درخواستهای بسیار بزرگ
- تعداد توکنهای خروجی
- تعداد درخواستهای همزمان
- محدودیت حافظه موتور اجرا
- زمان تا نخستین توکن
- زمان تکمیل پاسخ
یک سرویس ممکن است از Context بزرگ پشتیبانی کند، ولی استفاده همزمان کاربران از درخواستهای بلند، ظرفیت عملی آن را کاهش دهد.
KV Cache و Sliding Window Attention
در همه معماریها لازم نیست وضعیت تمام توکنهای گذشته به یک شکل در همه لایهها نگه داشته شود.
در بعضی مدلها، لایههایی با Sliding Window Attention فقط به پنجره مشخصی از توکنها توجه میکنند. بنابراین رفتار رشد کش آن لایهها با حالتی که تمام تاریخچه در هر لایه حفظ میشود فرق دارد.
مستندات Transformers صریحاً اشاره میکند که برای لایههای دارای Sliding Window یا بعضی الگوهای دیگر Attention، رشد کش پس از رسیدن به محدوده مربوط به آن لایه متوقف میشود. Hugging Face
در نتیجه، برآورد حافظه KV Cache باید با معماری همان مدل انجام شود؛ یک قاعده ثابت برای همه مدلهای زبانی کافی نیست.
KV Cacheو تعداد درخواستهای همزمان
اگر یک درخواست طولانی در حال تولید پاسخ باشد، موتور اجرا باید وضعیت لازم برای ادامه آن را نگه دارد. حال اگر تعداد زیادی درخواست مشابه همزمان فعال باشند، نیاز کلی به حافظه افزایش پیدا میکند.
این موضوع روی تصمیمهایی مانند موارد زیر اثر دارد:
- تعداد درخواستهای قابل پردازش همزمان
- طول مجاز ورودی و خروجی
- انتخاب سختافزار
- زمانبندی و صفبندی درخواستها
- تقسیم بار میان چند نمونه از موتور اجرا
- انتخاب روش مدیریت حافظه
بنابراین برای یک سرویس API، «سرعت یک درخواست منفرد» تنها معیار ظرفیت نیست. توان عملیاتی در بار واقعی نیز باید سنجیده شود.
چه زمانی Prefix Caching مفیدتر است؟
Prefix Cachingوقتی ارزش آزمایش بیشتری دارد که بخش بزرگی از ورودی درخواستها تکرار شود؛ مثلاً:
- دستور سیستمی ثابت و طولانی
- راهنمای ثابت یک دستیار سازمانی
- سند یکسان با پرسشهای متفاوت
- قالب ورودی مشترک با بخش متغیر کوچک
اگر هر درخواست از همان ابتدای متن متفاوت باشد، انتظار استفاده مجدد از بخش بزرگی از کش منطقی نیست.
حتی با پیشوند مشابه نیز اثر نهایی به پیادهسازی موتور، طول پیشوند، ظرفیت کش و بار ترافیک بستگی دارد.
KV Cache چه نسبتی با Speculative Decodingدارد؟
Speculative Decoding روش دیگری برای کاهش تأخیر تولید است: یک سازوکار سریعتر چند توکن پیشنهادی میسازد و مدل اصلی آنها را بررسی میکند.
KV Cache و Speculative Decodingمسائل مرتبطی را در مسیر تولید پاسخ هدف میگیرند، ولی یک روش واحد نیستند. موتور استنتاج باید وضعیت کش مدل اصلی و، بسته به روش، وضعیت سازوکار پیشنهاددهنده را نیز مدیریت کند.
برای جزئیات این روش، مقاله Speculative Decodingدر مدلهای زبانی را بخوانید.
اشتباهات رایج دربارهKV Cache
فرض اینکه کش، کل متن را به شکل قابل خواندن ذخیره میکند
محتوای اصلی KV Cache نمایشهای عددی مربوط به Attention است. نگهداری متن مکالمه در برنامه موضوع دیگری است.
فرض اینکه کش بدون هزینه است
کش محاسبات تکراری را کاهش میدهد، اما حافظه و مدیریت اجرایی لازم دارد.
فرض اینکه کش هر درخواست را سریعتر میکند
اثر آن به طول تولید، اندازه مدل، سختافزار و سربارهای اجرا بستگی دارد.
برابر دانستن KV Cache با کش پاسخ
کش پاسخ میتواند خروجی آماده را برای درخواست تعریفشده بازگرداند. KV Cache در فرایند اجرای مدل استفاده میشود.
فرض اشتراک خودکار کش میان کاربران
استفاده دوباره از پیشوند میان درخواستها به قابلیت موتور و شرایط سازگاری ورودیها وابسته است.
مقایسه سرعت بدون ثابتنگهداشتن تعداد توکنها
دو پاسخ با طول متفاوت، مبنای خوبی برای مقایسه زمان تولید نیستند.
بررسینکردن بار همزمان
تنظیمی که در اجرای یک درخواست سریع است، ممکن است در بار همزمان به دلیل فشار حافظه نتیجه متفاوتی داشته باشد.
نتیجهگیری از یک مدل کوچک برای همه مدلها
رفتار یک آزمایش روی CPU با مدل کوچک، عملکرد مدل بزرگ روی زیرساخت تولیدی را پیشبینی نمیکند.
برای ارزیابی عملی چه معیارهایی را ثبت کنیم؟
| معیار | کاربرد |
|---|---|
| زمان تا نخستین توکن | سنجش تجربه شروع پاسخ |
| زمان میان توکنهای خروجی | سنجش سرعت نمایش تدریجی پاسخ |
| زمان کل درخواست | سنجش زمان تکمیل کار |
| توکنهای ورودی | تفکیک اثر طول Prompt |
| توکنهای خروجی | مقایسه منصفانه زمان تولید |
| حافظه مصرفی | بررسی ظرفیت اجرا |
| تعداد درخواستهای همزمان | سنجش رفتار زیر بار |
| توان عملیاتی | بررسی ظرفیت سرویس |
| نرخ استفاده دوباره از پیشوند | ارزیابی Prefix Caching در صورت پشتیبانی |
مقایسه را برای چند گروه ورودی انجام دهید: کوتاه، معمول و طولانی. همچنین درخواستهای تکی و بار همزمان را جداگانه بررسی کنید.
پرسشهای متداول
KV Cacheچیست؟
KV Cache نمایشهای Key و Valueتوکنهای پردازششده را در مدل زبانی نگه میدارد تا در ادامه تولید پاسخ بتوان از آنها استفاده کرد و بخشی از محاسبات تکراری حذف شود.
آیا KV Cache کیفیت پاسخ را بهتر میکند؟
هدف اصلی آن بهینهسازی اجراست. کیفیت محتوایی پاسخ از صرف فعالبودن کش بهتر نمیشود. رفتار عددی و خروجی نهایی نیز باید با توجه به پیادهسازی بررسی شود.
آیا KV Cache همان حافظه مکالمه است؟
خیر. حافظه مکالمه در سطح محصول میتواند شامل پیامها، خلاصهها یا دادههای ذخیرهشده باشد. KV Cache وضعیت محاسباتی مدل برای پردازش دنباله است.
آیا KV Cache حافظه GPU مصرف میکند؟
بله، در بسیاری از مسیرهای اجرا وضعیت کش در حافظه GPU نگهداری میشود. مقدار آن به مدل، طول دنباله، تعداد درخواستها و راهبرد کش بستگی دارد.
Dynamic Cache بهتر است یا Static Cache؟
پاسخ عمومی ندارد. Dynamic Cache با طول متغیر انعطاف بیشتری دارد؛ Static Cache برای بعضی بهینهسازیهای اجرایی مناسب است، اما میتواند فضای بیشتری از پیش رزرو کند.
Quantized KV Cacheچه فایدهای دارد؟
میتواند حافظه لازم برای کش را کاهش دهد. اثر آن بر سرعت و مناسببودنش باید در محیط واقعی سنجیده شود.
Prefix Cachingچیست؟
استفاده مجدد از وضعیت محاسبهشده برای بخش آغازین مشترک درخواستهای سازگار است. این قابلیت میتواند پردازش دوباره پیشوند را کاهش دهد.
آیا برای استفاده از API مدل زبانی باید KV Cache را خودم مدیریت کنم؟
معمولاً مدیریت جزئیات داخلی KV Cache بر عهده ارائهدهنده مدل یا موتور استنتاج است. شما باید زمان پاسخ، محدودیتها و قابلیتهای اعلامشده سرویس را بررسی کنید؛ درباره پشتیبانی از Prefix Caching یا تنظیمات خاص، به مستندات همان سرویس رجوع کنید.
جمعبندی
KV Cache نمایشهای Key و Valueتوکنهای قبلی را هنگام تولید متن نگه میدارد و به مدل کمک میکند از محاسبه دوباره بخشی از اطلاعات گذشته پرهیز کند. این سازوکار برای سرعت تولید پاسخ مهم است، اما در مقابل حافظه مصرف میکند.
Dynamic Cache، Static Cache، Offloading، کش کمدقت و مدیریت بلوکی هرکدام راهی برای پاسخ به محدودیتهای متفاوتاند. Prefix Cachingنیز میتواند در شرایط مناسب پردازش دوباره بخش مشترک درخواستها را کاهش دهد.
برای انتخاب زیرساخت، تنها به اندازه مدل یا ادعای «کش فعال» اکتفا نکنید. زمان تا نخستین توکن، زمان کل پاسخ، حافظه، طول درخواست و عملکرد زیر بار همزمان را اندازه بگیرید.
اگر قصد دارید قابلیت مدلهای زبانی را به محصول خود اضافه کنید، میتوانید مدلهای در دسترس و روش اتصال از طریق API را در darvareh.ir بررسی کنید. هنگام مقایسه مدلها، کیفیت پاسخ فارسی، زمان پاسخ و هزینه درخواستهای واقعی محصولتان را کنار هم بسنجید.
مقالات مرتبط
- مدل زبانی بزرگ یا LLM چیست؟
- معماری Transformer وSelf-Attention
- راهنمای Inference در هوش مصنوعی
- آموزش vLLM و ارائه مدل با API سازگار
- Speculative Decodingچیست؟
- Quantizationمدل هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- مستندات Caching درHugging Face Transformers
- مستندات راهبردهای KV Cache درHugging Face Transformers
- مقالهEfficient Memory Management for Large Language Model Serving with PagedAttention
- مستندات Automatic Prefix Caching درvLLM
- مستندات طراحی Prefix Caching درvLLM
- صفحه مدل SmolLM2-135M-Instruct درHugging Face
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و صفحه سلب مسئولیت درواره را مطالعه کنید.



