
خلاصه ویدیو یوتیوب با هوش مصنوعی؛ معرفی ابزارها و آموزش ساخت خلاصهساز فارسی
در این راهنما با بهترین روشهای خلاصهکردن ویدیوهای یوتیوب با هوش مصنوعی آشنا میشوید و یک خلاصهساز فارسی واقعی میسازید که متن ویدیو را دریافت، فصلبندی و با API درواره خلاصه میکند. کد کامل Python و FastAPI، روش مدیریت ویدیوهای طولانی و مسیر پردازش ویدیوهای بدون زیرنویس نیز ارائه شده است.

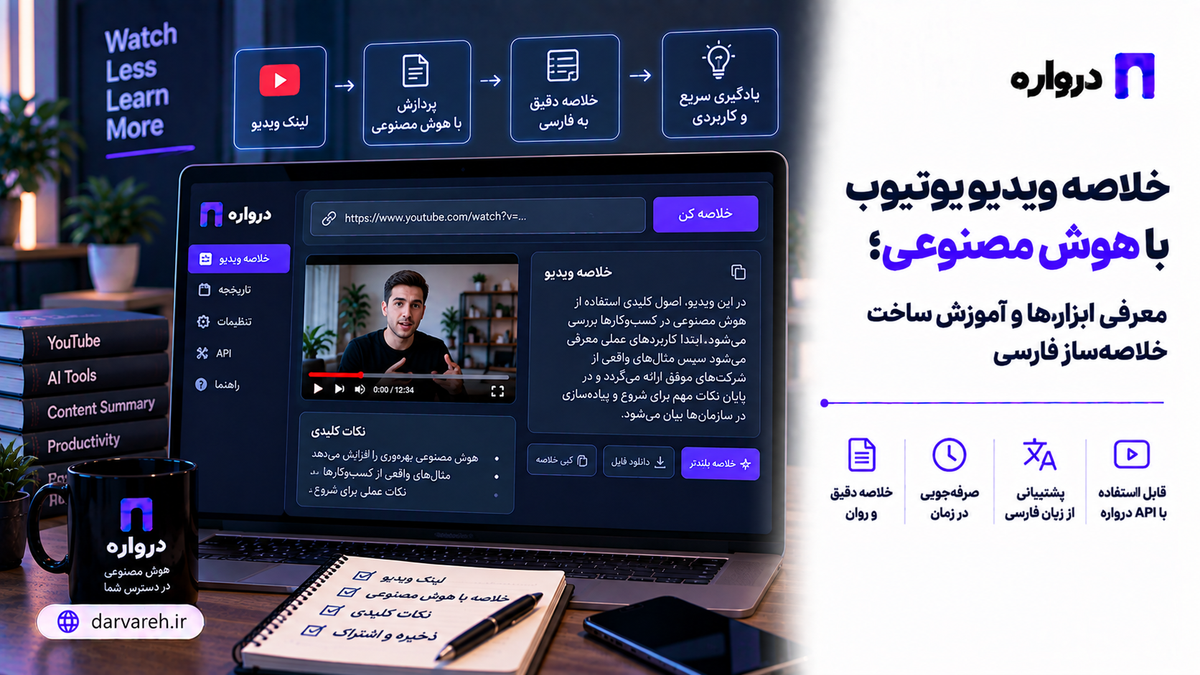
تماشای یک ویدیوی آموزشی ۶۰ دقیقهای برای پیداکردن چند نکته مشخص همیشه امکانپذیر نیست. ابزارهای خلاصهسازی ویدیو با هوش مصنوعی میتوانند محتوای گفتاری ویدیو را به خلاصه، نکات کلیدی، فصلبندی زمانی، سؤال و جواب یا یادداشت آموزشی تبدیل کنند.
کاربر معمولاً فقط لینک ویدیو را وارد میکند و خروجیهایی مانند موارد زیر را دریافت میکند:
- خلاصه کوتاه ویدیو
- نکات کلیدی
- فصلبندی همراه با زمان
- نقلقولها و اصطلاحات مهم
- سؤالهای آموزشی
- چکلیست اقدامات
- متن کامل صحبتها
- ترجمه فارسی محتوا
- پاسخ به سؤال درباره ویدیو
در این مقاله علاوه بر معرفی روشها و ابزارهای خلاصه ویدیو، یک برنامه واقعی میسازیم که Transcript ویدیو را دریافت و با استفاده از مدلهای هوش مصنوعی درواره، خلاصه فارسی تولید میکند.
خلاصهسازی ویدیو با هوش مصنوعی چگونه انجام میشود؟
مدل زبانی معمولاً فایل ویدیویی را مستقیماً خلاصه نمیکند. ابتدا محتوای گفتاری ویدیو باید به متن تبدیل شود.
سه مسیر اصلی وجود دارد:
استفاده از زیرنویس موجود
اگر ویدیو زیرنویس دستی یا خودکار داشته باشد، متن زیرنویس دریافت و برای خلاصهسازی به مدل ارسال میشود.
تبدیل صوت به متن
اگر زیرنویس موجود نباشد، صدای ویدیو استخراج و با یک مدل تشخیص گفتار مانند Whisper به متن تبدیل میشود.
تحلیل مستقیم ویدیو
بعضی مدلهای چندوجهی میتوانند تصویر، صدا و توالی ویدیو را تحلیل کنند. این روش برای درک صحنهها، اسلایدها و اتفاقات بصری مفیدتر است، اما معمولاً هزینه و پیچیدگی بیشتری دارد.
در بیشتر ویدیوهای سخنرانی، مصاحبه، کلاس و پادکست تصویری، مسیر زیر کافی است:
لینک یا فایل ویدیو
↓
دریافت زیرنویس یا استخراج صوت
↓
تبدیل گفتار به متن
↓
پاکسازی و بخشبندی Transcript
↓
خلاصهسازی هر بخش
↓
ترکیب خلاصهها
↓
خروجی فارسی همراه با زمانبندی
تفاوت Transcript، Subtitle و Summary
| اصطلاح | معنی |
|---|---|
| Transcript | متن کامل صحبتهای ویدیو |
| Subtitle | متن زمانبندیشده برای نمایش همزمان با ویدیو |
| Caption | زیرنویسی که ممکن است توضیح صداهای غیرگفتاری را نیز شامل شود |
| Summary | نسخه کوتاهشده و ساختاریافته محتوا |
| Chapters | بخشبندی موضوعی ویدیو همراه با زمان شروع |
| Highlights | مهمترین نکات یا قسمتهای قابل توجه |
برای ساخت خلاصه دقیق، بهتر است زمان شروع هر قسمت Transcript حفظ شود. در این صورت مدل میتواند فصلهای ویدیو را همراه با Timestamp تولید کند.
کاربردهای خلاصه ویدیو یوتیوب
ویدیوهای آموزشی
مدرس یا دانشجو میتواند خلاصه درس، تعاریف اصلی، مثالها و تمرینها را استخراج کند.
دورههای برنامهنویسی
از ویدیو میتوان ابزارهای معرفیشده، دستورات مهم، مراحل پروژه و خطاهای رایج را به دست آورد.
پادکست و مصاحبه
سامانه میتواند دیدگاه هر مهمان، نکات اصلی گفتگو و موضوعات مطرحشده را خلاصه کند.
جلسات و وبینارها
اگر فایل جلسه یا زیرنویس آن در اختیار شما باشد، میتوان تصمیمها، مسئولیتها و اقدامات بعدی را استخراج کرد.
تولید محتوا
یک ویدیوی بلند میتواند به مقاله، پست لینکدین، کپشن، خبرنامه یا چند متن کوتاه تبدیل شود.
تحقیق و بررسی
بهجای تماشای کامل چند ویدیو، ابتدا خلاصه آنها بررسی و سپس قسمتهای مهم مشاهده میشوند.
آموزش زبان
Transcript، ترجمه، واژههای مهم و سؤالهای درک مطلب را میتوان از ویدیو استخراج کرد.
ابزارهای خلاصه ویدیو با هوش مصنوعی
ابزارهای موجود در چند دسته قرار میگیرند.
ابزارهای آنلاین خلاصه ویدیو
ابزارهایی مانند Eightify، Glasp، NoteGPT و بعضی افزونههای مرورگر میتوانند لینک YouTube را دریافت و خلاصه تولید کنند.
قبل از انتخاب ابزار بررسی کنید:
- از زبان فارسی پشتیبانی میکند یا خیر.
- ویدیوهای طولانی را پردازش میکند یا خیر.
- Timestamp ارائه میدهد یا خیر.
- محدودیت نسخه رایگان چقدر است.
- امکان خروجیگرفتن وجود دارد یا خیر.
- در موقعیت جغرافیایی شما قابل استفاده است یا خیر.
دسترسی و امکانات این سرویسها ممکن است تغییر کند. برای یک محصول پایدار یا سازمانی، ساخت ابزار اختصاصی کنترل بیشتری ایجاد میکند.
NotebookLM
NotebookLM برای کار با منابع و تولید پاسخ یا خلاصه مبتنی بر آنها طراحی شده است. بسته به قابلیتهای فعال حساب و نوع ویدیو، میتوان از منابع پشتیبانیشده در آن استفاده کرد.
افزونههای Chrome
افزونههای خلاصهساز میتوانند هنگام مشاهده ویدیو، Transcript و خلاصه را کنار صفحه نمایش دهند. این روش برای استفاده روزمره سریع است.
Whisper
Whisper یک مدل متنباز تشخیص گفتار چندزبانه است که میتواند فایل صوتی را به متن تبدیل کند. مخزن رسمی Whisper آن را مدلی برای تشخیص گفتار، ترجمه گفتار و تشخیص زبان معرفی میکند. مخزن رسمی Whisper
faster-whisper
faster-whisper پیادهسازی بهینهتری از Whisper بر پایه CTranslate2 است و در بسیاری از پروژهها برای پردازش سریعتر یا مصرف حافظه کمتر استفاده میشود.
yt-dlp
yt-dlp ابزار خط فرمان متنبازی برای دریافت و پردازش رسانه و زیرنویس از سایتهای پشتیبانیشده است. استفاده از آن باید فقط برای محتوایی انجام شود که مجوز دسترسی و پردازش آن را دارید. مخزن رسمی yt-dlp
YouTube Transcript API
کتابخانه youtube-transcript-api میتواند Transcriptهای قابل دسترسی بعضی ویدیوها را بدون اجرای مرورگر دریافت کند. این پروژه از یک بخش مستندنشدۀ رابط YouTube استفاده میکند؛ بنابراین ممکن است با تغییرات پلتفرم متوقف یا محدود شود. نگهدارنده پروژه نیز این محدودیت را صریحاً اعلام کرده است. مخزن youtube-transcript-api
آیا YouTube Data API متن زیرنویس عمومی را میدهد؟
در YouTube Data API، مسیر captions.list فقط فهرست ترکهای زیرنویس مرتبط با ویدیو را برمیگرداند و خود متن زیرنویس را در پاسخ قرار نمیدهد. مستندات Captions: list
برای دریافت متن باید از captions.download استفاده شود، اما مستندات رسمی اعلام میکنند کاربر احراز هویتشده باید مجوز ویرایش ویدیو را داشته باشد. بنابراین این مسیر بیشتر برای ویدیوهای متعلق به خود کاربر یا کانال تحت مدیریت او مناسب است. مستندات Captions: download
برای محصول واقعی سه مسیر قابل بررسی است:
| شرایط | مسیر مناسب |
|---|---|
| ویدیو متعلق به خودتان است | YouTube Data API و OAuth |
| Transcript عمومی قابل دریافت است | کتابخانه Transcript با درنظرگرفتن احتمال تغییر |
| فایل صوتی یا ویدیویی مجاز در اختیار دارید | تبدیل گفتار به متن با Whisper |
چرا ابزار خلاصهساز اختصاصی بسازیم؟
ساخت ابزار اختصاصی مزایای زیر را دارد:
- تولید خروجی کاملاً فارسی
- انتخاب مدل متناسب با هزینه و کیفیت
- تعریف قالب خلاصه اختصاصی
- پشتیبانی از ویدیوهای طولانی
- ساخت فصلبندی زمانی
- استخراج اقدامها و سؤالها
- اتصال به وبسایت یا اپلیکیشن
- امکان فروش سرویس به کاربران
- کنترل تعداد درخواست و مصرف
- اتصال به API یکپارچه درواره
معماری خلاصهساز ویدیو با API درواره
کاربر
↓
ارسال لینک YouTube
↓
Backend برنامه
↓
استخراج Video ID
↓
دریافت Transcript
↓
تقسیم متن به بخشهای کوچک
↓
خلاصهسازی هر بخش با درواره
↓
ترکیب خلاصههای میانی
↓
خلاصه نهایی فارسی
آدرس پایه API درواره:
https://api.darvareh.ir/v1
شناسه مدل از متغیر محیطی خوانده میشود تا بتوان مدل را بدون تغییر کد عوض کرد.
خروجی مورد انتظار برنامه
خلاصه نهایی میتواند این ساختار را داشته باشد:
## خلاصه کوتاه
این ویدیو درباره روش ساخت یک برنامه هوش مصنوعی با Python است...
## نکات کلیدی
- ابتدا مسئله و خروجی مطلوب تعریف میشود.
- مدل از طریق API به Backend متصل میشود.
- خروجی مدل پیش از استفاده اعتبارسنجی میشود.
## فصلبندی
- 00:00 — معرفی موضوع
- 03:20 — طراحی معماری
- 11:45 — نوشتن کد
- 26:10 — مدیریت خطاها
## اقدامات پیشنهادی
1. ساخت پروژه آزمایشی
2. تعریف متغیرهای محیطی
3. مقایسه چند مدل
ساخت پروژه با Python
ساختار پروژه:
youtube-ai-summarizer/
├── app.py
├── requirements.txt
└── .env
نصب کتابخانهها
محتوای requirements.txt:
fastapi
uvicorn[standard]
openai
python-dotenv
youtube-transcript-api
ساخت محیط مجازی:
python -m venv .venv
فعالسازی در Linux و macOS:
source .venv/bin/activate
فعالسازی در Windows:
.venv\Scripts\activate
نصب وابستگیها:
pip install -r requirements.txt
تنظیم کلید API درواره
فایل .env:
DARVAREH_API_KEY=YOUR_API_KEY
DARVAREH_MODEL=YOUR_MODEL_ID
DARVAREH_BASE_URL=https://api.darvareh.ir/v1
شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید.
کد کامل خلاصهساز ویدیو
فایل app.py:
import os
import re
from urllib.parse import parse_qs, urlparse
from dotenv import load_dotenv
from fastapi import FastAPI, HTTPException
from openai import OpenAI
from pydantic import BaseModel, Field, HttpUrl
from youtube_transcript_api import YouTubeTranscriptApi
load_dotenv()
DARVAREH_API_KEY = os.environ["DARVAREH_API_KEY"]
DARVAREH_MODEL = os.environ["DARVAREH_MODEL"]
DARVAREH_BASE_URL = os.getenv(
"DARVAREH_BASE_URL",
"https://api.darvareh.ir/v1",
)
MAX_CHUNK_CHARACTERS = 9000
MAX_FINAL_INPUT_CHARACTERS = 45000
app = FastAPI(
title="Persian YouTube AI Summarizer",
version="1.0.0",
)
client = OpenAI(
api_key=DARVAREH_API_KEY,
base_url=DARVAREH_BASE_URL,
)
transcript_client = YouTubeTranscriptApi()
class SummaryRequest(BaseModel):
youtube_url: HttpUrl
output_language: str = Field(
default="fa",
pattern="^(fa|en)$",
)
extra_instruction: str = Field(
default="",
max_length=2000,
)
class SummaryResponse(BaseModel):
video_id: str
transcript_language: str
transcript_type: str
duration_seconds: int
chunks_count: int
model: str
summary: str
def extract_video_id(url: str) -> str:
"""استخراج شناسه ویدیو از انواع URLهای YouTube."""
parsed = urlparse(url)
hostname = parsed.hostname or ""
if hostname in {"youtu.be", "www.youtu.be"}:
video_id = parsed.path.lstrip("/").split("/")[0]
elif hostname.endswith("youtube.com"):
if parsed.path == "/watch":
video_id = parse_qs(
parsed.query
).get("v", [""])[0]
elif parsed.path.startswith(
("/shorts/", "/embed/", "/live/")
):
parts = parsed.path.strip("/").split("/")
video_id = parts[1] if len(parts) > 1 else ""
else:
video_id = ""
else:
video_id = ""
if not re.fullmatch(r"[A-Za-z0-9_-]{11}", video_id):
raise ValueError("لینک یا شناسه ویدیوی YouTube معتبر نیست.")
return video_id
def format_timestamp(seconds: float) -> str:
"""تبدیل ثانیه به HH:MM:SS یا MM:SS."""
total_seconds = max(0, int(seconds))
hours, remainder = divmod(total_seconds, 3600)
minutes, seconds = divmod(remainder, 60)
if hours:
return f"{hours:02d}:{minutes:02d}:{seconds:02d}"
return f"{minutes:02d}:{seconds:02d}"
def fetch_transcript(video_id: str):
"""دریافت بهترین Transcript موجود."""
try:
transcript_list = transcript_client.list(video_id)
except Exception as error:
raise ValueError(
"فهرست زیرنویسهای ویدیو قابل دریافت نیست."
) from error
transcript = None
try:
transcript = transcript_list.find_manually_created_transcript(
["fa", "en"]
)
except Exception:
pass
if transcript is None:
try:
transcript = transcript_list.find_generated_transcript(
["fa", "en"]
)
except Exception:
pass
if transcript is None:
for available_transcript in transcript_list:
transcript = available_transcript
break
if transcript is None:
raise ValueError(
"Transcript قابل استفادهای برای این ویدیو پیدا نشد."
)
try:
fetched = transcript.fetch()
except Exception as error:
raise ValueError(
"دریافت متن زیرنویس ناموفق بود."
) from error
snippets = [
{
"text": item.text.strip(),
"start": float(item.start),
"duration": float(item.duration),
}
for item in fetched
if item.text.strip()
]
if not snippets:
raise ValueError("متن زیرنویس خالی است.")
transcript_type = (
"generated"
if transcript.is_generated
else "manual"
)
return {
"snippets": snippets,
"language": transcript.language,
"language_code": transcript.language_code,
"type": transcript_type,
}
def split_transcript(
snippets: list[dict],
) -> list[str]:
"""تقسیم Transcript با حفظ Timestamp."""
chunks = []
current_lines = []
current_length = 0
for snippet in snippets:
timestamp = format_timestamp(snippet["start"])
line = f"[{timestamp}] {snippet['text']}"
if (
current_lines
and current_length + len(line)
> MAX_CHUNK_CHARACTERS
):
chunks.append("\n".join(current_lines))
current_lines = []
current_length = 0
current_lines.append(line)
current_length += len(line) + 1
if current_lines:
chunks.append("\n".join(current_lines))
return chunks
def call_model(
system_prompt: str,
user_prompt: str,
) -> str:
"""ارسال درخواست به مدل انتخابشده در درواره."""
completion = client.chat.completions.create(
model=DARVAREH_MODEL,
messages=[
{
"role": "system",
"content": system_prompt,
},
{
"role": "user",
"content": user_prompt,
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("مدل پاسخ متنی معتبری برنگرداند.")
return content.strip()
def summarize_chunk(
chunk: str,
chunk_number: int,
total_chunks: int,
output_language: str,
) -> str:
"""خلاصهسازی یک بخش از Transcript."""
language_name = (
"فارسی"
if output_language == "fa"
else "English"
)
system_prompt = (
"شما متخصص خلاصهسازی دقیق محتوای ویدیویی هستید. "
"فقط بر اساس Transcript ارائهشده بنویسید. "
"نامها، اعداد و زمانها را دقیق حفظ کنید."
)
user_prompt = f"""
این بخش شماره {chunk_number} از {total_chunks} بخش ویدیو است.
Transcript:
{chunk}
این بخش را به زبان {language_name} خلاصه کن.
قواعد:
- موضوعات اصلی را استخراج کن.
- ادعا، مثال، نام، عدد و نتیجه مهم را حفظ کن.
- برای موضوعات مهم Timestamp بنویس.
- مطالب تکراری و جملههای محاورهای غیرضروری را حذف کن.
- اطلاعاتی خارج از Transcript اضافه نکن.
"""
return call_model(
system_prompt=system_prompt,
user_prompt=user_prompt,
)
def build_final_summary(
partial_summaries: list[str],
output_language: str,
extra_instruction: str,
) -> str:
"""ترکیب خلاصههای میانی و تولید خروجی نهایی."""
language_name = (
"فارسی"
if output_language == "fa"
else "English"
)
combined = "\n\n---\n\n".join(
f"خلاصه بخش {index + 1}:\n{summary}"
for index, summary in enumerate(partial_summaries)
)
combined = combined[:MAX_FINAL_INPUT_CHARACTERS]
additional_instruction = (
extra_instruction.strip()
if extra_instruction.strip()
else "دستور تکمیلی وجود ندارد."
)
system_prompt = (
"شما ویراستار حرفهای خلاصه ویدیو هستید. "
"خلاصه نهایی باید دقیق، منظم و مبتنی بر متن باشد."
)
user_prompt = f"""
خلاصههای میانی یک ویدیو در ادامه آمدهاند:
{combined}
یک خلاصه نهایی به زبان {language_name} تولید کن.
ساختار خروجی:
## خلاصه کوتاه
یک جمعبندی کوتاه از کل ویدیو
## نکات کلیدی
فهرست مهمترین نکات
## فصلبندی زمانی
عنوان بخشهای اصلی همراه با Timestampهای موجود
## جزئیات مهم
نامها، اعداد، مثالها و نتایج مهم
## جمعبندی نهایی
نتیجه یا پیام اصلی ویدیو
دستور تکمیلی کاربر:
{additional_instruction}
قواعد:
- مطالب تکراری را ادغام کن.
- Timestamp جدید اختراع نکن.
- اطلاعات خارج از خلاصههای میانی اضافه نکن.
- اگر اقدام مشخصی مطرح شده، بخش «اقدامات پیشنهادی» اضافه کن.
"""
return call_model(
system_prompt=system_prompt,
user_prompt=user_prompt,
)
@app.get("/health")
def health():
return {
"status": "ok",
"model": DARVAREH_MODEL,
}
@app.post(
"/api/summarize",
response_model=SummaryResponse,
)
def summarize_youtube_video(
request: SummaryRequest,
):
try:
video_id = extract_video_id(
str(request.youtube_url)
)
transcript_data = fetch_transcript(video_id)
chunks = split_transcript(
transcript_data["snippets"]
)
partial_summaries = [
summarize_chunk(
chunk=chunk,
chunk_number=index + 1,
total_chunks=len(chunks),
output_language=request.output_language,
)
for index, chunk in enumerate(chunks)
]
final_summary = build_final_summary(
partial_summaries=partial_summaries,
output_language=request.output_language,
extra_instruction=request.extra_instruction,
)
except ValueError as error:
raise HTTPException(
status_code=422,
detail=str(error),
) from error
except Exception as error:
raise HTTPException(
status_code=502,
detail=f"پردازش ویدیو ناموفق بود: {error}",
) from error
last_snippet = transcript_data["snippets"][-1]
duration_seconds = int(
last_snippet["start"]
+ last_snippet["duration"]
)
return SummaryResponse(
video_id=video_id,
transcript_language=(
transcript_data["language"]
),
transcript_type=transcript_data["type"],
duration_seconds=duration_seconds,
chunks_count=len(chunks),
model=DARVAREH_MODEL,
summary=final_summary,
)
اجرای برنامه
دستور زیر را اجرا کنید:
uvicorn app:app --reload
سپس مستندات تعاملی FastAPI را باز کنید:
http://127.0.0.1:8000/docs
مسیر اصلی برنامه:
POST /api/summarize
ورودی نمونه:
{
  "youtube_url": "https://www.youtube.com/watch?v=VIDEO_ID",
  "output_language": "fa",
  "extra_instruction": "اصطلاحات فنی را نیز تعریف کن."
}
خروجی نمونه:
{
  "video_id": "VIDEO_ID",
  "transcript_language": "English",
  "transcript_type": "manual",
  "duration_seconds": 1845,
  "chunks_count": 4,
  "model": "YOUR_MODEL_ID",
  "summary": "## خلاصه کوتاه\n..."
}
چرا ویدیوهای طولانی را در چند مرحله خلاصه میکنیم؟
ارسال Transcript کامل یک ویدیوی چندساعته در یک درخواست مشکلاتی ایجاد میکند:
- ورودی ممکن است از Context مدل بزرگتر شود.
- هزینه درخواست افزایش پیدا میکند.
- مدل ممکن است به بخشهای انتهایی کمتر توجه کند.
- احتمال حذف جزئیات و Timestampها بیشتر میشود.
- در صورت خطا، کل پردازش باید تکرار شود.
در روش سلسلهمراتبی:
- Transcript به بخشهای کوچک تقسیم میشود.
- هر بخش جداگانه خلاصه میشود.
- خلاصههای میانی به مدل داده میشوند.
- مدل خروجی نهایی را میسازد.
این روش با نام Map-Reduce Summarization نیز شناخته میشود.
بخشبندی بهتر بر اساس زمان
در نمونه آموزشی، تقسیم متن بر اساس تعداد نویسه انجام شد. برای نتیجه حرفهایتر میتوان هر Chunk را بر اساس زمان ساخت:
def split_by_time(
    snippets: list[dict],
    minutes_per_chunk: int = 10,
) -> list[str]:
    chunks = []
    current_lines = []
    chunk_start = 0
    chunk_seconds = minutes_per_chunk * 60

    for snippet in snippets:
        if (
            current_lines
            and snippet["start"] - chunk_start
            >= chunk_seconds
        ):
            chunks.append("\n".join(current_lines))
            current_lines = []
            chunk_start = snippet["start"]

        timestamp = format_timestamp(
            snippet["start"]
        )

        current_lines.append(
            f"[{timestamp}] {snippet['text']}"
        )

    if current_lines:
        chunks.append("\n".join(current_lines))

    return chunks
تقسیم ۵ تا ۱۰ دقیقهای برای بسیاری از ویدیوهای آموزشی نقطه شروع مناسبی است، اما باید با نوع محتوا و ظرفیت مدل هماهنگ شود.
اگر ویدیو زیرنویس نداشته باشد چه کنیم؟
در صورت داشتن مجوز پردازش فایل، ابتدا صدا را استخراج کنید و سپس آن را به متن تبدیل کنید.
نصب yt-dlp
pip install -U yt-dlp
استخراج صوت
yt-dlp \
  -x \
  --audio-format mp3 \
  -o "input.%(ext)s" \
  "YOUTUBE_URL"
این روش را فقط برای ویدیوهایی استفاده کنید که متعلق به شما هستند یا اجازه دریافت و پردازش آنها را دارید.
نصب Whisper
pip install -U openai-whisper
Whisper به FFmpeg نیاز دارد. در Ubuntu یا Debian:
sudo apt update
sudo apt install ffmpeg
تبدیل فایل به متن:
whisper input.mp3 \
  --model turbo \
  --output_format srt
برای تعیین زبان فارسی:
whisper input.mp3 \
  --model turbo \
  --language Persian \
  --output_format srt
خروجی SRT شامل متن و زمانبندی است و میتوان آن را با همان الگوریتم بخشبندی و خلاصهسازی پردازش کرد.
استفاده از faster-whisper
نصب:
pip install faster-whisper
نمونه کد:
from faster_whisper import WhisperModel


model = WhisperModel(
    "medium",
    device="cpu",
    compute_type="int8",
)

segments, info = model.transcribe(
    "input.mp3",
    language="fa",
    vad_filter=True,
)

transcript_items = []

for segment in segments:
    transcript_items.append(
        {
            "start": segment.start,
            "duration": segment.end - segment.start,
            "text": segment.text.strip(),
        }
    )
اگر GPU مناسب دارید، میتوانید تنظیمات اجرا را بر اساس سختافزار تغییر دهید.
طراحی رابط کاربری خلاصهساز
صفحه کاربر میتواند شامل این عناصر باشد:
- فیلد لینک ویدیو
- انتخاب زبان خروجی
- نوع خلاصه
- میزان جزئیات
- دستور تکمیلی
- دکمه پردازش
- وضعیت دریافت Transcript
- وضعیت خلاصهسازی
- نمایش نتیجه Markdown
- دکمه کپی و دانلود
- لینک مستقیم به Timestampها
انواع خروجی پیشنهادی:
| نوع خروجی | کاربرد |
|---|---|
| خلاصه کوتاه | بررسی سریع موضوع |
| خلاصه کامل | مطالعه محتوای اصلی |
| نکات کلیدی | مرور سریع |
| فصلبندی | رفتن به قسمت موردنظر |
| یادداشت آموزشی | دانشجو و مدرس |
| پست وبلاگ | تولید محتوا |
| پست شبکه اجتماعی | بازنشر نکات |
| سؤال و جواب | مطالعه و آزمون |
| Action Items | جلسه و وبینار |
ساخت لینک قابل کلیک برای Timestamp
برای تبدیل زمان به لینک:
def youtube_timestamp_url(
    video_id: str,
    seconds: int,
) -> str:
    return (
        f"https://www.youtube.com/watch"
        f"?v={video_id}&t={seconds}s"
    )
مثال:
https://www.youtube.com/watch?v=VIDEO_ID&t=320s
برای ساخت لینک دقیق، علاوه بر متن نمایشی Timestamp باید مقدار ثانیه نیز در ساختار داده حفظ شود.
تولید خروجی JSON ساختاریافته
اگر خلاصه داخل اپلیکیشن نمایش داده میشود، JSON از Markdown قابل کنترلتر است.
ساختار پیشنهادی:
{
  "short_summary": "خلاصه کوتاه",
  "key_points": [
    "نکته اول",
    "نکته دوم"
  ],
  "chapters": [
    {
      "start_seconds": 0,
      "timestamp": "00:00",
      "title": "معرفی"
    },
    {
      "start_seconds": 325,
      "timestamp": "05:25",
      "title": "موضوع اصلی"
    }
  ],
  "important_terms": [
    {
      "term": "RAG",
      "definition": "توضیح اصطلاح"
    }
  ],
  "action_items": []
}
خروجی مدل باید در Backend با Pydantic اعتبارسنجی شود. اگر Timestamp مدل با دادههای ورودی مطابقت ندارد، نتیجه نباید بدون کنترل پذیرفته شود.
ساخت چت با ویدیو
پس از ذخیره Transcript، میتوان قابلیت پرسش از ویدیو را نیز اضافه کرد:
Transcript زمانبندیشده
↓
تقسیم به Chunk
↓
ساخت Embedding
↓
ذخیره در پایگاه برداری
↓
پرسش کاربر
↓
بازیابی بخشهای مرتبط
↓
پاسخ همراه با Timestamp
نمونه سؤالها:
- مدرس در مورد RAG چه توضیحی داد؟
- مثال مربوط به پایگاه داده در چه دقیقهای بود؟
- سه ابزار معرفیشده چه نام داشتند؟
- نتیجه نهایی سخنران چه بود؟
- این ویدیو با ویدیوی قبلی چه تفاوتی دارد؟
این قابلیت از نظر معماری شبیه چت با PDF است؛ با این تفاوت که بهجای شماره صفحه از Timestamp استفاده میشود.
خلاصهسازی تصویر و اسلایدهای ویدیو
Transcript فقط صحبتها را پوشش میدهد. ممکن است اطلاعات مهم در اسلاید، نمودار، کد یا تصویر قرار داشته باشد و گوینده آن را کامل نخواند.
برای تحلیل تصویری:
- در فاصلههای زمانی مشخص Frame استخراج کنید.
- Frameهای تکراری را حذف کنید.
- تصاویر مهم را به مدل دارای قابلیت بینایی بدهید.
- توضیح تصویر را همراه Timestamp ذخیره کنید.
- توضیحات بصری را با Transcript ترکیب کنید.
استخراج هر ۳۰ ثانیه یک Frame با FFmpeg:
ffmpeg \
  -i input.mp4 \
  -vf "fps=1/30" \
  frames/frame-%05d.jpg
برای ویدیوی دارای اسلاید، بهتر است تغییر صحنه تشخیص داده شود تا فقط هنگام تغییر اسلاید تصویر جدید استخراج شود.
انتخاب مدل مناسب در درواره
مدل مناسب خلاصهسازی ویدیو باید:
- متن فارسی را بهخوبی تولید کند.
- ورودی طولانی را مدیریت کند.
- نامها و اعداد را حفظ کند.
- از Timestampهای ورودی استفاده کند.
- خروجی ساختاریافته ارائه دهد.
- از اضافهکردن اطلاعات خارج از متن خودداری کند.
- زمان پاسخ و هزینه مناسبی داشته باشد.
چند مدل را روی مجموعه ثابتی از ویدیوها آزمایش کنید:
- ویدیوی فارسی با زیرنویس خودکار
- ویدیوی انگلیسی با زیرنویس دستی
- مصاحبه چندنفره
- آموزش فنی
- ویدیوی طولانی
- ویدیوی دارای اصطلاحات تخصصی
مدیریت هزینه خلاصهسازی ویدیو
هزینه خلاصهسازی بیشتر به طول Transcript و تعداد درخواستها بستگی دارد.
برای کاهش هزینه:
- عبارتهای تکراری زیرنویس را حذف کنید.
- Chunkها را بیش از حد کوچک نسازید.
- خلاصه میانی را کوتاه نگه دارید.
- متن کامل را دوباره در مرحله نهایی ارسال نکنید.
- نتیجه پردازششده هر ویدیو را Cache کنید.
- از شناسه ویدیو بهعنوان بخشی از کلید Cache استفاده کنید.
- مدل را متناسب با نوع مرحله انتخاب کنید.
- برای خلاصههای میانی از مدل سریعتر استفاده کنید.
- فقط در صورت تغییر Prompt یا مدل، خلاصه را دوباره تولید کنید.
کلید Cache پیشنهادی:
video_id
transcript_language
summary_type
output_language
model_id
prompt_version
برای مطالعه بیشتر به مقاله محاسبه هزینه API هوش مصنوعی مراجعه کنید.
معماری مناسب برای نسخه عملی
| بخش | فناوری پیشنهادی |
|---|---|
| Frontend | React، Next.js یا Vue |
| Backend | FastAPI یا Node.js |
| پایگاه داده | PostgreSQL |
| صف پردازش | Celery، RQ یا BullMQ |
| Cache | Redis |
| ذخیره فایل | Object Storage |
| تبدیل گفتار | Whisper یا faster-whisper |
| مدل خلاصهسازی | مدل متنی از API درواره |
| جستوجوی Transcript | pgvector یا Qdrant |
| نمایش ویدیو | YouTube IFrame Player API |
وضعیتهای پردازش:
queued
fetching_transcript
transcribing
chunking
summarizing
completed
failed
Backend بهتر است بلافاصله یک job_id برگرداند و پردازش طولانی در Worker انجام شود.
ارزیابی کیفیت خلاصه
خلاصه خوب فقط کوتاه نیست؛ باید نکات اصلی را بدون تغییر معنا حفظ کند.
معیارهای ارزیابی:
| معیار | سؤال |
|---|---|
| پوشش | آیا مهمترین موضوعات آمدهاند؟ |
| دقت | آیا نامها، اعداد و نتایج درستاند؟ |
| وفاداری | آیا مطلبی خارج از ویدیو اضافه شده است؟ |
| ساختار | آیا خروجی خوانا و منظم است؟ |
| Timestamp | آیا زمانها به بخش درست اشاره میکنند؟ |
| اختصار | آیا مطالب تکراری حذف شدهاند؟ |
| زبان فارسی | آیا متن طبیعی و روان است؟ |
| کاربرد | آیا خروجی با درخواست کاربر هماهنگ است؟ |
برای ارزیابی، خلاصه تولیدی را با Transcript و قسمتهای اصلی ویدیو مقایسه کنید.
اشتباهات رایج
ارسال Transcript کامل ویدیوی طولانی
ممکن است از ظرفیت ورودی مدل عبور کند یا کیفیت بخشهای انتهایی کاهش پیدا کند.
حذف Timestamp هنگام پاکسازی
بدون زمانبندی، ساخت فصلهای دقیق دشوار میشود.
اعتماد کامل به زیرنویس خودکار
زیرنویس خودکار ممکن است نامها، اعداد و اصطلاحات تخصصی را اشتباه تشخیص دهد.
یکسانگرفتن ترجمه و خلاصه
ترجمه باید محتوای کامل را حفظ کند، اما خلاصه فقط نکات اصلی را نگه میدارد.
استفاده از یک Prompt برای تمام ویدیوها
پادکست، کلاس، جلسه و آموزش برنامهنویسی به ساختار خروجی متفاوت نیاز دارند.
نادیدهگرفتن محتوای تصویری
در بعضی ویدیوها اطلاعات اصلی روی اسلاید یا نمودار نمایش داده میشوند.
پردازش دوباره یک ویدیو
Transcript و خلاصه نهایی را Cache کنید.
ذخیره شناسه مدل در بخشهای مختلف کد
شناسه مدل باید از متغیر محیطی یا تنظیمات مرکزی خوانده شود.
نداشتن مسیر جایگزین
اگر Transcript موجود نبود، برنامه باید امکان دریافت فایل یا پردازش صوت را ارائه دهد.
مسیر توسعه محصول
مرحله اول: خلاصه یک ویدیو
لینک دریافت و خلاصه فارسی تولید شود.
مرحله دوم: چند قالب خروجی
خلاصه کوتاه، کامل، آموزشی و فصلبندی اضافه شود.
مرحله سوم: پردازش پسزمینه
ویدیوهای طولانی در صف قرار گیرند.
مرحله چهارم: تبدیل گفتار به متن
برای فایلهای فاقد زیرنویس از Whisper استفاده شود.
مرحله پنجم: چت با ویدیو
Transcript در پایگاه برداری ذخیره شود.
مرحله ششم: تحلیل اسلایدها
Frameهای مهم و محتوای بصری پردازش شوند.
مرحله هفتم: حساب کاربری و مصرف
تعداد دقیقه، درخواست و هزینه هر کاربر ثبت شود.
مرحله هشتم: مقایسه مدلها
کیفیت و هزینه چند مدل درواره روی مجموعه ثابت ویدیوها ارزیابی شود.
ایدههای کسبوکاری
- خلاصهساز فارسی ویدیوهای آموزشی
- دستیار مطالعه دورههای آنلاین
- تولید مقاله از ویدیو
- تولید خبرنامه از پادکست
- ساخت یادداشت کلاس
- استخراج نکات وبینار
- تولید فصل خودکار ویدیو
- جستوجوی معنایی داخل کانال ویدیویی
- دستیار پاسخگویی از آرشیو ویدیوها
- تولید سؤال و آزمون از ویدیو
- ساخت کلیپ پیشنهادی بر اساس بخشهای مهم
- ترجمه و خلاصه ویدیوهای انگلیسی به فارسی
پرسشهای متداول
چگونه یک ویدیوی یوتیوب را با هوش مصنوعی خلاصه کنیم؟
ابتدا Transcript یا متن گفتار ویدیو را دریافت کنید. سپس متن را به بخشهای کوچک تقسیم کرده و خلاصه هر بخش را با مدل زبانی بسازید. در پایان خلاصههای میانی ترکیب میشوند.
آیا میتوان فقط با لینک YouTube خلاصه گرفت؟
اگر Transcript قابل دسترسی باشد، بله. در غیر این صورت باید فایل صوتی یا ویدیویی مجاز به سیستم داده و گفتار آن به متن تبدیل شود.
آیا خلاصه ویدیو فارسی امکانپذیر است؟
بله. حتی اگر Transcript انگلیسی باشد، میتوان خلاصه نهایی را با یک مدل زبانی مناسب به فارسی تولید کرد.
آیا ویدیو بدون زیرنویس نیز قابل خلاصهسازی است؟
بله. ابتدا باید صدا با Whisper یا یک سرویس Speech-to-Text به متن تبدیل شود.
آیا YouTube Data API زیرنویس همه ویدیوها را دانلود میکند؟
خیر. مسیر رسمی دانلود Caption به احراز هویت و مجوز ویرایش ویدیو نیاز دارد و برای دریافت متن آزاد همه ویدیوهای عمومی طراحی نشده است.
youtube-transcript-api رسمی است؟
خیر. این کتابخانه متنباز از بخشی مستندنشدۀ رابط YouTube استفاده میکند و ممکن است با تغییرات پلتفرم دچار اختلال شود.
چگونه Timestamp دقیق بسازیم؟
زمان شروع هر قطعه Transcript را حفظ و آن را همراه متن به مدل ارسال کنید. مدل نباید زمان جدیدی خارج از داده ورودی بسازد.
آیا میتوان از API درواره برای خلاصهسازی استفاده کرد؟
بله. برنامه میتواند با Base URL زیر و شناسه مدل انتخابشده به درواره متصل شود:
client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)
بهترین مدل برای خلاصه ویدیو چیست؟
مدلی مناسب است که Context کافی، کیفیت فارسی مطلوب، پیروی دقیق از دستور و هزینه متناسب داشته باشد. انتخاب نهایی باید با آزمایش روی Transcriptهای واقعی انجام شود.
آیا امکان چت با ویدیو وجود دارد؟
بله. Transcript زمانبندیشده را به Chunk تبدیل و داخل پایگاه برداری ذخیره کنید. سپس هر سؤال با بخشهای مرتبط پاسخ داده میشود.
جمعبندی
خلاصه ویدیو یوتیوب با هوش مصنوعی از چند مرحله تشکیل میشود:
- استخراج شناسه ویدیو
- دریافت Transcript یا تبدیل صوت به متن
- حفظ Timestampها
- پاکسازی زیرنویس
- تقسیم متن به بخشهای کوچک
- خلاصهسازی هر بخش
- ترکیب خلاصههای میانی
- ساخت خلاصه نهایی فارسی
- تولید فصلبندی و نکات کلیدی
- ذخیره نتیجه برای جلوگیری از پردازش تکراری
در نمونه این مقاله، Transcript با Python دریافت و برای خلاصهسازی به یک مدل متنی از طریق API درواره ارسال شد. شناسه مدل از تنظیمات برنامه خوانده میشود؛ بنابراین میتوان چند مدل را از نظر کیفیت، سرعت و هزینه مقایسه کرد.
برای دریافت کلید API و مشاهده مدلهای فعلی، به مستندات API درواره مراجعه کنید.
مقالات مرتبط
- تبدیل ویدیو به متن با هوش مصنوعی
- ساخت زیرنویس فارسی خودکار با هوش مصنوعی
- ساخت پادکست با هوش مصنوعی
- خلاصهکردن متن و PDF با هوش مصنوعی
- ساخت چت با PDF فارسی
- آموزش استفاده از API هوش مصنوعی در اپلیکیشنها
- محاسبه هزینه API هوش مصنوعی
- API سازگار با OpenAI چیست؟
منابع
- YouTube Data API: Captions list
- YouTube Data API: Captions download
- YouTube Transcript API
- OpenAI Whisper
- faster-whisper
- yt-dlp
- FFmpeg Documentation
- FastAPI Documentation
- OpenAI Python Library
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



