
چت با PDF با هوش مصنوعی؛ آموزش ساخت ChatPDF فارسی با API درواره
در این آموزش یاد میگیرید چگونه با Python، FastAPI، FAISS و API درواره یک سامانه ChatPDF فارسی بسازید. برنامه فایل PDF را دریافت میکند، بخشهای مرتبط را پیدا میکند و پاسخ مستند همراه با شماره صفحه ارائه میدهد.

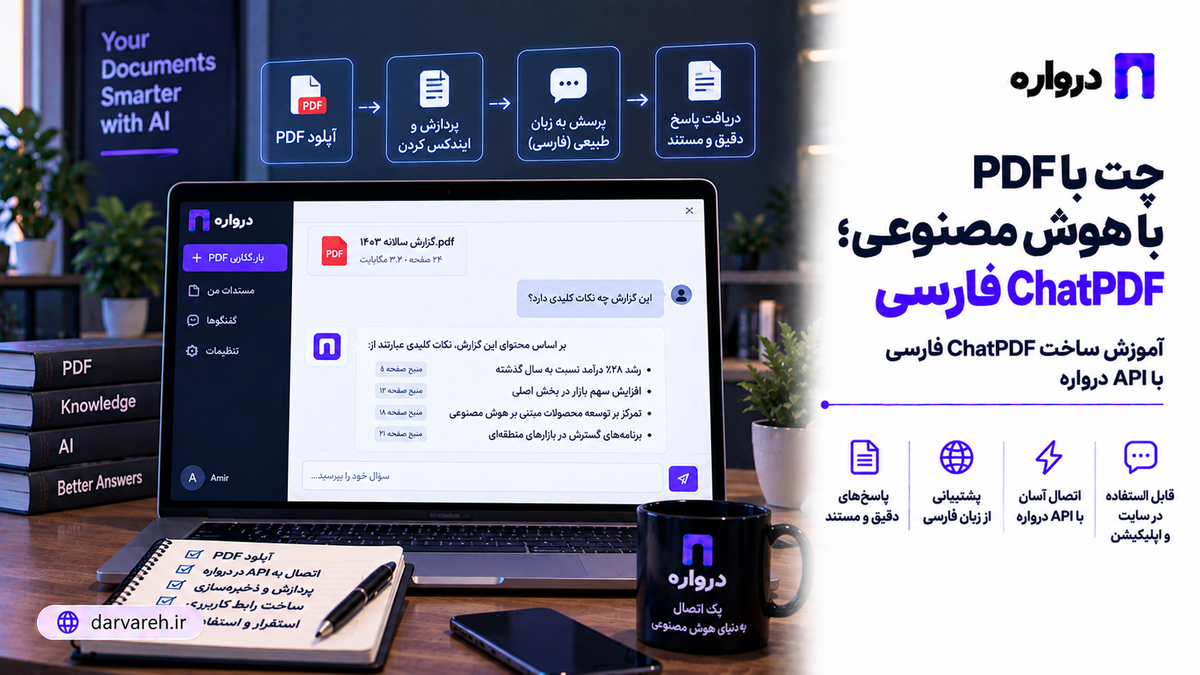
چت با PDF یکی از پرکاربردترین قابلیتهای هوش مصنوعی برای دانشجویان، پژوهشگران، شرکتها و توسعهدهندگان است. کاربر یک فایل PDF بارگذاری میکند و سپس میتواند درباره محتوای آن سؤال بپرسد، بخشهای مهم را پیدا کند یا خلاصهای مستند دریافت کند.
برای مثال، کاربر میتواند یک گزارش ۲۰۰ صفحهای را بارگذاری کند و بپرسد:
- مهمترین نتیجه این گزارش چیست؟
- نویسنده چه پیشنهادهایی ارائه کرده است؟
- تعریف یک اصطلاح در کدام صفحه قرار دارد؟
- تفاوت دو روش مطرحشده در سند چیست؟
- تمام اعداد مربوط به فروش را استخراج کن.
- فصل سوم را به زبان ساده توضیح بده.
- پاسخ را همراه با شماره صفحه ارائه کن.
در این مقاله یک سامانه واقعی پرسش از PDF با هوش مصنوعی میسازیم که متن سند را استخراج، بخشبندی و نمایهسازی میکند و برای تولید پاسخ از مدلهای موجود در API درواره کمک میگیرد.
چت با PDF چیست؟
چت با PDF یا AI PDF Chat قابلیتی است که به کاربر اجازه میدهد بهجای خواندن خطبهخط یک سند طولانی، سؤال خود را به زبان طبیعی مطرح کند.
سامانه ابتدا قسمتهای مرتبط سند را پیدا میکند و سپس همان قسمتها را همراه با سؤال کاربر به مدل زبانی میدهد. مدل باید پاسخ را بر اساس محتوای بازیابیشده تولید کند.
این فرایند معمولاً با معماری RAG پیادهسازی میشود.
RAG مخفف Retrieval-Augmented Generation به معنای «تولید تقویتشده با بازیابی» است. در این معماری، مدل قبل از پاسخدادن به یک منبع اطلاعاتی خارجی مانند PDF، پایگاه دانش یا اسناد شرکت متصل میشود.
تفاوت خلاصهسازی PDF با چت PDF
خلاصهسازی و چت با PDF به یکدیگر مرتبطاند، اما یک قابلیت محسوب نمیشوند.
| قابلیت | نحوه کار |
|---|---|
| خلاصهسازی PDF | کل سند یا بخشی از آن به یک خلاصه تبدیل میشود |
| چت با PDF | کاربر چند سؤال متفاوت درباره سند میپرسد |
| جستوجوی PDF | بخشهای مرتبط با یک عبارت پیدا میشوند |
| استخراج اطلاعات | فیلدهایی مانند نام، تاریخ و مبلغ استخراج میشوند |
| مقایسه اسناد | اطلاعات دو یا چند سند کنار هم قرار میگیرند |
در یک سامانه چت PDF، لازم نیست تمام سند برای هر سؤال دوباره به مدل ارسال شود. فقط قسمتهایی که احتمالاً پاسخ در آنها قرار دارد بازیابی میشوند.
این روش برای فایلهای طولانی سریعتر و اقتصادیتر است.
ChatPDF فارسی چه کاربردهایی دارد؟
پژوهش و دانشگاه
دانشجو یا پژوهشگر میتواند مقالهها، کتابها و گزارشهای علمی را بارگذاری کرده و درباره روش تحقیق، نتایج، فرضیهها و منابع سؤال بپرسد.
شرکتها و سازمانها
سامانه میتواند روی آییننامهها، دستورالعملها، گزارشهای داخلی، کاتالوگها و مستندات محصول کار کند.
فروش و پشتیبانی
کارشناسان میتوانند کاتالوگ یا دفترچه راهنمای محصولات را به سامانه بدهند و پاسخ اولیه سؤالات مشتری را دریافت کنند.
آموزش
دانشآموز یا مدرس میتواند از کتاب و جزوه سؤال بپرسد، خلاصه فصل دریافت کند یا تمرین و پرسش آموزشی بسازد.
قراردادها و اسناد اداری
میتوان بندها، تاریخها، طرفهای سند و موضوعات مشخص را استخراج کرد. البته نتیجه مدل باید با متن اصلی سند تطبیق داده شود.
مستندات فنی
توسعهدهنده میتواند راهنماهای فنی، مستندات API یا دفترچه محصول را به یک دستیار قابل جستوجو تبدیل کند.
معماری سامانه پرسش از PDF
جریان اصلی برنامه به این صورت است:
آپلود PDF
↓
استخراج متن هر صفحه
↓
پاکسازی و بخشبندی متن
↓
ساخت Embedding برای هر بخش
↓
ذخیره در پایگاه برداری
↓
دریافت سؤال کاربر
↓
ساخت Embedding سؤال
↓
پیداکردن بخشهای مرتبط
↓
ارسال سؤال و متن مرتبط به API درواره
↓
تولید پاسخ همراه با شماره صفحه
مدل زبانی مستقیماً داخل فایل جستوجو نمیکند. برنامه باید ابتدا متن مرتبط را پیدا کرده و در Context درخواست قرار دهد.
اجزای اصلی یک سامانه ChatPDF
| جزء | وظیفه |
|---|---|
| PDF Parser | استخراج متن و شماره صفحه |
| OCR | خواندن PDFهای اسکنشده |
| Text Splitter | تقسیم متن به بخشهای کوچک |
| Embedding Model | تبدیل متن به بردار |
| Vector Database | ذخیره و جستوجوی بردارها |
| Retriever | انتخاب بخشهای مرتبط |
| Language Model | تولید پاسخ نهایی |
| API Backend | مدیریت فایل و درخواستهای کاربران |
| User Interface | آپلود سند و نمایش گفتگو |
ابزارهای متنباز برای ساخت چت با PDF
PyMuPDF
PyMuPDF کتابخانهای سریع برای استخراج متن، تصویر و اطلاعات ساختاری از PDF است. در این آموزش از آن برای خواندن متن هر صفحه استفاده میکنیم.
این کتابخانه از page.get_text() برای استخراج متن استفاده میکند و برای صفحات تصویری نیز امکان اتصال به OCR را دارد. مستندات رسمی PyMuPDF
pypdf
کتابخانه pypdf گزینه سبک دیگری برای خواندن، ترکیب، جداسازی و پردازش فایلهای PDF است. برای PDFهایی با متن دیجیتال و ساختار ساده مناسب است.
pdfplumber
اگر استخراج جدول یا کنترل دقیقتر روی موقعیت کلمات اهمیت داشته باشد، pdfplumber میتواند انتخاب مناسبی باشد.
Docling
Docling برای تبدیل اسناد پیچیده به خروجی ساختاریافته طراحی شده است و میتواند در پردازش جدولها، عنوانها و ساختار صفحه مفید باشد.
Marker
Marker یک ابزار متنباز برای تبدیل PDF به Markdown است. برای اسنادی که حفظ ساختار تیترها، فرمولها و بخشبندی آنها اهمیت دارد، قابل بررسی است.
Tesseract و OCRmyPDF
اگر PDF از تصاویر اسکنشده ساخته شده باشد، استخراج متن معمولی نتیجه مطلوبی نمیدهد. در این حالت میتوان از Tesseract یا OCRmyPDF استفاده کرد.
PaddleOCR
PaddleOCR یک مجموعه متنباز OCR است که برای تشخیص متن و ساختار بعضی اسناد پیچیده استفاده میشود.
Sentence Transformers
Sentence Transformers متن را به بردارهای عددی تبدیل میکند. این بردارها امکان جستوجوی معنایی را فراهم میکنند؛ یعنی عبارتهای مرتبط حتی بدون تطابق کامل کلمات پیدا میشوند. راهنمای رسمی جستوجوی معنایی Sentence Transformers
FAISS
FAISS کتابخانهای متنباز برای جستوجوی سریع میان بردارهای متراکم است. این ابزار با C++ توسعه یافته و رابط Python نیز دارد. مخزن رسمی FAISS
Qdrant
Qdrant یک پایگاه داده برداری متنباز است که فیلتر متادیتا، ذخیره پایدار و جستوجوی برداری را ارائه میدهد. برای نسخههای چندکاربره و بزرگتر میتوان FAISS حافظهای را با Qdrant جایگزین کرد.
pgvector
اگر برنامه از PostgreSQL استفاده میکند، افزونه pgvector امکان ذخیره و جستوجوی Embeddingها را داخل همان پایگاه داده فراهم میکند.
LangChain و LlamaIndex
LangChain و LlamaIndex ابزارهایی برای ساخت جریانهای RAG، اتصال به پایگاه برداری و مدیریت اسناد ارائه میکنند. استفاده از آنها اجباری نیست؛ همانطور که در نمونه این مقاله، اجزای اصلی را مستقیماً پیادهسازی میکنیم.
FastAPI
FastAPI برای ساخت APIهای Python استفاده میشود. در این پروژه دو مسیر برای آپلود PDF و پرسیدن سؤال میسازیم. مستندات رسمی FastAPI بخشهای مستقلی برای دریافت فایل و ساخت API دارد. راهنمای FastAPI
نرمافزارهای متنباز آماده برای چت با اسناد
اگر نمیخواهید همه اجزا را از ابتدا بسازید، این پروژهها نیز قابل بررسیاند:
| ابزار | کاربرد |
|---|---|
| Open WebUI | رابط گفتگو با مدلها و فایلها |
| AnythingLLM | ساخت فضای کاری و گفتگو با اسناد |
| PrivateGPT | پرسش از اسناد با مدلهای محلی |
| DocsGPT | دستیار مبتنی بر مستندات |
| Quivr | ساخت پایگاه دانش و دستیار RAG |
| RAGFlow | پردازش اسناد و ساخت جریان RAG |
| Dify | ساخت اپلیکیشن و گردش کار هوش مصنوعی |
| Flowise | طراحی بصری جریانهای مبتنی بر LangChain |
| Langflow | ساخت تصویری برنامههای RAG و Agent |
در بسیاری از این ابزارها میتوان یک سرویس سازگار با OpenAI را از طریق Base URL و API Key سفارشی متصل کرد. جزئیات اتصال به نسخه و تنظیمات هر پروژه بستگی دارد.
ساخت ChatPDF فارسی با Python و API درواره
در نمونه عملی از فناوریهای زیر استفاده میکنیم:
- FastAPI برای Backend
- PyMuPDF برای استخراج متن
- Sentence Transformers برای Embedding
- مدل
multilingual-e5-baseبرای جستوجوی چندزبانه - FAISS برای جستوجوی برداری
- OpenAI Python SDK برای اتصال سازگار به درواره
- مدل متنی انتخابشده در درواره برای پاسخ نهایی
مدل multilingual-e5-base برای متنهای چندزبانه طراحی شده و در کارت رسمی آن، استفاده از پیشوندهای query: و passage: برای جستوجوی نامتقارن توضیح داده شده است. کارت مدل multilingual-e5-base
ساخت پوشه پروژه
ساختار پروژه:
persian-chatpdf/
├── app.py
├── requirements.txt
├── .env
└── static/
    └── index.html
نصب کتابخانهها
محتوای requirements.txt:
fastapi
uvicorn[standard]
python-multipart
pymupdf
sentence-transformers
faiss-cpu
openai
numpy
python-dotenv
سپس اجرا کنید:
python -m venv .venv
در Linux یا macOS:
source .venv/bin/activate
در Windows:
.venv\Scripts\activate
نصب وابستگیها:
pip install -r requirements.txt
تنظیم متغیرهای محیطی
محتوای فایل .env:
DARVAREH_API_KEY=YOUR_API_KEY
DARVAREH_MODEL=YOUR_MODEL_ID
DARVAREH_BASE_URL=https://api.darvareh.ir/v1
EMBEDDING_MODEL=intfloat/multilingual-e5-base
شناسه مدل متنی را از فهرست فعلی مدلهای درواره انتخاب کنید.
کلید API باید فقط در Backend قرار داشته باشد و نباید داخل JavaScript مرورگر نوشته شود.
کد کامل Backend
فایل app.py را ایجاد کنید:
import os
import re
import uuid
from typing import Any
import faiss
import fitz
import numpy as np
from dotenv import load_dotenv
from fastapi import FastAPI, File, HTTPException, UploadFile
from fastapi.responses import FileResponse
from openai import OpenAI
from pydantic import BaseModel, Field
from sentence_transformers import SentenceTransformer
load_dotenv()
DARVAREH_API_KEY = os.environ["DARVAREH_API_KEY"]
DARVAREH_MODEL = os.environ["DARVAREH_MODEL"]
DARVAREH_BASE_URL = os.getenv(
"DARVAREH_BASE_URL",
"https://api.darvareh.ir/v1",
)
EMBEDDING_MODEL_ID = os.getenv(
"EMBEDDING_MODEL",
"intfloat/multilingual-e5-base",
)
MAX_FILE_SIZE = 20 * 1024 * 1024
CHUNK_SIZE = 900
CHUNK_OVERLAP = 150
DEFAULT_TOP_K = 5
app = FastAPI(
title="Persian ChatPDF",
version="1.0.0",
)
ai_client = OpenAI(
api_key=DARVAREH_API_KEY,
base_url=DARVAREH_BASE_URL,
)
embedding_model = SentenceTransformer(EMBEDDING_MODEL_ID)
# این حافظه فقط برای نسخه آموزشی است.
documents: dict[str, dict[str, Any]] = {}
class AskRequest(BaseModel):
document_id: str
question: str = Field(min_length=2, max_length=2000)
top_k: int = Field(default=DEFAULT_TOP_K, ge=1, le=10)
class SourceItem(BaseModel):
page: int
score: float
preview: str
class AskResponse(BaseModel):
answer: str
sources: list[SourceItem]
def normalize_text(text: str) -> str:
"""پاکسازی فاصلهها و نویسههای غیرضروری."""
text = text.replace("\u200f", " ")
text = text.replace("\u202a", " ")
text = text.replace("\u202b", " ")
text = re.sub(r"[ \t]+", " ", text)
text = re.sub(r"\n{3,}", "\n\n", text)
return text.strip()
def extract_pdf_pages(pdf_bytes: bytes) -> list[dict[str, Any]]:
"""استخراج متن PDF همراه با شماره صفحه."""
try:
document = fitz.open(
stream=pdf_bytes,
filetype="pdf",
)
except Exception as error:
raise ValueError("فایل PDF قابل خواندن نیست.") from error
pages = []
for page_index, page in enumerate(document):
text = normalize_text(page.get_text("text"))
if text:
pages.append(
{
"page": page_index + 1,
"text": text,
}
)
document.close()
if not pages:
raise ValueError(
"متنی از فایل استخراج نشد. "
"احتمالاً PDF اسکنشده است و به OCR نیاز دارد."
)
return pages
def split_pages_into_chunks(
pages: list[dict[str, Any]],
) -> list[dict[str, Any]]:
"""تقسیم متن صفحات با حفظ شماره صفحه."""
chunks = []
for page_item in pages:
text = page_item["text"]
page_number = page_item["page"]
start = 0
while start < len(text):
end = min(start + CHUNK_SIZE, len(text))
chunk_text = text[start:end].strip()
if chunk_text:
chunks.append(
{
"page": page_number,
"text": chunk_text,
}
)
if end >= len(text):
break
start = max(end - CHUNK_OVERLAP, start + 1)
return chunks
def build_vector_index(
chunks: list[dict[str, Any]],
) -> faiss.IndexFlatIP:
"""ساخت نمایه FAISS از بخشهای سند."""
passages = [
f"passage: {chunk['text']}"
for chunk in chunks
]
embeddings = embedding_model.encode(
passages,
normalize_embeddings=True,
convert_to_numpy=True,
show_progress_bar=False,
).astype("float32")
index = faiss.IndexFlatIP(embeddings.shape[1])
index.add(embeddings)
return index
def retrieve_chunks(
document_data: dict[str, Any],
question: str,
top_k: int,
) -> list[dict[str, Any]]:
"""پیداکردن مرتبطترین قسمتهای PDF."""
query_embedding = embedding_model.encode(
[f"query: {question}"],
normalize_embeddings=True,
convert_to_numpy=True,
show_progress_bar=False,
).astype("float32")
available_count = len(document_data["chunks"])
result_count = min(top_k, available_count)
scores, indices = document_data["index"].search(
query_embedding,
result_count,
)
results = []
for score, chunk_index in zip(scores[0], indices[0]):
if chunk_index < 0:
continue
chunk = document_data["chunks"][int(chunk_index)]
results.append(
{
"page": chunk["page"],
"text": chunk["text"],
"score": float(score),
}
)
return results
def build_context(
retrieved_chunks: list[dict[str, Any]],
) -> str:
"""ساخت Context همراه با شماره صفحات."""
context_parts = []
for item in retrieved_chunks:
context_parts.append(
f"[صفحه {item['page']}]\n{item['text']}"
)
return "\n\n---\n\n".join(context_parts)
def generate_answer(
question: str,
context: str,
) -> str:
"""تولید پاسخ مستند با مدل درواره."""
completion = ai_client.chat.completions.create(
model=DARVAREH_MODEL,
messages=[
{
"role": "system",
"content": (
"شما یک دستیار تحلیل اسناد فارسی هستید. "
"فقط بر اساس متن سند پاسخ بدهید. "
"اگر پاسخ در متن ارائهشده وجود ندارد، "
"شفاف بگویید که اطلاعات کافی پیدا نشد. "
"برای ادعاهای اصلی، شماره صفحه را به شکل "
"[صفحه ۳] ذکر کنید. "
"پاسخ را روان، دقیق و مختصر بنویسید."
),
},
{
"role": "user",
"content": (
f"متن بازیابیشده از سند:\n\n{context}\n\n"
f"سؤال کاربر:\n{question}"
),
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("مدل پاسخ متنی معتبری برنگرداند.")
return content.strip()
@app.get("/")
def home():
return FileResponse("static/index.html")
@app.post("/api/documents")
async def upload_document(
file: UploadFile = File(...),
):
filename = file.filename or "document.pdf"
if not filename.lower().endswith(".pdf"):
raise HTTPException(
status_code=400,
detail="فقط فایل PDF قابل قبول است.",
)
pdf_bytes = await file.read()
if not pdf_bytes:
raise HTTPException(
status_code=400,
detail="فایل خالی است.",
)
if len(pdf_bytes) > MAX_FILE_SIZE:
raise HTTPException(
status_code=413,
detail="حجم فایل بیشتر از حد مجاز است.",
)
if not pdf_bytes.startswith(b"%PDF"):
raise HTTPException(
status_code=400,
detail="ساختار فایل PDF معتبر نیست.",
)
try:
pages = extract_pdf_pages(pdf_bytes)
chunks = split_pages_into_chunks(pages)
index = build_vector_index(chunks)
except ValueError as error:
raise HTTPException(
status_code=422,
detail=str(error),
) from error
document_id = str(uuid.uuid4())
documents[document_id] = {
"filename": filename,
"pages_count": len(pages),
"chunks": chunks,
"index": index,
}
return {
"document_id": document_id,
"filename": filename,
"pages_count": len(pages),
"chunks_count": len(chunks),
}
@app.post(
"/api/ask",
response_model=AskResponse,
)
def ask_document(request: AskRequest):
document_data = documents.get(request.document_id)
if not document_data:
raise HTTPException(
status_code=404,
detail="سند موردنظر پیدا نشد.",
)
retrieved_chunks = retrieve_chunks(
document_data=document_data,
question=request.question,
top_k=request.top_k,
)
if not retrieved_chunks:
raise HTTPException(
status_code=422,
detail="بخش مرتبطی در سند پیدا نشد.",
)
context = build_context(retrieved_chunks)
try:
answer = generate_answer(
question=request.question,
context=context,
)
except Exception as error:
raise HTTPException(
status_code=502,
detail=f"خطا در دریافت پاسخ مدل: {error}",
) from error
sources = [
SourceItem(
page=item["page"],
score=round(item["score"], 4),
preview=item["text"][:180],
)
for item in retrieved_chunks
]
return AskResponse(
answer=answer,
sources=sources,
)
ساخت رابط کاربری ساده
فایل static/index.html:
<!doctype html>
<html lang="fa" dir="rtl">
<head>
<meta charset="UTF-8">
<meta
name="viewport"
content="width=device-width, initial-scale=1"
>
<title>چت با PDF فارسی</title>
<style>
body {
max-width: 820px;
margin: 40px auto;
padding: 0 20px;
font-family: sans-serif;
line-height: 1.9;
background: #f7f8fc;
color: #172033;
}
.card {
margin-bottom: 20px;
padding: 24px;
border-radius: 16px;
background: white;
box-shadow: 0 8px 30px rgba(20, 30, 60, 0.08);
}
input,
textarea,
button {
box-sizing: border-box;
width: 100%;
margin-top: 12px;
padding: 12px;
font: inherit;
}
textarea {
min-height: 120px;
resize: vertical;
}
button {
border: 0;
border-radius: 10px;
background: #6246ea;
color: white;
cursor: pointer;
}
button:disabled {
cursor: wait;
opacity: 0.6;
}
#answer {
white-space: pre-wrap;
}
.source {
margin-top: 10px;
padding: 10px;
border-right: 3px solid #6246ea;
background: #f4f1ff;
}
</style>
</head>
<body>
<h1>چت با PDF فارسی</h1>
<section class="card">
<h2>۱. بارگذاری فایل</h2>
<input
id="pdf-file"
type="file"
accept="application/pdf"
>
<button id="upload-button">
بارگذاری و پردازش PDF
</button>
<p id="upload-status"></p>
</section>
<section class="card">
<h2>۲. پرسش از سند</h2>
<textarea
id="question"
placeholder="سؤال خود را درباره فایل بنویسید..."
></textarea>
<button id="ask-button" disabled>
ارسال سؤال
</button>
</section>
<section class="card">
<h2>پاسخ</h2>
<div id="answer">هنوز سؤالی ارسال نشده است.</div>
<div id="sources"></div>
</section>
<script>
let documentId = null;
const fileInput = document.getElementById("pdf-file");
const uploadButton =
document.getElementById("upload-button");
const uploadStatus =
document.getElementById("upload-status");
const questionInput =
document.getElementById("question");
const askButton =
document.getElementById("ask-button");
const answerBox =
document.getElementById("answer");
const sourcesBox =
document.getElementById("sources");
uploadButton.addEventListener("click", async () => {
const file = fileInput.files[0];
if (!file) {
uploadStatus.textContent =
"ابتدا یک فایل PDF انتخاب کنید.";
return;
}
const formData = new FormData();
formData.append("file", file);
uploadButton.disabled = true;
askButton.disabled = true;
uploadStatus.textContent =
"در حال استخراج و نمایهسازی متن...";
try {
const response = await fetch(
"/api/documents",
{
method: "POST",
body: formData,
}
);
const data = await response.json();
if (!response.ok) {
throw new Error(
data.detail || "پردازش فایل ناموفق بود."
);
}
documentId = data.document_id;
askButton.disabled = false;
uploadStatus.textContent =
`${data.pages_count} صفحه و ` +
`${data.chunks_count} بخش پردازش شد.`;
} catch (error) {
uploadStatus.textContent = error.message;
} finally {
uploadButton.disabled = false;
}
});
askButton.addEventListener("click", async () => {
const question = questionInput.value.trim();
if (!documentId || !question) {
return;
}
askButton.disabled = true;
answerBox.textContent = "در حال دریافت پاسخ...";
sourcesBox.innerHTML = "";
try {
const response = await fetch("/api/ask", {
method: "POST",
headers: {
"Content-Type": "application/json",
},
body: JSON.stringify({
document_id: documentId,
question: question,
top_k: 5,
}),
});
const data = await response.json();
if (!response.ok) {
throw new Error(
data.detail || "دریافت پاسخ ناموفق بود."
);
}
answerBox.textContent = data.answer;
data.sources.forEach((source) => {
const item = document.createElement("div");
item.className = "source";
item.textContent =
`صفحه ${source.page}: ` +
source.preview;
sourcesBox.appendChild(item);
});
} catch (error) {
answerBox.textContent = error.message;
} finally {
askButton.disabled = false;
}
});
</script>
</body>
</html>
اجرای برنامه
دستور زیر را اجرا کنید:
uvicorn app:app --reload
سپس آدرس زیر را باز کنید:
http://127.0.0.1:8000
یک فایل PDF متنی بارگذاری کرده و سؤالی درباره محتوای آن بپرسید.
مستندات خودکار API نیز در آدرس زیر در دسترس است:
http://127.0.0.1:8000/docs
API برنامه چگونه کار میکند؟
مسیر بارگذاری سند
POST /api/documents
ورودی:
multipart/form-data
file: document.pdf
خروجی نمونه:
{
  "document_id": "fa45af2f-8f32-4a60-9cb1-9ec87eae3307",
  "filename": "report.pdf",
  "pages_count": 42,
  "chunks_count": 118
}
مسیر پرسش از سند
POST /api/ask
ورودی:
{
"document_id": "fa45af2f-8f32-4a60-9cb1-9ec87eae3307",
"question": "مهمترین نتیجه گزارش چیست؟",
"top_k": 5
}
خروجی:
{
"answer": "بر اساس گزارش، مهمترین نتیجه ... [صفحه ۱۸]",
"sources": [
{
"page": 18,
"score": 0.8421,
"preview": "نتایج بررسی نشان میدهد که..."
}
]
}
بخشبندی یا Chunking چرا مهم است؟
اگر هر صفحه یا کل سند بهصورت یک متن بزرگ ذخیره شود، جستوجوی معنایی دقت کافی نخواهد داشت.
Chunk باید بهاندازهای کوچک باشد که یک موضوع نسبتاً مشخص را پوشش دهد و بهاندازهای بزرگ باشد که مفهوم جملهها از بین نرود.
در نمونه مقاله از تنظیمات زیر استفاده کردیم:
CHUNK_SIZE = 900
CHUNK_OVERLAP = 150
همپوشانی باعث میشود جملهای که در مرز دو Chunk قرار گرفته است بهطور کامل از دست نرود.
اعداد مناسب به نوع سند بستگی دارند:
| نوع سند | اندازه اولیه پیشنهادی |
|---|---|
| مقاله و متن عمومی | ۷۰۰ تا ۱۲۰۰ نویسه |
| قرارداد | بند یا زیرعنوان |
| کتاب آموزشی | پاراگراف یا بخش موضوعی |
| مستندات فنی | عنوان و محتوای زیر آن |
| جدول و گزارش مالی | سطرها و عنوان جدول |
| پرسشهای متداول | هر سؤال و پاسخ |
تقسیم متن صرفاً بر اساس تعداد کاراکتر ساده است، اما برای نسخه حرفهای بهتر است ساختار عنوان، پاراگراف، جدول و فصل نیز در نظر گرفته شود.
PDF اسکنشده را چگونه پردازش کنیم؟
بعضی فایلها فقط شامل تصویر صفحات هستند. در این حالت get_text() متن قابل استفادهای برنمیگرداند.
جریان مناسب برای PDF اسکنشده:
تشخیص نبود متن
↓
تبدیل صفحه به تصویر
↓
اجرای OCR
↓
پاکسازی متن
↓
ثبت شماره صفحه
↓
ساخت Embedding
PyMuPDF امکان استفاده از OCR روی صفحه را نیز ارائه میکند:
text_page = page.get_textpage_ocr()
text = page.get_text(textpage=text_page)
برای اجرای این قابلیت باید موتور OCR موردنیاز روی سرور نصب شده باشد. کیفیت OCR فارسی نیز باید با اسناد واقعی آزمایش شود.
برای فرمها، فاکتورها و اسناد دارای جدول، OCR ساده ممکن است ترتیب ستونها را بهدرستی حفظ نکند. در این شرایط ابزارهایی مانند Docling، PaddleOCR یا مدلهای تحلیل سند قابل بررسیاند.
چگونه شماره صفحه را در پاسخ حفظ کنیم؟
هنگام استخراج متن باید شماره صفحه در متادیتای هر Chunk ذخیره شود:
{
"page": 12,
"text": "متن استخراجشده از صفحه دوازدهم"
}
پس از بازیابی، متن به شکل زیر به مدل داده میشود:
[صفحه ۱۲]
متن مرتبط...

[صفحه ۲۷]
متن مرتبط...
پرامپت نیز باید از مدل بخواهد شماره صفحه را در پاسخ ذکر کند. این کار بررسی جواب را برای کاربر سادهتر میکند.
شماره صفحهای که کتاب روی صفحه چاپ کرده است ممکن است با شماره فیزیکی PDF متفاوت باشد. اگر این تفاوت اهمیت دارد، باید شماره چاپی صفحه نیز از سند استخراج و در متادیتا ذخیره شود.
چگونه دقت پاسخ را افزایش دهیم؟
تعداد نتایج بازیابی را تنظیم کنید
اگر top_k بسیار کم باشد، ممکن است بخش مهمی از پاسخ حذف شود. اگر بسیار زیاد باشد، متن نامرتبط وارد Context خواهد شد.
مقدار ۴ تا ۸ برای شروع مناسب است، اما باید با داده واقعی ارزیابی شود.
از Reranker استفاده کنید
ابتدا جستوجوی برداری ۱۵ یا ۲۰ نتیجه پیدا میکند. سپس یک مدل Reranker این نتایج را دوباره مرتب کرده و بهترین ۵ بخش را انتخاب میکند.
Sentence Transformers از Cross-Encoder برای امتیازدهی دقیقتر به جفت سؤال و متن پشتیبانی میکند. Cross-Encoder معمولاً دقیقتر اما کندتر از محاسبه مستقیم Embedding است. مستندات Cross-Encoder
جستوجوی ترکیبی بسازید
جستوجوی برداری برای تشابه معنایی مناسب است، اما شمارهها، کد محصولات و عبارتهای دقیق ممکن است با جستوجوی کلیدواژهای بهتر پیدا شوند.
در Hybrid Search نتایج دو روش ترکیب میشوند:
- جستوجوی برداری
- جستوجوی کلیدواژهای مانند BM25
ساختار سند را حفظ کنید
نام فصل، عنوان بخش، شماره صفحه و نوع محتوا را همراه هر Chunk ذخیره کنید.
پاسخ را محدود به سند کنید
در System Prompt صریحاً بنویسید:
اگر پاسخ در متن بازیابیشده وجود ندارد،
بگو اطلاعات کافی در سند پیدا نشد.
منابع را به کاربر نشان دهید
علاوه بر پاسخ مدل، متن کوتاهی از Chunkهای بازیابیشده را نمایش دهید تا کاربر بتواند نتیجه را بررسی کند.
انتخاب مدل مناسب از درواره
برای چت با PDF، مدل باید تواناییهای زیر را داشته باشد:
- درک مناسب زبان فارسی
- پیروی دقیق از Context
- پاسخگویی بدون افزودن اطلاعات غیرضروری
- توانایی ترکیب چند قسمت سند
- تولید ارجاع به شماره صفحه
- پشتیبانی از Context کافی
- سرعت متناسب با تجربه تعاملی
- هزینه قابل مدیریت
همیشه قویترین مدل برای تمام سؤالها ضروری نیست. سؤالهای ساده و استخراجی ممکن است با یک مدل سریعتر و اقتصادیتر پاسخ داده شوند؛ درحالیکه مقایسه چند فصل یا تحلیل پیچیده به مدل توانمندتری نیاز دارد.
شناسه مدل را در متغیر محیطی نگه دارید:
DARVAREH_MODEL=YOUR_MODEL_ID
به این ترتیب تغییر مدل به بازنویسی برنامه نیاز ندارد.
محاسبه هزینه چت با PDF
در این معماری دو نوع پردازش انجام میشود:
- ساخت Embedding برای بخشهای PDF
- تولید پاسخ با مدل زبانی
در نمونه مقاله، Embedding بهصورت محلی ساخته میشود؛ بنابراین هزینه API در مرحله پرسش و تولید پاسخ ایجاد خواهد شد.
هزینه هر سؤال تقریباً به این عوامل بستگی دارد:
- طول سؤال
- تعداد Chunkهای بازیابیشده
- اندازه هر Chunk
- طول تاریخچه گفتگو
- طول پاسخ
- قیمت مدل انتخابی
برای کاهش هزینه:
- تمام PDF را در هر سؤال ارسال نکنید.
- فقط قسمتهای مرتبط را وارد Context کنید.
- تعداد پیامهای تاریخچه را محدود کنید.
- برای سؤالهای تکراری کش تعریف کنید.
- از مدل متناسب با پیچیدگی سؤال استفاده کنید.
- پاسخ را در اندازه موردنیاز نگه دارید.
- Embedding سند را فقط هنگام تغییر فایل دوباره بسازید.
برای جزئیات بیشتر، مقاله محاسبه هزینه API هوش مصنوعی را مطالعه کنید.
ذخیره اطلاعات در نسخه عملی
در کد آموزشی، اطلاعات سند داخل حافظه Python ذخیره میشود. با توقف برنامه تمام اطلاعات از بین میروند و این روش برای محیط عملی مناسب نیست.
معماری پیشنهادی نسخه واقعی:
| داده | محل ذخیره پیشنهادی |
|---|---|
| فایل اصلی PDF | فضای ذخیرهسازی شیء |
| اطلاعات سند | PostgreSQL |
| Chunkها | PostgreSQL یا پایگاه سند |
| Embeddingها | Qdrant، pgvector یا پایگاه برداری |
| وضعیت پردازش | پایگاه داده |
| وظایف طولانی | Redis و صف پردازش |
| گزارش مصرف | جدول Usage |
| نتیجه سؤالهای پرتکرار | Cache |
برای هر سند باید موارد زیر ثبت شوند:
document_id
user_id
filename
status
pages_count
chunks_count
created_at
embedding_model
chunking_version
ثبت مدل Embedding و نسخه Chunking اهمیت دارد؛ زیرا تغییر هرکدام ممکن است به نمایهسازی مجدد سند نیاز داشته باشد.
پردازش PDF در پسزمینه
پردازش یک فایل بزرگ ممکن است چند دقیقه طول بکشد. در نسخه عملی بهتر است API آپلود، فایل را دریافت کرده و یک Job ایجاد کند.
وضعیتهای پیشنهادی:
uploaded
extracting
chunking
embedding
ready
failed
کاربر پس از آپلود یک document_id دریافت میکند و رابط کاربری وضعیت پردازش را بررسی میکند.
ابزارهای مناسب صف:
- Celery
- Dramatiq
- RQ
- Arq
- Redis Queue
- سرویسهای مدیریتشده صف
پشتیبانی از چند PDF
برای گفتوگو با چند فایل باید document_id یا collection_id در متادیتای بردارها ذخیره شود.
درخواست کاربر میتواند شامل چند سند باشد:
{
  "document_ids": [
    "document-1",
    "document-2"
  ],
  "question": "تفاوت نتیجه این دو گزارش چیست؟"
}
Retriever فقط میان Chunkهای همین اسناد جستوجو میکند. نام فایل و شماره صفحه نیز باید همراه هر نتیجه به مدل ارسال شوند.
نمونه Context:
[فایل: report-1404.pdf | صفحه ۱۸]
...

[فایل: report-1405.pdf | صفحه ۲۱]
...
افزودن تاریخچه گفتگو
برای سؤالهای دنبالهدار مانند «این مورد را بیشتر توضیح بده»، برنامه باید زمینه سؤال قبلی را درک کند.
دو روش وجود دارد:
ارسال چند پیام اخیر
چند سؤال و پاسخ اخیر به مدل فرستاده میشوند. این روش ساده است، اما Context و هزینه را افزایش میدهد.
بازنویسی سؤال
مدل ابتدا سؤال جدید را با توجه به تاریخچه به یک سؤال مستقل تبدیل میکند.
مثال:
سؤال قبلی:
درآمد شرکت در سال ۱۴۰۴ چقدر بوده است؟

سؤال جدید:
در مقایسه با سال قبل چطور؟

سؤال مستقل:
درآمد شرکت در سال ۱۴۰۴ نسبت به سال ۱۴۰۳ چه تغییری کرده است؟
سپس جستوجوی برداری با سؤال مستقل انجام میشود.
خروجی ساختاریافته برای کاربردهای نرمافزاری
اگر پاسخ قرار است داخل نرمافزار پردازش شود، بهتر است مدل خروجی JSON تولید کند:
{
  "answer": "پاسخ مستند",
  "found": true,
  "citations": [
    {
      "page": 18,
      "claim": "نتیجه اصلی گزارش"
    }
  ],
  "confidence": "medium"
}
سپس پاسخ با Pydantic اعتبارسنجی میشود.
نباید فقط به مقدار confidence تولیدشده توسط مدل اتکا کرد. شاخصهای بازیابی، وجود منبع و ارزیابی واقعی نیز باید بررسی شوند.
نمونه پرامپت مناسب برای ChatPDF فارسی
شما دستیار پرسش و پاسخ از اسناد فارسی هستید.
قواعد:
- فقط از متن بازیابیشده استفاده کن.
- اطلاعات خارج از سند اضافه نکن.
- اگر پاسخ وجود ندارد، شفاف



