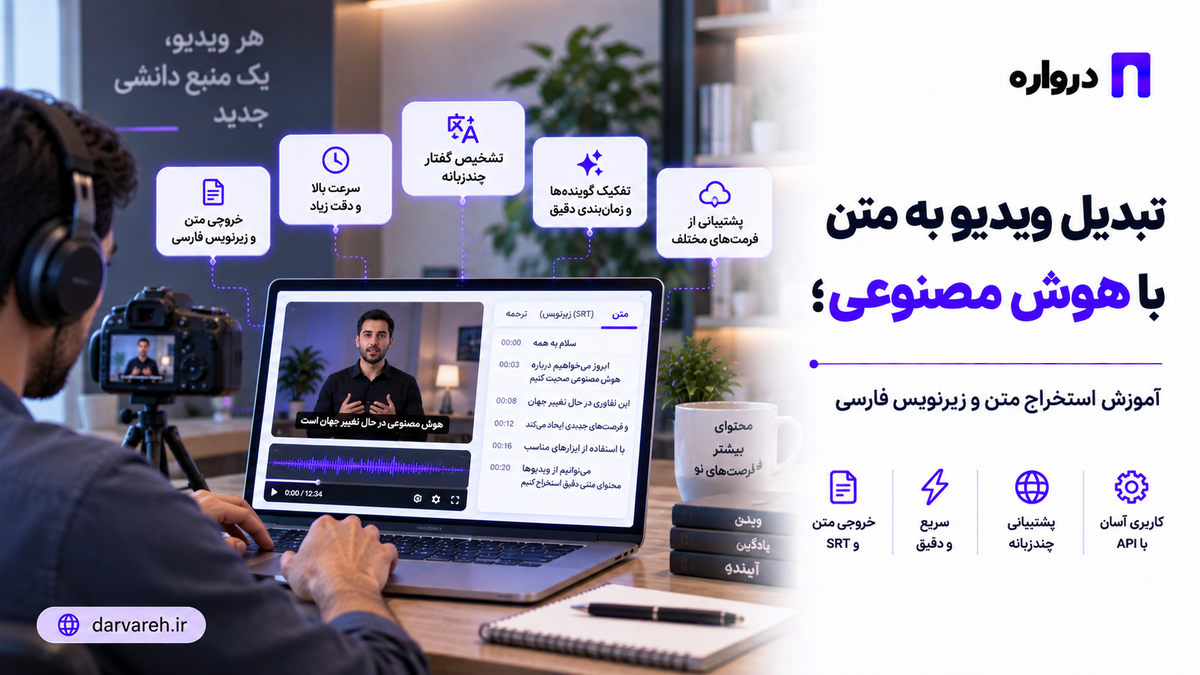
تبدیل ویدیو به متن با هوش مصنوعی؛ آموزش استخراج متن و زیرنویس فارسی
تبدیل ویدیو به متن با هوش مصنوعی، سریعترین راه برای پیادهسازی فیلم، استخراج صحبتها، ساخت زیرنویس و خلاصهکردن محتوای ویدیویی است. در این راهنما با ابزارهای آنلاین، روش رایگان Whisper، تولید فایل SRT و پردازش متن با API درواره آشنا میشوید.
تبدیل ویدیو به متن با هوش مصنوعی به شما اجازه میدهد محتوای یک فیلم، جلسه، کلاس آموزشی، مصاحبه یا ویدیوی شبکههای اجتماعی را بدون تایپ دستی پیادهسازی کنید. ابزارهای تشخیص گفتار میتوانند صدای داخل ویدیو را تحلیل کرده و آن را به متن ساده، متن زمانبندیشده یا فایل زیرنویس تبدیل کنند.
این قابلیت فقط برای نوشتن صحبتهای داخل فیلم کاربرد ندارد. پس از استخراج متن میتوان از هوش مصنوعی برای خلاصهسازی ویدیو، ساخت مقاله، تولید کپشن، ترجمه، تهیه صورتجلسه، شناسایی موضوعات مهم و ایجاد محتوای قابل جستوجو استفاده کرد.
در این مقاله روشهای مختلف تبدیل فیلم به متن، ابزارهای رایگان، نحوه ساخت زیرنویس SRT، مشکلات زبان فارسی و یک نمونه عملی برای پردازش متن استخراجشده با API درواره را بررسی میکنیم.
تبدیل ویدیو به متن چیست؟
تبدیل ویدیو به متن فرایندی است که در آن گفتار موجود در فایل ویدیویی به نوشته تبدیل میشود. این فرایند معمولاً با فناوری تشخیص خودکار گفتار یا Speech-to-Text انجام میشود.
در سادهترین حالت، ابزار هوش مصنوعی فقط یک متن پیوسته تحویل میدهد:
سلام و خوش آمدید. در این ویدیو درباره روشهای تولید محتوا صحبت میکنیم.در حالت پیشرفتهتر، زمان شروع و پایان هر بخش نیز ثبت میشود:
00:00:02 - 00:00:06
سلام و خوش آمدید.
00:00:07 - 00:00:12
در این ویدیو درباره روشهای تولید محتوا صحبت میکنیم.خروجی زمانبندیشده را میتوان برای ساخت زیرنویس، جستوجو داخل ویدیو، تدوین بر اساس متن و ساخت کلیپهای کوتاه استفاده کرد.
هوش مصنوعی چگونه صدای ویدیو را به متن تبدیل میکند؟
یک سامانه تبدیل فیلم به متن معمولاً چند مرحله را انجام میدهد:
- صدای ویدیو از تصویر جدا میشود.
- بخشهای دارای گفتار تشخیص داده میشوند.
- مدل تشخیص گفتار، صدا را به کلمات تبدیل میکند.
- علائم نگارشی و ساختار جمله اصلاح میشوند.
- در صورت نیاز، زمان هر جمله یا کلمه ثبت میشود.
- متن نهایی بهصورت TXT، DOCX، JSON، VTT یا SRT ارائه میشود.
مدلهای جدید میتوانند علاوه بر تشخیص کلمات، زبان فایل، تغییر گوینده و زمانبندی بخشها را نیز تشخیص دهند. برای نمونه، مستندات رسمی OpenAI میان رونویسی معمولی، ثبت زمان و جداسازی گویندگان تفاوت قائل میشود. در رونویسی دارای تفکیک گوینده، هر بخش میتواند اطلاعاتی مانند نام گوینده، زمان شروع و زمان پایان داشته باشد. مستندات تبدیل گفتار به متن OpenAI
کاربردهای تبدیل فیلم به متن با هوش مصنوعی
پیادهسازی کلاس و دوره آموزشی
دانشجو یا مدرس میتواند صدای کلاس را به متن تبدیل کند و سپس از متن برای ساخت جزوه، خلاصه درس، فلشکارت و سؤال امتحانی استفاده کند.
برای این کاربرد بهتر است اصطلاحات تخصصی درس از قبل به ابزار معرفی شوند تا نامها و واژههای علمی با دقت بیشتری نوشته شوند.
تبدیل جلسه به صورتجلسه
پس از پیادهسازی ویدیوی جلسه میتوان موارد زیر را استخراج کرد:
- تصمیمهای گرفتهشده
- وظایف هر فرد
- مهلت انجام کارها
- موضوعات حلنشده
- سؤالات مطرحشده
- خلاصه مدیریتی جلسه
اگر تشخیص گویندگان فعال باشد، مشخص میشود هر جمله توسط چه کسی بیان شده است.
ساخت زیرنویس فارسی
یکی از مهمترین کاربردها، تبدیل خودکار فیلم به زیرنویس فارسی است. برای این کار خروجی باید علاوه بر متن، زمان شروع و پایان هر قطعه را نیز داشته باشد.
راهنمای ساخت زیرنویس فارسی با هوش مصنوعی این فرایند را با تمرکز بیشتری روی فایل SRT توضیح میدهد.
استخراج متن از ویدیوی یوتیوب
اگر ویدیو در یوتیوب زیرنویس داشته باشد، ممکن است بتوان متن آن را مستقیماً مشاهده کرد. در غیر این صورت باید فایل ویدیو یا صدای آن را با رعایت حقوق صاحب محتوا پردازش کرد.
YouTube Data API امکاناتی برای مدیریت مسیرهای زیرنویس ویدیوهای دارای مجوز مناسب ارائه میدهد؛ دسترسی به زیرنویس هر ویدیو الزاماً آزاد نیست. مستندات Captions یوتیوب
برای خلاصهکردن محتوای یوتیوب نیز میتوانید مقاله خلاصهسازی ویدیوی یوتیوب با هوش مصنوعی را مطالعه کنید.
تولید مقاله و محتوای شبکههای اجتماعی
یک ویدیوی آموزشی بلند میتواند به چند نوع محتوا تبدیل شود:
- مقاله وبلاگ
- کپشن اینستاگرام
- پست لینکدین
- خبرنامه ایمیلی
- توضیحات ویدیو
- پرسشهای متداول
- سناریوی ویدیوی کوتاه
- چند نقلقول قابل انتشار
در این روش، متن استخراجشده ماده اولیه تولید محتوا است. مدل زبانی نباید اطلاعاتی خارج از ویدیو را به نام گوینده اضافه کند.
جستوجو در آرشیو ویدیو
سازمانهایی که تعداد زیادی جلسه، وبینار یا دوره آموزشی دارند، میتوانند متن ویدیوها را در یک موتور جستوجو ذخیره کنند. کاربر بهجای تماشای کامل هر فیلم، عبارت موردنظر را جستوجو کرده و مستقیماً به زمان مرتبط منتقل میشود.
خروجیهای متداول تبدیل ویدیو به متن
| قالب | کاربرد |
|---|---|
| TXT | متن ساده و قابل ویرایش |
| DOCX | تهیه گزارش، مقاله یا جزوه |
| JSON | اتصال خروجی به نرمافزار |
| SRT | زیرنویس زمانبندیشده |
| VTT | زیرنویس ویدیوهای تحت وب |
| CSV | تحلیل قطعهها و گویندگان |
| انتشار نسخه نهایی و ثابت |
اگر فقط به محتوای صحبتها نیاز دارید، خروجی TXT کافی است. برای زیرنویس باید SRT یا VTT دریافت کنید. در نرمافزارهای سازمانی، JSON انتخاب بهتری است؛ زیرا زمان، گوینده و متن هر قطعه را میتوان جداگانه ذخیره کرد.
ساختار فایل زیرنویس SRT چگونه است؟
یک فایل SRT از شماره قطعه، بازه زمانی و متن تشکیل میشود:
1
00:00:01,500 --> 00:00:04,700
سلام، به این آموزش خوش آمدید.
2
00:00:05,200 --> 00:00:09,800
در این ویدیو تبدیل فیلم به متن را بررسی میکنیم.پسوند فایل باید .srt باشد. بسیاری از پخشکنندهها و نرمافزارهای تدوین میتوانند این قالب را مستقیماً وارد کنند.
برای خوانایی زیرنویس بهتر است:
- هر قطعه بیش از دو خط نباشد.
- جمله در نقطه طبیعی شکسته شود.
- زیرنویس برای مدت کافی روی صفحه باقی بماند.
- فاصله زمانی قطعهها با تصویر هماهنگ باشد.
- اعداد، نامها و اصطلاحات تخصصی بازبینی شوند.
روشهای تبدیل ویدیو به متن فارسی
استفاده از ابزارهای آنلاین
در ابزارهای آنلاین معمولاً کافی است فایل ویدیو را بارگذاری کنید، زبان فارسی را انتخاب کرده و منتظر پردازش بمانید.
این روش برای کاربران غیرتوسعهدهنده مناسب است، اما پیش از بارگذاری فایل باید موارد زیر را بررسی کنید:
- محدودیت حجم و مدت ویدیو
- پشتیبانی واقعی از زبان فارسی
- امکان دریافت SRT
- قابلیت تشخیص چند گوینده
- سیاست نگهداری فایل
- هزینه هر دقیقه پردازش
- امکان ویرایش متن در مرورگر
- کیفیت خروجی در صدای شلوغ
نسخه رایگان بسیاری از ابزارها محدودیت زمانی، واترمارک یا امکان خروجی محدود دارد.
استفاده از زیرنویس خودکار پلتفرم ویدیو
پلتفرمهایی مانند یوتیوب میتوانند برای بعضی ویدیوها زیرنویس خودکار ایجاد کنند. این روش ساده است، اما دقت آن به زبان، کیفیت صدا و نوع محتوا وابسته خواهد بود.
زیرنویس خودکار را قبل از انتشار بررسی کنید؛ مخصوصاً اگر ویدیو شامل نام اشخاص، آدرس، مبلغ، اصطلاح فنی یا کلمات مشابه از نظر تلفظ است.
اجرای Whisper روی کامپیوتر
Whisper یک مدل متنباز تشخیص گفتار است که میتواند روی رایانه اجرا شود. مخزن رسمی آن، Whisper را یک مدل چندزبانه برای تشخیص گفتار، شناسایی زبان و ترجمه گفتار معرفی میکند. مخزن رسمی Whisper
مزیت اجرای محلی این است که فایل روی سیستم خودتان پردازش میشود. در مقابل، سرعت پردازش به سختافزار و اندازه مدل بستگی دارد.
مدلهای کوچکتر سریعتر و کمحجمتر هستند، اما ممکن است دقت کمتری داشته باشند. مدلهای بزرگتر معمولاً به حافظه و توان پردازشی بیشتری نیاز دارند.
استفاده از API تبدیل گفتار به متن
API برای وبسایتها، سامانههای آموزشی، نرمافزارهای جلسات و فرایندهای پرتعداد مناسب است. برنامه فایل را ارسال میکند و متن یا خروجی ساختاریافته را دریافت میکند.
بعضی APIها فایل MP4 را مستقیماً میپذیرند و در بعضی سرویسها باید ابتدا صدا استخراج شود. برای مثال، مستندات فعلی OpenAI قالبهایی مانند MP3، MP4، M4A، WAV و WebM را برای رونویسی فایل فهرست کرده و برای درخواست فایل محدودیت حجم تعیین میکند؛ این محدودیتها ممکن است تغییر کنند و باید پیش از پیادهسازی دوباره بررسی شوند. راهنمای رسمی رونویسی فایل
آموزش رایگان تبدیل ویدیو به متن با Whisper
مرحله اول: نصب FFmpeg
Whisper برای پردازش فایلهای صوتی و ویدیویی به FFmpeg نیاز دارد. مستندات رسمی Whisper نیز نصب این ابزار را بهعنوان یکی از پیشنیازها ذکر میکند.
در اوبونتو یا دبیان:
sudo apt update
sudo apt install ffmpeg
در macOS با Homebrew:
brew install ffmpegمرحله دوم: نصب Whisper
pip install -U openai-whisperمرحله سوم: تبدیل ویدیو به متن فارسی
whisper video.mp4 \
  --model medium \
  --language Persian \
  --task transcribe \
  --output_format txt
اگر فایل زیرنویس میخواهید:
whisper video.mp4 \
  --model medium \
  --language Persian \
  --task transcribe \
  --output_format srt
خروجی در پوشه جاری ذخیره میشود. سرعت اجرای دستور به مدت فیلم، مدل انتخابی، پردازنده و کارت گرافیک وابسته است.
استخراج صدای ویدیو با FFmpeg
برای کاهش حجم فایل میتوانید ابتدا تصویر را حذف و فقط صدا را نگه دارید:
ffmpeg \
  -i video.mp4 \
  -vn \
  -ac 1 \
  -ar 16000 \
  -c:a libmp3lame \
  -b:a 64k \
  audio.mp3
گزینه -vn مانع قرارگرفتن جریان ویدیویی در خروجی میشود. مستندات FFmpeg این گزینه را برای کنارگذاشتن جریان ویدیو توضیح داده است. مستندات رسمی FFmpeg
سپس فایل صوتی را پردازش کنید:
whisper audio.mp3 \
  --model medium \
  --language Persian \
  --output_format srt
چگونه دقت تبدیل ویدیو فارسی به متن را افزایش دهیم؟
کیفیت صدا را بهبود دهید
تشخیص گفتار زمانی بهتر عمل میکند که صدای گوینده واضح باشد. صدای موسیقی، پژواک، باد، مکالمه همزمان و فاصله زیاد از میکروفن میتواند تعداد خطاها را افزایش دهد.
اگر امکان ضبط دوباره وجود دارد:
- میکروفن را نزدیک گوینده قرار دهید.
- صدای موسیقی پسزمینه را کم کنید.
- از ضبط همزمان چند نفر جلوگیری کنید.
- محیطی با پژواک کمتر انتخاب کنید.
- سطح صدا را قبل از جلسه آزمایش کنید.
زبان را مشخص کنید
تشخیص خودکار زبان همیشه بهترین انتخاب نیست. اگر میدانید محتوای فایل فارسی است، زبان را صریحاً روی فارسی تنظیم کنید.
در فایلهایی که فارسی و انگلیسی ترکیب شدهاند، چند نمونه واقعی را آزمایش کنید؛ زیرا مدل ممکن است نام محصولات، اصطلاحات فنی یا کدها را اشتباه بنویسد.
فهرست اصطلاحات را ارائه کنید
اگر سرویس از prompt یا keywords پشتیبانی میکند، نام برند، محصول، افراد و اصطلاحات تخصصی را در اختیار آن قرار دهید.
برای مثال:
موضوع جلسه درباره درواره، API سازگار با OpenAI، مدلهای زبانی و RAG است.
واژههای مورد انتظار: درواره، OpenAI، Embedding، LangChain، LlamaIndexمستندات OpenAI توضیح میدهد که اطلاعات زمینهای، کلمات کلیدی و زبانهای مورد انتظار میتوانند برای بهبود تشخیص اصطلاحات تخصصی استفاده شوند؛ البته کلمات کلیدی صرفاً راهنما هستند و نباید بدون ارزیابی به آنها اعتماد کرد. راهنمای افزودن زمینه به رونویسی
فایلهای طولانی را قطعهبندی کنید
برای ویدیوهای چندساعته بهتر است فایل به بخشهای کوتاهتر تقسیم شود. این کار مدیریت خطا، تلاش مجدد و ذخیره مرحلهای خروجی را سادهتر میکند.
هنگام قطعهبندی چند ثانیه همپوشانی در نظر بگیرید تا کلمهای در محل برش حذف نشود. سپس بخشهای تکراری را هنگام ادغام پاک کنید.
متن را بدون تغییر معنا ویرایش کنید
مدل زبانی میتواند علائم نگارشی، نیمفاصله و ساختار جمله را اصلاح کند؛ اما نباید جملهای را که در ویدیو گفته نشده به متن اضافه کند.
در پرامپت ویرایش بنویسید:
متن زیر از گفتار استخراج شده است.
فقط خطاهای املایی، نشانهگذاری و نیمفاصله را اصلاح کن.
معنا، اعداد، نامها و ادعاهای گوینده را تغییر نده.
هیچ اطلاعات تازهای اضافه نکن.
بخشهای نامطمئن را با [نامشخص] علامت بزن.مشکلات رایج تبدیل فیلم فارسی به متن
اشتباه در نیمفاصله و رسمالخط
خروجی ممکن است عبارتهایی مانند «می شود»، «آن ها» و «نرم افزار» را بدون نیمفاصله بنویسد. یک مرحله ویرایش فارسی میتواند شکل نوشتاری را یکدست کند.
اشتباه در نام اشخاص و برندها
مدل از روی صدا حدس میزند و ممکن است یک نام کمکاربرد را با کلمهای رایج جایگزین کند. فهرست واژههای تخصصی و بازبینی انسانی برای این موارد ضروری است.
حذف علائم نگارشی
برخی مدلها متن را بهصورت جملههای طولانی تحویل میدهند. افزودن نقطه و ویرگول خوانایی را بهتر میکند، اما نباید مفهوم جمله تغییر کند.
همپوشانی صدای گویندگان
اگر چند نفر همزمان صحبت کنند، حتی مدلهای قوی نیز ممکن است بخشی از جملهها را ترکیب یا حذف کنند. جداسازی کانالهای صوتی هنگام ضبط میتواند نتیجه را بهتر کند.
لهجه و سرعت گفتار
دقت مدل در همه لهجهها یکسان نیست. گفتار بسیار سریع، بلعیدن کلمات و واژههای محلی احتمال خطا را افزایش میدهد.
موسیقی و صدای محیط
موسیقی بلند، صدای خیابان یا تماس اینترنتی بیکیفیت تشخیص کلمات را دشوار میکند. کاهش نویز میتواند کمککننده باشد، اما فیلتر شدید ممکن است بخشی از صدای گفتار را نیز از بین ببرد.
تبدیل متن ویدیو به خلاصه با API درواره
پس از استخراج متن، میتوان از یک مدل زبانی برای ساخت خلاصه، عنوان، نکات کلیدی و فصلبندی استفاده کرد.
در این نمونه فرض میکنیم متن رونویسیشده در فایل transcript.txt قرار دارد.
ابتدا کتابخانه را نصب کنید:
pip install openaiمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
کد پایتون:
import os
from pathlib import Path
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
def analyze_transcript(transcript: str) -> str:
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0.2,
messages=[
{
"role": "system",
"content": (
"شما متن استخراجشده از ویدیوهای فارسی را تحلیل میکنید. "
"فقط از اطلاعات موجود در متن استفاده کنید و هیچ ادعا، عدد "
"یا نقلقول تازهای نسازید."
),
},
{
"role": "user",
"content": f"""
متن زیر از یک ویدیو استخراج شده است.
خروجی را با این بخشها آماده کن:
1. عنوان پیشنهادی
2. خلاصه حداکثر ۲۰۰ کلمه
3. نکات کلیدی
4. فصلبندی پیشنهادی
5. اصطلاحات یا نامهای نیازمند بازبینی
6. اقدامات مطرحشده در ویدیو
اگر بخشی نامشخص است، آن را حدس نزن.
متن ویدیو:
{transcript}
""",
},
],
)
content = response.choices[0].message.content
if not content:
raise ValueError("پاسخی از مدل دریافت نشد.")
return content
transcript = Path("transcript.txt").read_text(encoding="utf-8")
result = analyze_transcript(transcript)
Path("video_analysis.md").write_text(result, encoding="utf-8")
print(result)شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید. درواره امکان دسترسی به مدلهای مختلف را از طریق یک API سازگار با OpenAI فراهم میکند؛ بنابراین تیم میتواند مدلهای متفاوت را روی متنهای واقعی مقایسه کند. مستندات API درواره
برای متنهای بسیار طولانی بهتر است رونویسی را به قطعههای منطقی تقسیم کنید، از هر قطعه خلاصه بگیرید و در پایان خلاصههای میانی را ترکیب کنید.
معماری پیشنهادی برای سامانه تبدیل ویدیو به متن
یک سامانه واقعی میتواند این مراحل را داشته باشد:
بارگذاری ویدیو
↓
بررسی نوع، حجم و مدت فایل
↓
استخراج و بهینهسازی صدا
↓
تقسیم فایل طولانی
↓
تبدیل گفتار به متن
↓
ثبت زمان و گوینده
↓
اصلاح نگارشی کنترلشده
↓
خلاصهسازی و استخراج اطلاعات
↓
ذخیره متن، JSON یا SRTبهتر است رابط کاربری مستقیماً به سرویس مدل متصل نشود. کلید API باید در سمت سرور نگهداری شود و اعتبارسنجی فایل، محدودیت مصرف و کنترل خروجی نیز در همان بخش انجام شود.
تبدیل ویدیو به متن برای کسبوکارها
مراکز آموزشی
میتوان برای هر جلسه متن قابل جستوجو، خلاصه، فصلبندی، سؤال و جزوه تولید کرد. زمان هر بخش نیز به لینک همان قسمت از ویدیو متصل میشود.
تیمهای فروش و پشتیبانی
تماسها و جلسههای ویدیویی میتوانند برای استخراج نیاز مشتری، اعتراضها، تعهدات و اقدام بعدی تحلیل شوند. تصمیمهای مهم نباید بدون بازبینی انسانی صرفاً بر اساس متن خودکار اجرا شوند.
رسانهها و تولیدکنندگان محتوا
مصاحبه، پادکست تصویری و وبینار را میتوان به مقاله، کپشن، زیرنویس و کلیپ کوتاه تبدیل کرد. حفظ لحن و بررسی نقلقولها در این کاربرد اهمیت زیادی دارد.
شرکتها و سازمانها
متن جلسات میتواند در سامانه مدیریت دانش ذخیره شود. با اتصال متنها به جستوجوی معنایی، کارکنان پاسخ خود را در آرشیو ویدیوها پیدا میکنند.
چگونه هزینه تبدیل فیلم به متن را کاهش دهیم؟
فقط صدا را ارسال کنید
اگر تصویر برای تحلیل لازم نیست، استخراج صدا حجم انتقال و ذخیرهسازی را کاهش میدهد.
سکوتهای طولانی را حذف کنید
در وبینار یا جلسه ممکن است چند دقیقه سکوت وجود داشته باشد. تشخیص و حذف سکوت از پردازش غیرضروری جلوگیری میکند.
مدل را متناسب با کیفیت لازم انتخاب کنید
برای پیشنویس داخلی شاید یک مدل سریع کافی باشد، اما زیرنویس عمومی یا متن حقوقی به دقت و بازبینی بیشتری نیاز دارد.
پردازش را مرحلهای انجام دهید
ابتدا متن خام را استخراج کنید. خلاصهسازی، ترجمه و تولید محتوا را فقط برای فایلهایی اجرا کنید که واقعاً به این خروجیها نیاز دارند.
نتیجهها را ذخیره کنید
یک فایل یکسان نباید پس از هر درخواست دوباره پردازش شود. هش فایل و نسخه تنظیمات را ذخیره کنید تا خروجی موجود قابل استفاده باشد.
معیارهای انتخاب ابزار تبدیل ویدیو به متن
پیش از انتخاب سرویس، چند فایل واقعی را با شرایط متفاوت آزمایش کنید:
| معیار | سؤال مهم |
|---|---|
| دقت فارسی | چند درصد از نامها، اعداد و جملهها درست هستند؟ |
| زمانبندی | زیرنویس با صدای گوینده هماهنگ است؟ |
| گویندگان | افراد مختلف درست تفکیک میشوند؟ |
| قالب خروجی | TXT، SRT، VTT و JSON در دسترس است؟ |
| سرعت | پردازش یک ساعت ویدیو چقدر طول میکشد؟ |
| هزینه | قیمت بر اساس دقیقه، فایل یا مصرف API است؟ |
| یکپارچهسازی | API و مستندات فنی ارائه میشود؟ |
| ویرایش | امکان اصلاح متن و زمانها وجود دارد؟ |
| زبان ترکیبی | فارسی همراه با واژههای انگلیسی درست پردازش میشود؟ |
برای مقایسه مدلها، یک مجموعه ثابت از فایلهای کوتاه آماده کنید و تعداد خطاهای کلمه، نام، عدد و زمانبندی را جداگانه بسنجید.
اشتباهات رایج هنگام استخراج متن از فیلم
اعتماد کامل به متن خام
حتی بهترین مدلها ممکن است یک عدد، نام یا جمله را اشتباه تشخیص دهند. متن حساس یا قابل انتشار باید بازبینی شود.
خلاصهسازی پیش از نگهداری متن اصلی
همیشه نسخه خام رونویسی را نگه دارید. خلاصه مدل جایگزین متن اصلی ویدیو نیست.
حذف زمانبندی
اگر احتمال ساخت زیرنویس یا لینکدادن به بخشهای ویدیو وجود دارد، زمان هر قطعه را از ابتدا ذخیره کنید.
ارسال کل فایل به مدل زبانی
مدل متنی معمولاً برای تبدیل مستقیم صدای ویدیو طراحی نشده است. ابتدا از مدل تشخیص گفتار استفاده کنید و سپس متن را برای تحلیل به مدل زبانی بدهید.
اصلاح بیش از حد متن
ویرایش تهاجمی ممکن است لحن یا ادعای گوینده را تغییر دهد. متن پیادهشده باید میان «ویرایش نگارشی» و «بازنویسی محتوایی» تفاوت روشنی داشته باشد.
فراموشکردن مجوز محتوا
پیش از دانلود، تبدیل، ترجمه یا بازنشر ویدیو مطمئن شوید اجازه لازم را دارید. دسترسی عمومی به یک ویدیو الزاماً مجوز بازنشر متن کامل آن نیست.
پرسشهای متداول
چگونه ویدیو را به متن فارسی تبدیل کنیم؟
میتوانید فایل را در یک ابزار آنلاین بارگذاری کنید، زیرنویس خودکار پلتفرم را دریافت کنید یا Whisper را روی کامپیوتر اجرا کنید. برای نتیجه بهتر، زبان فارسی را مشخص کرده و خروجی را بازبینی کنید.
آیا تبدیل ویدیو به متن رایگان است؟
بله. Whisper را میتوان روی کامپیوتر اجرا کرد، اما پردازش محلی به سختافزار و فضای ذخیرهسازی نیاز دارد. ابزارهای آنلاین رایگان معمولاً محدودیت مدت، حجم یا تعداد فایل دارند.
چگونه از ویدیو فایل Word بسازیم؟
ابتدا گفتار را به متن TXT تبدیل کنید. سپس متن را در Word قرار دهید و تیترها، پاراگرافها و علائم نگارشی را اصلاح کنید. این فرایند را میتوان با اسکریپت یا گردش کار خودکار نیز انجام داد.
چگونه ویدیو را به زیرنویس SRT تبدیل کنیم؟
ابزاری انتخاب کنید که زمان شروع و پایان جملهها را ارائه دهد. در Whisper میتوانید --output_format srt را تعیین کنید تا فایل زیرنویس ساخته شود.
آیا هوش مصنوعی میتواند گویندگان را تشخیص دهد؟
بعضی مدلها قابلیت تفکیک گویندگان یا diarization دارند. خروجی این مدلها معمولاً برای هر قطعه، شناسه گوینده و زمان شروع و پایان ارائه میکند.
بهترین مدل Whisper برای فارسی کدام است؟
یک پاسخ ثابت برای همه فایلها وجود ندارد. مدلهای بزرگتر معمولاً ظرفیت بیشتری دارند، اما کندتر و پرهزینهتر هستند. چند مدل را روی صدای واقعی، لهجه و اصطلاحات موردنظر خود آزمایش کنید.
آیا میتوان فیلم چندساعته را به متن تبدیل کرد؟
بله، اما بهتر است فایل به قطعههای کوچکتر تقسیم شود. این روش بازیابی خطا، پردازش موازی و کنترل هزینه را سادهتر میکند.
چگونه متن استخراجشده را خلاصه کنیم؟
متن را به یک مدل زبانی بدهید و ساختار خروجی را مشخص کنید؛ برای مثال خلاصه، نکات کلیدی، فصلبندی و اقدامات. برای متن بلند از خلاصهسازی چندمرحلهای استفاده کنید.
آیا میتوان ویدیوی بدون صدا را به متن تبدیل کرد؟
تشخیص گفتار فقط صدای موجود را به متن تبدیل میکند. برای ویدیوی بدون گفتار باید فریمهای تصویر، نوشتههای روی صفحه یا رویدادهای بصری با مدل بینایی تحلیل شوند.
تفاوت تبدیل ویدیو به متن با ساخت زیرنویس چیست؟
متن ساده فقط محتوای گفتار را نگه میدارد. زیرنویس علاوه بر متن، دارای زمان شروع و پایان هر قطعه است تا با پخش فیلم هماهنگ شود.
جمعبندی
تبدیل ویدیو به متن با هوش مصنوعی میتواند ساعتها تایپ دستی را به یک فرایند خودکار تبدیل کند. خروجی این فرایند برای ساخت زیرنویس، جزوه، صورتجلسه، مقاله، کپشن، جستوجوی ویدیو و مدیریت دانش کاربرد دارد.
برای رسیدن به نتیجه بهتر:
- صدای ورودی را با کیفیت مناسب تهیه کنید.
- زبان فارسی را بهصورت صریح مشخص کنید.
- نامها و اصطلاحات تخصصی را در اختیار مدل قرار دهید.
- برای زیرنویس، زمانبندی قطعهها را ذخیره کنید.
- متن خام را پیش از خلاصهسازی نگه دارید.
- اعداد، نامها و نقلقولها را بازبینی کنید.
- ویرایش نگارشی را بدون تغییر معنای گفتهها انجام دهید.
- چند مدل را روی فایلهای واقعی مقایسه کنید.
پس از استخراج متن میتوانید با API درواره از مدلهای مختلف برای خلاصهسازی، فصلبندی، استخراج اطلاعات و تولید محتوای تکمیلی استفاده کنید.
مقالات مرتبط
- تبدیل صدای فارسی به متن با هوش مصنوعی
- ساخت زیرنویس خودکار فارسی و فایل SRT
- خلاصهسازی ویدیوی یوتیوب با هوش مصنوعی
- حذف نویز صدا با هوش مصنوعی
- تبدیل متن و PDF به خلاصه با هوش مصنوعی
- آموزش اتصال API هوش مصنوعی به نرمافزار
منابع
- OpenAI: راهنمای رسمی تبدیل گفتار به متن
- مخزن رسمی Whisper
- مستندات رسمی FFmpeg
- Google Developers: مستندات زیرنویس یوتیوب
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.