
JEPA چیست؟ آموزش معماری پیشبینی مشترک، I-JEPA و V-JEPA با Python
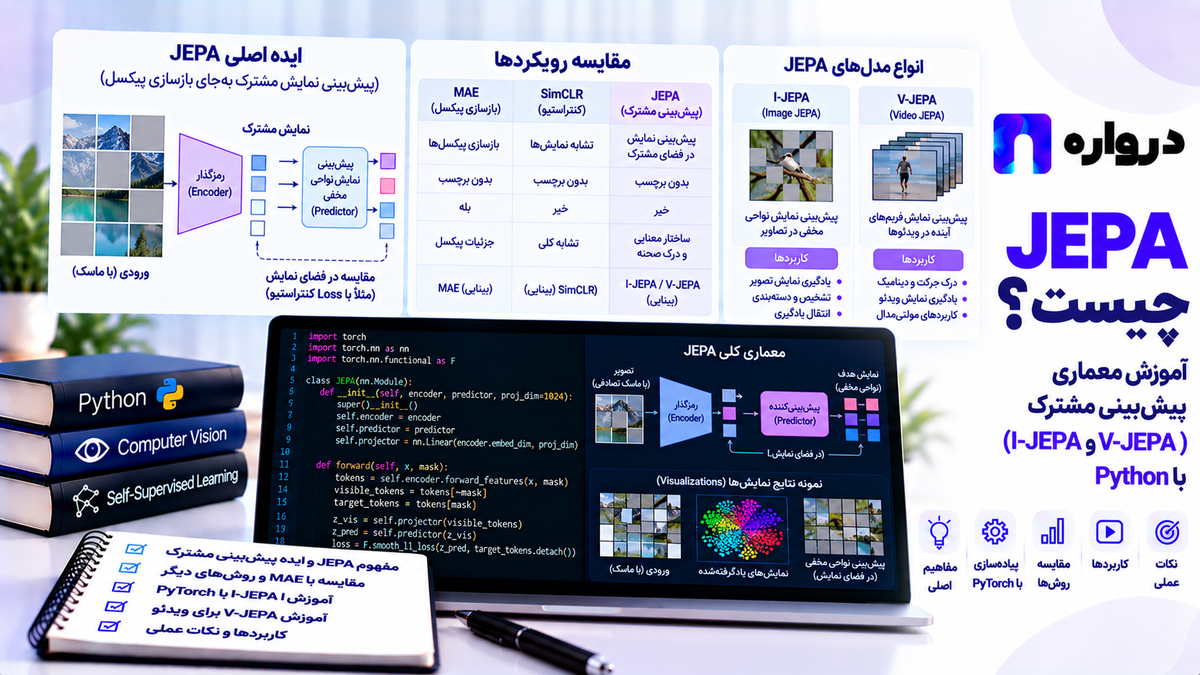
JEPA چیست و چگونه بدون بازسازی پیکسلها از تصویر و ویدئو یاد میگیرد؟ در این راهنما، معماری JEPA، تفاوت I-JEPA و V-JEPA، ارتباط آن با مدل جهان و استخراج ویژگی ویدئو با Pythonرا بررسی میکنیم.

Excerpt:
JEPA چیست و چگونه بدون بازسازی پیکسلها از تصویر و ویدئو یاد میگیرد؟ در این راهنما، معماری JEPA، تفاوت I-JEPA و V-JEPA، ارتباط آن با مدل جهان و استخراج ویژگی ویدئو با Pythonرا بررسی میکنیم.
عنوان متا:
JEPA چیست؟ آموزش I-JEPA و V-JEPA با مثال Python
توضیحات متا:
راهنمای جامع JEPA، I-JEPA و V-JEPA؛ بررسی یادگیری خودنظارتی، پیشبینی ویژگی، تفاوت با مدلهای مولد و استخراج ویژگی ویدئو باPython.
اسلاگ:jepa-ijepa-vjepa-predictive-architecture-python-guide
متن جایگزین تصویر شاخص:
معماری JEPA شامل رمزگذار زمینه، رمزگذار هدف و پیشبینیکننده برای یادگیری نمایشهای تصویر و ویدئو
JEPA چیست؟ آموزش معماری پیشبینی مشترک، I-JEPA و V-JEPA با Python
بسیاری از مدلهای هوش مصنوعی با پیشبینی محتوای ازدسترفته آموزش میبینند. یک مدل زبانی توکن بعدی را پیشبینی میکند و یک مدل بازسازی تصویر میتواند پیکسلهای پوشاندهشده را بسازد.
اما آیا برای یادگیری ساختار یک صحنه، لازم است مدل تمام جزئیات پیکسلی آن را بازسازی کند؟
JEPA رویکردی است که بهجای بازسازی مستقیم داده خام، نمایش ویژگیهای بخش پنهان را از اطلاعات بخش قابلمشاهده پیشبینی میکند.
برای مثال، مدل میتواند از قسمتهای دیدهشده یک تصویر، نمایش بخش پوشاندهشده را تخمین بزند. هدف اصلی، تولید یک تصویر قابلنمایش نیست؛ هدف، یادگیری ویژگیهایی است که برای کارهای بعدی مفید باشند.
این ایده در I-JEPA برای تصویر و V-JEPA برای ویدئو به کار رفته است. مقاله I-JEPA آن را روشی غیرمولد برای یادگیری خودنظارتی معرفی میکند که نمایش بخشهای هدف را از یک بخش زمینه پیشبینی میکند. arxiv.org
در این مقاله، ساختار JEPA، تفاوت آن با بازسازی پیکسلی، ارتباطش با مدل جهان و کاربردهای عملی آن را بررسی میکنیم. سپس یک نمونه استخراج ویژگی ویدئو با V-JEPA 2 و Python میسازیم.
JEPAچیست؟
JEPAمخفف Joint-Embedding Predictive Architecture است؛ میتوان آن را «معماری پیشبینی در فضای بازنمایی مشترک» ترجمه کرد.
برای فهم نام آن، سه مفهوم اهمیت دارند:
- Embedding: تبدیل داده به نمایش عددی قابلاستفاده برای شبکه.
- Joint: ارتباط نمایشهای زمینه و هدف در یک چارچوب یادگیری.
- Predictive: پیشبینی نمایش هدف از اطلاعات زمینه.
در یک نمونه تصویری، بخشی از تصویر بهعنوان زمینه در اختیار مدل قرار میگیرد. مدل تلاش میکند ویژگیهای بخشهای هدف را پیشبینی کند و این پیشبینی با نمایش هدف مقایسه میشود.
تفاوت کلیدی این است که مقایسه در فضای ویژگی انجام میشود، نه الزاماً در فضای پیکسل.
یک مثال ساده برای فهمJEPA
تصویری از یک دوچرخه را در نظر بگیرید که بخشی از چرخ آن پوشانده شده است.
در بازسازی پیکسلی، مدل باید مقدار پیکسلهای بخش پوشاندهشده را تخمین بزند. این مسئله میتواند شامل رنگ، نور، سایه، بافت و جزئیات پسزمینه باشد.
در پیشبینی ویژگی، مدل به دنبال تخمین یک نمایش عددی از بخش هدف است.
برای توضیح شهودی، میتوان انتظار داشت یک نمایش مفید اطلاعات مربوط به ساختار شیء و ارتباط بخشهای آن را نگه دارد. بااینحال، اجزای یک بردار ویژگی لزوماً برچسبهای قابلخواندنی مانند «چرخ» یا «فلز» نیستند.
این مثال برای فهم تفاوت هدفهاست؛ نشان نمیدهد هر مدل JEPA حتماً چنین مفاهیمی را به شکل مستقل و قابلتفسیر ذخیره میکند.
یادگیری خودنظارتی درJEPA
در یادگیری نظارتشده، معمولاً هدف آموزشی با برچسب انسانی مشخص میشود؛ مثلاً برای هر تصویر مینویسیم «دوچرخه».
در یادگیری خودنظارتی، هدف از خود داده ساخته میشود.
در JEPA، بخشهایی از تصویر یا ویدئو برای ساخت زمینه و هدف استفاده میشوند. بنابراین برای مرحله پیشآموزش، الزاماً به برچسب دستی هر نمونه نیاز نیست.
البته «بدون برچسب» به معنای «بدون طراحی» نیست. انتخاب داده، روش پوشاندن بخشها، معماری شبکه و هدف آموزشی همچنان تعیینکنندهاند.
همچنین برای ارزیابی یا آموزش یک طبقهبند نهایی ممکن است به داده برچسبدار نیاز داشته باشیم.
اجزای اصلی معماریJEPA
در ساختارهای رایج این خانواده، سه بخش مهم دیده میشود:
| بخش | وظیفه |
|---|---|
| رمزگذار زمینه | ساخت نمایش از اطلاعات قابلمشاهده |
| رمزگذار هدف | ساخت نمایش مرجع از بخش هدف |
| پیشبینیکننده | تخمین نمایش هدف با استفاده از زمینه |
رمزگذار زمینه
این شبکه بخشهای در دسترس را دریافت میکند و نمایش آنها را میسازد.
رمزگذار هدف
این شبکه نمایش مرجعی تولید میکند که پیشبینی مدل با آن مقایسه میشود. دسترسی شاخه هدف به داده، به معنای قابلمشاهدهبودن همان اطلاعات برای پیشبینیکننده نیست.
پیشبینیکننده
پیشبینیکننده از نمایش زمینه و اطلاعات لازم درباره هدف، نمایش موردانتظار را تخمین میزند.
مخزن رسمی I-JEPA بر همین تمایز تأکید میکند: پیشبینیکننده در فضای نهفته کار میکند و وظیفه آن پرکردن جزئیات پیکسلی نیست. GitHub
چرا پیشبینی ویژگی با بازسازی تصویر تفاوت دارد؟
دو هدف میتوانند مدل را به یادگیری اطلاعات متفاوتی تشویق کنند.
در بازسازی تصویر، خطای مربوط به جزئیات ظاهری بخشی از هدف است. در پیشبینی ویژگی، اطلاعات مهم به آنچه رمزگذار هدف نمایش میدهد وابسته میشود.
اما نباید نتیجه گرفت پیشبینی ویژگی همیشه بهتر است.
اگر هدف محصول، بازسازی دقیق تصویر یا تولید خروجی بصری باشد، وجود Decoder تصویری میتواند ضروری باشد. اگر هدف، ساخت ویژگی برای طبقهبندی یا تحلیل حرکت باشد، بازسازی تمام پیکسلها الزاماً نیاز محصول نیست.
انتخاب روش باید از وظیفه نهایی شروع شود.
تفاوت JEPA وMasked Autoencoder
Masked Autoencoder یا MAE نیز بخشهایی از تصویر را میپوشاند، اما در نسخه اصلی، هدف آن بازسازی پیکسلهای بخشهای پوشاندهشده است.
مقاله MAE از رمزگذاری بخشهای قابلمشاهده و یک رمزگشای سبک برای بازسازی تصویر استفاده میکند. این روش نیز برای یادگیری نمایشهای بصری طراحی شده است. arxiv.org
| معیار | JEPA تصویری | MAE اصلی |
|---|---|---|
| هدف پیشبینی | نمایش ویژگی بخش هدف | پیکسلهای بخش هدف |
| فضای مقایسه | فضای بازنمایی | فضای تصویر |
| نیاز به بازسازی تصویر در هدف اصلی | ندارد | دارد |
| خروجی مستقیم قابلنمایش | الزاماً ندارد | بازسازی تصویری |
| کاربرد | یادگیری ویژگی | یادگیری ویژگی از راه بازسازی |
پس هر دو میتوانند ابزار یادگیری خودنظارتی باشند. تفاوت آنها در تعریف هدف آموزشی است.
I-JEPAچیست؟
I-JEPA یا Image-based JEPA نسخهای از این ایده برای تصاویر است.
در این روش، نمایش چند بخش هدف از اطلاعات یک بخش زمینه پیشبینی میشود. مقاله اصلی نشان میدهد طراحی ماسک اهمیت زیادی دارد: بخشهای هدف باید بهاندازه کافی بزرگ باشند و زمینه نیز اطلاعات مناسبی فراهم کند.
مدل روی وظایف پاییندستی مانند طبقهبندی و برآورد برخی ویژگیهای تصویر ارزیابی شده است. این نتایج نشاندهنده مفیدبودن نمایشها در آزمایشهای مشخصاند؛ تضمینی برای برتری روی هر دیتاست نیستند. arxiv.org
آیا I-JEPA بخش گمشده تصویر را تولید میکند؟
خروجی اصلی پیشبینیکننده، نمایش ویژگی است.
برای تبدیل آن به تصویر قابلمشاهده، به سازوکار دیگری نیاز دارید. مخزن رسمی I-JEPA نمونههایی از استفاده از یک Decoder جداگانه برای نمایش پیشبینیها ارائه میکند؛ این Decoder را نباید با هدف اصلی آموزش I-JEPA یکی دانست. GitHub
V-JEPAچیست؟
V-JEPA یا Video JEPA این رویکرد را به ویدئو گسترش میدهد.
ویدئو علاوه بر ساختار مکانی، ساختار زمانی دارد. تغییر وضعیت اشیا و ترتیب رویدادها میتواند برای تحلیل یک عمل مهم باشد.
مقاله V-JEPA، پیشبینی ویژگی را بهعنوان هدف مستقلی برای یادگیری از ویدئو بررسی میکند. در مرحله پیشآموزش گزارششده، از متن، نمونههای منفی یا بازسازی پیکسلی بهعنوان هدف استفاده نشده است. نمایشهای حاصل روی کارهای مرتبط با ظاهر و حرکت ارزیابی شدهاند. arxiv.org
نباید تمام ماسکگذاریهای ویدئویی را «پیشبینی آینده» نامید. بعضی هدفها بخشهای پنهان در یک قطعه ویدئو هستند و الزاماً فقط فریمهای بعدی نیستند.
V-JEPA 2چیست؟
V-JEPA 2 توسعهای در این خانواده برای یادگیری نمایش ویدئو و بررسی فهم، پیشبینی و برنامهریزی است.
مقاله آن دو بخش را از هم تفکیک میکند:
- پیشآموزش یک مدل بدون شرط کنش با داده تصویری و ویدئویی.
- ادامه آموزش یک مدل شرطیشده بر کنش، با استفاده از داده تعامل ربات.
مدل دوم با نام V-JEPA 2-AC معرفی شده است. مقاله، برنامهریزی برای برخی وظایف جابهجایی اشیا با بازوی رباتیک را در محیطهای آزمایششده گزارش میکند. arxiv.org
این نتیجه را نباید به «توانایی انجام هر کار رباتیک» تعمیم داد.
تفاوت V-JEPA 2 وV-JEPA 2-AC
| معیار | V-JEPA 2 | V-JEPA 2-AC |
|---|---|---|
| تمرکز | نمایشهای ویدئویی | پیشبینی شرطیشده بر کنش |
| استفاده از داده تعامل در مرحله مربوط | مدل پایه بدون شرط کنش | دارد |
| نقش مستقیم در برنامهریزی ربات | نیازمند اجزای مناسب | در پژوهش بررسی شده |
| خروجی گفتوگویی فارسی | بهصورت مستقل ندارد | بهصورت مستقل ندارد |
مستندات رسمی Transformers نیز V-JEPA 2-AC را مدل جهان نهفتهای معرفی میکند که از مدل پایه و با داده مسیرهای تعامل ربات، ادامه آموزش دیده است. Hugging Face
پس بارگذاری یک رمزگذار V-JEPA 2، بهتنهایی یک سامانه کنترل ربات نمیسازد.
ارتباط JEPA با مدل جهان
مدل جهان بهطور کلی مدلی از وضعیت محیط و تغییرات آن است که میتواند در پیشبینی یا تصمیمگیری استفاده شود.
برای نمونه، یک سامانه رباتیک ممکن است نیاز داشته باشد نتیجه چند حرکت پیشنهادی را تخمین بزند و سپس حرکت مناسب را انتخاب کند.
پیشبینی در فضای نهفته میتواند بخشی از چنین سامانهای باشد. Meta نیز V-JEPA 2 را در چارچوب پژوهش درباره مدلهای جهان و برنامهریزی معرفی کرده است. ai.meta.com
بااینحال، هر مدل JEPA الزاماً مدل کامل پویایی محیط نیست. برای تصمیمگیری، اجزایی مانند نمایش کنش، هدف، برنامهریز و ارزیابی نتیجه نیز اهمیت دارند.
آیا JEPA جایگزین مدلهای زبانی است؟
JEPAرا نباید نام یک جایگزین آماده برای همه مدلهای زبانی دانست.
یک رمزگذار ویدئویی و یک مدل زبانی گفتوگویی وظایف متفاوتی دارند:
- رمزگذار ویدئو، نمایش عددی از محتوای بصری میسازد.
- مدل زبانی، متن را پردازش و تولید میکند.
برای پاسخگویی متنی درباره ویدئو، ممکن است لازم باشد نمایش بصری به یک مدل زبانی متصل و هماهنگ شود. مقاله V-JEPA 2 نیز نتایج پرسشوپاسخ ویدئویی را پس از همترازی با مدل زبانی گزارش میکند. arxiv.org
این همترازی یک مرحله واقعی طراحی و آموزش است؛ یک بردار ویژگی خام، مستقیماً معادل ورودی متنی API نیست.
آیا JEPA واقعیت فیزیکی را کاملاً میفهمد؟
عبارتهایی مانند «فهم جهان» باید با معیارهای آزمایش تفسیر شوند.
تشخیص عمل، پیشبینی عمل بعدی، پاسخ به پرسش و برنامهریزی، مسائل یکسانی نیستند.
برای مثال:
- تشخیص اینکه کسی لیوانی را جابهجا میکند، یک مسئله است.
- تخمین حرکت بعدی، مسئله دیگری است.
- محاسبه نتیجه برخورد دو جسم، مسئلهای متفاوت است.
- انتخاب حرکت مناسب برای یک ربات، مسئله چهارم است.
Meta همراه معرفی V-JEPA 2،آزمونهایی برای استدلال فیزیکی ارائه کرد و به فاصله عملکرد مدلها با انسان در آنها اشاره داشت. بنابراین نتایج پژوهش را باید همراه محدودیتهای آن خواند. ai.meta.com
کاربردهای بالقوهJEPA
کاربردهای زیر، مسیرهای پیشنهادی برای آزمایش نمایشهای یادگرفتهشده هستند و موفقیت آنها به ارزیابی دامنه نیاز دارد.
طبقهبندی ویدئو
نمایش یک قطعه ویدئو میتواند ورودی یک طبقهبند برای تشخیص نوع فعالیت باشد.
جستوجوی ویدئوهای مشابه
با ساخت بردار برای هر قطعه، میتوان شباهت نمایشها را بررسی کرد. نزدیکی بردارها باید با مفهوم شباهت موردنیاز محصول مقایسه شود.
تحلیل فرایندهای صنعتی
میتوان بررسی کرد آیا نمایشها به تشخیص مرحله یک فرایند یا تفاوت الگوهای حرکت کمک میکنند.
تحلیل ویدئوهای آموزشی
یک پروژه میتواند توانایی مدل در تفکیک مراحل انجام یک کار را آزمایش کند.
رباتیک
مدلهای شرطیشده بر کنش میتوانند در پژوهش درباره تخمین نتیجه کنش و برنامهریزی بررسی شوند.
برای هر کاربرد، ابتدا یک وظیفه محدود و معیار روشن تعریف کنید.
استخراج ویژگی ویدئو با V-JEPA 2 وPython
در مثال زیر، یک ویدئوی محلی را به مدل میدهیم و نمایش خروجی رمزگذار را دریافت میکنیم.
این مثال:
- مدل را از ابتدا آموزش نمیدهد.
- توضیح فارسی تولید نمیکند.
- عمل رباتیک پیشنهاد نمیدهد.
- ویژگی ویدئو را برای آزمایشهای بعدی استخراج میکند.
مستندات رسمی Transformers، استفاده از AutoVideoProcessor و AutoModel را برای استخراج ویژگی این مدل نشان میدهد. Hugging Face
نصب کتابخانهها
نسخه سازگار PyTorch را متناسب با سیستم و CUDA نصب کنید. سپس:
pip install -U transformers opencv-python numpyخواندن فریمهای یک قطعه ویدئو
برای این مثال، از چند ثانیه ابتدایی ویدئو ۶۴ فریم نمونهبرداری میکنیم.
import cv2import numpy as npdef read_video_clip( path: str, num_frames: int = 64, clip_seconds: float = 4.0,) -> np.ndarray: capture = cv2.VideoCapture(path) if not capture.isOpened(): raise ValueError("Cannot open the video.") try: total_frames = int( capture.get(cv2.CAP_PROP_FRAME_COUNT) ) fps = float( capture.get(cv2.CAP_PROP_FPS) ) if total_frames < 1 or fps <= 0: raise ValueError( "Invalid frame count or frame rate." ) clip_frame_count = min( total_frames,انتخاب چهار ثانیه و نمونهبرداری یکنواخت، تصمیم آموزشی این مثال است. برای کاربرد واقعی، مدت قطعه و فاصله فریمها را متناسب با حرکت موردنظر و تنظیمات مدل انتخاب کنید.
اگر قطعه کمتر از ۶۴ فریم داشته باشد، بعضی فریمها تکرار میشوند. این رفتار، اطلاعات زمانی تازهای ایجاد نمیکند.
بارگذاری مدل و دریافت ویژگی
import torchfrom transformers import ( AutoModel, AutoVideoProcessor,)MODEL_ID = "facebook/vjepa2-vitl-fpc64-256"device = torch.device( "cuda" if torch.cuda.is_available() else "cpu")processor = AutoVideoProcessor.from_pretrained( MODEL_ID)model = AutoModel.from_pretrained( MODEL_ID).to(device)model.eval()frames = read_video_clip( "sample.mp4", num_frames=64, clip_seconds=4.0,)# Convert T x H x W x C to T x C x H x W.video_tensor = torch.from_numpy( frames).permute(0, 3, 1, 2)inputs = processor(شناسه استفادهشده، Checkpoint رسمی استخراج ویژگی V-JEPA 2 است. جزئیات مدل و پیشپردازش را از کارت آن بررسی کنید. Hugging Face
این کد در محیط نگارش مقاله اجرا نشده است. زمان اجرا و حافظه موردنیاز به دستگاه و نسخه کتابخانهها وابسته است.
تبدیل ویژگیها به یک بردار ساده
برای بعضی آزمایشها، به یک بردار برای کل قطعه نیاز داریم.
میانگینگیری روی نمایش توکنها، یک Baseline ساده است:
import torch.nn.functional as Fwith torch.inference_mode(): clip_vector = features.mean(dim=1) clip_vector = F.normalize( clip_vector, p=2, dim=-1, )print("Clip vector shape:", clip_vector.shape)torch.save( clip_vector.cpu(), "sample-clip-vector.pt",)این روش پیشنهادی، معادل یک Head تخصصی آموزشدیده نیست. میانگینگیری ممکن است اطلاعات مربوط به ترتیب، موقعیت و رویدادهای کوتاه را کمرنگ کند.
قبل از استفاده عملی، آن را با روشهای مناسبتر تجمیع ویژگی مقایسه کنید.
چگونه یک کاربرد واقعی را ارزیابی کنیم؟
فرض کنید هدف، تشخیص سه مرحله از یک فرایند است.
یک مسیر آزمایشی مناسب میتواند چنین باشد:
- قطعههای ویدئو را با تعریف زمانی مشخص آماده کنید.
- ویژگی هر قطعه را استخراج کنید.
- یک طبقهبند ساده روی ویژگیهای آموزش بسازید.
- تنظیمات را با مجموعه اعتبارسنجی انتخاب کنید.
- عملکرد نهایی را روی داده آزمایش گزارش کنید.
تفکیک داده در سطح ویدئوی اصلی
قطعههای نزدیک از یک ویدئو میتوانند بسیار شبیه باشند. قرارگرفتن بعضی از آنها در Train و بعضی در Test ممکن است نتیجه را خوشبینانه کند.
بررسی تغییر شرایط
عملکرد را روی دوربین، نور، زاویه و محیط متفاوت بسنجید.
مقایسه باBaseline
استخراج ویژگی یک تصویر، مدل ویدئویی دیگر و حتی ویژگیهای ساده حرکت میتوانند نقطه مقایسه باشند.
گزارش معیار هر کلاس
دقت کلی ممکن است ضعف روی مرحلهای کمتعداد را پنهان کند.
این موارد، پیشنهادهای طراحی آزمایشاند؛ ادعایی درباره نتیجه قطعی JEPA در فرایند شما نیستند.
محدودیتها و اشتباهات رایج
فرض اینکه هر بردار JEPA با متن قابلمقایسه است
نمایش ویدئویی الزاماً در فضای مشترک با متن قرار ندارد. جستوجوی ویدئو با جمله فارسی به مدل یا روش هماهنگسازی مناسب نیاز دارد.
استفاده از مدل پایه بهعنوان طبقهبند آماده
استخراج ویژگی، با دریافت برچسب نهایی تفاوت دارد. ممکن است به Head یا طبقهبند آموزشدیده نیاز داشته باشید.
نادیدهگرفتن نمونهبرداری زمانی
دو ویدئو با محتوای مشابه، اگر با سیاستهای متفاوت نمونهبرداری شوند، ورودیهای قابلمقایسهای نخواهند داشت.
فرض تضمین عدم فروپاشی نمایش
پایینبودن خطای پیشبینی بهتنهایی مفیدبودن ویژگیها را ثابت نمیکند. در آموزش از ابتدا باید تنوع نمایش و عملکرد پاییندستی نیز بررسی شود.
نتیجهگیری از یکBenchmark
موفقیت در تشخیص عمل، بهتنهایی توانایی برنامهریزی یا استدلال فیزیکی کامل را نشان نمیدهد.
آموزش از ابتدا بدون بررسی مدل آماده
برای یک پروژه محدود، شروع با ویژگیهای مدل آماده میتواند آزمایش اولیه را سادهتر کند. پس از اندازهگیری عملکرد، درباره ادامه آموزش تصمیم بگیرید.
ارتباط تحلیل ویدئو با خدمات درواره
یک محصول تحلیل ویدئو معمولاً فقط به استخراج بردار نیاز ندارد. ممکن است بخواهد:
- نتیجه تشخیص را به فارسی توضیح دهد.
- رویدادها را در یک گزارش خلاصه کند.
- خروجی را برای کاربر غیرمتخصص قابلفهم کند.
- اطلاعات تشخیصدادهشده را در قالب موردنیاز برنامه ارائه دهد.
یک طراحی پیشنهادی این است که ماژول بصری، ابتدا رویدادها یا برچسبهای قابلاعتماد را استخراج کند و سپس مدل زبانی گزارش آنها را بنویسد.
در این مسیر، مدل زبانی دادهای را دریافت میکند که ماژول تحلیل تولید کرده است؛ ارسال مستقیم بردار خام JEPA به Chat API معنای مشخصی ندارد.
نمونه تولید گزارش با API درواره
pip install openaiimport json
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
# Example data produced by a separate analysis module.
events = [
{
"start_seconds": 0,
"end_seconds": 3,
"label": "برداشتن قطعه",
},
{
"start_seconds": 3,
"end_seconds": 7,
"label": "قرار دادن قطعه روی میز",
},
]
response = client.chat.completions.create(
model=os.environ["DARVAREH_CHAT_MODEL"],
messages=[
{
"role": "user",
"content": (
"بر اساس رویدادهای زیر یک گزارش "
"کوتاه فارسی بنویس. "
"جزئیات مشاهدهنشده اضافه نکن.\n\n"
+ json.dumps(
events,
ensure_ascii=False,
)
),
},
],
)
print(response.choices[0].message.content)داده رویدادهای این مثال دستی و فرضی است؛ کد استخراج ویژگی قبلی بهتنهایی این برچسبها را تولید نمیکند.
مدل در دسترس و قابلیتهای آن را از مستندات درواره بررسی کنید. این مثال نیز به معنای ارائه مستقیم V-JEPA در API درواره نیست.
پرسشهای متداول
JEPAچیست؟
معماریای برای پیشبینی نمایش ویژگی هدف از اطلاعات زمینه است، بهجای اینکه الزاماً داده خام را بازسازی کند.
I-JEPA و V-JEPAچه تفاوتی دارند؟
I-JEPA برای تصویر معرفی شده است. V-JEPAاین رویکرد را برای یادگیری نمایشهای ویدئویی به کار میبرد.
آیا JEPA تصویر تولید میکند؟
هدف اصلی نمونههای بررسیشده، تولید تصویر نیست. تبدیل نمایشها به تصویر به اجزای دیگری نیاز دارد.
آیا V-JEPA فقط آینده را پیشبینی میکند؟
خیر. هدف پیشبینی میتواند بخشهای پوشاندهشده مکانی یا زمانی باشد و الزاماً فقط آینده نیست.
آیا JEPA بدون برچسب آموزش میبیند؟
مرحله خودنظارتی میتواند بدون برچسب انسانی هر نمونه انجام شود. کارهای نهایی و ارزیابی ممکن است برچسب بخواهند.
آیا JEPA جایگزین LLM است؟
این دو میتوانند نقشهای متفاوت و مکمل داشته باشند. یک رمزگذار ویدئویی مستقل، چتبات متنی نیست.
آیا هر مدل JEPA یک مدل جهان کامل است؟
خیر. مدلسازی کنش، پویایی و برنامهریزی به طراحی و آموزش متناسب نیاز دارد.
آیا میتوان ویدئو را با V-JEPA به متن تبدیل کرد؟
استخراج ویژگی بهتنهایی متن تولید نمیکند. به طبقهبند، مدل زبانی هماهنگشده یا اجزای تکمیلی نیاز دارید.
آیا ویژگیهای آن برای ویدئوهای صنعتی مناسباند؟
این موضوع باید با داده و معیار همان محیط بررسی شود؛ نتیجه دیتاست عمومی کافی نیست.
جمعبندی
JEPA هدف یادگیری را از بازسازی مستقیم داده خام به پیشبینی در فضای ویژگی منتقل میکند. I-JEPA این ایده را برای تصویر و V-JEPAبرای ویدئو بررسی کردهاند.
V-JEPA 2و نسخه شرطیشده بر کنش آن، مسیرهایی برای مطالعه نمایشهای بصری و برنامهریزی در محیط فیزیکی ارائه میکنند. بااینحال، استخراج ویژگی، تشخیص رویداد، تولید گزارش و کنترل ربات چهار قابلیت متفاوتاند و هرکدام به اجزای مناسب نیاز دارند.
برای یک محصول عملی، ابتدا وظیفه محدود، داده مناسب و معیار ارزیابی تعریف کنید. سپس نمایشهای مدل آماده را با Baseline مقایسه کنید و درباره آموزش بیشتر تصمیم بگیرید.
اگر میخواهید نتایج تحلیل تصویری را به گزارش فارسی، پاسخ متنی یا یک قابلیت کاربردی در نرمافزار خود تبدیل کنید، از درواره شروع کنید و مدل زبانی مناسب را از طریق API یکپارچه به محصولتان متصل کنید.
مقالات مرتبط
- مدل جهان و هوش فضایی چیست؟
- بینایی ماشین چیست؟
- هوش مصنوعی چندوجهی چیست؟
- آموزش Autoencoder وVAE
- Embeddingچیست؟
- پردازش تصویر و ویدئو باOpenCV
- ارسال تصویر به API مدلهای بینایی
منابع
- Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture
- مخزن رسمیI-JEPA
- Masked Autoencoders Are Scalable Vision Learners
- Revisiting Feature Prediction for Learning Visual Representations from Video
- مخزن رسمیV-JEPA
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning
- معرفی رسمی V-JEPA 2 و آزمونهای استدلال فیزیکی
- مستندات رسمی Transformers برایV-JEPA 2
- کارت رسمی مدلV-JEPA 2 ViT-L
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدلها و ابزارها و صفحه سلب مسئولیت را مطالعه کنید.



