
Autoencoder چیست؟ آموزش خودرمزگذار، تشخیص ناهنجاری و VAE با PyTorch
Autoencoder چیست و چگونه داده را فشرده، بازسازی و پاکسازی میکند؟ در این آموزش، خودرمزگذار، Denoising Autoencoder و VAE را میشناسید و یک مدل واقعی تشخیص ناهنجاری را با PyTorch پیادهسازی میکنید.

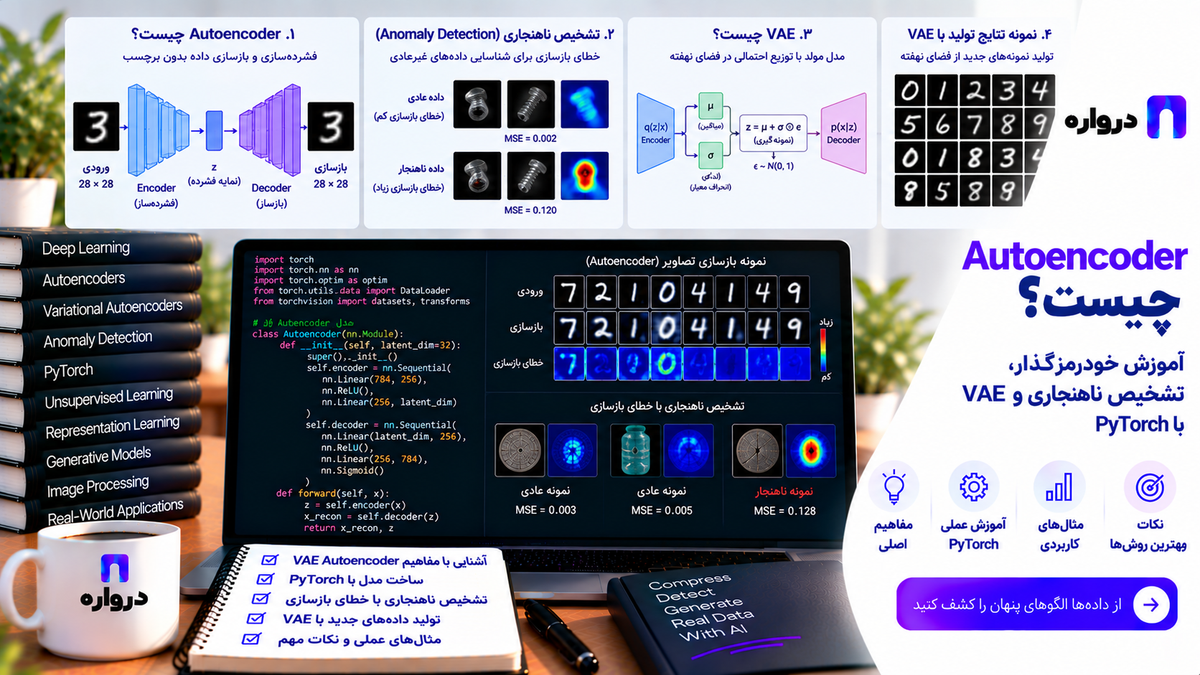
Autoencoder یا خودرمزگذار نوعی شبکه عصبی است که یاد میگیرد ورودی را به یک نمایش فشرده تبدیل و سپس همان ورودی را بازسازی کند.
برخلاف مدلهای طبقهبندی، Autoencoder برای آموزش الزاماً به برچسب نیاز ندارد. ورودی مدل نقش هدف خروجی را نیز ایفا میکند. برای مثال، یک تصویر وارد شبکه میشود و مدل تلاش میکند نسخهای نزدیک به همان تصویر را در خروجی بسازد.
اگر معماری بهدرستی طراحی شده باشد، مدل نمیتواند صرفاً داده را کپی کند. بخش میانی شبکه ظرفیت محدودی دارد و مدل را مجبور میکند ویژگیهای مهم ورودی را در یک نمایش فشرده یاد بگیرد.
Autoencoder در کاربردهای زیر استفاده میشود:
- کاهش ابعاد داده
- حذف نویز تصویر و سیگنال
- تشخیص ناهنجاری
- استخراج ویژگی
- فشردهسازی داده
- بازسازی بخشهای ازدسترفته
- یادگیری بدون نظارت
- ساخت فضای نهفته
- پیشآموزش شبکههای عصبی
- مدلهای مولد مانند VAE
در این مقاله، ساختار Autoencoder و انواع آن را بررسی میکنیم و سپس با PyTorch یک خودرمزگذار کانولوشنی برای بازسازی تصویر، حذف نویز و تشخیص ناهنجاری میسازیم.
Autoencoder چیست؟
Autoencoder شبکهای است که ورودی را به یک نمایش داخلی فشرده تبدیل و سپس از همان نمایش، ورودی را بازسازی میکند.
این مدل سه بخش اصلی دارد:
- Encoder یا رمزگذار
- Latent Space یا فضای نهفته
- Decoder یا رمزگشا
مسیر پردازش به شکل زیر است:
داده ورودی
↓
Encoder
↓
نمایش فشرده در فضای نهفته
↓
Decoder
↓
داده بازسازیشدههدف آموزش این است که خروجی بازسازیشده تا حد ممکن به ورودی اصلی نزدیک باشد.
مستندات Google توضیح میدهد که وقتی لایههای پنهان Autoencoder از ورودی کوچکتر باشند، مدل مجبور میشود یک نمایش فشرده از ویژگیهای اصلی داده یاد بگیرد.
Encoder چیست؟
Encoder داده اصلی را دریافت و آن را به یک نمایش کوچکتر تبدیل میکند.
برای مثال، یک تصویر ۲۸ در ۲۸ پیکسل شامل ۷۸۴ مقدار است. Encoder میتواند این اطلاعات را به یک بردار ۳۲ یا ۶۴ عنصری تبدیل کند.
هدف فقط کاهش تعداد مقدارها نیست. Encoder باید اطلاعاتی را نگه دارد که برای بازسازی ورودی اهمیت دارند.
در تصاویر، این اطلاعات ممکن است شامل موارد زیر باشند:
- لبهها
- شکل کلی
- بافت
- جهت قرارگیری شیء
- بخشهای روشن و تاریک
- ساختارهای تکرارشونده
فضای نهفته چیست؟
فضای نهفته یا Latent Space نمایش فشردهای است که Encoder تولید میکند.
هر نمونه در این فضا با یک بردار نمایش داده میشود. اگر مدل خوب آموزش دیده باشد، نمونههای مشابه ممکن است نمایشهای نزدیکتری داشته باشند.
برای مثال، در دیتاست پوشاک، تصاویر کفشها ممکن است در بخش مشابهی از فضای نهفته قرار بگیرند و تصاویر کیفها در ناحیهای دیگر دیده شوند؛ حتی اگر مدل هنگام آموزش برچسب این کلاسها را دریافت نکرده باشد.
فضای نهفته در کاربردهای زیر مفید است:
- خوشهبندی
- جستوجوی نمونه مشابه
- نمایش دوبعدی داده
- کاهش ابعاد
- تشخیص ناهنجاری
- استفاده بهعنوان ورودی مدل دیگر
- تولید نمونه جدید در مدلهای احتمالاتی
Decoder چیست؟
Decoder نمایش فشرده را دریافت و تلاش میکند داده اصلی را بازسازی کند.
ساختار Decoder معمولاً معکوس تقریبی Encoder است. اگر Encoder ابعاد تصویر را کاهش دهد، Decoder آنها را دوباره افزایش میدهد.
در مدل تصویری میتوان از لایههایی مانند موارد زیر استفاده کرد:
LinearConv2dConvTranspose2d- Upsampling
- Batch Normalization
- ReLU
- Sigmoid یا Tanh
انتخاب فعالساز خروجی باید با محدوده داده ورودی هماهنگ باشد. اگر مقدار پیکسلها بین صفر و یک قرار دارند، Sigmoid انتخاب رایجی برای خروجی Decoder است.
Autoencoder چگونه آموزش داده میشود؟
در آموزش نظارتشده معمولاً ورودی و برچسب جدا هستند:
تصویر → کلاس تصویردر Autoencoder، ورودی و هدف یکساناند:
تصویر → همان تصویرمدل یک نسخه بازسازیشده تولید میکند و تابع Loss تفاوت آن را با ورودی اصلی اندازه میگیرد.
توابع Loss رایج عبارتاند از:
- Mean Squared Error برای دادههای پیوسته
- L1 Loss برای کاهش حساسیت به بعضی خطاهای بزرگ
- Binary Cross Entropy برای دادههایی با مقادیر مناسب این تابع
- ترکیبی از Loss پیکسلی و Loss ادراکی در پروژههای تصویری پیشرفته
مدل از طریق پسانتشار وزنهای Encoder و Decoder را اصلاح میکند.
آیا Autoencoder فقط ورودی را کپی میکند؟
اگر شبکه ظرفیت بسیار زیادی داشته باشد، احتمال دارد به یک تابع کپی پیچیده تبدیل شود و نمایش مفیدی یاد نگیرد.
برای جلوگیری از این مشکل از محدودیتهایی مانند موارد زیر استفاده میشود:
- فضای نهفته کوچک
- شبکه کمظرفیتتر
- اضافهکردن نویز به ورودی
- اعمال Sparsity
- Dropout
- Weight Decay
- محدودیت احتمالاتی در VAE
- استفاده از داده آموزشی متنوع
- ارزیابی روی دادهای که مدل ندیده است
بازسازی خوب بهتنهایی ثابت نمیکند فضای نهفته مفید است. نمایشهای یادگرفتهشده باید در وظیفه واقعی نیز ارزیابی شوند.
انواع Autoencoder
Undercomplete Autoencoder
در این مدل، فضای نهفته کوچکتر از ورودی است. محدودیت ظرفیت باعث میشود شبکه ویژگیهای مهمتر را نگه دارد.
این نوع Autoencoder برای یادگیری نمایش فشرده و کاهش ابعاد استفاده میشود.
Sparse Autoencoder
در Sparse Autoencoder ممکن است فضای نهفته بزرگ باشد، اما مدل تشویق میشود فقط تعداد محدودی از واحدها را برای هر ورودی فعال کند.
هدف این است که ویژگیها بهصورت پراکنده و تخصصی نمایش داده شوند.
Denoising Autoencoder
در این معماری، ورودی نویزی و هدف خروجی تمیز است.
تصویر نویزی → Autoencoder → تصویر تمیزمدل نمیتواند تنها پیکسلهای ورودی را کپی کند؛ زیرا باید ساختار اصلی تصویر را از میان نویز بازیابی کند.
Convolutional Autoencoder
برای تصاویر، استفاده از لایههای کانولوشنی معمولاً بهتر از تبدیل مستقیم تمام پیکسلها به یک بردار است.
Convolutional Autoencoder ساختار مکانی تصویر را حفظ میکند و ویژگیهایی مانند لبه و بافت را بهتر استخراج میکند.
Contractive Autoencoder
این مدل تلاش میکند نمایش فضای نهفته نسبت به تغییرات کوچک ورودی حساسیت کمتری داشته باشد.
Variational Autoencoder
VAE یا Variational Autoencoder فضای نهفته را بهصورت احتمالاتی مدل میکند. این ویژگی امکان نمونهبرداری و تولید داده جدید را فراهم میکند.
Sequence Autoencoder
برای متن، صوت یا سری زمانی میتوان Encoder و Decoder را با LSTM، GRU یا Transformer ساخت.
تفاوت Autoencoder و PCA
PCA یک روش خطی برای کاهش ابعاد است. Autoencoder میتواند روابط غیرخطی پیچیدهتری را یاد بگیرد.
| معیار | PCA | Autoencoder |
|---|---|---|
| نوع تبدیل | خطی | خطی یا غیرخطی |
| سرعت آموزش | بالا | کمتر |
| نیاز به GPU | معمولاً ندارد | برای مدل بزرگ مفید است |
| تفسیرپذیری | بیشتر | کمتر |
| داده پیچیده | محدودتر | انعطافپذیرتر |
| تنظیم معماری | ندارد | ضروری است |
| خطر بیشبرازش | کمتر | بیشتر |
| مناسب برای Baseline | بسیار مناسب | مرحله بعدی آزمایش |
همیشه Autoencoder بهتر از PCA نیست. برای داده جدولی کوچک، PCA ممکن است سادهتر، سریعتر و حتی دقیقتر باشد.
بهتر است ابتدا یک Baseline با PCA بسازید و سپس بررسی کنید Autoencoder بهبود قابلتوجهی ایجاد میکند یا خیر.
تفاوت Autoencoder و مدلهای فشردهسازی معمولی
ابزارهای فشردهسازی مانند JPEG برای طیف گستردهای از تصاویر طراحی شدهاند. Autoencoder میتواند برای یک نوع داده مشخص آموزش ببیند.
برای مثال، یک Autoencoder اختصاصی ممکن است فقط برای تصاویر قطعات صنعتی یا اسناد اسکنشده بهینه شود.
بااینحال، استفاده از Autoencoder برای فشردهسازی عملی محدودیتهایی دارد:
- Decoder باید در مقصد در دسترس باشد.
- تغییر دیتاست ممکن است کیفیت را کاهش دهد.
- آموزش مدل هزینه دارد.
- مقایسه باید با استانداردهای فشردهسازی قوی انجام شود.
- خطای بازسازی ممکن است برای بعضی کاربردها قابلقبول نباشد.
تفاوت Autoencoder، VAE، GAN و Diffusion
| ویژگی | Autoencoder | VAE | GAN | Diffusion |
|---|---|---|---|---|
| هدف اصلی | بازسازی و نمایش فشرده | فضای نهفته احتمالاتی و تولید | تولید داده واقعینما | تولید داده با حذف تدریجی نویز |
| Encoder | دارد | دارد | معمولاً ندارد | به معماری وابسته است |
| Decoder یا Generator | دارد | دارد | دارد | شبکه حذف نویز دارد |
| آموزش رقابتی | ندارد | ندارد | دارد | ندارد |
| تولید نمونه جدید | محدود | بله | بله | بله |
| پایداری آموزش | معمولاً مناسب | نسبتاً مناسب | حساستر | معمولاً پایدارتر |
| کیفیت بازسازی | بالا | ممکن است نرمتر باشد | هدف اصلی نیست | به معماری وابسته است |
| تشخیص ناهنجاری | رایج | امکانپذیر | کمتر رایج | امکانپذیر اما پرهزینهتر |
آموزش عملی Convolutional Autoencoder با PyTorch
در این مثال از دیتاست Fashion-MNIST استفاده میکنیم. این دیتاست شامل تصاویر خاکستری پوشاک در ابعاد ۲۸ در ۲۸ پیکسل است.
ابتدا کتابخانهها را نصب کنید:
pip install torch torchvision matplotlibبارگذاری دیتاست
import torch
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


BATCH_SIZE = 128

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

transform = transforms.ToTensor()

train_dataset = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=transform,
)

test_dataset = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=transform,
)

train_loader = DataLoader(
    train_dataset,
    batch_size=BATCH_SIZE,
    shuffle=True,
    num_workers=2,
    pin_memory=torch.cuda.is_available(),
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
    num_workers=2,
    pin_memory=torch.cuda.is_available(),
)

print(f"Device: {device}")
print(f"Train samples: {len(train_dataset)}")
print(f"Test samples: {len(test_dataset)}")
داده با ToTensor به Tensor تبدیل میشود و مقدار پیکسلها در محدوده سازگار با خروجی Sigmoid قرار میگیرد.
مستندات رسمی PyTorch نیز Dataset را برای نگهداری نمونهها و DataLoader را برای ساخت جریان Batchهای داده معرفی میکند.
ساخت Convolutional Autoencoder
from torch import nn


class ConvolutionalAutoencoder(nn.Module):
    def __init__(self, latent_size: int = 64):
        super().__init__()

        self.encoder = nn.Sequential(
            nn.Conv2d(
                in_channels=1,
                out_channels=16,
                kernel_size=3,
                stride=2,
                padding=1,
            ),
            nn.ReLU(),

            nn.Conv2d(
                in_channels=16,
                out_channels=32,
                kernel_size=3,
                stride=2,
                padding=1,
            ),
            nn.ReLU(),

            nn.Flatten(),
            nn.Linear(32 * 7 * 7, latent_size),
        )

        self.decoder_input = nn.Sequential(
            nn.Linear(latent_size, 32 * 7 * 7),
            nn.ReLU(),
        )

        self.decoder = nn.Sequential(
            nn.Unflatten(
                dim=1,
                unflattened_size=(32, 7, 7),
            ),

            nn.ConvTranspose2d(
                in_channels=32,
                out_channels=16,
                kernel_size=4,
                stride=2,
                padding=1,
            ),
            nn.ReLU(),

            nn.ConvTranspose2d(
                in_channels=16,
                out_channels=1,
                kernel_size=4,
                stride=2,
                padding=1,
            ),
            nn.Sigmoid(),
        )

    def encode(
        self,
        images: torch.Tensor,
    ) -> torch.Tensor:
        return self.encoder(images)

    def decode(
        self,
        latent_vectors: torch.Tensor,
    ) -> torch.Tensor:
        features = self.decoder_input(latent_vectors)
        return self.decoder(features)

    def forward(
        self,
        images: torch.Tensor,
    ) -> torch.Tensor:
        latent_vectors = self.encode(images)
        return self.decode(latent_vectors)
Encoder ابعاد تصویر را ابتدا از ۲۸ به ۱۴ و سپس به ۷ کاهش میدهد. ویژگیهای خروجی در نهایت به یک بردار نهفته تبدیل میشوند.
Decoder همین مسیر را بهصورت تقریبی معکوس میکند و تصویر را دوباره به ابعاد اصلی بازمیگرداند.
آموزش Autoencoder
model = ConvolutionalAutoencoder(
    latent_size=64,
).to(device)

criterion = nn.MSELoss()

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.0001,
)

EPOCHS = 15

for epoch in range(EPOCHS):
    model.train()

    total_loss = 0.0
    total_samples = 0

    for images, _ in train_loader:
        images = images.to(device)

        optimizer.zero_grad()

        reconstructed = model(images)
        loss = criterion(reconstructed, images)

        loss.backward()
        optimizer.step()

        total_loss += loss.item() * images.size(0)
        total_samples += images.size(0)

    average_loss = total_loss / total_samples

    print(
        f"Epoch [{epoch + 1}/{EPOCHS}] "
        f"Loss: {average_loss:.6f}"
    )
برچسب تصاویر در حلقه آموزش استفاده نمیشود. مدل فقط تصویر را دریافت میکند و تلاش میکند همان تصویر را بازسازی کند.
ارزیابی مدل روی داده Test
def evaluate_autoencoder(
    model,
    data_loader,
    criterion,
    device,
):
    model.eval()

    total_loss = 0.0
    total_samples = 0

    with torch.inference_mode():
        for images, _ in data_loader:
            images = images.to(device)

            reconstructed = model(images)
            loss = criterion(
                reconstructed,
                images,
            )

            total_loss += (
                loss.item() * images.size(0)
            )
            total_samples += images.size(0)

    return total_loss / total_samples


test_loss = evaluate_autoencoder(
    model,
    test_loader,
    criterion,
    device,
)

print(f"Test reconstruction loss: {test_loss:.6f}")
مقایسه Loss آموزش و Test به شناسایی بیشبرازش کمک میکند، اما برای ارزیابی کامل باید تصاویر بازسازیشده را نیز مشاهده کنید.
نمایش تصاویر اصلی و بازسازیشده
import matplotlib.pyplot as plt


model.eval()

images, _ = next(iter(test_loader))
images = images[:10].to(device)

with torch.inference_mode():
    reconstructed = model(images)

images = images.cpu()
reconstructed = reconstructed.cpu()

figure, axes = plt.subplots(
    2,
    10,
    figsize=(15, 3),
)

for index in range(10):
    axes[0, index].imshow(
        images[index].squeeze(),
        cmap="gray",
    )
    axes[0, index].axis("off")

    axes[1, index].imshow(
        reconstructed[index].squeeze(),
        cmap="gray",
    )
    axes[1, index].axis("off")

axes[0, 0].set_ylabel("Original")
axes[1, 0].set_ylabel("Reconstructed")

plt.tight_layout()
plt.show()
موارد زیر را بررسی کنید:
- آیا شکل کلی شیء حفظ شده است؟
- آیا لبهها بیشازحد محو شدهاند؟
- آیا Decoder جزئیات مهم را از دست داده است؟
- آیا بعضی کلاسها بهتر از بقیه بازسازی میشوند؟
- آیا مدل روی تصاویر Test عملکردی نزدیک به Train دارد؟
استخراج ویژگی با Encoder
پس از آموزش میتوان فقط از Encoder برای تبدیل تصاویر به بردار استفاده کرد:
model.eval()

images, labels = next(iter(test_loader))
images = images.to(device)

with torch.inference_mode():
    embeddings = model.encode(images)

print(embeddings.shape)
اگر Batch شامل ۱۲۸ تصویر و اندازه فضای نهفته ۶۴ باشد، خروجی شامل ۱۲۸ بردار ۶۴بعدی خواهد بود.
از این بردارها میتوان برای موارد زیر استفاده کرد:
- خوشهبندی
- جستوجوی تصاویر مشابه
- نمایش دوبعدی با UMAP یا t-SNE
- ورودی یک طبقهبند سبک
- تشخیص نمونههای دور از توزیع
- مقایسه ویژگیهای تصاویر
ساخت Denoising Autoencoder
برای حذف نویز، هنگام آموزش به ورودی نویز اضافه میکنیم، اما هدف همچنان تصویر تمیز باقی میماند.
def add_noise(
    images: torch.Tensor,
    noise_level: float = 0.3,
) -> torch.Tensor:
    noise = torch.randn_like(images) * noise_level
    noisy_images = images + noise

    return torch.clamp(
        noisy_images,
        min=0.0,
        max=1.0,
    )
حلقه آموزش:
denoising_model = ConvolutionalAutoencoder(
    latent_size=64,
).to(device)

optimizer = torch.optim.AdamW(
    denoising_model.parameters(),
    lr=0.001,
)

criterion = nn.MSELoss()

for epoch in range(15):
    denoising_model.train()

    total_loss = 0.0
    total_samples = 0

    for clean_images, _ in train_loader:
        clean_images = clean_images.to(device)

        noisy_images = add_noise(
            clean_images,
            noise_level=0.3,
        )

        optimizer.zero_grad()

        reconstructed = denoising_model(
            noisy_images
        )

        loss = criterion(
            reconstructed,
            clean_images,
        )

        loss.backward()
        optimizer.step()

        total_loss += (
            loss.item() * clean_images.size(0)
        )
        total_samples += clean_images.size(0)

    print(
        f"Epoch {epoch + 1:02d} | "
        f"Loss: {total_loss / total_samples:.6f}"
    )
مدل ورودی نویزی را میبیند، اما با تصویر تمیز مقایسه میشود. بنابراین باید ساختار اصلی تصویر را یاد بگیرد و نویز تصادفی را نادیده بگیرد.
ارزیابی حذف نویز
denoising_model.eval()

clean_images, _ = next(iter(test_loader))
clean_images = clean_images[:10].to(device)

noisy_images = add_noise(
    clean_images,
    noise_level=0.3,
)

with torch.inference_mode():
    restored_images = denoising_model(
        noisy_images
    )

clean_images = clean_images.cpu()
noisy_images = noisy_images.cpu()
restored_images = restored_images.cpu()

figure, axes = plt.subplots(
    3,
    10,
    figsize=(15, 5),
)

for index in range(10):
    axes[0, index].imshow(
        clean_images[index].squeeze(),
        cmap="gray",
    )
    axes[0, index].axis("off")

    axes[1, index].imshow(
        noisy_images[index].squeeze(),
        cmap="gray",
    )
    axes[1, index].axis("off")

    axes[2, index].imshow(
        restored_images[index].squeeze(),
        cmap="gray",
    )
    axes[2, index].axis("off")

axes[0, 0].set_ylabel("Clean")
axes[1, 0].set_ylabel("Noisy")
axes[2, 0].set_ylabel("Restored")

plt.tight_layout()
plt.show()
مدلی که فقط با یک نوع نویز آموزش دیده است ممکن است روی نویزهای دیگر عملکرد خوبی نداشته باشد. انواع نویز باید با شرایط واقعی کاربرد هماهنگ باشند.
تشخیص ناهنجاری با Autoencoder
یکی از کاربردهای مهم Autoencoder، تشخیص ناهنجاری یا Anomaly Detection است.
ایده اصلی این است:
- مدل فقط با نمونههای عادی آموزش میبیند.
- مدل بازسازی نمونههای عادی را یاد میگیرد.
- یک نمونه غیرعادی وارد مدل میشود.
- مدل در بازسازی آن با مشکل بیشتری مواجه میشود.
- خطای بازسازی بالا بهعنوان نشانه ناهنجاری استفاده میشود.
برای مثال، میتوان مدل را فقط با تصاویر یک نوع قطعه سالم آموزش داد. اگر تصویر قطعه معیوب وارد شود، ممکن است خطای بازسازی افزایش یابد.
ساخت دیتاست نمونههای عادی
در Fashion-MNIST کلاس شماره ۷ مربوط به کفش Sneaker است. برای مثال آموزشی، فقط این کلاس را عادی در نظر میگیریم.
from torch.utils.data import Subset, random_split


NORMAL_CLASS = 7

normal_indices = [
    index
    for index, label in enumerate(
        train_dataset.targets
    )
    if int(label) == NORMAL_CLASS
]

normal_dataset = Subset(
    train_dataset,
    normal_indices,
)

validation_size = int(
    len(normal_dataset) * 0.2
)

training_size = (
    len(normal_dataset) - validation_size
)

generator = torch.Generator().manual_seed(42)

normal_train_dataset, normal_validation_dataset = (
    random_split(
        normal_dataset,
        [training_size, validation_size],
        generator=generator,
    )
)

normal_train_loader = DataLoader(
    normal_train_dataset,
    batch_size=128,
    shuffle=True,
)

normal_validation_loader = DataLoader(
    normal_validation_dataset,
    batch_size=128,
    shuffle=False,
)
در پروژه واقعی، تعریف نمونه عادی باید بر اساس مسئله کسبوکار و بررسی متخصص دامنه انجام شود.
آموزش مدل تشخیص ناهنجاری
از همان معماری Autoencoder استفاده میکنیم:
anomaly_model = ConvolutionalAutoencoder(
    latent_size=32,
).to(device)

criterion = nn.MSELoss()

optimizer = torch.optim.AdamW(
    anomaly_model.parameters(),
    lr=0.001,
)

for epoch in range(15):
    anomaly_model.train()

    total_loss = 0.0
    total_samples = 0

    for images, _ in normal_train_loader:
        images = images.to(device)

        optimizer.zero_grad()

        reconstructed = anomaly_model(images)
        loss = criterion(reconstructed, images)

        loss.backward()
        optimizer.step()

        total_loss += loss.item() * images.size(0)
        total_samples += images.size(0)

    print(
        f"Epoch {epoch + 1:02d} | "
        f"Loss: {total_loss / total_samples:.6f}"
    )
محاسبه امتیاز ناهنجاری
خطای بازسازی هر نمونه را جداگانه محاسبه میکنیم:
def reconstruction_errors(
    model,
    data_loader,
    device,
):
    model.eval()

    errors = []
    labels = []

    with torch.inference_mode():
        for images, batch_labels in data_loader:
            images = images.to(device)

            reconstructed = model(images)

            batch_errors = torch.mean(
                (images - reconstructed) ** 2,
                dim=(1, 2, 3),
            )

            errors.extend(
                batch_errors.cpu().tolist()
            )

            labels.extend(
                batch_labels.tolist()
            )

    return errors, labels
تعیین آستانه ناهنجاری
آستانه را با استفاده از خطاهای مجموعه اعتبارسنجی عادی تعیین میکنیم:
import numpy as np


validation_errors, _ = reconstruction_errors(
    anomaly_model,
    normal_validation_loader,
    device,
)

threshold = float(
    np.quantile(
        validation_errors,
        0.95,
    )
)

print(f"Anomaly threshold: {threshold:.6f}")
در این مثال، پنج درصد نمونههای عادی دارای بالاترین خطا ممکن است ناهنجار تشخیص داده شوند. این فقط یک نقطه شروع است.
آستانه عملی باید بر اساس موارد زیر تنظیم شود:
- هزینه هشدار اشتباه
- هزینه ازدستدادن ناهنجاری واقعی
- ظرفیت تیم بررسی
- نرخ پایه ناهنجاری
- تغییرات داده در زمان
- Recall موردنیاز
- Precision موردانتظار
آزمایش روی کل دیتاست Test
all_test_errors, all_test_labels = (
    reconstruction_errors(
        anomaly_model,
        test_loader,
        device,
    )
)

predicted_anomalies = [
    error > threshold
    for error in all_test_errors
]

true_anomalies = [
    label != NORMAL_CLASS
    for label in all_test_labels
]
محاسبه معیارها:
from sklearn.metrics import classification_report


print(
    classification_report(
        true_anomalies,
        predicted_anomalies,
        target_names=["عادی", "ناهنجار"],
        digits=4,
    )
)
این مثال فقط برای آموزش مفهوم است. تفاوت کلاسهای Fashion-MNIST بسیار آشکار است و نتیجه آن نباید بهعنوان اثبات کارایی مدل در داده صنعتی در نظر گرفته شود.
محدودیت تشخیص ناهنجاری با Autoencoder
فرض رایج این است که مدل نمونه غیرعادی را بدتر بازسازی میکند، اما این فرض همیشه درست نیست.
یک Autoencoder با ظرفیت زیاد ممکن است نمونههای غیرعادی را نیز بهخوبی بازسازی کند. همچنین بعضی نمونههای عادی دشوار ممکن است خطای زیادی داشته باشند.
برای ارزیابی دقیق باید:
- نمونههای ناهنجار واقعی جمعآوری شوند.
- معیارها در چند آستانه بررسی شوند.
- دادههای مربوط به دورههای زمانی متفاوت آزمایش شوند.
- نرخ هشدار اشتباه پایش شود.
- مدل با روشهایی مانند Isolation Forest مقایسه شود.
- Drift داده بررسی شود.
- تصمیم نهایی فقط بر اساس Reconstruction Error نباشد.
Variational Autoencoder یا VAE چیست؟
VAE مخفف Variational Autoencoder است. این مدل مانند Autoencoder از Encoder و Decoder تشکیل میشود، اما فضای نهفته را به شکل یک توزیع احتمالاتی یاد میگیرد.
Encoder بهجای تولید مستقیم یک بردار قطعی، پارامترهایی را تولید میکند که ناحیه احتمالاتی هر ورودی را در فضای نهفته توصیف میکنند. سپس یک بردار از آن ناحیه نمونهبرداری و وارد Decoder میشود.
این ساختار باعث میشود فضای نهفته منظمتر و پیوستهتر باشد. در نتیجه میتوان از نقاط مختلف آن نمونه گرفت و دادههای جدید ساخت.
مقاله Auto-Encoding Variational Bayes روش آموزش این مدل را با استفاده از بازپارامتردهی و بهینهسازی گرادیانی معرفی کرد.
تفاوت Autoencoder معمولی و VAE
| ویژگی | Autoencoder | VAE |
|---|---|---|
| فضای نهفته | قطعی | احتمالاتی |
| هدف اصلی | بازسازی | بازسازی و منظمکردن فضای نهفته |
| تولید نمونه جدید | محدود | مناسبتر |
| وضوح بازسازی | معمولاً بیشتر | گاهی نرمتر |
| پیوستگی فضای نهفته | تضمینشده نیست | معمولاً منظمتر |
| تابع Loss | خطای بازسازی | بازسازی همراه با محدودیت توزیع |
| کاربرد اصلی | فشردهسازی و استخراج ویژگی | مدلسازی مولد و فضای نهفته |
Reparameterization Trick چیست؟
نمونهبرداری تصادفی مستقیم میتواند مسیر محاسبه گرادیان را مختل کند. VAE برای حل این مسئله از روشی به نام Reparameterization Trick استفاده میکند.
در این روش، بخش تصادفی از پارامترهای قابلآموزش جدا میشود. بنابراین PyTorch میتواند گرادیان را از Decoder به Encoder منتقل کند.
بدون این روش، آموزش انتهابهانتهای VAE با پسانتشار معمول دشوار خواهد بود.
ساخت VAE ساده با PyTorch
class VariationalAutoencoder(nn.Module):
    def __init__(
        self,
        latent_size: int = 20,
    ):
        super().__init__()

        self.encoder = nn.Sequential(
            nn.Flatten(),
            nn.Linear(28 * 28, 400),
            nn.ReLU(),
        )

        self.mean_layer = nn.Linear(
            400,
            latent_size,
        )

        self.log_variance_layer = nn.Linear(
            400,
            latent_size,
        )

        self.decoder = nn.Sequential(
            nn.Linear(latent_size, 400),
            nn.ReLU(),
            nn.Linear(400, 28 * 28),
            nn.Sigmoid(),
        )

    def encode(
        self,
        images: torch.Tensor,
    ):
        features = self.encoder(images)

        mean = self.mean_layer(features)
        log_variance = self.log_variance_layer(
            features
        )

        return mean, log_variance

    def reparameterize(
        self,
        mean: torch.Tensor,
        log_variance: torch.Tensor,
    ):
        standard_deviation = torch.exp(
            0.5 * log_variance
        )

        noise = torch.randn_like(
            standard_deviation
        )

        return mean + noise * standard_deviation

    def decode(
        self,
        latent_vectors: torch.Tensor,
    ):
        reconstructed = self.decoder(
            latent_vectors
        )

        return reconstructed.view(
            -1,
            1,
            28,
            28,
        )

    def forward(
        self,
        images: torch.Tensor,
    ):
        mean, log_variance = self.encode(images)

        latent_vectors = self.reparameterize(
            mean,
            log_variance,
        )

        reconstructed = self.decode(
            latent_vectors
        )

        return (
            reconstructed,
            mean,
            log_variance,
        )
تابع Loss در VAE
Loss شامل دو بخش است:
- خطای بازسازی تصویر
- محدودیتی برای منظمکردن فضای نهفته
def vae_loss(
    reconstructed,
    original,
    mean,
    log_variance,
):
    reconstruction_loss = nn.functional.binary_cross_entropy(
        reconstructed,
        original,
        reduction="sum",
    )

    regularization_loss = -0.5 * torch.sum(
        1
        + log_variance
        - mean.pow(2)
        - log_variance.exp()
    )

    return (
        reconstruction_loss
        + regularization_loss
    )
اگر وزن بخش منظمسازی بیشازحد زیاد باشد، کیفیت بازسازی ممکن است کاهش پیدا کند. اگر این بخش بسیار ضعیف باشد، فضای نهفته ویژگی مولد و پیوسته خود را از دست میدهد.
آموزش VAE
vae = VariationalAutoencoder(
    latent_size=20,
).to(device)

optimizer = torch.optim.Adam(
    vae.parameters(),
    lr=0.001,
)

for epoch in range(15):
    vae.train()

    total_loss = 0.0

    for images, _ in train_loader:
        images = images.to(device)

        optimizer.zero_grad()

        reconstructed, mean, log_variance = (
            vae(images)
        )

        loss = vae_loss(
            reconstructed,
            images,
            mean,
            log_variance,
        )

        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    average_loss = (
        total_loss / len(train_dataset)
    )

    print(
        f"Epoch {epoch + 1:02d} | "
        f"Loss: {average_loss:.4f}"
    )
نمونه رسمی Keras نیز یک Convolutional VAE را با دیتاست MNIST پیادهسازی میکند و ساختار Encoder، Sampling و Decoder را نشان میدهد.
تولید تصاویر جدید با VAE
پس از آموزش، میتوان بردارهای تصادفی از فضای نهفته ساخت و به Decoder داد:
vae.eval()

with torch.inference_mode():
    latent_vectors = torch.randn(
        16,
        20,
        device=device,
    )

    generated_images = vae.decode(
        latent_vectors
    ).cpu()
ذخیره خروجی:
from torchvision.utils import save_image


save_image(
    generated_images,
    "vae-generated-images.png",
    nrow=4,
)
برخلاف Autoencoder معمولی، فضای نهفته VAE برای نمونهبرداری منظمتر طراحی شده است.
نقش VAE در مدلهای Diffusion
در بعضی مدلهای Latent Diffusion، تصویر ابتدا توسط VAE به فضای نهفته منتقل میشود. فرایند Diffusion بهجای پیکسلهای کامل روی این نمایش فشرده اجرا میشود و سپس Decoder تصویر نهایی را بازسازی میکند.
این روش میتواند هزینه محاسباتی را نسبت به اجرای فرایند روی تصویر کامل کاهش دهد.
نمونه رسمی Fine-tuning مدل Stable Diffusion در Keras نیز VAE را بهعنوان بخشی معرفی میکند که تصویر را به فضای نهفته تصویری منتقل میکند و Decoder دوباره تصویر را میسازد.
بنابراین VAE فقط یک مدل آموزشی مستقل نیست و میتواند یکی از اجزای اصلی سامانههای تولید تصویر بزرگتر باشد.
Autoencoder برای داده جدولی
Autoencoder را میتوان روی دادههای عددی و جدولی نیز آموزش داد.
برای مثال، ورودی میتواند شامل ویژگیهای زیر باشد:
- تعداد درخواستهای کاربر
- متوسط مبلغ سفارش
- فاصله زمانی تراکنشها
- نرخ خطا
- مصرف منابع
- تعداد رخدادهای هر نوع
- زمان پاسخ سرویس
پیش از آموزش باید:
- ویژگیهای عددی مقیاسبندی شوند.
- مقادیر گمشده مدیریت شوند.
- متغیرهای دستهای به شکل مناسب نمایش داده شوند.
- ستونهای مربوط به آینده حذف شوند.
- تفکیک Train و Test بر اساس شرایط واقعی انجام شود.
- مدل فقط با داده عادی آموزش ببیند، اگر هدف تشخیص ناهنجاری است.
استفاده از Autoencoder روی داده جدولی کوچک همیشه بهترین انتخاب نیست. Isolation Forest، One-Class SVM و روشهای آماری نیز باید بهعنوان Baseline آزمایش شوند.
Autoencoder برای متن
در Autoencoder متنی، Encoder یک جمله یا سند را به بردار فشرده تبدیل میکند و Decoder تلاش میکند متن اصلی را بازسازی کند.
ساختار میتواند بر پایه موارد زیر باشد:
- LSTM
- GRU
- Transformer
- مدل Encoder-Decoder
- مدلهای از پیشآموزشدیده
بازسازی دقیق متن دشوارتر از تصویر است؛ زیرا خروجی شامل انتخاب گسسته توکنها است و ترتیب آنها اهمیت دارد.
برای بسیاری از کاربردهای جستوجوی معنایی، استفاده از مدل Embedding از پیشآموزشدیده معمولاً سادهتر از آموزش Autoencoder متنی از ابتدا است.
ساخت Embedding متنی با API درواره
درواره امکان دسترسی به مدلهای Embedding را از طریق API یکپارچه فراهم میکند.
نصب کتابخانه:
pip install openai scikit-learnتنظیم متغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
تولید بردار برای پیامهای فارسی:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
messages = [
"سفارش من هنوز ارسال نشده است.",
"برای دریافت فاکتور رسمی راهنمایی میخواهم.",
"برنامه هنگام ورود خطا نمایش میدهد.",
]
response = client.embeddings.create(
model=os.environ[
"DARVAREH_EMBEDDING_MODEL"
],
input=messages,
)
vectors = [
item.embedding
for item in response.data
]
print(len(vectors))
print(len(vectors[0]))شناسه مدل و محدودیت ورودی را از فهرست فعلی مدلها و مستندات API درواره بررسی کنید.
تشخیص پیام غیرعادی با Embedding و Isolation Forest
پس از تبدیل پیامها به بردار، میتوان یک مدل تشخیص ناهنجاری روی بردارها آموزش داد:
from sklearn.ensemble import IsolationForest


detector = IsolationForest(
    contamination=0.02,
    random_state=42,
)

detector.fit(vectors)

predictions = detector.predict(vectors)
scores = detector.decision_function(vectors)

for message, prediction, score in zip(
    messages,
    predictions,
    scores,
):
    status = (
        "عادی"
        if prediction == 1
        else "نیازمند بررسی"
    )

    print(status, score, message)
برای استفاده واقعی، مدل باید با تعداد زیادی پیام معمول سازمان آموزش ببیند و روی نمونههای بررسیشده ارزیابی شود.
این روش میتواند در موارد زیر کاربرد داشته باشد:
- یافتن تیکتهای نامعمول
- کشف موضوعات جدید
- شناسایی پیامهای خارج از دستههای فعلی
- اولویتبندی بررسی انسانی
- تحلیل تغییر الگوی درخواست کاربران
نباید هر نمونه دور از توزیع را الزاماً خطا یا رفتار مخرب دانست. ممکن است یک محصول جدید، کمپین یا تغییر رابط کاربری موضوعات تازهای ایجاد کرده باشد.
Autoencoder اختصاصی یا API آماده؟
| معیار | Autoencoder اختصاصی | API مدل آماده |
|---|---|---|
| نیاز به داده آموزشی | زیاد | معمولاً کمتر |
| زمان شروع | طولانیتر | سریعتر |
| کنترل معماری | کامل | محدود |
| نگهداری زیرساخت | بر عهده تیم | عمدتاً بر عهده سرویس |
| مناسب برای تصویر تخصصی | بله | به مدل بستگی دارد |
| مناسب برای متن عمومی | نیازمند داده و آموزش | معمولاً بهتر برای شروع |
| هزینه اولیه | بیشتر | مصرفمحور |
| امکان اجرای داخلی | بله | معمولاً نیازمند اتصال API |
| تغییر مدل | نیازمند توسعه | سادهتر در API چندمدلی |
برای داده اختصاصی مانند تصاویر قطعات صنعتی، سیگنال دستگاه یا داده حسگر، Autoencoder داخلی میتواند ارزشمند باشد.
برای متن عمومی فارسی، جستوجوی معنایی و تحلیل پیام، شروع با API Embedding یا مدل زبانی معمولاً سریعتر است.
اشتباهات رایج هنگام استفاده از Autoencoder
بزرگبودن بیشازحد فضای نهفته
فضای نهفته بزرگ ممکن است به مدل اجازه دهد ورودی را بدون یادگیری ویژگیهای عمومی کپی کند.
ارزیابی فقط با Loss
دو مدل با Loss نزدیک ممکن است کیفیت بصری، ساختار فضای نهفته و عملکرد متفاوتی در کاربرد نهایی داشته باشند.
آموزش تشخیص ناهنجاری با داده آلوده
اگر نمونههای ناهنجار زیادی در داده آموزش باشند، مدل ممکن است بازسازی آنها را نیز یاد بگیرد.
تعیین آستانه روی داده Test
آستانه باید با داده Train یا Validation تعیین شود. استفاده از Test برای تنظیم آستانه باعث خوشبینی در ارزیابی خواهد شد.
فرض اینکه هر خطای بازسازی بالا ناهنجاری است
نمونه سخت، کمنور یا دارای شرایط متفاوت میتواند عادی باشد، اما خطای زیادی ایجاد کند.
ناهماهنگی پیشپردازش
مقیاس و ترتیب ویژگیها در آموزش و استقرار باید کاملاً یکسان باشند.
ظرفیت بیشازحد Decoder
Decoder بسیار قدرتمند ممکن است بدون استفاده مؤثر از فضای نهفته، بازسازی خوبی انجام دهد.
مقایسهنکردن با Baseline
روشهای سادهتر مانند PCA، Isolation Forest و مدلهای نظارتشده را نیز آزمایش کنید.
استفاده عملی بدون پایش Drift
تغییر دستگاه، نور، محصول یا رفتار کاربران میتواند توزیع داده را تغییر دهد و نرخ هشدار اشتباه را افزایش دهد.
چگونه Autoencoder بهتری بسازیم؟
اندازه فضای نهفته را آزمایش کنید
چند اندازه مختلف را با معیار یکسان مقایسه کنید. فضای بسیار کوچک جزئیات را حذف میکند و فضای بسیار بزرگ ممکن است نمایش فشرده مفیدی نسازد.
از داده اعتبارسنجی استفاده کنید
تنظیم معماری، آستانه و تعداد Epoch نباید روی داده Test انجام شود.
خروجیها را مشاهده کنید
برای داده تصویری، نمونههای اصلی و بازسازیشده را کنار هم قرار دهید. Loss میانگین ممکن است خطاهای مهم بعضی نمونهها را پنهان کند.
مدل را با کاربرد نهایی ارزیابی کنید
اگر هدف خوشهبندی است، کیفیت خوشهها را بسنجید. اگر هدف تشخیص ناهنجاری است، Precision و Recall را روی ناهنجاریهای واقعی بررسی کنید.
نسخه داده و مدل را ذخیره کنید
Checkpoint مدل باید همراه اطلاعات زیر نگهداری شود:
- نسخه دیتاست
- تنظیمات پیشپردازش
- معماری Encoder و Decoder
- اندازه فضای نهفته
- تابع Loss
- آستانه ناهنجاری
- معیارهای Validation
- نسخه PyTorch و CUDA
خطا را به تفکیک گروه بررسی کنید
میانگین کلی ممکن است عملکرد ضعیف روی یک نوع دستگاه، محصول یا شرایط تصویربرداری را پنهان کند.
پرسشهای متداول
Autoencoder چیست؟
Autoencoder نوعی شبکه عصبی است که ورودی را به نمایش فشرده تبدیل میکند و سپس تلاش میکند همان ورودی را بازسازی کند.
خودرمزگذار چیست؟
خودرمزگذار معادل فارسی Autoencoder است. این مدل از Encoder، فضای نهفته و Decoder تشکیل میشود.
آیا Autoencoder یادگیری بدون نظارت است؟
Autoencoder معمولاً در گروه روشهای بدون نظارت یا خودنظارتی قرار میگیرد؛ زیرا برای آموزش به برچسب انسانی نیاز ندارد و هدف از خود ورودی ساخته میشود.
Latent Space چیست؟
فضای نهفته نمایش فشردهای از ویژگیهای مهم داده است که Encoder تولید میکند.
Denoising Autoencoder چیست؟
مدلی است که ورودی نویزی دریافت میکند و نسخه تمیز همان داده را بازسازی میکند.
VAE چیست؟
Variational Autoencoder نوعی خودرمزگذار احتمالاتی است که فضای نهفته منظمتری میسازد و برای تولید نمونه جدید مناسبتر است.
تفاوت VAE و GAN چیست؟
VAE بر یادگیری فضای نهفته احتمالاتی و بازسازی تمرکز دارد. GAN با رقابت میان Generator و Discriminator آموزش میبیند و میتواند تصاویر بسیار واقعی تولید کند، اما آموزش آن حساستر است.
آیا Autoencoder برای تشخیص ناهنجاری مناسب است؟
بله، بهویژه وقتی نمونه عادی فراوان و نمونه ناهنجار کم باشد. بااینحال، فرض خطای بازسازی بیشتر برای ناهنجاری باید روی داده واقعی بررسی شود.
آیا Autoencoder برای کاهش ابعاد بهتر از PCA است؟
همیشه خیر. Autoencoder روابط غیرخطی را یاد میگیرد، اما پیچیدهتر است. PCA یک Baseline سریع و تفسیرپذیر محسوب میشود.
آیا Autoencoder میتواند تصویر جدید تولید کند؟
Autoencoder معمولی برای نمونهبرداری طراحی نشده است. VAE برای تولید نمونه جدید انتخاب مناسبتری است.
آیا برای آموزش Autoencoder به GPU نیاز داریم؟
مدلهای کوچک روی CPU نیز آموزش میبینند، اما برای تصاویر بزرگ، شبکه عمیق یا دیتاست حجیم استفاده از GPU زمان آموزش را کاهش میدهد.
جمعبندی
Autoencoder شبکهای است که داده را به یک نمایش فشرده تبدیل و سپس بازسازی میکند. بخش Encoder ویژگیهای مهم را استخراج میکند، فضای نهفته آنها را نگه میدارد و Decoder داده اصلی را بازسازی میکند.
این معماری در کاهش ابعاد، حذف نویز، استخراج ویژگی و تشخیص ناهنجاری کاربرد دارد. Denoising Autoencoder با ورودی نویزی و هدف تمیز آموزش میبیند. VAE نیز با ساخت یک فضای نهفته احتمالاتی امکان نمونهبرداری و تولید داده جدید را فراهم میکند.
موفقیت Autoencoder فقط به پایینبودن Reconstruction Loss وابسته نیست. اندازه فضای نهفته، ظرفیت مدل، کیفیت داده، آستانه تشخیص، مقایسه با Baseline و ارزیابی روی نمونههای واقعی همگی اهمیت دارند.
برای دادههای تصویری یا حسگرهای تخصصی، آموزش Autoencoder اختصاصی میتواند انتخاب مناسبی باشد. برای تحلیل معنایی متن، جستوجو و پردازش پیامهای فارسی نیز میتوان ابتدا مدلهای Embedding آماده را از طریق API درواره آزمایش کرد و سپس بر اساس کیفیت، هزینه و حجم مصرف درباره آموزش مدل اختصاصی تصمیم گرفت.
مقالات مرتبط
- GAN چیست؟ آموزش شبکه مولد تخاصمی
- مدل Diffusion چیست؟
- کاهش ابعاد داده در یادگیری ماشین
- تشخیص ناهنجاری با یادگیری ماشین
- شبکه عصبی CNN چیست؟
- PyTorch چیست؟
- Embedding چیست؟
- جستوجوی معنایی چیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- Auto-Encoding Variational Bayes
- Keras Variational Autoencoder Example
- Google Machine Learning: Autoencoder and Representation Learning
- PyTorch Quickstart
- Keras Generative Deep Learning Examples
- Fine-tuning Stable Diffusion with VAE
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



