
GAN چیست؟ آموزش شبکه مولد تخاصمی و ساخت DCGAN با PyTorch
GAN یا شبکه مولد تخاصمی چگونه تصویر تولید میکند؟ در این راهنمای جامع، معماری GAN، انواع آن، مشکلات آموزش و پیادهسازی عملی DCGAN با PyTorch را یاد میگیرید و آن را با مدلهای Diffusion مقایسه میکنید.

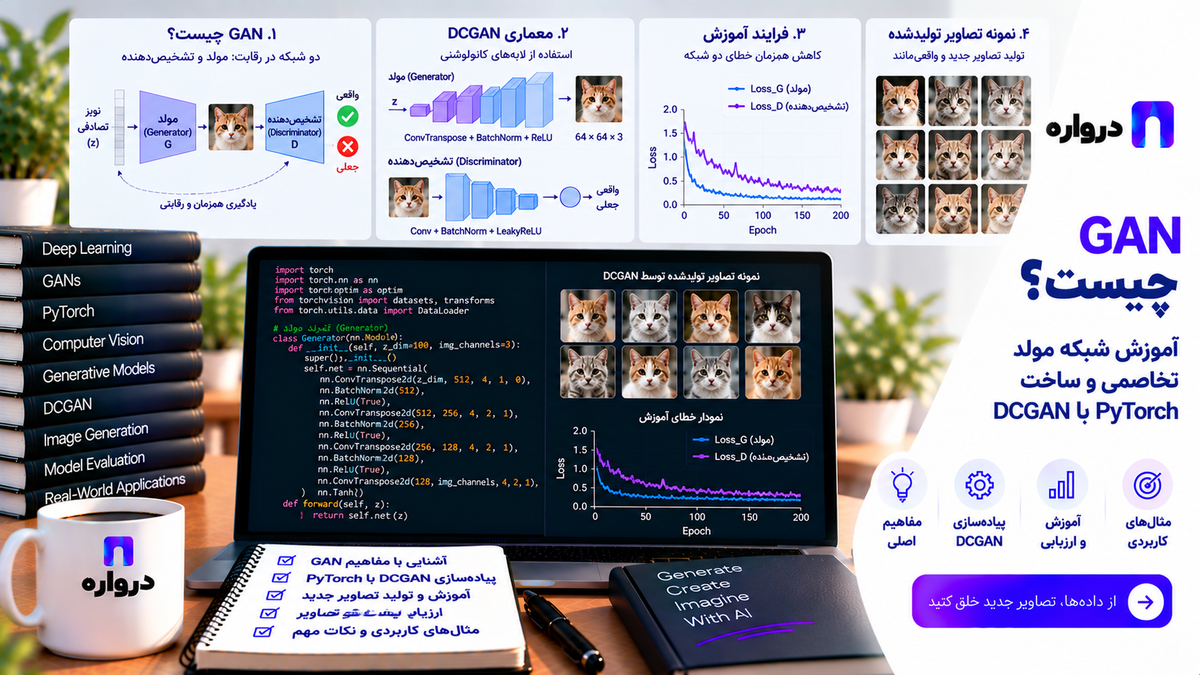
شبکه مولد تخاصمی یا GAN یکی از مهمترین معماریهای هوش مصنوعی مولد است. این معماری با آموزش همزمان دو شبکه عصبی میتواند تصاویر، صداها و نمونههای مصنوعی جدیدی تولید کند که به دادههای واقعی شباهت دارند.
پیش از گسترش مدلهای Diffusion، بسیاری از پیشرفتهای مهم تولید تصویر با هوش مصنوعی بر پایه GAN انجام میشدند. مدلهایی مانند StyleGAN، CycleGAN و SRGAN نشان دادند که شبکههای عصبی نهتنها میتوانند تصویر را طبقهبندی کنند، بلکه قادرند دادههای کاملاً جدیدی نیز بسازند.
در این راهنما ابتدا بررسی میکنیم GAN چیست و چگونه کار میکند. سپس یک مدل DCGAN واقعی را با PyTorch پیادهسازی میکنیم، مشکلات رایج آموزش آن را میشناسیم و در پایان توضیح میدهیم چه زمانی آموزش GAN اختصاصی منطقی است و چه زمانی استفاده از API تولید تصویر انتخاب بهتری خواهد بود.
GAN چیست؟
GAN مخفف Generative Adversarial Network و به معنای شبکه مولد تخاصمی است.
این معماری در سال ۲۰۱۴ توسط ایان گودفلو و همکارانش معرفی شد. ایده اصلی آن آموزش همزمان دو مدل است:
- Generator یا مولد: داده مصنوعی تولید میکند.
- Discriminator یا تمایزدهنده: تشخیص میدهد داده واقعی است یا توسط مولد ساخته شده است.
مولد تلاش میکند تصاویر واقعیتری بسازد و تمایزدهنده تلاش میکند نمونههای مصنوعی را شناسایی کند. این رقابت باعث میشود هر دو شبکه بهتدریج بهتر شوند. مقاله اصلی GAN این فرایند را مانند یک بازی رقابتی میان دو مدل معرفی میکند.
برای مثال، اگر بخواهیم GAN تصاویر کفش تولید کند:
- مجموعهای از تصاویر واقعی کفش را به مدل میدهیم.
- مولد در ابتدا تصاویری شبیه نویز میسازد.
- تمایزدهنده تصاویر واقعی و مصنوعی را مقایسه میکند.
- خطای تمایزدهنده به مولد کمک میکند خروجی خود را بهتر کند.
- پس از تکرارهای زیاد، مولد میتواند تصاویر جدیدی بسازد که ظاهر آنها به کفش واقعی نزدیک است.
تفاوت مدل مولد و مدل تشخیصی چیست؟
مدلهای تشخیصی یا Discriminative معمولاً برای تشخیص یک برچسب یا تصمیمگیری استفاده میشوند. برای مثال، یک مدل طبقهبندی تصویر مشخص میکند تصویر ورودی متعلق به گربه است یا سگ.
مدل مولد سعی میکند الگوهای موجود در داده را یاد بگیرد تا نمونهای جدید ایجاد کند.
| نوع مدل | ورودی | خروجی نمونه |
|---|---|---|
| مدل طبقهبندی | تصویر | نام کلاس تصویر |
| مدل تشخیص شیء | تصویر | محل و نوع اشیا |
| مدل زبانی | متن یا دستور | متن جدید |
| GAN | نویز یا ورودی شرطی | تصویر یا داده مصنوعی |
| مدل Diffusion | نویز و معمولاً پرامپت | تصویر تولیدشده |
GAN صرفاً تصاویر آموزشی را کپی نمیکند. هدف آن یادگیری توزیع و الگوهای کلی داده است؛ بااینحال، بررسی حفظکردن نمونههای آموزشی همچنان بخشی مهم از ارزیابی مدل محسوب میشود.
اجزای اصلی معماری GAN
Generator یا شبکه مولد
مولد یک بردار تصادفی را دریافت میکند و آن را به دادهای مانند تصویر تبدیل میکند.
بردار تصادفی را معمولاً Latent Vector یا بردار فضای نهفته مینامند. هر بردار میتواند به تصویری متفاوت منجر شود. در طول آموزش، مولد یاد میگیرد چگونه ویژگیهایی مانند شکل، رنگ، بافت و ساختار را از این بردار استخراج کند.
در یک GAN تصویری، مولد معمولاً مراحل زیر را انجام میدهد:
- دریافت نویز تصادفی
- تبدیل نویز به مجموعهای از ویژگیها
- افزایش تدریجی ابعاد فضایی
- ساخت تصویر نهایی
- محدودکردن مقادیر پیکسلها به بازه مورد انتظار
Discriminator یا شبکه تمایزدهنده
تمایزدهنده یک تصویر را دریافت میکند و مشخص میکند که تصویر احتمالاً واقعی است یا مصنوعی.
این شبکه با دو نوع داده آموزش میبیند:
- تصاویر واقعی موجود در دیتاست
- تصاویر مصنوعی ساختهشده توسط مولد
تمایزدهنده از دید معماری به یک طبقهبند دودویی شباهت دارد. تفاوت مهم این است که دادههای مصنوعی آن در طول آموزش دائماً تغییر میکنند؛ زیرا مولد نیز همزمان در حال یادگیری است.
طبق توضیح رسمی Google، خروجی مولد مستقیماً وارد تمایزدهنده میشود و سیگنال حاصل از طبقهبندی تمایزدهنده از طریق پسانتشار برای بهبود مولد استفاده میشود.
GAN چگونه آموزش داده میشود؟
آموزش GAN معمولاً بهصورت متناوب انجام میشود.
مرحله اول: آموزش تمایزدهنده با داده واقعی
یک دسته از تصاویر واقعی به تمایزدهنده داده میشود. مدل باید آنها را واقعی تشخیص دهد.
مرحله دوم: ساخت تصاویر مصنوعی
مولد مجموعهای از بردارهای تصادفی را دریافت میکند و تصاویر مصنوعی میسازد.
مرحله سوم: آموزش تمایزدهنده با داده مصنوعی
تصاویر تولیدشده به تمایزدهنده داده میشوند. در این مرحله، مدل باید آنها را مصنوعی تشخیص دهد.
مرحله چهارم: آموزش مولد
مولد دوباره تصویر میسازد؛ اما این بار هدف آن فریبدادن تمایزدهنده است. وزنهای تمایزدهنده در این مرحله تغییر نمیکنند و خطای آن برای اصلاح مولد به کار میرود.
این چرخه هزاران بار تکرار میشود. اگر آموزش متعادل باشد، تصاویر مولد بهتدریج طبیعیتر و تشخیص آنها برای تمایزدهنده دشوارتر میشود.
فضای نهفته در GAN چیست؟
فضای نهفته یا Latent Space نمایش فشردهای از ویژگیهایی است که مولد آموخته است.
در یک مدل تولید چهره، جهتهای مختلف این فضا ممکن است با ویژگیهایی مانند موارد زیر ارتباط پیدا کنند:
- زاویه چهره
- نورپردازی
- حالت صورت
- رنگ مو
- پسزمینه
- سن ظاهری
میتوان دو بردار فضای نهفته را بهآرامی به یکدیگر نزدیک کرد و مجموعهای از تصاویر میانی ساخت. به این کار Latent Interpolation گفته میشود.
فضای نهفته یکی از دلایل جذابیت GAN است؛ زیرا امکان کنترل، ترکیب و ویرایش ویژگیهای خروجی را فراهم میکند.
DCGAN چیست؟
DCGAN مخفف Deep Convolutional Generative Adversarial Network است. این معماری نسخهای از GAN است که برای پردازش و تولید تصویر از لایههای کانولوشنی استفاده میکند.
در DCGAN معمولاً:
- مولد از
ConvTranspose2dبرای بزرگکردن ویژگیها استفاده میکند. - تمایزدهنده از
Conv2dبرای کوچککردن تصویر استفاده میکند. - در بخشهایی از شبکه از Batch Normalization استفاده میشود.
- فعالساز مولد معمولاً ReLU است.
- فعالساز تمایزدهنده معمولاً LeakyReLU است.
- خروجی مولد با Tanh محدود میشود.
معماری DCGAN در پژوهش Radford و همکاران بهعنوان مجموعهای از محدودیتهای معماری برای پایدارترکردن GANهای کانولوشنی معرفی شد.
آموزش رسمی PyTorch نیز از DCGAN برای تولید تصاویر جدید چهره استفاده میکند.
پیشنیازهای ساخت DCGAN با PyTorch
در این مثال، مدلی میسازیم که تصاویر رنگی ۶۴ در ۶۴ پیکسل تولید کند.
ابتدا کتابخانههای موردنیاز را نصب کنید:
pip install torch torchvision pillowساختار دیتاست باید مشابه زیر باشد:
data/
└── images/
    └── all/
        ├── image-001.jpg
        ├── image-002.jpg
        ├── image-003.jpg
        └── ...
وجود پوشه all به این دلیل است که کلاس ImageFolder انتظار دارد تصاویر داخل حداقل یک زیرپوشه قرار گرفته باشند. برای آموزش بدون شرط، نام این پوشه اهمیت خاصی ندارد.
تصاویر باید از یک دامنه مشخص باشند. ترکیب تصاویر کاملاً نامرتبط، یادگیری توزیع داده را دشوار میکند. برای مثال، میتوانید از تصاویر محصولات، طرحهای پارچه، آیکونها، شخصیتهای کارتونی یا اشیای یک دسته مشخص استفاده کنید.
آمادهسازی دیتاست
from pathlib import Path

import torch
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


IMAGE_SIZE = 64
BATCH_SIZE = 64
DATA_DIR = Path("data/images")

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

transform = transforms.Compose(
    [
        transforms.Resize(IMAGE_SIZE),
        transforms.CenterCrop(IMAGE_SIZE),
        transforms.ToTensor(),
        transforms.Normalize(
            mean=(0.5, 0.5, 0.5),
            std=(0.5, 0.5, 0.5),
        ),
    ]
)

dataset = datasets.ImageFolder(
    root=DATA_DIR,
    transform=transform,
)

loader = DataLoader(
    dataset,
    batch_size=BATCH_SIZE,
    shuffle=True,
    num_workers=2,
    pin_memory=torch.cuda.is_available(),
)

print(f"Device: {device}")
print(f"Number of images: {len(dataset)}")نرمالسازی داده با مقدارهای 0.5 باعث میشود دامنه پیکسلها با خروجی Tanh در مولد هماهنگ شود.
استفاده از CenterCrop برای همه دیتاستها مناسب نیست. اگر سوژه در مرکز تصویر قرار ندارد، بهتر است قبل از آموزش، فرایند برش متناسب با داده خود طراحی کنید.
ساخت Generator با PyTorch
مولد نویز تصادفی را دریافت میکند و طی چند مرحله آن را به تصویر رنگی تبدیل میکند.
from torch import nn


LATENT_DIM = 100
GENERATOR_FEATURES = 64
IMAGE_CHANNELS = 3


class Generator(nn.Module):
    def __init__(
        self,
        latent_dim: int = LATENT_DIM,
        features: int = GENERATOR_FEATURES,
        channels: int = IMAGE_CHANNELS,
    ):
        super().__init__()

        self.network = nn.Sequential(
            nn.ConvTranspose2d(
                latent_dim,
                features * 8,
                kernel_size=4,
                stride=1,
                padding=0,
                bias=False,
            ),
            nn.BatchNorm2d(features * 8),
            nn.ReLU(inplace=True),

            nn.ConvTranspose2d(
                features * 8,
                features * 4,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features * 4),
            nn.ReLU(inplace=True),

            nn.ConvTranspose2d(
                features * 4,
                features * 2,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features * 2),
            nn.ReLU(inplace=True),

            nn.ConvTranspose2d(
                features * 2,
                features,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features),
            nn.ReLU(inplace=True),

            nn.ConvTranspose2d(
                features,
                channels,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.Tanh(),
        )

    def forward(self, noise: torch.Tensor) -> torch.Tensor:
        return self.network(noise)
هر لایه ConvTranspose2d ابعاد فضایی ویژگیها را افزایش میدهد. خروجی نهایی شامل سه کانال رنگی و اندازه ۶۴ در ۶۴ پیکسل است.
ساخت Discriminator با PyTorch
تمایزدهنده تصویر را دریافت و آن را به یک مقدار خام یا Logit تبدیل میکند.
DISCRIMINATOR_FEATURES = 64


class Discriminator(nn.Module):
    def __init__(
        self,
        channels: int = IMAGE_CHANNELS,
        features: int = DISCRIMINATOR_FEATURES,
    ):
        super().__init__()

        self.network = nn.Sequential(
            nn.Conv2d(
                channels,
                features,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.LeakyReLU(0.2, inplace=True),

            nn.Conv2d(
                features,
                features * 2,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features * 2),
            nn.LeakyReLU(0.2, inplace=True),

            nn.Conv2d(
                features * 2,
                features * 4,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features * 4),
            nn.LeakyReLU(0.2, inplace=True),

            nn.Conv2d(
                features * 4,
                features * 8,
                kernel_size=4,
                stride=2,
                padding=1,
                bias=False,
            ),
            nn.BatchNorm2d(features * 8),
            nn.LeakyReLU(0.2, inplace=True),

            nn.Conv2d(
                features * 8,
                1,
                kernel_size=4,
                stride=1,
                padding=0,
                bias=False,
            ),
        )

    def forward(self, image: torch.Tensor) -> torch.Tensor:
        return self.network(image).view(-1)
در خروجی تمایزدهنده از Sigmoid استفاده نکردهایم؛ زیرا در ادامه از BCEWithLogitsLoss استفاده میکنیم. این تابع عملیات Sigmoid و محاسبه خطا را بهشکل عددی پایدارتر ترکیب میکند.
مقداردهی اولیه وزنها
مقداردهی اولیه مناسب میتواند شروع آموزش GAN را پایدارتر کند.
def initialize_weights(module: nn.Module) -> None:
    class_name = module.__class__.__name__

    if "Conv" in class_name:
        nn.init.normal_(module.weight.data, 0.0, 0.02)

    elif "BatchNorm" in class_name:
        nn.init.normal_(module.weight.data, 1.0, 0.02)
        nn.init.constant_(module.bias.data, 0)


generator = Generator().to(device)
discriminator = Discriminator().to(device)

generator.apply(initialize_weights)
discriminator.apply(initialize_weights)
حلقه کامل آموزش DCGAN
اکنون میتوانیم هر دو شبکه را آموزش دهیم.
from torchvision.utils import save_image
EPOCHS = 50
LEARNING_RATE = 0.0002
BETA_1 = 0.5
OUTPUT_DIR = Path("outputs")
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
criterion = nn.BCEWithLogitsLoss()
generator_optimizer = torch.optim.Adam(
generator.parameters(),
lr=LEARNING_RATE,
betas=(BETA_1, 0.999),
)
discriminator_optimizer = torch.optim.Adam(
discriminator.parameters(),
lr=LEARNING_RATE,
betas=(BETA_1, 0.999),
)
fixed_noise = torch.randn(
64,
LATENT_DIM,
1,
1,
device=device,
)
for epoch in range(EPOCHS):
generator.train()
discriminator.train()
for batch_index, (real_images, _) in enumerate(loader):
real_images = real_images.to(device)
current_batch_size = real_images.size(0)
real_targets = torch.ones(
current_batch_size,
device=device,
)
fake_targets = torch.zeros(
current_batch_size,
device=device,
)
# -------------------------
# آموزش Discriminator
# -------------------------
discriminator_optimizer.zero_grad()
real_logits = discriminator(real_images)
real_loss = criterion(real_logits, real_targets)
noise = torch.randn(
current_batch_size,
LATENT_DIM,
1,
1,
device=device,
)
fake_images = generator(noise)
fake_logits = discriminator(fake_images.detach())
fake_loss = criterion(fake_logits, fake_targets)
discriminator_loss = real_loss + fake_loss
discriminator_loss.backward()
discriminator_optimizer.step()
# -------------------------
# آموزش Generator
# -------------------------
generator_optimizer.zero_grad()
generated_logits = discriminator(fake_images)
# مولد میخواهد تصاویرش واقعی تشخیص داده شوند.
generator_loss = criterion(
generated_logits,
real_targets,
)
generator_loss.backward()
generator_optimizer.step()
if batch_index % 100 == 0:
print(
f"Epoch [{epoch + 1}/{EPOCHS}] "
f"Batch [{batch_index}/{len(loader)}] "
f"D Loss: {discriminator_loss.item():.4f} "
f"G Loss: {generator_loss.item():.4f}"
)
with torch.no_grad():
samples = generator(fixed_noise).cpu()
save_image(
samples,
OUTPUT_DIR / f"epoch-{epoch + 1:03d}.png",
normalize=True,
value_range=(-1, 1),
nrow=8,
)استفاده از detach() هنگام آموزش تمایزدهنده اهمیت زیادی دارد. با این کار، گرادیانهای مرحله تمایزدهنده وارد مولد نمیشوند.
fixed_noise نیز در تمام دورهها ثابت میماند. بنابراین با مشاهده فایلهای خروجی میتوان تغییر کیفیت تصاویر یک ورودی ثابت را در طول آموزش ارزیابی کرد.
ذخیره و بارگذاری مدل
پس از آموزش، وزنهای هر دو شبکه و Optimizerها را ذخیره کنید:
checkpoint = {
    "generator": generator.state_dict(),
    "discriminator": discriminator.state_dict(),
    "generator_optimizer": generator_optimizer.state_dict(),
    "discriminator_optimizer": discriminator_optimizer.state_dict(),
    "latent_dim": LATENT_DIM,
    "epoch": EPOCHS,
}

torch.save(
    checkpoint,
    OUTPUT_DIR / "dcgan-checkpoint.pt",
)
برای بارگذاری مولد:
checkpoint = torch.load(
    "outputs/dcgan-checkpoint.pt",
    map_location=device,
    weights_only=False,
)

generator = Generator(
    latent_dim=checkpoint["latent_dim"]
).to(device)

generator.load_state_dict(checkpoint["generator"])
generator.eval()
اگر فقط تولید تصویر اهمیت دارد، میتوانید وزنهای Generator را بهصورت جداگانه ذخیره کنید. نگهداری Optimizerها زمانی مفید است که بخواهید آموزش را از همان نقطه ادامه دهید.
تولید تصاویر جدید با مدل آموزشدیده
generator.eval()

with torch.inference_mode():
    noise = torch.randn(
        16,
        LATENT_DIM,
        1,
        1,
        device=device,
    )

    generated_images = generator(noise).cpu()

save_image(
    generated_images,
    "outputs/generated-images.png",
    normalize=True,
    value_range=(-1, 1),
    nrow=4,
)
با هر نویز جدید، مجموعه متفاوتی از تصاویر تولید میشود. برای قابلتکرارشدن نتیجه میتوانید پیش از ساخت نویز، Seed تصادفی PyTorch را تنظیم کنید.
چرا آموزش GAN دشوار است؟
در شبکههای معمولی، یک مدل تلاش میکند یک هدف نسبتاً ثابت را یاد بگیرد. در GAN، وضعیت متفاوت است؛ زیرا هر شبکه دائماً در حال تغییردادن مسئله شبکه دیگر است.
اگر تمایزدهنده خیلی قوی شود، مولد سیگنال آموزشی مفیدی دریافت نمیکند. اگر مولد زودتر از تمایزدهنده پیشرفت کند، تمایزدهنده ممکن است نتواند تفاوت نمونهها را تشخیص دهد.
به همین دلیل، کاهش یک Loss بهتنهایی لزوماً به معنای بهترشدن مدل نیست.
Mode Collapse چیست؟
Mode Collapse یکی از شناختهشدهترین مشکلات GAN است. در این وضعیت، مولد فقط تعداد محدودی الگوی مشابه تولید میکند.
برای مثال، مدلی که باید انواع کفش را بسازد ممکن است فقط یک مدل کفش را با تفاوتهای جزئی در رنگ تولید کند. این تصاویر شاید باکیفیت باشند، اما تنوع کافی ندارند.
نشانههای Mode Collapse عبارتاند از:
- شباهت زیاد تصاویر تولیدشده
- تکرار شکل یا پسزمینه
- بیاثرشدن تغییر نویز
- کاهش تنوع در طول آموزش
- تولید چند خروجی محدود برای ورودیهای متعدد
راهکارهای احتمالی شامل موارد زیر هستند:
- استفاده از معماریهایی مانند WGAN
- کاهش قدرت بیشازحد تمایزدهنده
- تنظیم نرخ یادگیری دو شبکه
- افزایش تنوع داده آموزشی
- استفاده از Data Augmentation مناسب
- بررسی خروجی یک نویز ثابت
- تغییر نسبت مراحل آموزش Generator و Discriminator
- استفاده از Mini-batch Discrimination در معماریهای پیشرفتهتر
چرا تصاویر GAN دارای الگوی شطرنجی میشوند؟
گاهی در تصاویر DCGAN الگوهای منظم و شطرنجی دیده میشود. این مشکل ممکن است به نحوه کار ConvTranspose2d و همپوشانی نامتوازن عملیات افزایش ابعاد مربوط باشد.
برای کاهش این مشکل میتوان:
- اندازه Kernel و Stride را با دقت انتخاب کرد.
- ابتدا تصویر را با روشهایی مانند nearest-neighbor یا bilinear بزرگ کرد.
- پس از افزایش اندازه از
Conv2dمعمولی استفاده کرد. - خروجی لایههای مختلف را جداگانه مشاهده کرد.
- معماریهای جدیدتر مولد را آزمایش کرد.
آیا Loss پایین به معنای GAN بهتر است؟
خیر. Loss در GAN باید همراه با کیفیت و تنوع تصاویر بررسی شود.
برای مثال، پایینآمدن شدید خطای تمایزدهنده ممکن است نشان دهد تمایزدهنده بیشازحد قوی شده است. همچنین افزایش موقت خطای مولد لزوماً نشانه شکست آموزش نیست.
برای پایش بهتر، موارد زیر را همزمان ثبت کنید:
- Loss مولد
- Loss تمایزدهنده
- تصاویر مربوط به نویز ثابت
- تنوع خروجیها
- تغییر کیفیت در طول Epochها
- گرادیانها و وزنهای شبکه
- معیارهای ارزیابی مانند FID و KID
ارزیابی GAN چگونه انجام میشود؟
ارزیابی مدل مولد از ارزیابی یک طبقهبند دشوارتر است؛ زیرا خروجی درست یکتایی وجود ندارد.
بررسی بصری
تصاویر را از نظر وضوح، ساختار، تنوع و خطاهای تکرارشونده بررسی کنید. این روش سریع است، اما ممکن است تحت تأثیر قضاوت شخصی قرار گیرد.
معیار FID
معیار Fréchet Inception Distance توزیع ویژگیهای تصاویر واقعی و تولیدشده را مقایسه میکند. مقدار کمتر معمولاً نشاندهنده شباهت بیشتر دو توزیع است.
FID را باید روی تعداد مناسبی تصویر و با تنظیمات یکسان محاسبه کرد. مقایسه عددهایی که با دیتاست، پیشپردازش یا تعداد نمونه متفاوت ساخته شدهاند قابلاعتماد نیست.
معیار KID
معیار Kernel Inception Distance نیز ویژگیهای تصاویر واقعی و مصنوعی را مقایسه میکند و برای بعضی مجموعههای کوچکتر انتخاب مناسبی است.
ارزیابی تنوع
کیفیت بالا بدون تنوع کافی نشاندهنده یک مدل مولد موفق نیست. تصاویر حاصل از نویزهای متفاوت را کنار هم قرار دهید و الگوهای تکراری را بررسی کنید.
بررسی حفظ دادههای آموزشی
تصاویر تولیدشده را با نزدیکترین نمونههای دیتاست مقایسه کنید. اگر خروجیها شباهت غیرعادی به تصاویر آموزشی دارند، احتمال حفظکردن داده بهجای یادگیری الگوهای عمومی وجود دارد.
انواع مهم GAN
Conditional GAN
در GAN شرطی یا cGAN علاوه بر نویز، اطلاعاتی مانند برچسب کلاس نیز به مدل داده میشود.
برای مثال، کاربر میتواند مشخص کند تصویر مربوط به کفش، کیف یا پیراهن باشد. مولد نویز و برچسب را دریافت میکند و تمایزدهنده نیز علاوه بر واقعی یا مصنوعیبودن، سازگاری تصویر با همان شرط را میآموزد.
CycleGAN
CycleGAN برای تبدیل تصویر میان دو دامنه استفاده میشود و الزاماً به تصاویر جفتشده نیاز ندارد.
کاربردهای نمونه:
- تبدیل عکس به نقاشی
- تغییر فصل منظره
- تبدیل طرح اولیه به تصویر
- تبدیل سبک بصری یک دامنه به دامنه دیگر
StyleGAN
StyleGAN خانوادهای از مدلهای مولد تصویری است که کنترل ویژگیها را در مراحل مختلف مولد تفکیک میکند. این معماری بهویژه به دلیل تولید تصاویر باکیفیت و کنترل بهتر فضای نهفته شناخته میشود.
WGAN
Wasserstein GAN با تغییر تابع هدف و شیوه ارزیابی تمایزدهنده تلاش میکند آموزش را پایدارتر و نشانههای پیشرفت مدل را قابلتفسیرتر کند.
نسخه WGAN-GP برای اعمال محدودیت موردنیاز شبکه از جریمه گرادیان استفاده میکند و در بسیاری از پروژههای تحقیقاتی جایگزین مناسبی برای GAN کلاسیک است.
SRGAN و ESRGAN
این مدلها برای Super Resolution یا افزایش وضوح تصویر طراحی شدهاند. هدف آنها بازسازی جزئیات نسخه باکیفیت از یک ورودی کموضوح است.
Pix2Pix
Pix2Pix برای تبدیل تصویر به تصویر با دادههای جفتشده استفاده میشود. برای مثال، میتوان نقشه لبهها و تصویر واقعی متناظر با آن را به مدل داد تا تبدیل میان این دو نمایش را یاد بگیرد.
کاربردهای GAN
تولید تصاویر مصنوعی
GAN میتواند تصاویر جدیدی از یک دامنه مشخص تولید کند؛ مانند محصول، طرح پارچه، دکوراسیون، شخصیت یا اشیای گرافیکی.
افزایش داده
میتوان از نمونههای مصنوعی برای افزایش تنوع دیتاست استفاده کرد. بااینحال، اضافهکردن داده مصنوعی باید با آزمایش کنترلشده انجام شود. داده نامعتبر ممکن است خطاها و سوگیریهای جدیدی وارد مدل کند.
تبدیل تصویر به تصویر
مدلهایی مانند CycleGAN و Pix2Pix امکان تغییر سبک یا تبدیل ساختاری تصویر را فراهم میکنند.
افزایش کیفیت تصویر
GANها در Super Resolution، حذف نویز، بازسازی جزئیات و اصلاح برخی نقصهای تصویری استفاده شدهاند.
ساخت داده برای آزمایش نرمافزار
در بعضی پروژهها میتوان داده مصنوعی غیرحساس برای آزمایش رابط کاربری، خطوط پردازش تصویر یا نمونه اولیه محصول تولید کرد.
تشخیص ناهنجاری
اگر GAN فقط با نمونههای عادی آموزش ببیند، بازسازی ضعیف برخی ورودیها میتواند نشانه متفاوتبودن آنها باشد. این روش به طراحی و ارزیابی دقیق نیاز دارد و نباید صرفاً بر اساس خروجی بصری استفاده شود.
تفاوت GAN با Autoencoder و VAE
| ویژگی | GAN | Autoencoder | VAE |
|---|---|---|---|
| هدف اصلی | تولید داده واقعینما | فشردهسازی و بازسازی | تولید داده از فضای نهفته ساختاریافته |
| اجزای اصلی | مولد و تمایزدهنده | Encoder و Decoder | Encoder احتمالاتی و Decoder |
| کیفیت بصری | بالقوه بسیار بالا | معمولاً محدودتر | گاهی نرمتر یا محوتر |
| پایداری آموزش | دشوارتر | سادهتر | معمولاً پایدارتر از GAN |
| فضای نهفته | میتواند قابلکنترل باشد | همیشه منظم نیست | ساختار منظمتری دارد |
| مشکل رایج | Mode Collapse | بازسازی ضعیف | افت جزئیات خروجی |
تفاوت GAN و Diffusion چیست؟
مدلهای Diffusion با تخریب تدریجی داده و یادگیری فرایند معکوس آن کار میکنند. GAN از رقابت مولد و تمایزدهنده استفاده میکند.
| معیار | GAN | Diffusion |
|---|---|---|
| روش آموزش | رقابت دو شبکه | یادگیری حذف نویز |
| پایداری آموزش | حساستر | معمولاً پایدارتر |
| سرعت تولید پس از آموزش | اغلب بسیار سریع | ممکن است به چند مرحله نمونهبرداری نیاز داشته باشد |
| تنوع خروجی | در معرض Mode Collapse | معمولاً تنوع بهتر |
| کنترل با متن | نیازمند معماری شرطی مناسب | در مدلهای جدید بسیار رایج |
| کیفیت در پروژه محدود | به داده و تنظیم دقیق وابسته | مدلهای آماده قدرتمند در دسترساند |
| استقرار سبک | در بعضی موارد مناسبتر | معمولاً سنگینتر |
در بسیاری از سامانههای جدید تولید تصویر از متن، مدلهای Diffusion رایجتر شدهاند. بااینحال، GAN همچنان برای تولید سریع، تبدیل تصویر، افزایش وضوح، دامنههای محدود و پژوهش روی مدلهای مولد کاربرد دارد.
چه زمانی GAN اختصاصی آموزش دهیم؟
آموزش GAN اختصاصی زمانی قابلبررسی است که:
- دیتاست منسجم و کافی در اختیار دارید.
- خروجی به یک دامنه تصویری محدود تعلق دارد.
- کنترل کامل روی وزنها و خط پردازش ضروری است.
- زمان تولید بسیار کوتاه اهمیت دارد.
- مدل باید در زیرساخت خودتان اجرا شود.
- تیم تجربه یادگیری عمیق و منابع GPU دارد.
- مدلهای آماده نیاز تخصصی پروژه را پوشش نمیدهند.
در مقابل، اگر هدف شما ساخت سریع قابلیت تولید تصویر در یک اپلیکیشن است، آموزش GAN از ابتدا معمولاً اولین انتخاب اقتصادی نیست.
چه زمانی از API تولید تصویر استفاده کنیم؟
استفاده از API معمولاً زمانی منطقیتر است که:
- میخواهید نسخه اولیه محصول را سریع منتشر کنید.
- داده آموزشی اختصاصی ندارید.
- کاربران با پرامپت متن آزاد تصویر میسازند.
- به سبکها و موضوعات متنوع نیاز دارید.
- نمیخواهید زیرساخت GPU مدیریت کنید.
- مصرف پروژه متغیر است.
- تیم باید چند مدل را آزمایش کند.
- کیفیت مدلهای آماده برای کاربرد شما کافی است.
برای مثال، یک فروشگاه اینترنتی که میخواهد به کاربران امکان ساخت تصویر تبلیغاتی بدهد، میتواند ابتدا از یک API تولید تصویر استفاده کند. اگر بعداً مشخص شد یک سبک کاملاً اختصاصی و پرتکرار موردنیاز است، آموزش مدل سفارشی بررسی میشود.
اتصال اپلیکیشن تولید تصویر به API درواره
درواره امکان دسترسی یکپارچه به مدلهای مختلف هوش مصنوعی را از طریق API فراهم میکند. در مدلهایی که از مسیر سازگار تولید تصویر پشتیبانی میکنند، میتوان از OpenAI Python SDK استفاده کرد.
ابتدا کتابخانه را نصب کنید:
pip install openaiمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_IMAGE_MODEL="YOUR_IMAGE_MODEL_ID"
نمونه کد:
import base64
import os
from pathlib import Path
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
response = client.images.generate(
model=os.environ["DARVAREH_IMAGE_MODEL"],
prompt=(
"تصویر تبلیغاتی مینیمال از یک کفش ورزشی سفید، "
"پسزمینه آبی روشن، نورپردازی استودیویی، "
"ترکیببندی مناسب فروشگاه اینترنتی"
),
size="1024x1024",
)
image = response.data[0]
if getattr(image, "url", None):
print(image.url)
elif getattr(image, "b64_json", None):
output_path = Path("generated-product-image.png")
output_path.write_bytes(
base64.b64decode(image.b64_json)
)
print(output_path)شناسه مدل، اندازههای قابلپشتیبانی، قالب خروجی و پارامترهای اضافی ممکن است برای هر مدل متفاوت باشند. پیش از پیادهسازی نهایی، مشخصات مدل انتخابشده را در مستندات API درواره بررسی کنید.
کلید API نباید در JavaScript مرورگر، اپلیکیشن موبایل یا کد قابلمشاهده کاربر قرار گیرد. درخواست تولید تصویر را از سرور برنامه خود ارسال کنید.
معماری پیشنهادی برای محصول تولید تصویر
ساختار مناسب یک اپلیکیشن تولید تصویر میتواند شامل مراحل زیر باشد:
- کاربر توضیح تصویر را در رابط کاربری وارد میکند.
- سرور هویت، اعتبار و محدودیتهای کاربر را بررسی میکند.
- پرامپت با قالب و تنظیمات محصول ترکیب میشود.
- درخواست از سرور به API درواره ارسال میشود.
- نتیجه در فضای ذخیرهسازی برنامه ثبت میشود.
- وضعیت کار به کاربر نمایش داده میشود.
- هزینه و مصرف هر درخواست ذخیره میشود.
برای پردازشهایی که زمان بیشتری نیاز دارند، بهتر است از صف کار، Worker و Webhook یا بررسی دورهای وضعیت استفاده شود. نگهداشتن یک اتصال HTTP برای مدت طولانی میتواند باعث Timeout شود.
مقایسه آموزش GAN و استفاده از API
| معیار | آموزش GAN اختصاصی | استفاده از API |
|---|---|---|
| زمان شروع | طولانیتر | کوتاه |
| نیاز به دیتاست | زیاد | معمولاً ندارد |
| مدیریت GPU | ضروری | بر عهده سرویس |
| کنترل معماری | کامل | محدود به تنظیمات مدل |
| تنوع موضوع | وابسته به دیتاست | معمولاً گستردهتر |
| هزینه اولیه | بالا | مصرفمحور |
| نگهداری مدل | بر عهده تیم | عمدتاً بر عهده ارائهدهنده |
| مناسب برای | دامنه محدود و تخصصی | اپلیکیشن و نمونه اولیه |
| امکان تغییر مدل | نیازمند توسعه مجدد | سادهتر در API چندمدلی |
یک معماری ترکیبی نیز ممکن است بهترین نتیجه را بدهد. برای مثال، محصول میتواند تصاویر عمومی را با API بسازد و عملیات تخصصی مانند افزایش وضوح یا تبدیل سبک محدود را با یک GAN داخلی انجام دهد.
چگونه آموزش GAN را پایدارتر کنیم؟
از دیتاست تمیز شروع کنید
تصاویر خراب، اندازههای نامناسب، برشهای ناهماهنگ و نمونههای نامرتبط مستقیماً کیفیت مولد را کاهش میدهند.
رزولوشن را تدریجی افزایش دهید
ابتدا آموزش را با تصاویر کوچکتر آزمایش کنید. پس از اطمینان از درستبودن خط داده و معماری، رزولوشن را افزایش دهید.
خروجی ثابت ذخیره کنید
فقط به عدد Loss نگاه نکنید. در پایان هر Epoch، خروجی مجموعهای ثابت از بردارهای نویز را ذخیره کنید.
نرخ یادگیری را جداگانه تنظیم کنید
مولد و تمایزدهنده الزاماً به نرخ یادگیری یکسان نیاز ندارند. اگر یکی از دو شبکه بر دیگری غلبه میکند، تنظیم جداگانه Optimizerها را آزمایش کنید.
داده را بیشازحد دستکاری نکنید
افزایش داده میتواند مفید باشد، اما تبدیلهایی که معنای تصویر را تغییر میدهند ممکن است توزیع نادرستی به مدل آموزش دهند.
Checkpoint منظم بسازید
آموزش GAN ممکن است پس از یک دوره مناسب دوباره ناپایدار شود. ذخیره دورهای مدل اجازه میدهد بهترین نسخه را بر اساس ارزیابی بازیابی کنید.
آزمایشها را ثبت کنید
حداقل این اطلاعات را برای هر اجرا نگه دارید:
- نسخه دیتاست
- معماری مدل
- Seed تصادفی
- نرخ یادگیری
- اندازه Batch
- تعداد Epoch
- تصاویر نمونه
- وزنهای ذخیرهشده
- معیارهای ارزیابی
- نسخه PyTorch و CUDA
خطاهای رایج در پیادهسازی GAN
فراموشکردن detach
هنگام آموزش تمایزدهنده باید تصاویر مولد را با detach() جدا کنید. در غیر این صورت، گرادیانهای غیرضروری در مولد محاسبه میشوند.
استفاده همزمان از Sigmoid و BCEWithLogitsLoss
اگر از BCEWithLogitsLoss استفاده میکنید، Sigmoid را در خروجی تمایزدهنده قرار ندهید.
ناهماهنگی خروجی Tanh و نرمالسازی
اگر مولد از Tanh استفاده میکند، تصاویر واقعی نیز باید به دامنه سازگار تبدیل شوند.
ارزیابی فقط با Loss
Lossهای GAN بهتنهایی کیفیت یا تنوع را نشان نمیدهند. تصاویر، FID، KID و نشانههای Mode Collapse را نیز بررسی کنید.
استفاده از دیتاست بسیار کوچک
یک GAN با ظرفیت بالا میتواند دیتاست کوچک را حفظ کند. کاهش ظرفیت مدل، افزایش داده کنترلشده یا استفاده از روشهای مناسب داده کم را بررسی کنید.
شروع با رزولوشن بالا
آموزش مستقیم تصاویر بزرگ هزینه و پیچیدگی عیبیابی را افزایش میدهد. ابتدا خط لوله را در ابعاد کوچک اعتبارسنجی کنید.
پرسشهای متداول
GAN مخفف چیست؟
GAN مخفف Generative Adversarial Network و به معنای شبکه مولد تخاصمی است.
GAN چگونه تصویر تولید میکند؟
مولد یک بردار تصادفی را به تصویر تبدیل میکند. تمایزدهنده واقعی یا مصنوعیبودن تصویر را میسنجد و بازخورد آن برای بهبود مولد استفاده میشود.
تفاوت Generator و Discriminator چیست؟
Generator داده مصنوعی میسازد؛ اما Discriminator میان داده واقعی و مصنوعی تمایز ایجاد میکند. این دو شبکه با اهداف مخالف آموزش میبینند.
DCGAN چیست؟
DCGAN نوعی GAN مبتنی بر لایههای کانولوشنی است که برای تولید تصویر طراحی شده و از کانولوشنهای معمولی و Transposed Convolution استفاده میکند.
Mode Collapse چیست؟
Mode Collapse زمانی رخ میدهد که مولد فقط چند خروجی شبیه به هم تولید کند و بخش بزرگی از تنوع داده واقعی را پوشش ندهد.
آیا GAN فقط برای تولید تصویر است؟
خیر. GAN میتواند برای دادههای دیگر نیز طراحی شود، اما شناختهشدهترین کاربردهای آن در تولید و تبدیل تصویر قرار دارند.
آیا GAN از Diffusion بهتر است؟
هیچ پاسخ ثابتی وجود ندارد. مدلهای Diffusion برای تولید متنوع و کنترل با متن بسیار قدرتمندند؛ اما GAN ممکن است در تولید سریع، مدلهای کوچکتر و بعضی مسائل تخصصی مناسبتر باشد.
برای آموزش GAN به GPU نیاز داریم؟
آموزش نمونههای بسیار کوچک روی CPU امکانپذیر است، اما برای دیتاست واقعی و تصاویر باکیفیت معمولاً GPU لازم است.
برای ساخت سایت تولید تصویر باید GAN آموزش دهیم؟
معمولاً خیر. برای نسخه اولیه محصول میتوان از API یک مدل آماده استفاده کرد. آموزش GAN زمانی توجیه بیشتری دارد که داده اختصاصی، دامنه محدود و نیاز فنی مشخص داشته باشید.
آیا میتوان مدل تولید تصویر را با API درواره فراخوانی کرد؟
بله، درواره دسترسی یکپارچه به مدلهای هوش مصنوعی را فراهم میکند. مدل و مسیر مناسب را باید بر اساس فهرست فعلی مدلها و مستندات سرویس انتخاب کنید.
جمعبندی
GAN معماری مهمی در هوش مصنوعی مولد است که با رقابت میان Generator و Discriminator آموزش میبیند. مولد داده مصنوعی میسازد و تمایزدهنده تلاش میکند آن را از داده واقعی تشخیص دهد.
برای ساخت یک GAN موفق باید علاوه بر معماری شبکه، به کیفیت دیتاست، تعادل آموزش، تنوع خروجی، Mode Collapse و روش ارزیابی توجه کنید. DCGAN نقطه شروع مناسبی برای یادگیری عملی این مفهوم است، اما پروژههای پیچیدهتر ممکن است به معماریهایی مانند Conditional GAN، WGAN، StyleGAN یا CycleGAN نیاز داشته باشند.
اگر هدف اصلی شما یادگیری و پژوهش است، پیادهسازی DCGAN با PyTorch درک عمیقی از مدلهای مولد ایجاد میکند. اگر میخواهید قابلیت تولید تصویر را سریعتر وارد وبسایت یا اپلیکیشن کنید، استفاده از یک API آماده معمولاً مسیر کوتاهتری است.
با API درواره میتوانید مدلهای مختلف را بدون مدیریت مستقیم زیرساخت پردازشی آزمایش کنید و پس از ارزیابی کیفیت، سرعت و هزینه، مدل مناسب محصول خود را انتخاب کنید.
مقالات مرتبط
- شبکه عصبی کانولوشنی CNN چیست؟
- مدل Diffusion چیست؟
- تولید تصویر با هوش مصنوعی
- راهنمای API تولید تصویر درواره
- PyTorch چیست؟
- Transfer Learning و Fine-tuning با PyTorch
- هوش مصنوعی مولد چیست؟
منابع
- مقاله اصلی Generative Adversarial Networks
- آموزش رسمی DCGAN در PyTorch
- معماری GAN در Google Machine Learning
- مقاله Deep Convolutional GAN
- آموزش DCGAN در TensorFlow
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



