
GQA چیست؟ تفاوت MHA و MQA و آموزش توجه گروهی با PyTorch
GQA چیست و چگونه مصرف حافظه مدلهای زبانی را کاهش میدهد؟ در این راهنما، تفاوت MHA، MQA و Grouped-Query Attention، تأثیر آنها بر KV Cache و پیادهسازی عملی با PyTorchرا بررسی میکنیم.

وقتی یک مدل زبانی پاسخ طولانی تولید میکند، فقط وزنهای مدل حافظه GPU را اشغال نمیکنند. اطلاعات مربوط به توکنهای قبلی نیز باید نگهداری شوند تا مدل بتواند ادامه متن را با توجه به آنها بسازد.
یکی از اجزای مهم این حافظه، KV Cache است. با طولانیترشدن گفتوگو و افزایش تعداد درخواستهای همزمان، حجم این کش میتواند به محدودیتی جدی برای اجرای مدل تبدیل شود.
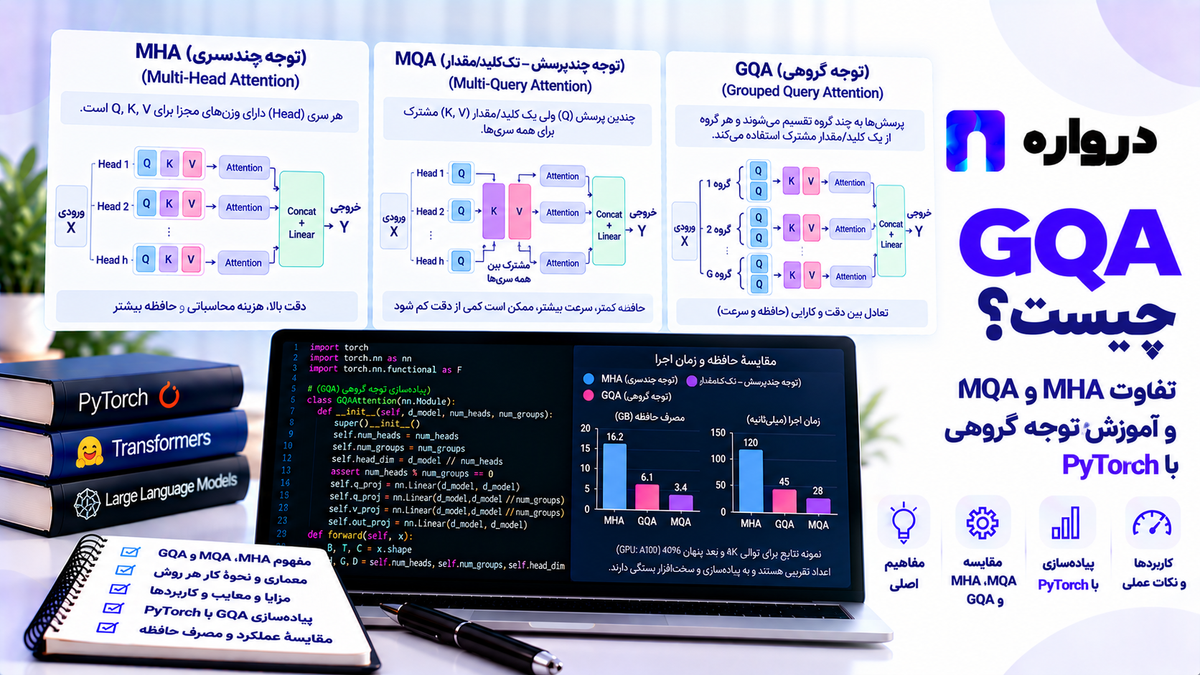
Grouped-Query Attention یا GQA معماریای برای سازوکار توجه است که چند سر Query را به یک مجموعه مشترک از Key و Value متصل میکند. این اشتراکگذاری، تعداد سرهای Key و Value و در نتیجه حجم اطلاعاتی را که باید برای توکنهای گذشته ذخیره شود، کاهش میدهد.
برای فهم GQA باید آن را کنار دو معماری دیگر قرار دهیم:
- MHA: توجه چندسری با Key و Value جدا برای هر سرQuery.
- MQA: چند سر Query با یک سر مشترک Key و یک سر مشترکValue.
- GQA: چند گروه از سرهای Query که هر گروه، Key و Value مشترک دارد.
در این مقاله، این سه ساختار را مقایسه میکنیم، حافظه موردنیاز آنها را با یک مثال عددی محاسبه میکنیم و یک لایه توجه گروهی آموزشی در PyTorch میسازیم.
پیشنیاز: Query، Key و Value چه هستند؟
در سازوکار Attention، نمایش هر توکن به سه نوع بردار تبدیل میشود:
Queryیا پرسوجو
Queryمشخص میکند توکن فعلی به دنبال چه اطلاعاتی در توکنهای دیگر است.
Keyیا کلید
Key نمایش قابلمقایسهای از هر توکن فراهم میکند. مدل با مقایسه Query و Key،میزان ارتباط میان توکنها را محاسبه میکند.
Valueیا مقدار
Valueاطلاعاتی است که پس از تعیین وزن توجه، در ساخت نمایش خروجی مشارکت میکند.
این نامها برای توضیح عملیات شبکه هستند؛ Query یک پرسش متنی مستقل نیست و Value نیز لزوماً معادل معنای قابلتفسیر یک کلمه نیست.
در Multi-Head Attention، این عملیات در چند سر انجام میشود. هر سر میتواند از تصویر متفاوتی از نمایش ورودی استفاده کند و خروجی سرها در پایان با یکدیگر ترکیب میشوند. مقاله اصلی Transformer این ساختار را معرفی کرد. arxiv.org
چرا مدل زبانی به KV Cache نیاز دارد؟
در تولید خودبازگشتی، مدل توکنهای خروجی را بهترتیب میسازد. برای تولید هر توکن جدید، باید به متن قبلی توجه کند.
اگر Key و Value توکنهای گذشته در هر مرحله دوباره محاسبه شوند، بخش قابلتوجهی از محاسبات تکرار خواهد شد. KV Cache این اطلاعات را ذخیره میکند تا در مراحل بعدی دوباره استفاده شوند.
در یک Decoder معمول، کش هر لایه شامل Key و Value توکنهای پردازششده است. با اضافهشدن توکنهای جدید، این کش نیز رشد میکند. مستندات Hugging Face توضیح میدهد که استفاده از کش، محاسبه مجدد اطلاعات قبلی را حذف میکند؛ البته کش جایگزین عملیات توجه توکن جدید به گذشته نمیشود. Hugging Face
این موضوع یک پیامد عملی دارد: مدلی که وزنهای آن داخل حافظه GPU جا میشوند، ممکن است هنگام پردازش چند گفتوگوی طولانی با کمبود حافظه مواجه شود.
MHAچیست؟
Multi-Head Attention یا MHA به معنای توجه چندسری است.
در ساختار رایج MHA، تعداد سرهای Query، Key و Value برابر است. برای مثال، اگر یک لایه ۳۲ سر توجه داشته باشد، معمولاً شامل موارد زیر خواهد بود:
- ۳۲ سرQuery
- ۳۲ سرKey
- ۳۲ سرValue
هر سر Query با Key و Value متناظر خود کار میکند.
مزیت این ساختار، استقلال بیشتر نمایشهای هر سر است. در مقابل، برای توکنهای گذشته باید Key و Value تمام این سرها نگهداری شوند.
نکته مهم این است که «تعداد سر بیشتر» بهتنهایی تضمینکننده کیفیت بالاتر نیست. کیفیت نهایی به کل معماری، داده آموزشی و فرایند آموزش وابسته است.
MQAچیست؟
Multi-Query Attention یا MQA چند سر Query را حفظ میکند، اما همه آنها از یک سر Key و یک سر Value مشترک استفاده میکنند.
در مثال ۳۲ سرQuery:
- تعداد سرهای Query برابر ۳۲ است.
- تعداد سرهای Key برابر یک است.
- تعداد سرهای Value برابر یک است.
بنابراین MQA به معنای داشتن فقط یک سر توجه در تمام شبکه نیست. Queryها همچنان متعدد هستند؛ اشتراکگذاری در بخش Key و Value اتفاق میافتد.
مقاله Fast Transformer Decoding: One Write-Head is All You Need این معماری را برای کاهش نیاز به انتقال داده از حافظه هنگام تولید مرحلهای معرفی کرد. نتایج آن بهبود سرعت را در تنظیمات آزمایششده نشان میدهند، اما نباید آنها را به تمام مدلها و سختافزارها تعمیم داد. arxiv.org
GQAچیست؟
Grouped-Query Attentionیا توجه پرسوجوی گروهی سرهای Query را به چند گروه تقسیم میکند. هر گروه از یک سر Key و یک سر Value مشترک استفاده میکند.
برای مثال، یک لایه میتواند ۳۲ سر Query و ۸ سر Key و Value داشته باشد. در این حالت، هر چهار سر Query از یک جفت Key و Value مشترک استفاده میکنند.
GQAمیان دو حالت قرار میگیرد:
- در MHA، هر Query، Key و Value جداگانه دارد.
- در MQA، تمام Queryها یک Key و Value مشترک دارند.
- در GQA، اشتراکگذاری داخل چند گروه انجام میشود.
مقاله اصلی GQA نشان داد که در آزمایشهای آن، این معماری میتواند کیفیتی نزدیک به MHA و سرعتی قابلمقایسه با MQA ایجاد کند. این نتیجه یک یافته تجربی در شرایط مشخص است، نه تضمینی برای هر مدل. ACL Anthology
مقایسه MHA، GQA وMQA
در جدول زیر، تعداد سرهای Query را در هر سه معماری برابر ۳۲ فرض میکنیم.
| ویژگی | MHA | GQA نمونه | MQA |
|---|---|---|---|
| تعداد سرهای Query | ۳۲ | ۳۲ | ۳۲ |
| تعداد سرهای Key | ۳۲ | ۸ | ۱ |
| تعداد سرهای Value | ۳۲ | ۸ | ۱ |
| Queryهای متصل به هر جفت Key و Value | ۱ | ۴ | ۳۲ |
| حجم نسبی KV Cache با شرایط یکسان | ۱۰۰٪ | ۲۵٪ | حدود ۳٫۱٪ |
| میزان اشتراکگذاری | ندارد | داخل هر گروه | میان تمام Queryها |
درصدهای جدول، محاسبه نظری حجم Key وValue هستند. این اعداد درباره کل حافظه GPU یا سرعت نهایی سامانه اظهار نظر نمیکنند.
مثال عددی: GQA چقدر حافظه کش را کاهش میدهد؟
برای یک مثال فرضی، شرایط زیر را در نظر بگیرید:
- ۳۲ لایه دارایAttention
- ۳۲ سرQuery
- اندازه هر سر برابر۱۲۸
- یک دنباله شامل ۸۱۹۲ توکن
- ذخیره هر مقدار با ۲ بایت
- Key و Valueهماندازه
- نگهداری تمام توکنها در کش تمام لایهها
با این فرضها، حجم خام کش چنین خواهد بود:
| معماری | تعداد سرهای KV | حجم خام KV Cache |
|---|---|---|
| MHA | ۳۲ | ۴ GiB |
| GQA | ۸ | ۱ GiB |
| MQA | ۱ | ۱۲۸ MiB |
این اعداد شامل وزنهای مدل، حافظه موقت عملیات، سربار تخصیص و اطلاعات مدیریتی کش نیستند.
اگر هشت دنباله همطول همزمان فعال باشند و کش آنها مستقل نگهداری شود، حجم خام کش در این مثال هشت برابر میشود.
محاسبه باPython
کد زیر بدون نیاز به کتابخانه جانبی، همین برآورد را انجام میدهد:
def estimate_kv_cache_bytes(
    *,
    batch_size: int,
    sequence_length: int,
    num_layers: int,
    num_kv_heads: int,
    head_dim: int,
    bytes_per_element: int = 2,
) -> int:
    values = (
        batch_size,
        sequence_length,
        num_layers,
        num_kv_heads,
        head_dim,
        bytes_per_element,
    )

    if any(value <= 0 for value in values):
        raise ValueError("All parameters must be positive.")

    return (
        2  # Key and Value
        * batch_size
        * sequence_length
        * num_layers
        * num_kv_heads
        * head_dim
        * bytes_per_element
    )


settings = {
    "batch_size": 1,
    "sequence_length": 8192,
    "num_layers": 32,
    "head_dim": 128,
    "bytes_per_element": 2,
}

for name, kv_heads in [
    ("MHA", 32),
    ("GQA", 8),
    ("MQA", 1),
]:
    size_bytes = estimate_kv_cache_bytes(
        **settings,
        num_kv_heads=kv_heads,
    )

    print(
        f"{name}: "
        f"{size_bytes / 1024**3:.3f} GiB"
    )
خروجی محاسبه:
MHA: 4.000 GiB
GQA: 1.000 GiB
MQA: 0.125 GiB
این برآورد برای ساختار فرضشده مناسب است. در مدلهایی با پنجره لغزان، انواع متفاوت لایه یا کش فشرده، باید ساختار واقعی مدل را در محاسبه لحاظ کرد.
چرا کاهش کش لزوماً به همان نسبت سرعت را افزایش نمیدهد؟
اگر کش از ۴ GiB به ۱ GiB برسد، نمیتوان نتیجه گرفت کل مدل چهار برابر سریعتر شده است.
زمان پاسخ مدل صرف عملیات مختلفی میشود:
- محاسبه نمایش توکنها
- ساخت Query، Key وValue
- اجرایAttention
- اجرای شبکه پیشخور
- جابهجایی داده
- نمونهبرداری توکن
- زمانبندی درخواستها
- ارتباط میان چند GPU، در صورت استفاده
GQAبخشی از این مسیر را تغییر میدهد. بنابراین اثر آن به این بستگی دارد که گلوگاه اجرای مدل در کدام بخش قرار گرفته باشد.
برای تصمیم عملی، باید حافظه مصرفی، زمان پاسخ و کیفیت خروجی را جداگانه اندازه گرفت.
تفاوت اثر GQA در Prefill وDecode
تولید پاسخ معمولاً دو مرحله دارد:
Prefill
مدل متن ورودی را پردازش میکند و اطلاعات لازم برای ادامه تولید را میسازد. در این مرحله، تعداد زیادی توکن ورودی میتوانند در عملیات دستهای شرکت کنند.
Decode
مدل توکنهای جدید را مرحلهبهمرحله تولید میکند و از اطلاعات ذخیرهشده گذشته استفاده میکند.
انگیزه اصلی MQA، کاهش فشار دسترسی به حافظه در تولید مرحلهای بود. در نتیجه، بررسی زمان Decode برای ارزیابی این خانواده معماریها اهمیت ویژهای دارد. arxiv.org
در یک محصول واقعی، دو پرسش متفاوت مطرحاند:
- کاربر چقدر منتظر شروع پاسخ میماند؟
- پس از شروع پاسخ، متن با چه سرعتی تولید میشود؟
یک عدد کلی برای مدت پاسخ، تفاوت این دو تجربه را پنهان میکند.
GQAدر مدلهای واقعی
GQA فقط یک ایده آموزشی نیست. برای نمونه، مستندات رسمی Transformersاستفاده از آن را در مدل Llama 2 با ۷۰میلیارد پارامتر ذکر میکند. huggingface.co
بااینحال، نباید از نام یک خانواده نتیجه گرفت که تمام اعضای آن ساختار Attention یکسانی دارند.
برای بررسی مدل مشخص، معمولاً باید تنظیماتی مانند موارد زیر را بخوانید:
num_attention_headsnum_key_value_headshead_dim، اگر بهصورت مستقل تعریف شده باشد
در تنظیمات Llama، برابر بودن تعداد سرهای Query و KV نشاندهنده MHA است؛ یک سر KV نشاندهنده MQA و تعداد میانی نشاندهنده GQA است. این قاعده را باید در چارچوب معماری همان مدل تفسیر کرد. Hugging Face
بررسی تنظیمات باTransformers
pip install transformersimport os
from transformers import AutoConfig
model_id = os.environ["HF_MODEL_ID"]
config = AutoConfig.from_pretrained(model_id)
query_heads = getattr(
config,
"num_attention_heads",
None,
)
kv_heads = getattr(
config,
"num_key_value_heads",
None,
)
print("Model type:", config.model_type)
print("Query heads:", query_heads)
print("KV heads:", kv_heads)
if query_heads is None or kv_heads is None:
print(
"Read this model's architecture documentation."
)
elif kv_heads == query_heads:
print("Attention type: MHA")
elif kv_heads == 1:
print("Attention type: MQA")
elif 1 < kv_heads < query_heads:
print("Attention type: GQA")
else:
print("Inspect the model implementation.")این کد برای معماریهایی طراحی شده است که از این نامگذاری استفاده میکنند. نبودن یک فیلد، بهتنهایی معماری مدل را مشخص نمیکند.
آموزش GQA باPyTorch
برای فهم عملیات، ابتدا یک پیادهسازی مرجع میسازیم.
شکل Tensorها را چنین در نظر میگیریم:
| Tensor | ترتیب ابعاد |
|---|---|
| Query | Batch، تعداد سر Query، طول Query، اندازه سر |
| Key | Batch، تعداد سر KV، طول Key، اندازه سر |
| Value | Batch، تعداد سر KV، طول Value، اندازه سر |
در مثال ما، Query هشت سر و Key و Value هرکدام دو سر دارند. بنابراین هر چهار سر Query به یک جفت سر KV متصل میشوند.
نصب
pip install torchپیادهسازی مرجع
کد زیر برای شفافبودن عملیات، Key و Value را با repeat_interleave گسترش میدهد. این روش آموزشی، مزیت حافظهای یک کرنل بهینه GQA را در Tensorهای موقت حفظ نمیکند.
import mathimport torchdef reference_gqa( query: torch.Tensor, key: torch.Tensor, value: torch.Tensor, allowed_mask: torch.Tensor | None = None,) -> torch.Tensor: query_heads = query.size(1) kv_heads = key.size(1) if kv_heads != value.size(1): raise ValueError( "Key and Value must have equal head counts." ) if query_heads % kv_heads != 0: raise ValueError( "Query heads must be divisible by KV heads." ) if key.size(-2) != value.size(-2): raise ValueError( "Key and Value lengths must match." ) repeats = query_heads // kv_heads expanded_key = key.repeat_interleave( repeats, dim=1, )ساخت ورودی نمونه
torch.manual_seed(42)batch_size = 2sequence_length = 16query_heads = 8kv_heads = 2head_dim = 32query = torch.randn( batch_size, query_heads, sequence_length, head_dim,)key = torch.randn( batch_size, kv_heads, sequence_length, head_dim,)value = torch.randn_like(key)causal_mask = torch.ones( sequence_length, sequence_length, dtype=torch.bool,).tril()output = reference_gqa( query, key, value, allowed_mask=causal_mask,)شکل خروجی مورد انتظار:
torch.Size([2, 8, 16, 32])خروجی همچنان هشت سر دارد. کمشدن تعداد سرهای KV، تعداد سرهای Query یا خروجی Attention را در این مثال کم نمیکند.
استفاده از GQA درSDPA
PyTorchدر تابع scaled_dot_product_attention پارامتر enable_gqa را ارائه میکند.
مستندات فعلی، بخشپذیری تعداد سرهای Query بر تعداد سرهای Key و برابر بودن تعداد سرهای Key و Value را از محدودیتهای GQA میداند. پشتیبانی اجرای آن نیز به نسخه، Backend و دستگاه وابسته است. PyTorch main documentation
نمونه زیر برای محیط CUDA دارای پشتیبانی مناسب است و به متغیرهای بخش قبلی وابسته است:
import torch.nn.functional as F


if torch.cuda.is_available():
    query_cuda = query.cuda()
    key_cuda = key.cuda()
    value_cuda = value.cuda()

    with torch.inference_mode():
        native_output = F.scaled_dot_product_attention(
            query_cuda,
            key_cuda,
            value_cuda,
            dropout_p=0.0,
            is_causal=True,
            enable_gqa=True,
        )

        reference_output = reference_gqa(
            query_cuda,
            key_cuda,
            value_cuda,
            allowed_mask=causal_mask.cuda(),
        )

    torch.testing.assert_close(
        native_output,
        reference_output,
        rtol=1e-3,
        atol=1e-4,
    )

    print("Outputs are numerically close.")
else:
    print("Run the native example on supported CUDA.")
برابری عددی تقریبی، صحت یک حالت از عملیات را بررسی میکند. این بررسی، کیفیت یک مدل زبانی یا سرعت بهتر روی تمام ورودیها را اثبات نمیکند.
همچنین dropout_p را هنگام ارزیابی صریحاً صفر قرار دهید؛ SDPA مقدار Dropout را از همین آرگومان میگیرد. PyTorch main documentation
ساخت یک لایه آموزشیGQA
در لایه کاملتر، ابتدا نمایش ورودی به Query، Key و Value تبدیل میشود. سپس خروجی سرها کنار هم قرار میگیرد و از یک تبدیل خروجی عبور میکند.
کلاس زیر از تابع مرجع قبلی استفاده میکند:
from torch import nnclass EducationalGQA(nn.Module): def __init__( self, hidden_size: int = 256, query_heads: int = 8, kv_heads: int = 2, ): super().__init__() if hidden_size % query_heads != 0: raise ValueError( "hidden_size must divide into query heads." ) if query_heads % kv_heads != 0: raise ValueError( "query_heads must be divisible by kv_heads." ) self.query_heads = query_heads self.kv_heads = kv_heads self.head_dim = hidden_size // query_heads self.query_projection = nn.Linear( hidden_size, query_heads * self.head_dim, bias=False, ) self.key_projection = nn.Linear( hidden_size, kv_heads * self.head_dim, bias=False,استفاده:
layer = EducationalGQA( hidden_size=256, query_heads=8, kv_heads=2,)hidden_states = torch.randn(2, 16, 256)result = layer(hidden_states)print(result.shape)شکل خروجی مورد انتظار:
torch.Size([2, 16, 256])این کلاس فقط سازوکار توجه را نشان میدهد. یک مدل زبانی کامل به اجزای دیگری مانند اطلاعات موقعیت، اتصال باقیمانده، نرمالسازی، شبکه پیشخور، مدیریت Padding و کش نیاز دارد. کدها در محیط نگارش این مقاله اجرا نشدهاند.
نکته مهم: ماسک تولید مرحلهای با ماسک آموزش یکسان نیست
در مثال بالا، طول Query و Key برابر بود و ماسک مثلثی برای توجه علّی مناسب بود.
اما هنگام Decode ممکن است Query فقط یک توکن داشته باشد و Key شامل تمام توکنهای گذشته بهعلاوه توکن فعلی باشد.
در این حالت، توکن جدید باید بتواند به تمام موقعیتهای مجاز گذشته توجه کند. استفاده بیبررسی از یک ماسک مثلثی با ابعاد نامساوی میتواند اتصالها را اشتباه محدود کند.
مستندات SDPA رفتار is_causal=True را برای ماتریسهای غیرمربعی با تراز بالای چپ توضیح میدهد. بنابراین نباید آن را بدون توجه به موقعیت واقعی Query، جایگزین ماسک کش کرد. PyTorch main documentation
برای یک Query که دقیقاً آخرین توکن است و Key فقط گذشته و همان توکن را در بر میگیرد، تمام این Keyها میتوانند مجاز باشند. در تولید چندتوکنی یا Batch دارای Padding، منطق ماسک باید متناسب با موقعیت هر نمونه ساخته شود.
آیا میتوان MHA را با تغییر تنظیمات به GQA تبدیل کرد؟
تغییر عدد num_key_value_heads در یک فایل تنظیمات، تبدیل معتبر مدل محسوب نمیشود.
این تغییر روی ابعاد وزنهای Key و Value اثر میگذارد. حتی اگر وزنها با یک روش ساده کوچک شوند، مدل حاصل باید از نظر کیفیت بررسی شود.
مقاله GQA روشی برای تبدیل Checkpointهای MHA و ادامه آموزش آنها ارائه میکند. در تنظیمات مطالعه، این ادامه آموزش با بخشی از هزینه پیشآموزش اصلی انجام شد. بنابراین تبدیل معماری با فعالکردن یک گزینه هنگام استنتاج تفاوت دارد. ACL Anthology
برای استفاده عملی، معمولاً انتخاب Checkpointی که از ابتدا با GQA آموزش دیده یا بهصورت معتبر تبدیل شده، مسیر روشنتری است.
تفاوت GQA وFlashAttention
این دو فناوری مسئله یکسانی را حل نمیکنند.
| معیار | GQA | FlashAttention |
|---|---|---|
| موضوع اصلی | نحوه اشتراک سرهای Key و Value | شیوه اجرای عملیات Attention |
| تغییر معماری سرها | بله | الزاماً خیر |
| کاهش حجم خام KV Cache | با کاهش سرهای KV | هدف اصلی آن نیست |
| تمرکز اصلی | ساختار نمایشهای KV | کاهش جابهجایی حافظه و ذخیرهسازی میانی |
| امکان استفاده همزمان | با Backend سازگار | با معماری و Backend سازگار |
FlashAttention یک روش محاسبه Attention دقیق با توجه به هزینه دسترسی به حافظه است؛ مفهوم آن بهخودیخود معادل کمکردن تعداد سرهای KVنیست. arxiv.org
در نتیجه، یک مدل میتواند GQA داشته باشد و همزمان از اجرای بهینه Attention استفاده کند.
تفاوت GQA وPagedAttention
GQA تعیین میکند برای هر توکن چند سر Key و Valueتولید شود.
PagedAttention به مدیریت حافظه کش در سامانه ارائه مدل میپردازد. مقاله آن روشی برای کاهش اتلاف حافظه و مدیریت انعطافپذیرتر KV Cache در خدمتدهی مدلهای زبانی ارائه میکند. arxiv.org
در یک مثال ساده:
- GQA میتواند اندازه اطلاعات KVهر توکن را کاهش دهد.
- مدیریت صفحهای میتواند نحوه تخصیص و استفاده از حافظه آن اطلاعات را بهبود دهد.
این دو اثر را نباید در گزارش عملکرد با یکدیگر اشتباه گرفت.
GQAچه چیزی را درباره کیفیت فارسی مشخص میکند؟
وجود GQA در معماری یک مدل، بهتنهایی نشان نمیدهد که آن مدل فارسی را خوب میفهمد.
برای انتخاب مدل فارسی، یک مجموعه ارزیابی متناسب با محصول بسازید. برای نمونه:
| وظیفه | نمونه ارزیابی |
|---|---|
| خلاصهسازی | حفظ نکات اصلی یک متن فارسی |
| استخراج اطلاعات | استخراج تاریخ، مبلغ و نام از متن |
| پاسخ مبتنی بر سند | استفاده درست از اطلاعات ارائهشده |
| پیروی از دستور | رعایت تعداد بندها و قالب خروجی |
| بازنویسی | حفظ معنا و تغییر لحن |
| گفتوگو | استفاده درست از سابقه مکالمه |
این پیشنهاد، یک روش ارزیابی محصول است: ابتدا کیفیت موردنیاز را مشخص کنید و سپس هزینه و سرعت مدلهای دارای کیفیت قابلقبول را مقایسه کنید.
نام معماری باید به فهم ویژگیهای فنی کمک کند؛ تصمیم نهایی را نتیجه آزمایش روی کار واقعی تعیین میکند.
چگونه عملکرد یک مدل GQA را ارزیابی کنیم؟
شرایط آزمایش را ثابت نگه دارید
برای مقایسه قابلتفسیر، موارد زیر را ثبت کنید:
- نسخه دقیق مدل
- GPUو مقدار حافظه
- نسخه موتور استنتاج
- نوع داده وزنها و کش
- طول ورودی
- تعداد توکن خروجی
- تعداد درخواست همزمان
- تنظیمات نمونهبرداری
- نوع کرنلAttention
حافظه و زمان را جدا گزارش کنید
سه خروجی مستقل داشته باشید:
- مصرف حافظه در طولهای مختلف متن.
- زمان شروع و تکمیل پاسخ.
- کیفیت پاسخ در وظایف موردنظر.
چند طول ورودی را آزمایش کنید
یک آزمایش با ورودی کوتاه، رفتار مدل در گفتوگوی طولانی را نشان نمیدهد. ورودیهای کوتاه، متوسط و نزدیک به محدوده عملی محصول را جدا بررسی کنید.
میانگین را کافی ندانید
برای تجربه کاربر، پاسخهای کند نیز اهمیت دارند. علاوه بر میانگین، صدکهای تأخیر و تعداد درخواست ناموفق را ثبت کنید.
نتیجه را به کل معماری نسبت ندهید
اگر دو مدل در داده آموزشی، اندازه و موتور اجرا متفاوتاند، نتیجه مقایسه فقط اثر GQA را جدا نمیکند. برای بررسی علمی این اثر، به آزمایشی با کنترل متغیرهای دیگر نیاز دارید.
اشتباهات رایج دربارهGQA
اشتباهگرفتن سر Query با سرKV
مدلی با ۳۲ سر Query و ۸ سر KV، هشت سر Query ندارد.
تعمیم کاهش کش به کل حافظه
کاهش ۷۵ درصدی حجم خام KV Cache، به معنای کاهش ۷۵ درصدی کل حافظه مدل نیست.
فرض افزایش سرعت متناسب با کاهش حافظه
اثر سرعت باید اندازهگیری شود؛ نسبت حجم کش، نتیجه Benchmark نیست.
ذخیره Key و Value گسترشیافته
اگر در یک پیادهسازی آموزشی Key و Value را تکرار کردهاید، نگهداری نسخه تکرارشده بهعنوان کش، هدف اشتراکگذاری را از بین میبرد.
تغییر معماری بدون وزن سازگار
تنظیمات GQA باید با وزنها و پیادهسازی مدل هماهنگ باشند.
نتیجهگیری درباره کیفیت از روی تعداد سرها
تعداد سر KV بهتنهایی معیار رتبهبندی مدل برای فارسی، برنامهنویسی یا استدلال نیست.
استفاده از مدلهای زبانی با API درواره
دانستن GQA برای فهم محدودیتهای زیرساخت و انتخاب مدل مفید است. بااینحال، برای آزمایش یک مدل در برنامه، لازم نیست از ابتدا لایه Attention و سامانه خدمتدهی آن را پیادهسازی کنید.
درواره رابط API یکپارچهای برای دسترسی به مدلهای هوش مصنوعی ارائه میکند و در نمونه رسمی آن، استفاده از کتابخانه OpenAI با آدرس پایه درواره نشان داده شده است. darvareh.ir
نصب کتابخانه
pip install openaiمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_AVAILABLE_MODEL_ID"
ارسال یک درخواست فارسی
import osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1",)response = client.chat.completions.create( model=os.environ["DARVAREH_CHAT_MODEL"], messages=[ { "role": "user", "content": ( "تفاوت MHA، MQA و GQA را " "در سه بند کوتاه فارسی توضیح بده. " "کاهش حافظه را از افزایش سرعت " "جدا بررسی کن." ), }, ],)print(response.choices[0].message.content)شناسه مدل و قابلیتهای آن را از فهرست مدلها و مستندات درواره بررسی کنید.
برای مقایسه کاربردی، همین مجموعه پرسشها را روی چند مدل اجرا کنید و پاسخها را با معیار ثابت بسنجید. اگر معماری داخلی مدلی مستند نشده است، از سرعت پاسخ آن نمیتوان نتیجه گرفت که از GQA استفاده میکند.
پرسشهای متداول
GQAچیست؟
GQA نوعی Attention است که چند سر Query را در گروههایی قرار میدهد و برای هر گروه، Key و Valueمشترک به کار میبرد.
تفاوت اصلی GQA و MHA چیست؟
در MHA رایج، هر سر Query، Key و Value متناظر جداگانه دارد. در GQA، چند سر Query از یک جفت سر KV مشترک استفاده میکنند.
تفاوت GQA و MQA چیست؟
MQA یک سر Key و یک سر Value مشترک برای تمام Queryها دارد. GQA چند جفت سر KVدارد و اشتراکگذاری را داخل گروهها انجام میدهد.
آیا GQA تعداد سرهای Query را کاهش میدهد؟
الزاماً خیر. در مثال این مقاله، تعداد Queryها ثابت است و تعداد سرهای KV کاهش مییابد.
آیا GQA کل حافظه مدل را چهار برابر کمتر میکند؟
خیر. در مثال فرضی ما، حجم خام KV Cache چهار برابر کمتر شد. وزنها و سایر مصرفکنندگان حافظه همچنان وجود دارند.
آیا GQA همیشه سریعتر است؟
نتیجه به مدل، سختافزار، کرنل، طول متن و تعداد درخواست همزمان وابسته است و باید آزمایش شود.
آیا میتوان GQA را در API فعال کرد؟
معمولاً GQA ویژگی معماری مدل است. اگر سرویس تنظیم مشخصی برای آن ارائه نکرده باشد، با اضافهکردن یک پارامتر دلخواه نمیتوان ساختار مدل را تغییر داد.
آیا GQA و FlashAttention با هم قابلاستفادهاند؟
در صورت پشتیبانی پیادهسازی و Backend، بله. آنها به دو جنبه متفاوت از Attention میپردازند.
آیا کد آموزشی این مقاله یک مدل زبانی کامل است؟
خیر. کد، عملیات توجه گروهی را نشان میدهد و برای ساخت مدل کامل به اجزای بیشتری نیاز دارد.
جمعبندی
MHA، MQA و GQA در نحوه ارتباط سرهای Query با Key و Value تفاوت دارند. MHA استقلال بیشتری به سرهای KV میدهد، MQA آنها را به یک جفت مشترک محدود میکند و GQAاشتراکگذاری را در چند گروه انجام میدهد.
کاهش تعداد سرهای KV میتواند حجم خام کش را بهطور قابلتوجهی کاهش دهد. بااینحال، کاهش حافظه کش، افزایش سرعت کل مدل و حفظ کیفیت سه موضوع جدا هستند و هرکدام به بررسی مستقل نیاز دارند.
برای انتخاب مدل، کیفیت پاسخ در کار واقعی را بسنجید و سپس سرعت، هزینه و ظرفیت اجرای آن را مقایسه کنید.
اگر میخواهید این مقایسه را در برنامه یا محصول خود آغاز کنید، مدلهای در دسترس و راهنمای اتصال API را در درواره بررسی کنید؛ یک مجموعه ارزیابی فارسی بسازید و مدل مناسب کاربردتان را با معیارهای روشن انتخاب کنید.
مقالات مرتبط
- معماری Transformer و سازوکارAttention
- مدل زبانی بزرگ چیست؟
- استنتاج در هوش مصنوعی چیست؟
- پنجره زمینه چیست؟
- آموزش اجرای مدل زبانی باvLLM
- کوانتیزهسازی مدلهای هوش مصنوعی
- ارزیابی مدلهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- Attention Is All You Need
- Fast Transformer Decoding: One Write-Head is All You Need
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- مستندات رسمیPyTorch: Scaled Dot Product Attention
- مستندات رسمی Hugging Face: سازوکار کش
- مستندات رسمی Hugging Face: معماریLlama
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- وبسایت رسمی درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدلها و کتابخانهها و صفحه سلب مسئولیت را مطالعه کنید.



