
مدل دیفیوژن چیست؟ نحوه ساخت تصویر و ویدئو با Diffusion Models
مدل دیفیوژن یکی از مهمترین فناوریهای پشت ابزارهای تولید تصویر و ویدئو با هوش مصنوعی است. در این راهنمای جامع، فرایند افزودن و حذف نویز، DDPM، DDIM، Latent Diffusion، Stable Diffusion، U-Net، VAE، Flow Matching را همراه با مثال عملی و کد پایتون بررسی میکنیم.

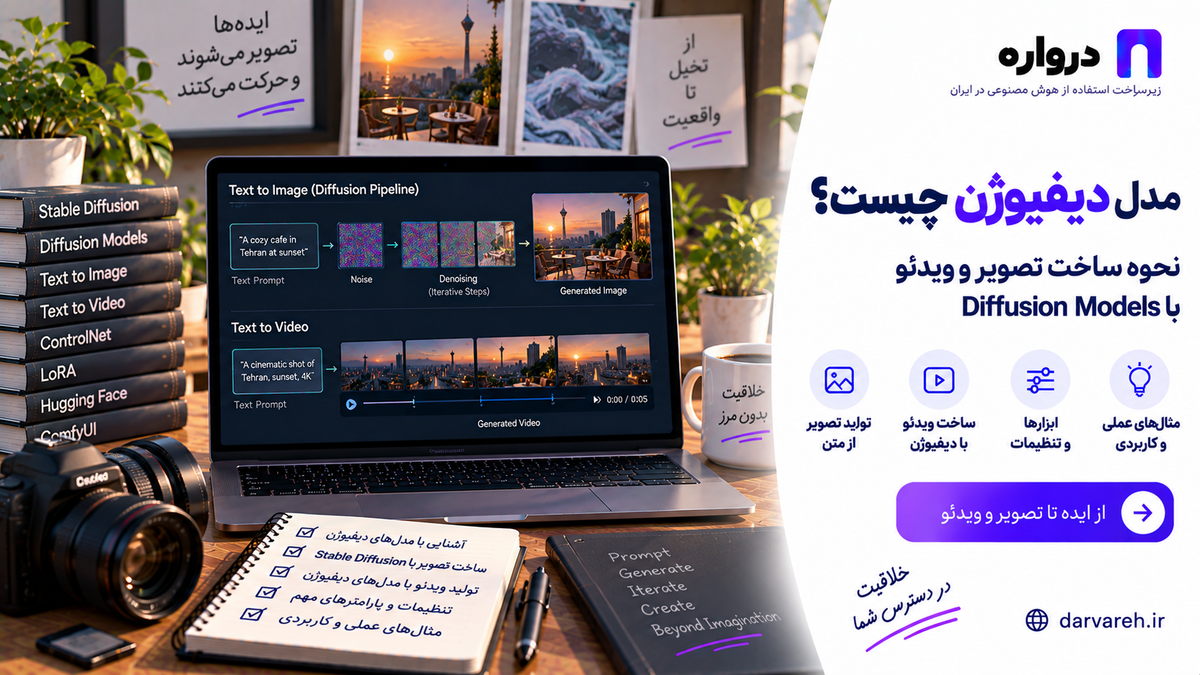
وقتی از یک مدل هوش مصنوعی میخواهید «یک شهر آیندهنگرانه در شب» یا «یک ویدئوی سینمایی از حرکت دوربین میان کوهها» بسازد، خروجی معمولاً بهصورت مستقیم و یکمرحلهای تولید نمیشود.
در بسیاری از مدلهای مولد، فرایند از یک تصویر یا نمایش کاملاً نویزی آغاز میشود. مدل طی چند مرحله نویز را کاهش میدهد تا به ساختاری برسد که با توضیح کاربر هماهنگ باشد.
خانوادهای از مدلهای مولد که بر چنین فرایندی تکیه دارند، Diffusion Models یا مدلهای دیفیوژن نامیده میشوند.
مدلهای دیفیوژن در سالهای اخیر در کاربردهای زیر نقش مهمی داشتهاند:
- تولید تصویر از متن
- تبدیل تصویر به تصویر
- ویرایش و بازسازی تصویر
- حذف یا اضافهکردن اشیا
- افزایش وضوح تصویر
- رنگیکردن تصاویر
- تولید ویدئو از متن
- متحرکسازی تصویر
- تولید صوت و موسیقی
- ساخت مدل سهبعدی
- تولید داده مصنوعی
در این مقاله میخوانید:
- مدل دیفیوژن چیست؟
- چرا در فرایند تولید، نویز اضافه و حذف میشود؟
- Forward Diffusion و Reverse Diffusion چگونه کار میکنند؟
- DDPM و DDIM چه تفاوتی دارند؟
- Latent Diffusion چیست؟
- Stable Diffusion چگونه کار میکند؟
- U-Net، VAE، Text Encoder و Scheduler چه وظیفهای دارند؟
- Guidance Scale و Seed چگونه روی خروجی اثر میگذارند؟
- Diffusion Transformer یا DiT چیست؟
- تفاوت Diffusion با Flow Matching چیست؟
- مدلهای دیفیوژن چگونه ویدئو تولید میکنند؟
- چگونه با Python و Diffusers یک تصویر بسازیم؟
- چگونه از طریق API درواره به مدلهای تولید تصویر متصل شویم؟
مدل دیفیوژن چیست؟
مدل دیفیوژن نوعی مدل مولد است که یاد میگیرد داده را از یک وضعیت نویزی بازسازی کند.
ایده اصلی را میتوان در دو فرایند خلاصه کرد:
- در فرایند روبهجلو، به داده واقعی بهتدریج نویز اضافه میشود.
- در فرایند معکوس، مدل یاد میگیرد این نویز را مرحلهبهمرحله حذف کند.
برای یک تصویر، مسیر روبهجلو چنین است:
تصویر واقعی
    ↓
کمی نویز
    ↓
نویز بیشتر
    ↓
تصویر تقریباً نامشخص
    ↓
نویز تقریباً کامل
فرایند تولید تصویر مسیر معکوس را طی میکند:
نویز تصادفی
↓
کاهش تدریجی نویز
↓
ساختارهای اولیه
↓
اشیا، رنگها و جزئیات
↓
تصویر نهایی
مدل Denoising Diffusion Probabilistic Model یا DDPM یکی از پایههای اصلی مدلهای دیفیوژن مدرن است. مقاله DDPM تولید نمونههای تصویری را با یادگیری فرایند حذف تدریجی نویز توضیح میدهد.
چرا از نویز برای ساخت تصویر استفاده میشود؟
در نگاه اول، تخریب یک تصویر و تبدیل آن به نویز ممکن است غیرمنطقی به نظر برسد. هدف از این کار ساخت یک مسئله آموزشی قابلیادگیری است.
اگر از مدل بخواهیم بدون هیچ فرایند میانی، یک تصویر کامل را مستقیماً از یک عدد تصادفی بسازد، مسئله بسیار پیچیده خواهد بود.
در مدل دیفیوژن، این مسئله بزرگ به مجموعهای از مسائل کوچکتر تبدیل میشود:
در هر مرحله مقدار محدودی نویز را تشخیص بده و حذف کن.
مدل با مشاهده تعداد زیادی تصویر در سطوح مختلف نویز، یاد میگیرد:
- چه الگوهایی متعلق به تصویر واقعی هستند؛
- چه بخشهایی نویز محسوب میشوند؛
- چگونه از یک ورودی نویزی به نمونهای شبیه دادههای آموزشی برسد؛
- چگونه فرایند را بر اساس متن، تصویر یا شرط دیگری هدایت کند.
مدل فقط یک فیلتر ساده حذف نویز نیست. در زمان تولید، از الگوهایی که در داده آموزشی آموخته است برای ساخت محتوایی جدید استفاده میکند.
Forward Diffusion چیست؟
Forward Diffusion یا فرایند انتشار روبهجلو، داده واقعی را در چند مرحله به نویز تبدیل میکند.
فرض کنید تصویر اصلی را با x0x_0 نشان دهیم. در هر مرحله مقدار کمی نویز گاوسی اضافه میشود:
q(xt∣xt−1)=N(xt;1−βtxt−1,βtI)q(x_t|x_{t-1}) = \mathcal{N} \left( x_t; \sqrt{1-\beta_t}x_{t-1}, \beta_t I \right)
در این رابطه:
- x0x_0 تصویر اصلی است؛
- xtx_t تصویر نویزی در مرحله tt است؛
- βt\beta_t مقدار نویز اضافهشده در آن مرحله است؛
- II ماتریس همانی است؛
- N\mathcal{N} توزیع نرمال را نشان میدهد.
با افزایش tt، تصویر اصلی کمتر قابلتشخیص میشود.
ویژگی مهم DDPM این است که میتوان نمونه نویزی مرحله tt را مستقیماً از تصویر اصلی محاسبه کرد:
xt=αˉtx0+1−αˉtϵx_t = \sqrt{\bar{\alpha}_t}x_0 + \sqrt{1-\bar{\alpha}_t}\epsilon
که در آن:
- ϵ\epsilon نویز تصادفی گاوسی است؛
- αt=1−βt\alpha_t = 1-\beta_t؛
- αˉt\bar{\alpha}_t حاصلضرب تجمعی مقادیر α\alpha تا مرحله tt است.
این رابطه باعث میشود برای آموزش، لازم نباشد مدل همه مراحل قبلی را یکییکی اجرا کند. میتوان مستقیماً یک مرحله تصادفی انتخاب و نسخه نویزی همان مرحله را ساخت.
Reverse Diffusion چیست؟
Reverse Diffusion فرایندی است که مدل در آن تلاش میکند از نویز به داده واقعی برسد.
فرایند تولید معمولاً با یک نمونه تصادفی آغاز میشود:
xT∼N(0,I)x_T \sim \mathcal{N}(0,I)
سپس مدل در هر مرحله نویز موجود را تخمین میزند و Scheduler بر اساس این تخمین، نمونهای کمی تمیزتر ایجاد میکند:
xT → xT-1 → xT-2 → ... → x1 → x0
مدل عصبی را میتوان به شکل زیر نمایش داد:
ϵθ(xt,t,c)\epsilon_\theta(x_t,t,c)
در این رابطه:
- xtx_t نمونه نویزی فعلی است؛
- tt مرحله زمانی است؛
- cc شرط اختیاری مانند متن ورودی است؛
- θ\theta پارامترهای مدل است؛
- خروجی، نویز یا کمیت مرتبطی است که مدل پیشبینی میکند.
در بسیاری از تنظیمات آموزشی، مدل تلاش میکند تفاوت میان نویز واقعی و نویز پیشبینیشده را کاهش دهد:
L=E[∥ϵ−ϵθ(xt,t,c)∥2]L = \mathbb{E} \left[ \|\epsilon - \epsilon_\theta(x_t,t,c)\|^2 \right]
در پیادهسازیهای جدید، مدل ممکن است بهجای نویز خام، نمونه تمیز، سرعت یا پارامترسازی دیگری را پیشبینی کند. بنابراین همه مدلهای جدید دقیقاً از یک هدف آموزشی یکسان استفاده نمیکنند.
یک مثال ساده از فرایند آموزش
فرض کنید یک تصویر گربه در مجموعه آموزشی وجود دارد.
در یک مرحله آموزش:
- یک زمان تصادفی مانند t=600t=600 انتخاب میشود.
- مقدار متناظر نویز به تصویر اضافه میشود.
- نسخه نویزی تصویر به مدل داده میشود.
- شماره مرحله یا Time Embedding نیز به مدل داده میشود.
- اگر مدل شرطی باشد، متن توضیحی تصویر هم وارد میشود.
- مدل نویز اضافهشده را پیشبینی میکند.
- اختلاف نویز واقعی و پیشبینیشده محاسبه میشود.
- پارامترهای مدل برای کاهش این اختلاف بهروزرسانی میشوند.
این فرایند برای تصاویر و مراحل زمانی مختلف تکرار میشود.
مدل بهتدریج یاد میگیرد در هر سطح نویز چه ساختارهایی محتملاند.
مدل دیفیوژن چگونه از متن تصویر میسازد؟
برای ساخت تصویر از متن، فقط یادگیری حذف نویز کافی نیست. مدل باید بداند خروجی باید با چه توضیحی هماهنگ باشد.
فرض کنید Prompt چنین باشد:
یک روباه نارنجی در جنگل مهآلود، نور سینمایی، نمای نزدیک
فرایند معمول:
Prompt
↓
Tokenizer
↓
Text Encoder
↓
Text Embeddings
↓
شرطدهی فرایند حذف نویز
↓
Latent یا تصویر نهایی
Text Encoder متن را به مجموعهای از بردارها تبدیل میکند. مدل حذف نویز از این بردارها برای هدایت تصویر به سمت مفاهیم موردنظر استفاده میکند.
این ارتباط معمولاً با Attention یا Cross-Attention برقرار میشود. برای مثال، هنگام ساخت بخش مربوط به روباه، مدل میتواند به توکنهای «روباه» و «نارنجی» توجه کند؛ برای پسزمینه نیز توکنهای «جنگل» و «مهآلود» اهمیت بیشتری خواهند داشت.
اجزای اصلی یک Pipeline تولید تصویر
یک Pipeline مدرن تولید تصویر ممکن است چند مدل و مؤلفه جداگانه داشته باشد.
مستندات Hugging Face Diffusers توضیح میدهند که Pipelineها اجزایی مانند مدل حذف نویز، Scheduler، VAE، Tokenizer و Text Encoder را به یک فرایند انتهابهانتها متصل میکنند.
Tokenizer
متن Prompt را به توکنها و شناسههای عددی تبدیل میکند.
Text Encoder
توکنها را به بردارهای معنایی تبدیل میکند. این بردارها اطلاعاتی درباره موضوع، صفت، سبک و روابط موجود در Prompt حمل میکنند.
مدل حذف نویز
در معماریهای قدیمیتر و بسیاری از مدلهای شناختهشده، این بخش یک U-Net شرطی است. مدلهای جدیدتر ممکن است از Transformer یا معماری ترکیبی استفاده کنند.
VAE
Variational Autoencoder تصویر را میان فضای پیکسلی و فضای نهفته جابهجا میکند:
Pixel Image
    ↓ Encoder
Latent Representation
    ↓ Decoder
Pixel Image
Scheduler یا Sampler
مشخص میکند در هر مرحله چگونه از پیشبینی مدل برای حرکت از نمونه نویزی به نمونه تمیزتر استفاده شود.
Guidance
میزان اثر شرط متنی یا ورودی دیگر را بر فرایند تولید کنترل میکند.
U-Net چیست؟
U-Net نوعی معماری شبکه عصبی است که ابتدا برای بخشبندی تصویر معرفی شد، اما نسخههای توسعهیافته آن در مدلهای دیفیوژن برای پیشبینی نویز نیز استفاده شدند.
ساختار U-Net دو مسیر اصلی دارد:
ورودی
  ↓
کاهش ابعاد و استخراج ویژگی
  ↓
نمایش میانی
  ↓
افزایش ابعاد و بازسازی
  ↓
خروجی
Skip Connectionها ویژگیهای مسیر کاهش ابعاد را به لایههای متناظر مسیر بازسازی منتقل میکنند. این ارتباط به حفظ اطلاعات مکانی کمک میکند.
U-Net در مدل دیفیوژن ممکن است اطلاعات زیر را دریافت کند:
- نمونه نویزی فعلی
- شماره مرحله زمانی
- بردارهای متن
- اطلاعات تصویر مرجع
- نقشه عمق یا لبه
- ماسک ویرایش
- سایر شرطهای کنترلی
بااینحال، نباید تصور کرد همه مدلهای دیفیوژن از U-Net استفاده میکنند. نسل جدیدی از مدلها از Transformer بهعنوان ستون اصلی حذف نویز یا پیشبینی جریان استفاده میکنند.
Latent Diffusion چیست؟
مدل دیفیوژن میتواند فرایند حذف نویز را مستقیماً روی پیکسلهای تصویر انجام دهد. مشکل این روش، هزینه بالای محاسبات برای تصاویر بزرگ است.
برای یک تصویر RGB با ابعاد ۱۰۲۴ در ۱۰۲۴، مدل باید روی میلیونها مقدار پیکسلی عملیات انجام دهد.
Latent Diffusion فرایند را به فضای فشردهتری منتقل میکند:
تصویر
  ↓ VAE Encoder
Latent فشرده
  ↓ Diffusion Process
Latent تولیدشده
  ↓ VAE Decoder
تصویر نهایی
در این روش:
- VAE تصویر را به یک نمایش نهفته کوچکتر تبدیل میکند.
- مدل دیفیوژن در فضای نهفته آموزش میبیند.
- Latent نهایی با Decoder به تصویر پیکسلی تبدیل میشود.
مقاله High-Resolution Image Synthesis with Latent Diffusion Models نشان داد که اجرای دیفیوژن در فضای نهفته میتواند هزینه محاسبات را نسبت به کار مستقیم در فضای پیکسلی کاهش دهد و همچنان برای وظایفی مانند تولید تصویر، Inpainting و Super-resolution خروجی رقابتی ایجاد کند.
Stable Diffusion چیست؟
Stable Diffusion نام خانوادهای از مدلهای تولید تصویر است که نسلهای شناختهشده اولیه آنها بر Latent Diffusion تکیه داشتند.
یک Pipeline کلاسیک Stable Diffusion شامل اجزای زیر است:
- Tokenizer
- Text Encoder
- VAE
- U-Net شرطی
- Scheduler
- مکانیزم Guidance
مستندات Diffusers برای Pipeline کلاسیک Stable Diffusion نیز همین اجزای اصلی را فهرست میکنند.
فرایند کلی:
Prompt
↓
Text Embedding
↓
نویز تصادفی در فضای Latent
↓
حذف چندمرحلهای نویز
↓
Latent نهایی
↓
VAE Decoder
↓
تصویر
Stable Diffusion یک نام مشخص برای یک خانواده مدل است؛ درحالیکه Diffusion Model یک دسته کلی از روشهای مدلسازی مولد محسوب میشود.
تفاوت Pixel Diffusion و Latent Diffusion
| معیار | Pixel Diffusion | Latent Diffusion |
|---|---|---|
| فضای پردازش | پیکسل | فضای نهفته فشرده |
| هزینه محاسبات | معمولاً بیشتر | معمولاً کمتر |
| نیاز به VAE | الزامی نیست | دارد |
| حفظ جزئیات | مستقیم روی پیکسل | وابسته به کیفیت VAE |
| تولید وضوح بالا | پرهزینهتر | عملیتر |
| پیچیدگی Pipeline | کمتر | بیشتر |
Latent Diffusion رایگان نیست؛ فشردهسازی ممکن است بخشی از جزئیات را تغییر دهد و کیفیت خروجی به توان VAE نیز وابسته است.
DDPM چیست؟
DDPM مخفف Denoising Diffusion Probabilistic Model است.
ویژگیهای اصلی:
- فرایند روبهجلو مارکوفی برای افزودن نویز
- فرایند معکوس آموختنی
- تولید نمونه از نویز تصادفی
- استفاده از چند مرحله حذف نویز
- کیفیت مناسب در ازای نمونهگیری نسبتاً کند در نسخه پایه
DDPM پایه مفهومی بسیاری از مدلهای دیفیوژن است، اما در محیط عملی اغلب از Samplerها و Schedulerهای سریعتر استفاده میشود.
DDIM چیست؟
DDIM مخفف Denoising Diffusion Implicit Model است.
هدف اصلی آن کاهش تعداد مراحل موردنیاز برای نمونهگیری است. مقاله DDIM روشی را معرفی کرد که میتواند با همان هدف آموزشی DDPM، از فرایند نمونهگیری متفاوت و سریعتری استفاده کند.
تفاوت ساده:
| ویژگی | DDPM | DDIM |
|---|---|---|
| فرایند نمونهگیری | تصادفیتر | میتواند قطعیتر باشد |
| تعداد مراحل | معمولاً بیشتر | قابل کاهش |
| سرعت | کندتر در نسخه پایه | سریعتر |
| بازتولید با Seed | وابسته به تنظیمات | قابلکنترلتر در حالت قطعی |
| کاربرد | پایه آموزشی و تولید | استنتاج سریعتر و ویرایش |
امروزه Schedulerهای بیشتری نیز وجود دارند و انتخاب بهترین گزینه به مدل، تعداد مراحل و هدف کیفیت یا سرعت بستگی دارد.
Scheduler در مدل دیفیوژن چیست؟
Scheduler تعیین میکند:
- در چه Time Stepهایی نمونهگیری انجام شود؛
- میزان نویز هر مرحله چقدر باشد؛
- خروجی مدل چگونه به نمونه مرحله بعد تبدیل شود؛
- فرایند با چند مرحله به پایان برسد.
مدل عصبی و Scheduler یک چیز نیستند.
مدل عصبی نویز، سرعت یا کمیت مرتبط را پیشبینی میکند. Scheduler از این پیشبینی برای بهروزرسانی نمونه استفاده میکند.
به همین دلیل ممکن است یک مدل واحد با Schedulerهای مختلف اجرا شود و نتایج متفاوتی از نظر سرعت، جزئیات و پایداری ایجاد کند. مستندات Diffusers نیز امکان جایگزینی Scheduler در Pipeline را نشان میدهند.
Sampling Step چیست؟
Sampling Step تعداد دفعاتی است که مدل در فرایند تولید برای کاهش نویز اجرا میشود.
برای مثال:
۲۰ Steps
۳۰ Steps
۵۰ Steps
افزایش Steps معمولاً محاسبات و زمان تولید را بیشتر میکند، اما کیفیت همیشه بهصورت خطی افزایش نمییابد.
در یک مدل و Scheduler مشخص ممکن است:
- Steps بسیار کم، خروجی ناقص ایجاد کند؛
- Steps متوسط، تعادل خوبی میان سرعت و کیفیت داشته باشد؛
- Steps بیشازحد، هزینه را افزایش دهد بدون آنکه بهبود محسوسی ایجاد کند.
مدلهای تقطیرشده یا Turbo ممکن است برای تولید با تعداد بسیار کمی Step آموزش دیده باشند. بنابراین مقدار مناسب باید بر اساس توصیه همان مدل انتخاب شود.
Classifier-Free Guidance چیست؟
مدل شرطی باید میان دو هدف تعادل برقرار کند:
- تولید نمونهای طبیعی و متنوع
- پیروی دقیق از Prompt
Classifier-Free Guidance یا CFG روشی برای افزایش اثر شرط متنی بر خروجی است.
در این روش، مدل معمولاً دو پیشبینی انجام میدهد:
- پیشبینی بدون شرط
- پیشبینی با شرط متنی
سپس آنها ترکیب میشوند:
ϵguided=ϵuncond+s(ϵcond−ϵuncond)\epsilon_{guided} = \epsilon_{uncond} + s \left( \epsilon_{cond} - \epsilon_{uncond} \right)
در این رابطه، ss همان Guidance Scale است.
مقاله Classifier-Free Diffusion Guidance این روش را راهی برای کنترل تعادل میان کیفیت یا وفاداری به شرط و تنوع نمونهها معرفی میکند.
Guidance Scale چه اثری دارد؟
Guidance Scale میزان تأثیر Prompt را افزایش یا کاهش میدهد.
Guidance پایین
- آزادی بیشتر مدل
- تنوع بیشتر
- احتمال فاصلهگرفتن از Prompt
- گاهی خروجی طبیعیتر
Guidance متوسط
- تعادل میان کیفیت و تطابق
- مناسب بسیاری از کاربردهای عمومی
Guidance بسیار بالا
- تأکید شدید روی Prompt
- احتمال رنگهای اغراقشده
- احتمال ایجاد Artifact
- احتمال کاهش تنوع
- الزاماً به معنای کیفیت بیشتر نیست
مقدار مناسب به مدل وابسته است. بعضی مدلهای جدید با Guidance بسیار پایین یا حتی بدون CFG کلاسیک اجرا میشوند.
Negative Prompt چیست؟
Negative Prompt مشخص میکند چه عناصر یا ویژگیهایی در خروجی مطلوب نیستند.
مثال:
blurry, low quality, distorted hands, watermark
در Pipelineهای مبتنی بر CFG، Negative Prompt میتواند در شاخه شرط منفی یا بدون شرط استفاده شود.
بااینحال، Negative Prompt همیشه مشکلات مدل را حل نمیکند. اگر مدل در نمایش یک مفهوم ضعف داشته باشد، افزودن فهرست طولانی عبارات منفی الزاماً نتیجه را بهتر نمیکند.
Seed چیست؟
Seed عدد اولیه مولد اعداد شبهتصادفی است.
اگر این موارد ثابت باشند:
- مدل
- نسخه کتابخانه
- سختافزار و روش محاسبات
- Scheduler
- تعداد Steps
- Prompt
- ابعاد
- Seed
- سایر پارامترها
میتوان خروجی مشابه یا در بعضی محیطها بازتولیدپذیر تولید کرد.
تغییر Seed باعث تغییر نویز اولیه و در نتیجه تغییر ترکیببندی تصویر میشود.
Seed برای کاربردهای زیر مفید است:
- مقایسه دو Prompt
- بررسی اثر Guidance
- ساخت نسخههای نزدیک
- آزمون رگرسیون
- بازتولید نسبی خروجی
بااینحال، بازتولید بیتبهبیت روی سختافزارها و نسخههای مختلف همیشه تضمینشده نیست.
Image-to-Image چگونه کار میکند؟
در Image-to-Image، فرایند از نویز کامل آغاز نمیشود.
ابتدا تصویر ورودی به فضای Latent منتقل میشود. سپس مقدار کنترلشدهای نویز به آن اضافه و فرایند حذف نویز اجرا میشود.
پارامتری مانند Strength تعیین میکند تصویر اولیه تا چه حد تغییر کند.
Strength پایین
- ساختار تصویر اصلی بیشتر حفظ میشود؛
- تغییرات محدودتر هستند.
Strength بالا
- نویز بیشتری اضافه میشود؛
- مدل آزادی بیشتری برای تغییر تصویر دارد؛
- شباهت به تصویر اولیه ممکن است کاهش پیدا کند.
کاربردها:
- تغییر سبک عکس
- طراحی دوباره اتاق
- ساخت نسخه تبلیغاتی محصول
- تغییر نور و فصل
- تبدیل طرح دستی به تصویر
- بازطراحی کاراکتر
Inpainting چیست؟
Inpainting برای تغییر بخش مشخصی از تصویر استفاده میشود.
ورودی معمولاً شامل این موارد است:
- تصویر اصلی
- ماسک
- Prompt
ماسک مشخص میکند کدام ناحیه باید بازسازی شود.
تصویر + ماسک + Prompt
↓
بازسازی ناحیه انتخابشده
کاربردها:
- حذف شیء
- تغییر لباس
- تعویض پسزمینه یک ناحیه
- اصلاح بخش آسیبدیده
- اضافهکردن محصول
- بازسازی فضای خالی تصویر
مدل باید هم Prompt و هم محتوای اطراف ماسک را در نظر بگیرد تا مرزهای طبیعی ایجاد شوند.
Outpainting چیست؟
Outpainting بوم تصویر را گسترش میدهد.
برای مثال:
تصویر مربعی
    ↓
گسترش چپ و راست
    ↓
تصویر افقی
مدل بر اساس محتوای موجود، بخشهای جدید را تولید میکند.
این روش برای تبدیل نسبت تصویر، ساخت بنر و گسترش پسزمینه کاربرد دارد.
ControlNet و کنترل ساختار تصویر
Prompt بهتنهایی همیشه کنترل دقیقی روی وضعیت بدن، لبهها، عمق یا ترکیببندی نمیدهد.
روشهایی مانند ControlNet یا Adapterها اطلاعات ساختاری اضافی به مدل ارائه میکنند:
- نقشه لبه
- نقشه عمق
- حالت بدن
- خطوط طراحی
- نقشه Segment
- تصویر مرجع
فرایند کلی:
Prompt
+
اطلاعات ساختاری
↓
مدل تولید تصویر
↓
خروجی کنترلشدهتر
به این ترتیب میتوان سبک را تغییر داد و در عین حال ساختار اصلی را بهتر حفظ کرد.
Diffusion Transformer یا DiT چیست؟
در بسیاری از مدلهای اولیه، U-Net ستون اصلی پیشبینی نویز بود. Diffusion Transformer یا DiT بهجای U-Net از Transformer استفاده میکند.
در DiT، نمایش نهفته تصویر به Patch یا Token تقسیم و با بلوکهای Transformer پردازش میشود.
مقاله Scalable Diffusion Models with Transformers نشان داد که میتوان U-Net متداول را با Transformer جایگزین کرد و Latentهای تصویر را بهصورت Patch پردازش کرد.
مقایسه ساده:
| ویژگی | U-Net Diffusion | Diffusion Transformer |
|---|---|---|
| ستون اصلی | شبکه کانولوشنی U شکل | Transformer |
| ورودی | ویژگیهای مکانی | توکنها یا Patchهای نهفته |
| تعامل دوربرد | با لایهها و Attention | Attention سراسری یا بهینهشده |
| مقیاسپذیری | مناسب | مناسب مدلهای بزرگتر |
| کاربرد | بسیاری از نسلهای کلاسیک | تعداد زیادی از مدلهای جدید |
همه مدلهای DiT دقیقاً معماری یکسانی ندارند. نحوه اتصال متن و تصویر، نوع Attention، معماری VAE و هدف آموزشی میان آنها متفاوت است.
MMDiT چیست؟
MMDiT مخفف Multimodal Diffusion Transformer است.
در این معماری، نمایش متن و تصویر میتواند با وزنهای جداگانه پردازش شود، اما در عملیات Attention با یکدیگر تعامل داشته باشد.
هدف آن است که:
- متن در فضای مناسب زبان پردازش شود؛
- تصویر در فضای مناسب تصویر پردازش شود؛
- اطلاعات میان دو نوع Token تبادل شود؛
- ارتباط Prompt و تصویر بهتر مدلسازی شود.
برای نمونه، Stability AI در توضیح معماری Stable Diffusion 3 از MMDiT و وزنهای جداگانه برای نمایشهای متن و تصویر همراه با تعامل Attention استفاده میکند.
Flow Matching چیست؟
Flow Matching روشی برای آموزش مدلهای مولد پیوسته است که میدان برداری انتقال میان توزیع نویز و داده را یاد میگیرد.
بهصورت مفهومی:
نویز
↓
مسیر پیوسته آموختهشده
↓
داده
در مدل دیفیوژن کلاسیک، فرایند با افزودن تدریجی نویز و یادگیری مسیر معکوس توضیح داده میشود. در Flow Matching، مدل حرکت یا میدان برداری روی یک مسیر احتمالاتی را یاد میگیرد.
مقاله Flow Matching توضیح میدهد که این چارچوب با خانوادهای از مسیرهای احتمالاتی، از جمله مسیرهای مرتبط با Diffusion، سازگار است؛ اما میتواند از مسیرهای غیردیفیوژنی نیز استفاده کند.
بنابراین این دو اصطلاح دقیقاً مترادف نیستند:
- هر Flow Matching الزاماً DDPM کلاسیک نیست.
- بعضی مسیرهای دیفیوژن را میتوان در چارچوب Flow Matching بیان کرد.
- بسیاری از مدلهای جدید تصویری و ویدیویی از روشهای Flow، Rectified Flow یا ترکیب آنها با Transformer استفاده میکنند.
Rectified Flow چیست؟
Rectified Flow تلاش میکند مسیر انتقال نویز به داده را مستقیمتر کند.
مسیر مستقیمتر میتواند امکان نمونهگیری با تعداد مراحل کمتر را فراهم کند، هرچند عملکرد واقعی به آموزش، معماری و Solver وابسته است.
برای نمونه، Stable Diffusion 3 از ترکیب معماری MMDiT و فرمولبندی Rectified Flow استفاده کرده است.
به همین دلیل، قراردادن تمام مدلهای جدید زیر عنوان «DDPM» از نظر فنی دقیق نیست؛ حتی اگر تجربه کاربری آنها همچنان شبیه تبدیل تدریجی نویز به تصویر باشد.
مدل دیفیوژن چگونه ویدئو تولید میکند؟
ویدئو علاوه بر ابعاد مکانی، بعد زمان دارد.
مدل تولید ویدئو باید همزمان این موارد را یاد بگیرد:
- ساختار هر فریم
- حرکت میان فریمها
- ثبات هویت کاراکتر
- ثبات اشیا و پسزمینه
- حرکت دوربین
- هماهنگی نور
- ترتیب رخدادها
یک Pipeline ساده ویدئویی:
Prompt یا تصویر مرجع
↓
Text/Image Encoder
↓
Latent Video Noise
↓
Spatiotemporal Denoising
↓
Video Latents
↓
Video Decoder
↓
فریمهای نهایی
مدل ممکن است از یکی از روشهای زیر استفاده کند:
- U-Net سهبعدی
- Temporal Attention
- Spatial Attention
- Diffusion Transformer
- VAE ویدیویی
- Flow Matching
- معماری ترکیبی
برای مثال، گزارش CogVideoX از یک VAE سهبعدی برای فشردهسازی ابعاد مکانی و زمانی و یک Diffusion Transformer برای تولید ویدئو استفاده میکند.
تولید ویدئو از تصویر گرانتر است؛ زیرا تعداد زیادی فریم باید با حفظ انسجام زمانی تولید شوند.
چرا تولید ویدئو از تصویر دشوارتر است؟
در تصویر ثابت، مدل فقط یک لحظه را تولید میکند. در ویدئو، هر تغییر باید در طول زمان منطقی باشد.
چالشهای مهم:
- تغییر ناخواسته چهره
- ناپدیدشدن اشیا
- تغییر لباس یا رنگ
- حرکت غیرطبیعی دست و پا
- لرزش پسزمینه
- حرکت نامنظم دوربین
- ناهماهنگی سایهها
- تغییر اندازه سوژه
- نقض پیوستگی فیزیکی
به همین دلیل Prompt ویدئویی بهتر است علاوه بر موضوع، حرکت و دوربین را نیز مشخص کند.
مثال:
A cinematic medium shot of a woman walking through a rainy
neon-lit street at night, slow dolly-in camera movement,
natural motion, realistic reflections, consistent character
appearance.
این Prompt شامل موارد زیر است:
- سوژه
- محیط
- زمان
- نور
- نوع نما
- حرکت دوربین
- سبک
- ویژگی پایداری
مقایسه مدل دیفیوژن با GAN
GAN از دو شبکه استفاده میکند:
- Generator برای ساخت نمونه
- Discriminator برای تشخیص نمونه واقعی و جعلی
| معیار | Diffusion | GAN |
|---|---|---|
| روش تولید | حذف چندمرحلهای نویز | تولید مستقیمتر |
| آموزش | هدف حذف نویز یا کمیت مرتبط | رقابت Generator و Discriminator |
| پایداری آموزش | معمولاً قابلکنترلتر | میتواند ناپایدار باشد |
| سرعت تولید | معمولاً کندتر | معمولاً سریعتر |
| تنوع نمونه | مناسب | خطر Mode Collapse |
| کنترل با متن | بسیار رایج | امکانپذیر اما کمتر متداول |
| ویرایش تصویر | انعطافپذیر | وابسته به معماری |
GANها همچنان در بعضی کاربردها مانند تولید سریع یا Super-resolution مفیدند. مدل دیفیوژن جایگزین مطلق همه روشهای مولد نیست.
مقایسه Diffusion و مدل Autoregressive
مدل Autoregressive داده را بخشبهبخش تولید میکند.
برای متن:
توکن ۱ → توکن ۲ → توکن ۳
برای تصویر نیز میتوان پیکسل، Token تصویری یا Patchها را بهترتیب تولید کرد.
| معیار | Diffusion | Autoregressive |
|---|---|---|
| مسیر تولید | اصلاح تکراری کل نمونه | تولید ترتیبی اجزا |
| تعداد مراحل | چند مرحله Denoising | وابسته به تعداد Token |
| مناسب برای | تصویر، ویدئو، صوت | متن و داده Tokenized |
| بازبینی کل نمونه | در هر مرحله امکانپذیر | تولید عمدتاً یکطرفه |
| سرعت | وابسته به تعداد Steps | وابسته به طول دنباله |
مدلهای جدید ممکن است ترکیبی باشند؛ برای مثال، مدل زبانی Prompt را پردازش کند و یک مدل Diffusion یا Flow محتوای تصویری را بسازد.
پارامترهای مهم تولید تصویر
Prompt
توضیح محتوایی که باید تولید شود.
Negative Prompt
ویژگیهایی که باید کمتر در خروجی دیده شوند، در مدلهای پشتیبانیکننده.
Width و Height
ابعاد تصویر. ابعاد بزرگتر معمولاً حافظه و زمان بیشتری میخواهند.
Number of Steps
تعداد مراحل نمونهگیری.
Guidance Scale
قدرت اثر شرط متنی در مدلهای مبتنی بر CFG.
Seed
مقدار اولیه تصادفی برای کنترل ترکیببندی و بازتولید نسبی.
Number of Images
تعداد خروجیهای تولیدشده برای هر Prompt.
Scheduler
الگوریتم حرکت میان مراحل نمونهگیری.
Strength
میزان تغییر تصویر مرجع در Image-to-Image.
آموزش اجرای مدل دیفیوژن با Python
برای اجرای یک Pipeline آماده میتوان از کتابخانه Diffusers استفاده کرد.
نصب کتابخانهها
pip install torch diffusers transformers accelerate safetensors
تولید تصویر
import torch
from diffusers import DiffusionPipeline


MODEL_ID = "stable-diffusion-v1-5/stable-diffusion-v1-5"

pipeline = DiffusionPipeline.from_pretrained(
    MODEL_ID,
    torch_dtype=torch.float16,
    use_safetensors=True,
)

pipeline = pipeline.to("cuda")

generator = torch.Generator(
    device="cuda",
).manual_seed(42)

result = pipeline(
    prompt=(
        "A modern Persian technology workspace, "
        "minimal design, soft daylight, realistic photography"
    ),
    negative_prompt=(
        "blurry, low quality, distorted, watermark"
    ),
    num_inference_steps=30,
    guidance_scale=7.0,
    generator=generator,
)

image = result.images[0]
image.save("generated-image.png")
این نمونه به GPU سازگار و حافظه کافی نیاز دارد. شناسه مدل، مجوز استفاده، اندازه فایل و تنظیمات توصیهشده باید در صفحه رسمی همان مدل بررسی شوند.
مستندات Diffusers نیز بارگذاری Pipeline آماده و اجرای فرایند تولید را از طریق DiffusionPipeline.from_pretrained() ارائه میکنند.
اجزای کد چه کاری انجام میدهند؟
from_pretrained
وزنها و تنظیمات اجزای Pipeline را دریافت و بارگذاری میکند.
torch_dtype=torch.float16
از دقت نیمه برای کاهش حافظه در سختافزار سازگار استفاده میکند.
to("cuda")
مدل را روی GPU قرار میدهد.
manual_seed(42)
نویز اولیه را برای بازتولید نسبی نتیجه کنترل میکند.
num_inference_steps
تعداد مراحل نمونهگیری را مشخص میکند.
guidance_scale
میزان اثر Prompt را در Pipeline پشتیبانیکننده کنترل میکند.
استفاده از مدل تولید تصویر از طریق API درواره
اجرای محلی مدل تصویری ممکن است به GPU، فضای ذخیرهسازی و تنظیمات تخصصی نیاز داشته باشد. راه دیگر، استفاده از API است.
ساختار دقیق درخواست به مدل و endpoint پشتیبانیشده بستگی دارد. اگر مدل انتخابی در مستندات فعلی درواره از رابط سازگار با Images API پشتیبانی کند، الگوی Python میتواند به این شکل باشد:
import os

from openai import OpenAI


client = OpenAI(
    base_url="https://api.darvareh.ir/v1",
    api_key=os.environ["DARVAREH_API_KEY"],
)

result = client.images.generate(
    model=os.environ["DARVAREH_IMAGE_MODEL"],
    prompt=(
        "A premium Persian saffron package on a light stone surface, "
        "soft studio lighting, commercial product photography"
    ),
    size="1024x1024",
)

print(result)
از آنجا که مدلهای تصویر و ویدئو ممکن است پارامترها، endpointها و روش تحویل خروجی متفاوتی داشته باشند، موارد زیر را از صفحه مدل و مستندات فعلی بررسی کنید:
- شناسه دقیق مدل
- اندازههای قابل پشتیبانی
- نسبت تصویر
- فرمت پاسخ
- امکان Image-to-Image
- پشتیبانی از Negative Prompt
- تعداد خروجی
- Seed
- هزینه هر تصویر
- روش دریافت فایل یا URL
- شیوه اجرای درخواستهای طولانی
برای اطلاعات بهروز به مستندات API درواره مراجعه کنید.
معماری پیشنهادی سرویس تولید تصویر
رابط کاربری نباید کلید API را مستقیماً در اختیار داشته باشد.
flowchart TD
A["کاربر"] --> B["وبسایت یا اپلیکیشن"]
B --> C["Backend محصول"]
C --> D["اعتبارسنجی و ثبت Job"]
D --> E["API درواره"]
E --> F["مدل تصویر یا ویدئو"]
F --> C
C --> G["ذخیره و نمایش نتیجه"]
Backend باید مسئول موارد زیر باشد:
- نگهداری کلید API
- اعتبارسنجی Prompt
- انتخاب مدل
- کنترل ابعاد و تعداد خروجی
- بررسی موجودی یا سهمیه کاربر
- ثبت وضعیت Job
- مدیریت خطا و Timeout
- ذخیره نتیجه
- محاسبه هزینه هر درخواست
- تحویل امن فایل به کاربر
برای تولید ویدئو یا تصاویر سنگین بهتر است Job بهصورت غیرهمزمان مدیریت شود:
queued
→ processing
→ succeeded
→ failed
نمونه ساختار Job در Backend
from enum import StrEnum

from pydantic import BaseModel, Field


class GenerationStatus(StrEnum):
    QUEUED = "queued"
    PROCESSING = "processing"
    SUCCEEDED = "succeeded"
    FAILED = "failed"


class ImageGenerationRequest(BaseModel):
    prompt: str = Field(min_length=3, max_length=3000)
    model: str
    width: int = Field(default=1024, ge=256, le=2048)
    height: int = Field(default=1024, ge=256, le=2048)
    number_of_images: int = Field(default=1, ge=1, le=4)


class GenerationJob(BaseModel):
    id: str
    status: GenerationStatus
    output_urls: list[str] = []
    error_message: str | None = None
در نسخه عملی، مقادیر مجاز باید بر اساس قابلیت مدل انتخابشده تعیین شوند، نه صرفاً ورودی آزاد کاربر.
چه زمانی اجرای محلی مدل دیفیوژن مناسب است؟
Self-hosting معمولاً زمانی منطقی است که:
- مدل متنباز مشخصی انتخاب شده باشد؛
- تیم به GPU مناسب دسترسی داشته باشد؛
- حجم درخواست بالا و قابلپیشبینی باشد؛
- کنترل کامل Pipeline اهمیت داشته باشد؛
- نیاز به LoRA یا شخصیسازی وجود داشته باشد؛
- تیم توان نگهداری زیرساخت را داشته باشد؛
- مجوز مدل با کاربرد تجاری سازگار باشد.
چه زمانی استفاده از API مناسبتر است؟
API معمولاً زمانی انتخاب بهتری است که:
- محصول در مرحله نمونه اولیه باشد؛
- تیم GPU اختصاصی نداشته باشد؛
- میزان مصرف نامشخص باشد؛
- دسترسی به چند مدل اهمیت داشته باشد؛
- هدف، عرضه سریعتر قابلیت باشد؛
- تیم نخواهد مدل و زیرساخت را مدیریت کند؛
- پرداخت بر اساس مصرف مناسبتر باشد؛
- مدلهای تصویر و ویدئو مرتب تغییر کنند.
در بسیاری از محصولات، ارزش اصلی از آموزش یک مدل تصویر از صفر ایجاد نمیشود. طراحی تجربه کاربری، Promptهای ساختاریافته، گردش کار، قالبهای آماده، ذخیره نتایج و حل مسئله مشخص کاربر اهمیت بیشتری دارند.
چگونه مدل تصویر مناسب را انتخاب کنیم؟
انتخاب مدل فقط بر اساس زیبایی چند نمونه تبلیغاتی کافی نیست.
یک مجموعه ارزیابی ثابت بسازید و معیارهای زیر را بررسی کنید:
تطابق با Prompt
آیا مدل همه اشیا، صفات و روابط را رعایت میکند؟
کیفیت زبان فارسی
آیا Prompt فارسی را بهدرستی درک میکند یا باید به انگلیسی تبدیل شود؟
تایپوگرافی
آیا میتواند متن خوانا داخل تصویر ایجاد کند؟
ثبات کاراکتر
آیا چهره و لباس در چند تصویر ثابت میمانند؟
جزئیات اشیا
آیا دست، انگشت، بستهبندی و عناصر کوچک درست تولید میشوند؟
ویرایش تصویر
آیا Inpainting و Image-to-Image با دقت کافی انجام میشود؟
سرعت
هر تصویر چقدر زمان میبرد؟
هزینه
هزینه هر خروجی قابلاستفاده چقدر است؟
مجوز
آیا استفاده تجاری، بازتوزیع یا شخصیسازی مجاز است؟
قابلیت کنترل
آیا مدل از Seed، نسبت تصویر، تصویر مرجع یا ورودی ساختاری پشتیبانی میکند؟
روش درست مقایسه هزینه مدلها
هزینه اسمی هر تصویر بهتنهایی کافی نیست.
ممکن است یک مدل تصویر ارزانتری تولید کند، اما برای رسیدن به نتیجه مطلوب به پنج بار تلاش نیاز داشته باشد.
معیار بهتر:
هزینه هر خروجی قابلاستفاده=هزینه کل تولیدهاتعداد خروجیهای تأییدشدههزینه\ هر\ خروجی\ قابلاستفاده = \frac{هزینه\ کل\ تولیدها} {تعداد\ خروجیهای\ تأییدشده}
برای مثال:
| مدل | هزینه ۱۰ خروجی | خروجی قابلاستفاده | هزینه هر خروجی مفید |
|---|---|---|---|
| مدل A | ۱۰۰ واحد | ۲ | ۵۰ واحد |
| مدل B | ۱۸۰ واحد | ۶ | ۳۰ واحد |
با وجود هزینه اولیه بیشتر، مدل B در این مثال اقتصادیتر است.
بهینهسازی Prompt برای مدل دیفیوژن
یک Prompt تصویری مناسب میتواند این اجزا را داشته باشد:
موضوع + ویژگیها + محیط + ترکیببندی + نور + دوربین + سبک + کیفیت
مثال:
A premium black perfume bottle, centered composition,
dark marble background, soft rim lighting, commercial
product photography, realistic reflections, high detail
تفکیک اجزا:
- موضوع: بطری عطر مشکی
- ترکیببندی: در مرکز
- محیط: سنگ مرمر تیره
- نور: نور حاشیهای نرم
- کاربرد: عکاسی تبلیغاتی
- ویژگی: بازتاب طبیعی و جزئیات بالا
Prompt طولانی الزاماً بهتر نیست. عبارتهای متناقض یا صفتهای بیشازحد میتوانند نتیجه را ضعیف کنند.
اشتباهات رایج هنگام استفاده از مدلهای دیفیوژن
تصور اینکه مدل تصویر را از پایگاه داده کپی میکند
مدل الگوهای آماری را یاد میگیرد و نمونه جدید تولید میکند. بااینحال، امکان شباهت زیاد یا بازتولید بعضی الگوهای آموزشی کاملاً منتفی نیست و باید خروجی عملی بررسی شود.
افزایش بیشازحد Guidance
Guidance بیشتر همیشه کیفیت بالاتر ایجاد نمیکند و ممکن است خروجی مصنوعی یا اشباعشده شود.
افزایش بیدلیل Steps
پس از یک حد مشخص، افزایش تعداد مراحل ممکن است فقط زمان و هزینه را بیشتر کند.
استفاده از ابعاد نامناسب
مدلها معمولاً برای دامنه مشخصی از ابعاد آموزش دیدهاند. تولید مستقیم در وضوح یا نسبت نامناسب میتواند ترکیببندی را خراب کند.
نادیدهگرفتن مجوز مدل
متنباز یا قابلدانلودبودن وزنها به معنای آزادی نامحدود برای استفاده تجاری نیست.
ثابتکردن پارامترها برای همه مدلها
Guidance، Steps و Scheduler مناسب یک مدل الزاماً برای مدل دیگر مناسب نیست.
اتصال مستقیم Frontend به API
این کار میتواند کلید API و کنترل هزینه را در معرض کاربر قرار دهد. درخواست باید از Backend محصول عبور کند.
ذخیرهنکردن تنظیمات تولید
برای بازتولید و ارزیابی، حداقل این اطلاعات را ثبت کنید:
- Model ID
- نسخه مدل
- Prompt
- Negative Prompt
- Seed
- Steps
- Guidance
- Scheduler
- Width و Height
- زمان تولید
- هزینه
- شناسه درخواست
پرسشهای متداول
مدل دیفیوژن چیست؟
مدل دیفیوژن نوعی مدل مولد است که فرایند تبدیل داده به نویز و مسیر معکوس آن را یاد میگیرد تا بتواند از نویز، تصویر یا داده جدید تولید کند.
DDPM مخفف چیست؟
DDPM مخفف Denoising Diffusion Probabilistic Model است و به مدلی اشاره دارد که فرایند احتمالاتی افزودن و حذف نویز را یاد میگیرد.
Stable Diffusion همان مدل دیفیوژن است؟
Stable Diffusion یک خانواده مشخص از مدلهای مولد است. Diffusion Model نام دسته بزرگتری از روشها است.
Latent Diffusion چیست؟
در Latent Diffusion، فرایند تولید در فضای نهفته فشرده انجام میشود و سپس VAE نتیجه را به تصویر پیکسلی تبدیل میکند.
U-Net چه نقشی دارد؟
در بسیاری از مدلهای دیفیوژن، U-Net نویز یا کمیت موردنیاز برای حرکت به نمونه تمیزتر را پیشبینی میکند. مدلهای جدید ممکن است بهجای آن از Transformer استفاده کنند.
Scheduler چیست؟
Scheduler الگوریتم و زمانبندی حرکت میان مراحل نویززدایی را کنترل میکند و از خروجی مدل برای محاسبه نمونه مرحله بعد استفاده میکند.
Guidance Scale چیست؟
پارامتری است که در مدلهای پشتیبانیکننده، قدرت اثر Prompt را بر خروجی تنظیم میکند. مقدار بسیار بالا الزاماً خروجی بهتری نمیسازد.
Seed چیست؟
Seed مقدار اولیه مولد اعداد شبهتصادفی است و روی نویز اولیه و ترکیببندی خروجی اثر میگذارد.
Diffusion Transformer چیست؟
Diffusion Transformer مدلی است که در فرایند دیفیوژن یا تولید مبتنی بر جریان، از Transformer برای پردازش نمایش نهفته استفاده میکند.
آیا Flow Matching همان Diffusion است؟
خیر. این دو مرتبطاند، اما دقیقاً یکسان نیستند. Flow Matching چارچوب گستردهتری برای یادگیری میدان انتقال میان توزیعها است و میتواند مسیرهای دیفیوژنی یا غیردیفیوژنی داشته باشد.
آیا مدل دیفیوژن فقط تصویر میسازد؟
خیر. این مدلها و روشهای مرتبط برای تولید و ویرایش تصویر، ویدئو، صوت، موسیقی، داده سهبعدی و داده مصنوعی استفاده میشوند.
آیا میتوان مدل دیفیوژن را روی کامپیوتر شخصی اجرا کرد؟
بله، اگر سختافزار، حافظه و سیستمعامل مناسب داشته باشید. مدلهای بزرگ یا تولید ویدئو ممکن است به GPU قدرتمندتری نیاز داشته باشند.
آیا برای استفاده از مدل تصویر باید GPU بخریم؟
خیر. میتوان از APIهای مدیریتشده مانند API درواره استفاده کرد و هزینه را بر اساس مصرف پرداخت کرد.
جمعبندی
مدلهای دیفیوژن از مهمترین روشهای تولید محتوای تصویری و چندرسانهای هستند. ایده اصلی آنها یادگیری مسیر معکوس تبدیل داده به نویز است.
اجزای مهم این فرایند عبارتاند از:
- Forward Diffusion برای افزودن نویز
- Reverse Diffusion برای حذف نویز
- مدل عصبی برای پیشبینی نویز، سرعت یا کمیت مرتبط
- Text Encoder برای درک Prompt
- Scheduler برای کنترل مراحل نمونهگیری
- VAE برای انتقال میان فضای پیکسل و Latent
- Guidance برای کنترل اثر شرط
- Seed برای کنترل نویز اولیه
- U-Net یا Transformer بهعنوان ستون مدل
- API یا موتور استنتاج برای ارائه قابلیت به کاربر
نسلهای اولیه بیشتر با DDPM، U-Net و حذف نویز چندمرحلهای توضیح داده میشدند. مدلهای جدیدتر ممکن است از Latent Diffusion، Diffusion Transformer، Flow Matching، Rectified Flow و روشهای نمونهگیری سریعتر استفاده کنند.
برای توسعهدهنده، مهمترین تصمیم صرفاً انتخاب نام مدل نیست. کیفیت Prompt، زمان تولید، هزینه هر خروجی قابلاستفاده، مجوز، قابلیت ویرایش، ثبات کاراکتر و امکان اتصال API باید روی نمونههای واقعی آزمایش شوند.
اگر قصد دارید قابلیت تولید تصویر یا ویدئو را به وبسایت، اپلیکیشن یا محصول SaaS خود اضافه کنید، میتوانید از مستندات API درواره شروع کنید.
آدرس پایه API درواره:
https://api.darvareh.ir/v1
مقالات مرتبط
- تولید تصویر از متن با هوش مصنوعی
- بهترین ابزارهای ساخت عکس با هوش مصنوعی
- تبدیل عکس به ویدئو با هوش مصنوعی
- ساخت ویدئو از متن با هوش مصنوعی
- ویرایش عکس با هوش مصنوعی
- تولید تصویر با API درواره
- مدل چندوجهی چیست؟
- ترنسفورمر چیست؟
- محاسبه هزینه API هوش مصنوعی
منابع
- Denoising Diffusion Probabilistic Models
- Denoising Diffusion Implicit Models
- High-Resolution Image Synthesis with Latent Diffusion Models
- Classifier-Free Diffusion Guidance
- Scalable Diffusion Models with Transformers
- Flow Matching for Generative Modeling
- Hugging Face Diffusers Documentation
- مخزن رسمی Latent Diffusion
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



