نامگذاری و مرتبسازی فایلهای PDF با Python و API هوش مصنوعی
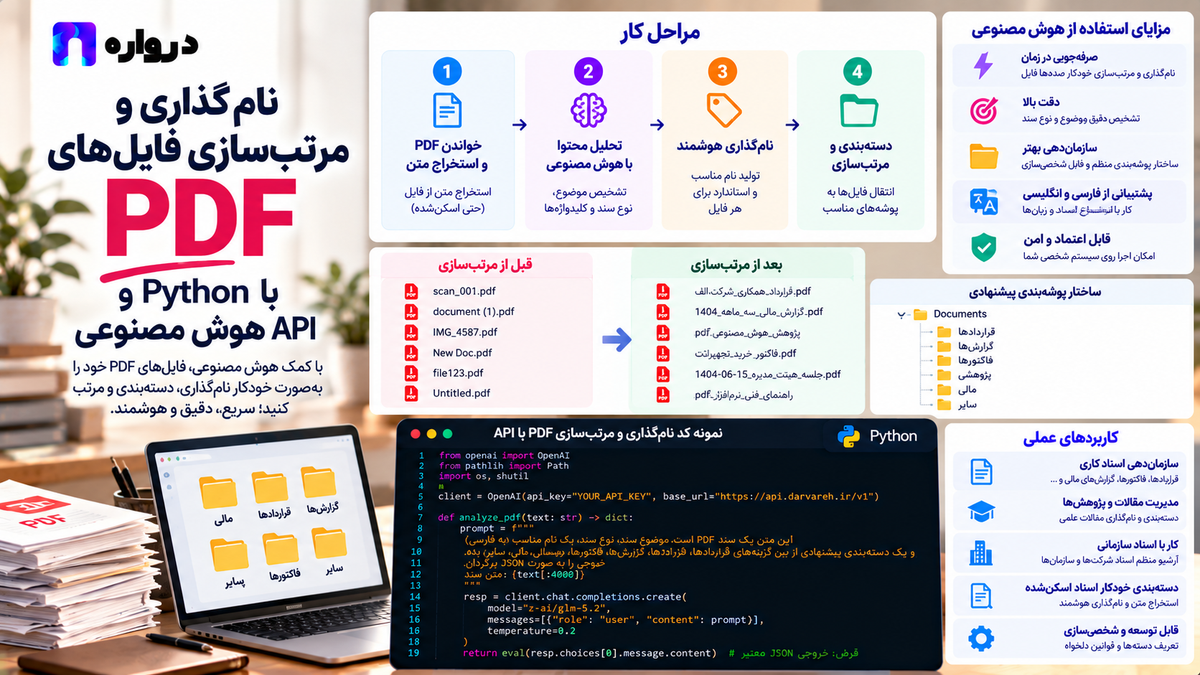
فایلهای PDF با نامهای نامفهوم را چگونه مرتب کنیم؟ در این آموزش با Python و API هوش مصنوعی، محتوای اسناد را بررسی میکنیم، نام و دسته پیشنهادی میسازیم و پس از بازبینی، نسخههای مرتبشده فایلها را ذخیره میکنیم.

پوشهای شامل صدها فایل با نامهایی مانند scan123.pdf، download.pdf و document-final-2.pdf را تصور کنید. برای پیدا کردن یک گزارش، جزوه یا راهنمای محصول، باید چندین فایل را باز کنید تا محتوای آنها مشخص شود.
مرتبسازی دستی این فایلها وقتگیر است. تغییر نام گروهی هم وقتی مفید است که الگوی مناسبی در نامهای فعلی وجود داشته باشد. اگر نام فایل هیچ ارتباطی با محتوا نداشته باشد، اضافهکردن شماره یا تاریخ مشکل اصلی را حل نمیکند.
هوش مصنوعی میتواند بخشی از محتوای سند را بخواند و برای آن نام و دسته پیشنهادی بسازد. برنامه Python نیز استخراج متن، بررسی خروجی و ذخیره فایلها را انجام میدهد.
در این مقاله ابزاری میسازیم که:
- فایلهای PDF، متنی و Markdown را بررسی میکند.
- بخشی از متن هر فایل را استخراج میکند.
- از API درواره نام فارسی و دسته پیشنهادی میگیرد.
- خروجی مدل را اعتبارسنجی میکند.
- پیشنهادها را در یک فایل JSON برای بازبینی نگه میدارد.
- در مرحلهای جداگانه، نسخههای مرتبشده فایلها را میسازد.
این روش برای آرشیو جزوهها، مستندات فنی، گزارشهای سازمانی و فایلهای دانلودشده کاربرد دارد. همچنین میتواند نقطه شروع ساخت قابلیت «مرتبسازی هوشمند اسناد» در یک نرمافزار باشد.
مرتبسازی فایل با هوش مصنوعی چگونه کار میکند؟
در تغییر نام معمولی، برنامه با اطلاعاتی مانند نام فعلی، پسوند و تاریخ فایل کار میکند.
در مرتبسازی مبتنی بر محتوا، برنامه بخشی از متن سند را نیز بررسی میکند. برای مثال، اگر صفحات ابتدایی یک PDF درباره نصب دستگاه و تنظیمات اولیه باشد، مدل میتواند نامی مانند «راهنمای نصب و تنظیم دستگاه» پیشنهاد دهد.
بااینحال، پیشنهاد مدل باید از اطلاعات موجود در سند پشتیبانی شود. اگر شماره نسخه، تاریخ یا نام محصول در متن وجود ندارد، برنامه نباید آن را به نام فایل اضافه کند.
برای نمونه:
| نام فعلی | محتوای قابلمشاهده | نام پیشنهادی |
|---|---|---|
download.pdf | راهنمای استفاده از یک نرمافزار حسابداری | راهنمای استفاده از نرمافزار حسابداری |
scan_004.pdf | تصویر اسکنشده بدون متن قابلاستخراج | نیازمند OCR یا بررسی دستی |
document.pdf | گزارش عملکرد واحد پشتیبانی | گزارش عملکرد واحد پشتیبانی |
notes.txt | یادداشت آموزشی درباره HTTP | یادداشت آموزشی HTTP |
این جدول نمونه توضیحی است؛ کیفیت پیشنهادهای واقعی به متن استخراجشده و مدل انتخابی وابسته خواهد بود.
چه زمانی قواعد ساده کافی هستند؟
برای تمام پوشهها به مدل زبانی نیاز نداریم.
اگر فایلها از یک سامانه مشخص دریافت میشوند و ساختار ثابتی دارند، معمولاً قواعد برنامهنویسی انتخاب مناسبتری هستند.
برای مثال، اگر شماره گزارش همیشه در اولین خط قرار دارد، میتوان آن را مستقیماً استخراج کرد. اگر نام فعلی شامل تاریخ استاندارد است، مرتبسازی بر اساس همان تاریخ به تحلیل معنایی نیاز ندارد.
| وضعیت فایلها | روش مناسب برای شروع |
|---|---|
| نامهای دارای الگوی ثابت | تغییر نام با قواعد و عبارت منظم |
| اطلاعات ساختاریافته و قابلاستخراج | پردازش مستقیم فیلدها |
| اسناد متنوع با عنوانهای نامشخص | پیشنهاد نام با مدل زبانی |
| PDF اسکنشده | استخراج متن با OCR، سپس تحلیل |
| فایلهای کم و ساده | بررسی دستی |
ارزش مدل زبانی زمانی بیشتر میشود که نام مناسب به فهم موضوع سند وابسته باشد.
نام فایل خوب چه ویژگیهایی دارد؟
نام مناسب باید موضوع سند را روشن کند و در یک آرشیو واقعی قابلاستفاده باشد.
برای این پروژه، قواعد زیر را در نظر میگیریم:
- عنوان کوتاه و توصیفی باشد.
- اطلاعاتی که در متن وجود ندارد به عنوان اضافه نشود.
- پسوند فایل حفظ شود.
- جداکنندههای مسیر وارد نام نشوند.
- نامهای مشابه باعث بازنویسی فایلهای قبلی نشوند.
- ارتباط فایل جدید با فایل اصلی قابلپیگیری باشد.
برای جلوگیری از تداخل، در انتهای نام پیشنهادی بخشی از هش محتوای فایل را قرار میدهیم:
راهنمای-نصب-نرمافزار-a19c42d803b1.pdfاین شناسه از محتوای فایل محاسبه میشود. بنابراین دو سند با عنوان مشابه معمولاً نام نهایی متفاوتی خواهند داشت.
البته استفاده از بخشی از هش، تضمین ریاضیِ نبود برخورد نیست. در برنامه ما، بازکردن فایل خروجی در حالت ایجاد انحصاری، از بازنویسی مقصد موجود جلوگیری میکند.
چرا پیشنهاد نام و اجرای عملیات را جدا میکنیم؟
نامگذاری معنایی همیشه نتیجه قطعی ندارد.
ممکن است مدل از روی مقدمه، عنوانی بسیار عمومی پیشنهاد دهد. ممکن است یک گزارش آموزشی را در دسته «گزارش» قرار دهد، درحالیکه شما ترجیح میدهید در پوشه «آموزش» ذخیره شود.
به همین دلیل ابزار را در دو مرحله اجرا میکنیم:
مرحله اول: تولید فایل پیشنهادها، شامل نام اصلی، عنوان پیشنهادی، دسته و شواهد متنی.
مرحله دوم: خواندن همان پیشنهادهای بازبینیشده و ساخت نسخههای مرتبشده.
این جداسازی یک مزیت عملی دارد: هنگام اجرای مرحله دوم، دوباره از مدل درخواست نمیکنیم. بنابراین پیشنهادهای تأییدشده در فاصله بازبینی و اجرا تغییر نمیکنند.
ابزار ما چه نوع فایلهایی را پشتیبانی میکند؟
در این آموزش، ورودیها محدود به سه نوع هستند:
- PDFدارای متن قابلاستخراج
- فایل متنی UTF-8 با پسوند
.txt - فایل Markdown با پسوند
.md
برای استخراج متن PDF از pypdf استفاده میکنیم. طبق مستندات رسمی، این کتابخانه میتواند متن موجود در PDF را استخراج کند، اما خودش موتور OCR نیست و نوشته داخل تصویر اسکنشده را تشخیص نمیدهد. ساختار پیچیده PDF نیز ممکن است استخراج متن را دشوار کند. pypdf 6.19.0 documentation
در نتیجه، فایل اسکنشدهای که لایه متنی ندارد، در این نسخه به بررسی جداگانه نیاز خواهد داشت.
آمادهسازی محیطPython
برای اجرای مثال، از Python 3.10 یا جدیدتر استفاده کنید.
کتابخانهها را نصب کنید:
pip install requests pydantic pypdfسپس متغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
در PowerShell ویندوز:
$env:DARVAREH_API_KEY="YOUR_API_KEY"
$env:DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
شناسه مدل را بر اساس مدلهای در دسترس حساب خود انتخاب کنید. پیش از اجرا، مسیر درخواست و قابلیتهای مدل انتخابی را با مستندات API درواره تطبیق دهید.
مثال زیر از درخواست متنی به مسیر chat/completions استفاده میکند. پشتیبانی از خروجی ساختاریافته اختصاصی را فرض نمیکنیم؛ خروجی JSON را در برنامه بررسی خواهیم کرد.
ساختار خروجی هوش مصنوعی
برای هر سند، سه فیلد از مدل میخواهیم:
| فیلد | کاربرد |
|---|---|
title | عنوان پیشنهادی برای فایل |
category | دسته از میان گزینههای ازپیشتعریفشده |
evidence | عبارت کوتاهی از متن ورودی که پیشنهاد را پشتیبانی میکند |
دستهها در این مثال عبارتاند از:
education: محتوای آموزشیreport: گزارشmanual: راهنما و دستورالعملother: سایر اسناد
انتخاب دسته از یک فهرست محدود، ساختار پوشهها را قابلپیشبینی نگه میدارد. اگر مدل بتواند هر نامی بسازد، ممکن است پوشههای هممعنی متعددی مانند «راهنما»، «راهنمای استفاده» و «دستورالعمل» ایجاد شوند.
برای بررسی نوع دادهها و فیلدهای خروجی از Pydantic استفاده میکنیم. این کتابخانه امکان تعریف مدل داده و اعتبارسنجی ورودی را فراهم میکند. بااینحال، معتبر بودن ساختار داده، صحت معنایی عنوان را ثابت نمیکند. Pydantic Docs
کد کامل ابزار مرتبسازی فایلها
کد زیر را در فایلی با نام organize_documents.py ذخیره کنید.
import argparseimport hashlibimport jsonimport osimport reimport shutilimport unicodedatafrom pathlib import Pathfrom typing import Literalimport requestsfrom pydantic import BaseModel, ConfigDict, Fieldfrom pypdf import PdfReaderCategory = Literal[ "education", "report", "manual", "other",]SUPPORTED = {".pdf", ".txt", ".md"}MAX_FILE_BYTES = 10 * 1024 * 1024MAX_TEXT_CHARS = 6000class Suggestion(BaseModel): model_config = ConfigDict( extra="forbid", strict=True, ) title: str = Field( min_length=3, max_length=100, ) category: Category evidence: str = Field( min_length=5,این نمونه برای شروع توسعه ارائه شده است؛ اجرای درخواست واقعی به کلید معتبر، مدل در دسترس و سازگاری تنظیمات با API نیاز دارد. نتیجه عملی مدل روی فایلهای شما باید جداگانه ارزیابی شود.
مرحله اول: تولید پیشنهادهای نامگذاری
فرض کنید اسناد در پوشه documents قرار دارند:
python organize_documents.py plan documents rename-plan.jsonبرنامه برای هر فایل مناسب، یک درخواست تحلیل ارسال میکند و نتیجه موفق را در rename-plan.json قرار میدهد.
نمونه ساختار فایل پیشنهادها:
{
"source_dir": "/path/to/documents",
"items": [
{
"title": "راهنمای نصب نرمافزار",
"category": "manual",
"evidence": "این راهنما مراحل نصب نرمافزار را توضیح میدهد.",
"source_name": "download.pdf",
"sha256": "..."
}
]
}مقدار sha256 در خروجی واقعی یک رشته ۶۴کاراکتری خواهد بود. علامت ... در این نمونه صرفاً برای کوتاهکردن نمایش است و در فایل قابلاجرا نباید استفاده شود.
چگونه پیشنهادها را بازبینی کنیم؟
فایل JSON را باز کنید و عنوان و دسته هر سند را بررسی کنید.
در بازبینی، به این موارد توجه کنید:
- آیا عنوان موضوع اصلی سند را نشان میدهد؟
- آیا مدل از روی یک مثال فرعی، عنوان نامناسب ساخته است؟
- آیا نام محصول یا سازمان درست نوشته شده است؟
- آیا عنوان بیشازحد عمومی است؟
- آیا دسته پیشنهادی با ساختار آرشیو شما هماهنگ است؟
میتوانید title و category را اصلاح کنید. دسته باید همچنان یکی از چهار مقدار مجاز باشد.
برای حذف یک پیشنهاد نامناسب، کل شیء مربوط به آن را از آرایه items حذف کنید. فیلدهای source_name و sha256 را تغییر ندهید؛ برنامه از آنها برای پیدا کردن فایل اصلی و بررسی تغییر محتوا استفاده میکند.
مرحله دوم: ساخت پوشههای مرتبشده
پس از بازبینی پیشنهادها:
python organize_documents.py apply rename-plan.json organizedبرنامه در پوشه organized زیرپوشههای دستهبندی را میسازد و فایلها را با نام جدید کپی میکند.
فایل اصلی در پوشه ورودی باقی میماند. همچنین مرحله apply به API درخواست نمیفرستد؛ همان پیشنهادهای موجود در فایل برنامه را اجرا میکند.
برای کار با مسیرها از pathlib استفاده شده است. مستندات Python این ماژول را بهعنوان رابط شیءگرا برای مسیرهای فایل و عملیات مرتبط معرفی میکند. Python 3.14.8 documentation
چرا فقط سه صفحه اول PDF را بررسی میکنیم؟
در بسیاری از اسناد، عنوان و معرفی موضوع در صفحات ابتدایی قرار دارند. بررسی این بخشها میتواند برای یک نمونه اولیه کافی باشد.
اما این انتخاب محدودیت دارد:
- صفحه اول ممکن است فقط جلد باشد.
- سند ممکن است چند موضوع مستقل داشته باشد.
- عنوان اصلی ممکن است در صفحات بعدی ظاهر شود.
- فهرست مطالب میتواند متن نمونه را تحتتأثیر قرار دهد.
در نسخه توسعهیافته میتوان از چند بخش سند نمونه برداشت: صفحات ابتدایی، بخش میانی و نتیجهگیری.
برای اسناد بلند، بهتر است عنوان پیشنهادی بر اساس نمایی از چند بخش ساخته شود. صرفاً افزایش حجم ورودی، بدون بررسی کیفیت نمونهبرداری، لزوماً مشکل را حل نمیکند.
محدودیت ۶۰۰۰ کاراکتر در کد، تصمیم این نمونه آموزشی است و معادل محدودیت توکن مدل نیست. ظرفیت واقعی ورودی باید با مشخصات مدل انتخابی هماهنگ شود.
آیا شواهد متنی، عنوان را قابلاعتماد میکند؟
وجود شواهد، بازبینی را آسانتر میکند. بهجای اینکه فقط یک نام پیشنهادی ببینید، میتوانید عبارت پشتیبان آن را نیز بخوانید.
برنامه بررسی میکند که evidence عیناً در متن ارسالی وجود داشته باشد. این بررسی جلوی پذیرش عبارت ساختگی را میگیرد، اما ارتباط معنایی آن با عنوان را تضمین نمیکند.
برای مثال، عبارت «نصب نرمافزار» ممکن است در یک گزارش خطا هم وجود داشته باشد. بنابراین عنوان «راهنمای نصب نرمافزار» لزوماً نتیجه درستی نیست.
اعتبارسنجی ساختار، تطبیق شواهد و بررسی معنایی سه کار متفاوتاند. در یک محصول واقعی، باید هر سه را متناسب با اهمیت آرشیو طراحی کنید.
برخورد با PDF فارسی و فایلهای اسکنشده
اگر متن استخراجشده خالی یا نامفهوم باشد، ارسال آن به مدل معمولاً پیشنهاد مناسبی تولید نمیکند.
برای بررسی اولیه، خروجی استخراج متن را مشاهده کنید:
from pypdf import PdfReader

reader = PdfReader("sample.pdf")

text = reader.pages[0].extract_text() or ""

print(text[:1500])
اگر حروف جابهجا، کلمات ناقص یا ترتیب خطوط نامناسب است، ابتدا مشکل استخراج را بررسی کنید.
اگر سند فقط تصویر دارد، به مرحله OCR نیاز خواهید داشت. پس از OCR نیز نمونهای از متن را بازبینی کنید؛ اشتباه در نام محصول یا اصطلاح اصلی میتواند مستقیماً به نامگذاری غلط منجر شود.
شرط حداقل ۸۰ کاراکتر در کد، صرفاً یک فیلتر ساده است. وجود متن کافی، بهتنهایی نشانه خوانا یا صحیح بودن آن نیست.
مدیریت خطاهایAPI
در این ابزار، شکست تحلیل یک فایل باعث توقف تحلیل تمام پوشه نمیشود. فایل مشکلدار رد میشود و نام آن همراه نوع خطا نمایش داده میشود.
خطاها ممکن است شامل این موارد باشند:
| خطا | اقدام مناسب |
|---|---|
| احراز هویت ناموفق | بررسی کلید و تنظیمات حساب |
| شناسه مدل نامعتبر | بررسی مدل انتخابی |
| محدودیت درخواست | کاهش سرعت و زمانبندی مجدد |
| پایان زمان انتظار | بررسی شبکه و سیاست تلاش مجدد |
| JSON نامعتبر | اصلاح دستور یا انتخاب مدل مناسبتر |
| متن استخراجشده ناکافی | بررسی PDF یا انجام OCR |
در Requests، دریافت JSON بهتنهایی موفق بودن درخواست HTTP را ثابت نمیکند. به همین دلیل قبل از خواندن پاسخ، raise_for_status() را فراخوانی میکنیم. همچنین زمان انتظار اتصال و خواندن پاسخ را مشخص کردهایم؛ این تنظیم، سقف قطعی زمان کل اجرای درخواست نیست. Requests 2.34.2 documentation
در نسخه عملیاتی، بهتر است نتیجه هر فایل در یک گزارش جداگانه ثبت شود. برای خطاهای موقت نیز میتوان تلاش مجدد محدود و با فاصله زمانی اضافه کرد.
هزینه مرتبسازی فایلها را چگونه کنترل کنیم؟
در این مثال، هر فایل یک درخواست مستقل ایجاد میکند. هزینه پردازش به مدل، حجم متن و تعداد فایلها وابسته است.
برای کاهش پردازش غیرضروری:
- فایلهای نامرتبط را پیش از تحلیل کنار بگذارید.
- اسناد یکسان را بر اساس هش شناسایی کنید.
- نتیجه تحلیل قبلی را نگه دارید.
- حجم نمونه متن را متناسب با مسئله انتخاب کنید.
- مدلها را روی یک مجموعه ثابت مقایسه کنید.
- مرحله اجرای پیشنهادها را بدون درخواست مجدد انجام دهید.
کد فعلی برای فایلهای تکراری، حافظه نهان تحلیل ندارد. افزودن ذخیره نتیجه بر اساس ترکیب «هش فایل، مدل و نسخه دستور» میتواند توسعه بعدی مفیدی باشد.
کیفیت ابزار را چگونه بسنجیم؟
قبل از پردازش یک آرشیو بزرگ، مجموعه کوچکی از فایلهای متنوع آماده کنید.
این مجموعه بهتر است شامل سند آموزشی، گزارش، راهنما، PDF دارای جلد، متن فارسی و فایلهایی با موضوع مبهم باشد.
برای هر فایل بررسی کنید:
| معیار | سؤال ارزیابی |
|---|---|
| دقت عنوان | آیا نام پیشنهادی موضوع اصلی را نشان میدهد؟ |
| اطلاعات اضافه | آیا مدل جزئیاتی را حدس زده است؟ |
| دستهبندی | آیا پوشه پیشنهادی مناسب است؟ |
| استخراج متن | آیا نمونه ورودی خوانا است؟ |
| میزان ویرایش | چند پیشنهاد به اصلاح انسانی نیاز دارند؟ |
| زمان و هزینه | پردازش هر فایل چقدر منابع مصرف میکند؟ |
نرخ موفقیت درخواست API را با کیفیت نامگذاری اشتباه نگیرید. ممکن است تمام درخواستها موفق باشند، اما تعداد زیادی عنوان به اصلاح نیاز داشته باشند.
چگونه این ابزار را به یک قابلیت نرمافزاری تبدیل کنیم؟
برای استفاده در یک پنل تحت وب، همین منطق را میتوان پشت یک API داخلی قرار داد.
کاربر فایل را بارگذاری میکند. بکاند متن را استخراج و پیشنهاد نام را ذخیره میکند. سپس رابط کاربری عنوان و دسته را نمایش میدهد تا کاربر آنها را اصلاح یا تأیید کند.
برای نسخه اولیه، امکانات زیر ارزش بیشتری دارند:
- نمایش نام فعلی کنار نام پیشنهادی
- نمایش عبارت پشتیبان
- ویرایش عنوان و دسته
- انتخاب چند فایل برای تأیید
- ثبت فایلهای ناموفق
- دانلود نسخه مرتبشده
برای پوشههای بزرگ، پردازش پسزمینه و نمایش وضعیت هر فایل نیز لازم میشود. بهتر است ابتدا کیفیت پیشنهادها را با حجم کم بسنجید و سپس اجرای انبوه را اضافه کنید.
محدودیتهای نسخه آموزشی
این برنامه یک ابزار اولیه است و چند محدودیت مشخص دارد:
- فقط فایلهای مستقیم پوشه ورودی را بررسی میکند.
- OCRانجام نمیدهد.
- فقط بخشی از سند را تحلیل میکند.
- دستهبندی چندموضوعی ندارد.
- اجرای تحلیل بهصورت ترتیبی است.
- ادامه خودکار عملیات متوقفشده را پیادهسازی نمیکند.
- برای فایلهای بسیار بزرگ یا پوشههایی که همزمان تغییر میکنند طراحی نشده است.
محدودیت اندازه فایل نیز بهتنهایی مصرف حافظه هنگام پردازش PDF را تضمین نمیکند. برای سرویس عمومی، پردازش اسناد باید در محیط دارای محدودیت منابع و مدیریت خطای مناسب انجام شود.
پرسشهای متداول
آیا هوش مصنوعی میتواند نام فایل PDF را از روی محتوا پیشنهاد دهد؟
بله. با استخراج متن و ارسال بخش مناسبی از آن به مدل زبانی، میتوان عنوان پیشنهادی دریافت کرد. دقت نتیجه به کیفیت استخراج و میزان نمایندگی متن انتخابی وابسته است.
آیا این ابزار فایل اصلی را تغییر میدهد؟
نسخه ارائهشده فایل اصلی را نگه میدارد و از آن یک نسخه با نام جدید در پوشه خروجی میسازد.
آیا PDF اسکنشده پشتیبانی میشود؟
اگر PDF لایه متنی قابلاستفاده نداشته باشد، ابتدا باید OCR انجام شود. pypdf نوشته داخل تصویر را تشخیص نمیدهد.
آیا نام فارسی برای فایل مناسب است؟
برای آرشیوی که کاربران فارسیزبان دارد، نام فارسی میتواند خواناتر باشد. سازگاری آن را با نرمافزارها و سامانههای مقصد خود بررسی کنید.
اگر دو فایل عنوان مشابه داشته باشند چه میشود؟
بخشی از هش فایل به نام اضافه میشود. اگر مقصد همچنان موجود باشد، برنامه آن را بازنویسی نمیکند و آن مورد را گزارش میدهد.
آیا اعتبارسنجی JSON کافی است؟
خیر. JSON معتبر فقط ساختار قابلپردازش را نشان میدهد. درستی عنوان، دسته و ارتباط شواهد همچنان به ارزیابی معنایی نیاز دارد.
آیا اجرای مرحله دوم دوباره هزینه API دارد؟
خیر. دستور apply از فایل پیشنهادهای ذخیرهشده استفاده میکند و درخواست جدیدی به مدل ارسال نمیکند.
آیا میتوان این قابلیت را به سایت یا برنامه اضافه کرد؟
بله. استخراج متن، تولید پیشنهاد و اجرای پیشنهاد را میتوان به سرویس بکاند تبدیل کرد و برای آن رابط بارگذاری و بازبینی ساخت.
جمعبندی
مرتبسازی فایلها با هوش مصنوعی زمانی مفید است که نام مناسب به فهم محتوای سند وابسته باشد. Python عملیات استخراج و ذخیرهسازی را انجام میدهد و مدل زبانی برای عنوان و دسته پیشنهاد میسازد.
در ابزار این مقاله، پیشنهادها ابتدا در یک فایل قابلبازبینی ذخیره میشوند. پس از اصلاح و تأیید، برنامه نسخههای مرتبشده را تولید میکند. این طراحی، هم پیگیری نتایج را آسانتر میکند و هم اجرای عملیات را از تغییرات احتمالی پاسخ مدل جدا نگه میدارد.
برای رسیدن به نتیجه مناسب، کیفیت متن استخراجشده و میزان اصلاح انسانی را اندازهگیری کنید. عنوان کوتاه و دقیق، از نام طولانیِ دارای اطلاعات حدسزدهشده ارزشمندتر است.
مقالات مرتبط
- پردازش هوشمند اسناد با هوش مصنوعی
- مقایسه فایلهای PDF و Word با هوش مصنوعی
- گفتوگو با فایل PDF با هوش مصنوعی
- آموزش هوش مصنوعی با Python وAPI
- آموزش JSON در Python وJavaScript
- مدیریت خطای 429 و محدودیت درخواستAPI
منابع
- مستندات رسمی pypdf: استخراج متن ازPDF
- مستندات رسمیPython: pathlib
- مستندات رسمیPython: unicodedata
- مستندات رسمی Pydantic: مدلها و اعتبارسنجی
- مستندات رسمی Requests: درخواست HTTP و مدیریت پاسخ
- مستندات API درواره
ساخت ابزار مدیریت اسناد با API درواره
اگر میخواهید قابلیت نامگذاری، دستهبندی یا خلاصهسازی اسناد را به برنامه خود اضافه کنید، میتوانید بخش تحلیل متن را با API درواره پیادهسازی کنید و منطق استخراج، بازبینی و ذخیرهسازی را در نرمافزار خود نگه دارید.
از یک پوشه کوچک شروع کنید، پیشنهادهای مدل را بررسی کنید و پس از سنجش کیفیت، قابلیت را به جریان کاری اصلی اضافه کنید.
برای بررسی خدمات و شروع اتصال برنامه خود به API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.