ترجمه زیرنویس SRT به فارسی با Python و API هوش مصنوعی
با Python و API هوش مصنوعی، فایل SRT را به فارسی ترجمه کنید و زمانبندی آن را حفظ کنید. این آموزش شامل کد مترجم زیرنویس، واژهنامه تخصصی، پردازش دستهای، کنترل ساختار فایل و اتصال به API درواره است.

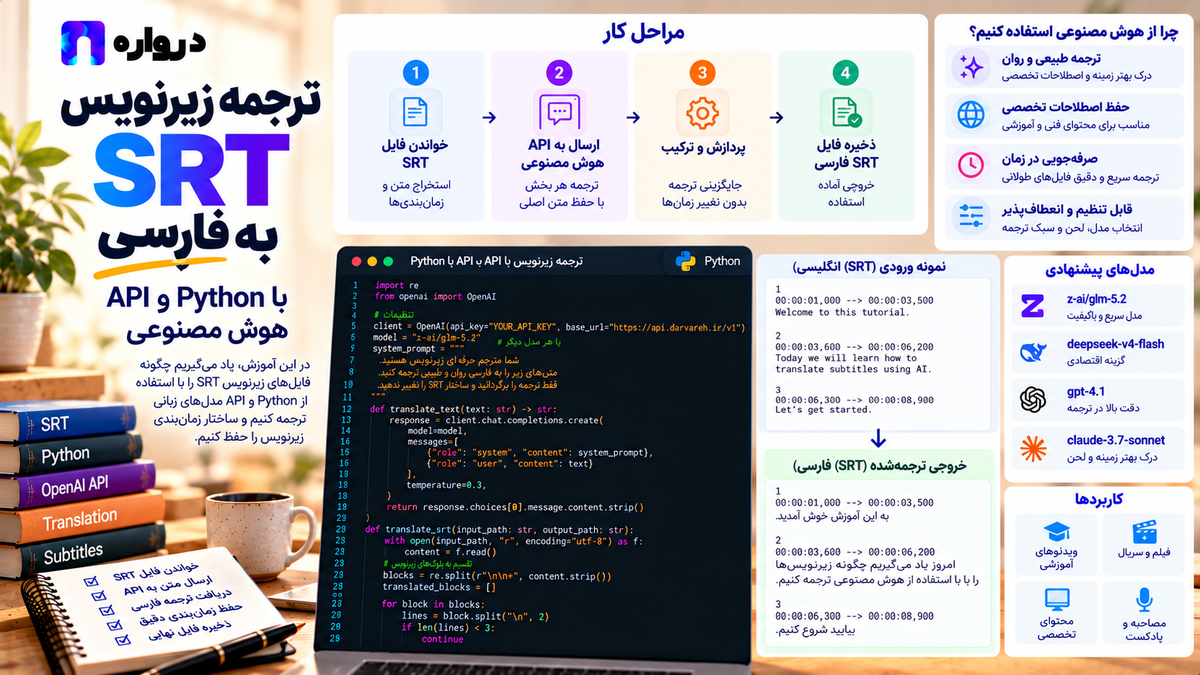
اگر برای یک ویدئوی آموزشی فایل زیرنویس انگلیسی دارید، برای ساخت نسخه فارسی لازم نیست دوباره صدا را به متن تبدیل کنید. میتوانید متن همان زیرنویس را ترجمه کنید و زمان نمایش هر قسمت را نگه دارید.
این کار برای دورههای برنامهنویسی، آموزش نرمافزار، معرفی محصول و ویدئوهای سازمانی کاربرد دارد. اما ارسال کل فایل به یک مدل و درخواست «این زیرنویس را ترجمه کن» همیشه نتیجه قابل استفادهای نمیدهد.
مدل ممکن است چند قطعه را ادغام کند، شمارهها را تغییر دهد، بخشی از متن را حذف کند یا توضیح اضافی بنویسد.
راهحل بهتر این است که برنامه مسئول ساختار فایل باشد و مدل فقط ترجمه متن را انجام دهد.
در این آموزش، یک مترجم فایل SRT با Python و API درواره میسازیم که:
- متن زیرنویس را به فارسی ترجمه میکند.
- شماره و زمانبندی قطعات را حفظ میکند.
- چند قطعه را در هر درخواست پردازش میکند.
- از واژهنامه تخصصی استفاده میکند.
- خروجی مدل را پیش از ساخت فایل بررسی میکند.
- فایل اصلی را بازنویسی نمیکند.
تفاوت ترجمه زیرنویس و ساخت زیرنویس
این دو فرایند به ورودی و ابزار متفاوتی نیاز دارند.
| کار | ورودی | پردازش اصلی | خروجی |
|---|---|---|---|
| ساخت زیرنویس | صوت یا ویدئو | تشخیص گفتار و زمانبندی | فایل زیرنویس |
| ترجمه زیرنویس | فایل SRT موجود | ترجمه متن | زیرنویس زبان مقصد |
| اصلاح زیرنویس | فایل زیرنویس | ویرایش متن یا زمانها | نسخه اصلاحشده |
در این مقاله، فرض میکنیم زیرنویس اولیه موجود است و با ویدئو هماهنگی دارد.
اگر زمانبندی ورودی اشتباه باشد، ترجمه آن را اصلاح نمیکند. برای اصلاح هماهنگی باید مرحله جداگانهای داشته باشید.
فایل SRT چیست؟
SRTیک قالب متنی رایج برای زیرنویس است. هر قطعه معمولاً شامل شماره، زمان شروع و پایان و متن نمایشدادهشده است. قطعات با خط خالی از هم جدا میشوند.
نمونه:
1
00:00:01,000 --> 00:00:04,000
Create an API key before running the application.

2
00:00:04,500 --> 00:00:07,000
Then send your first request.
نسخه ترجمهشده میتواند چنین باشد:
1
00:00:01,000 --> 00:00:04,000
پیش از اجرای برنامه، یک کلید API بسازید.

2
00:00:04,500 --> 00:00:07,000
سپس اولین درخواست را ارسال کنید.
در مثال بالا، متن عوض شده است، اما شماره و زمانها همان مقادیر اولیه هستند.
چرا زمانبندی را به مدل نمیدهیم؟
برای ترجمه، مدل به متن و مقداری بافت نیاز دارد. تولید دوباره Timestamp ضروری نیست.
در معماری این آموزش:
- Pythonفایل را میخواند.
- قطعات زیرنویس استخراج میشوند.
- فقط متن قطعات با شناسه داخلی به مدل ارسال میشود.
- ترجمهها به قطعات اولیه متصل میشوند.
- فایل خروجی با زمانهای اصلی ساخته میشود.
این جداسازی، کنترل ساختار را قابل بررسی میکند. البته ترجمه ممکن است همچنان از نظر معنا یا خوانایی نیازمند اصلاح باشد.
پیشنیازهای ساخت مترجم زیرنویس
برای اجرای نمونه به این موارد نیاز دارید:
- Python 3.10یا جدیدتر
- فایل SRT با متن قابل خواندن
- کلید API درواره
- شناسه یک مدل متنی پشتیبانیشده
- اتصال شبکه
در این پروژه به مدل تشخیص گفتار یا Embedding نیاز نداریم. کار اصلی، ترجمه متن است.
مدل مناسب را بر اساس کیفیت فارسی، عملکرد روی اصطلاحات حوزه شما، زمان پاسخ و هزینه انتخاب کنید. طول ورودی و پارامترهای پشتیبانیشده را در مستندات درواره بررسی کنید.
نصب کتابخانهها
pip install openai srt pydanticنقش کتابخانهها:
| کتابخانه | کاربرد |
|---|---|
openai | ارسال درخواست با کلاینت سازگار |
srt | خواندن و ساخت فایل زیرنویس |
pydantic | بررسی ساختار خروجی مدل |
کتابخانه srt برای پردازش، تغییر و ساخت زیرنویس طراحی شده و اطلاعات متن و زمان هر قطعه را جدا نگه میدارد. srt 3.5.3 documentation
تنظیم کلید API و مدل
در Linux وmacOS:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
درPowerShell:
$env:DARVAREH_API_KEY="YOUR_API_KEY"
$env:DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
شناسه مدل را دقیقاً مطابق فهرست مدلهای قابل استفاده وارد کنید. نام نمایشی مدل ممکن است با شناسه موردنیاز API متفاوت باشد.
ساخت فایل برنامه
کدهای بخشهای بعدی را بهترتیب در فایلی با نام translate_srt.py قرار دهید.
واردکردن کتابخانهها و تعریف قالب خروجی
از مدل میخواهیم برای هر قطعه، شناسه و ترجمه برگرداند:
import argparseimport jsonimport osimport refrom dataclasses import replacefrom pathlib import Pathimport srtfrom openai import OpenAIfrom pydantic import ( BaseModel, ConfigDict, Field,)class TranslationItem(BaseModel): model_config = ConfigDict( extra="forbid", strict=True, ) cue_id: int translation: str = Field(min_length=1)class TranslationBatch(BaseModel): model_config = ConfigDict( extra="forbid", strict=True, ) items: list[TranslationItem]Pydantic ساختار داده را با مدل تعریفشده تطبیق میدهد. در اینجا، قالب معتبر JSONرا بررسی میکنیم؛ این بررسی بهتنهایی صحت ترجمه را تأیید نمیکند. Pydantic Docs
تعریف واژهنامه تخصصی
GLOSSARY = { "artificial intelligence": "هوش مصنوعی", "API": "API", "API key": "کلید API", "request": "درخواست", "response": "پاسخ", "embedding": "Embedding", "fine-tuning": "فاینتیونینگ",}واژهنامه را با مخاطب هماهنگ کنید. برای دوره مقدماتی، ترجمه فارسی بسیاری از اصطلاحات مناسب است. در دوره تخصصی، حفظ برخی واژهها میتواند فهم آموزش و تطبیق با مستندات را آسانتر کند.
وجود واژهنامه در درخواست، رعایت آن را تضمین نمیکند؛ چند اصطلاح مهم را در خروجی بررسی کنید.
خواندن فایلSRT
def read_subtitles( input_path: Path,) -> list[srt.Subtitle]: raw = input_path.read_text( encoding="utf-8-sig" ) subtitles = list( srt.parse( raw, ignore_errors=False, ) ) if not subtitles: raise ValueError( "The subtitle file is empty" ) for subtitle in subtitles: if ( subtitle.start.total_seconds() < 0 or subtitle.end <= subtitle.start ): raise ValueError( "Invalid subtitle timing" ) if not subtitle.content.strip(): raise ValueError(این نمونه برای زیرنویس متنی ساده نوشته شده است. اگر فایل دارای تگهایی مانند <i> باشد، باید حفظ و اعتبارسنجی تگها را به برنامه اضافه کنید.
کد، همپوشانی زمانی دو قطعه را خودکار خطا نمیداند؛ چنین همپوشانیای ممکن است در بعضی فایلها عمدی باشد.
ترجمه یک دسته از قطعات
شناسه داخلی cue_id بر اساس موقعیت قطعه در فایل ساخته میشود. این شناسه با شماره اصلی SRT تفاوت دارد و فقط برای اتصال ترجمه به قطعه استفاده میشود.
def translate_batch( client: OpenAI, model: str, subtitles: list[srt.Subtitle], start_position: int, batch_size: int,) -> dict[int, str]: batch = subtitles[ start_position: start_position + batch_size ] items = [ { "cue_id": start_position + offset, "text": subtitle.content, } for offset, subtitle in enumerate(batch) ] before = [ subtitle.content for subtitle in subtitles[ max(0, start_position - 2): start_position ] ] after_start = start_position + len(batch) after = [ subtitle.contentدو قطعه قبل و بعد، بافت محدودی برای فهم جملههای ناتمام فراهم میکنند. این روش جای بازبینی پیوستگی کل ویدئو را نمیگیرد.
اگر مدل بهجای JSON، متن توضیحی یا بلوک کد برگرداند، برنامه خطا میدهد. بهتر است این خطا آشکار باشد تا ترجمه ناقص، بیصدا وارد فایل نشود.
ساخت خروجی با زمانهای اصلی
def timing_signature( subtitles: list[srt.Subtitle],): return [ ( subtitle.index, subtitle.start, subtitle.end, subtitle.proprietary, ) for subtitle in subtitles ]def translate_file( input_path: Path, output_path: Path, batch_size: int = 12,): if input_path.resolve() == output_path.resolve(): raise ValueError( "Input and output paths must differ" ) if output_path.exists(): raise FileExistsError( "The output file already exists" ) if batch_size < 1: raise ValueError(گزینه reindex=False برای جلوگیری از شمارهگذاری مجدد استفاده شده است. پس از ساخت خروجی، فایل دوباره پردازش میشود و شمارهها و زمانها با ورودی تطبیق داده میشوند. این رفتار با امکانات مستند کتابخانه srt سازگار است. srt 3.5.3 documentation
این کد مقادیر زمانبندی را حفظ میکند؛ الزاماً قالب ظاهری و پایان خطهای فایل را بایتبهبایت یکسان نگه نمیدارد.
اجرای برنامه از خط فرمان
این قسمت را در انتهای همان فایل قرار دهید:
if __name__ == "__main__": parser = argparse.ArgumentParser( description=( "Translate plain-text SRT subtitles " "to Persian with Darvareh API" ) ) parser.add_argument("input") parser.add_argument("output") parser.add_argument( "--batch-size", type=int, default=12, ) args = parser.parse_args() translate_file( input_path=Path(args.input), output_path=Path(args.output), batch_size=args.batch_size, )اجرا:
python translate_srt.py lesson-en.srt lesson-fa.srtبرای دستههای کوچکتر:
python translate_srt.py lesson-en.srt lesson-fa.srt --batch-size 6ماژول استاندارد argparse برای تعریف ورودیهای خط فرمان استفاده شده است؛ بنابراین، مسیر فایلها بدون تغییر کد قابل تعیین است. Python 3.14.8 documentation
اندازه دستهها را چگونه انتخاب کنیم؟
تعداد قطعات، معیار دقیقی برای حجم ورودی نیست. دوازده قطعه کوتاه با دوازده قطعه بلند تفاوت زیادی دارند.
در این نمونه، اندازه دسته بر اساس تعداد قطعات تعیین میشود. برای نسخه کاربردیتر، مجموع توکنهای متن، واژهنامه، بافت و خروجی مورد انتظار را نیز در نظر بگیرید.
| دسته کوچکتر | دسته بزرگتر |
|---|---|
| بررسی خطا آسانتر | تعداد درخواست کمتر |
| نیاز به خروجی کوتاهتر | بافت پیوسته بیشتر |
| سربار درخواست بیشتر | خطر خروجی ناقص بیشتر |
| مناسب شروع آزمایش | نیازمند کنترل طول دقیقتر |
با نمونه کوتاه شروع کنید و بر اساس محدودیت مدل و نتیجه آزمایش، اندازه را تغییر دهید.
حفظ زمانبندی با خوانایی یکسان نیست
ممکن است ترجمه از نظر معنایی درست باشد، اما در مدت نمایش قطعه خوانده نشود.
برای مثال، یک عبارت کوتاه انگلیسی ممکن است در فارسی به جمله بلندتری تبدیل شود. نگهداشتن زمان اصلی در این حالت به کنترل جداگانه خوانایی نیاز دارد.
میتوانید قطعات دارای این نشانهها را برای بازبینی مشخص کنید:
- متن بسیار بلند
- بیش از دو خط
- زمان نمایش کوتاه
- جمله ناتمام یا شکست نامناسب خط
- ترکیب پیچیده فارسی و انگلیسی
راهنمای رسمی Netflix، برای محتوای مخصوص آن پلتفرم، حداکثر دو خط و اصول مشخصی برای شکستن جملهها تعیین میکند. این قواعد نمونهای از دستورالعمل حرفهای هستند؛ برای هر پروژه باید الزامات مقصد انتشار را بررسی کرد. Partner Help Center
اگر به تغییر زمانبندی نیاز پیدا کردید، آن را مرحلهای مستقل انجام دهید. مترجم این آموزش زمانها را خودکار تغییر نمیدهد.
کنترل کیفیت ترجمه فارسی
صحت ساختار و کیفیت ترجمه را جدا بررسی کنید.
| کنترل ساختاری | کنترل زبانی |
|---|---|
| تعداد قطعات حفظ شده است | معنای جمله حفظ شده است |
| شمارهها تغییر نکردهاند | نفی و شرط درست منتقل شدهاند |
| زمانها یکساناند | اصطلاحات یکدست هستند |
| متن خالی وجود ندارد | نامها و اعداد درستاند |
| فایل دوباره قابل پردازش است | ترجمه طبیعی و خواناست |
برای ویدئوی برنامهنویسی، نام تابع، دستور، مسیر فایل و پیام خطا را با دقت بررسی کنید. ترجمه نام یک دستور میتواند اجرای آموزش را برای مخاطب دشوار کند.
برای ارزیابی اولیه، چند قطعه از ابتدا، وسط و انتهای ویدئو و چند قطعه دارای اصطلاح، عدد یا جمله منفی انتخاب کنید.
جلوگیری از ترجمه ناهماهنگ اصطلاحات
یک اصطلاح ممکن است در دستههای مختلف با معادلهای متفاوت ترجمه شود.
برای کاهش این مشکل:
- واژهنامه را در همه درخواستها ارسال کنید.
- نام محصول و اصطلاحات پرتکرار را از قبل تعیین کنید.
- لحن رسمی یا محاورهای را مشخص کنید.
- ترجمه اصطلاحات مهم را در خروجی بررسی کنید.
- واژهنامه را برای هر حوزه جدا نگه دارید.
برای دورههای فنی، «API» را میتوان حفظ کرد، اما عبارتی مانند «send a request» معمولاً با «ارسال درخواست» روشنتر است.
هدف، قابل فهم بودن ترجمه برای مخاطب است؛ نه فارسیکردن اجباری تمام واژهها یا حفظ بیدلیل همه اصطلاحات انگلیسی.
خطاهای رایج هنگام اجرا
فایل خوانده نمیشود
کد انتظار UTF-8 دارد و BOM این رمزگذاری را نیز میپذیرد. اگر فایل با رمزگذاری دیگری ذخیره شده است، آن را ابتدا به UTF-8 تبدیل کنید.
پاسخ مدل JSON نیست
دستور را بررسی کنید یا در صورت پشتیبانی مدل و مسیر API، خروجی ساختاریافته را بهصورت جداگانه آزمایش کنید.
بعضی قطعات در پاسخ غایباند
اندازه دسته را کاهش دهید. حذف قطعات نباید با خروجی ناقص پذیرفته شود.
خطای محدودیت درخواست رخ میدهد
سرعت پردازش را کاهش دهید و سیاست Retry محدود طراحی کنید. ارسال مجدد درخواست ممکن است مصرف بیشتری ایجاد کند.
زمان انتظار تمام میشود
اندازه دسته، مدل و زمان انتظار را بررسی کنید. Timeout سمت برنامه الزاماً به معنی انجامنشدن پردازش در سرویس نیست.
زیرنویس فارسی نامناسب نمایش داده میشود
فایل را در پخشکننده مقصد بررسی کنید. چینش فارسی و انگلیسی، فونت و پشتیبانی پخشکننده بر نمایش اثر دارند.
پردازش فایلهای طولانی و ادامه پس از قطع ارتباط
نسخه آموزشی، ترجمهها را تا پایان در حافظه نگه میدارد. اگر اجرای آن متوقف شود، دستههای موفق قبلی باید دوباره پردازش شوند.
برای نسخه حرفهای، ذخیره نتیجه هر دسته را اضافه کنید. رکورد ذخیرهشده بهتر است شامل این موارد باشد:
- شناسه فایل و اثر انگشت محتوای ورودی
- شناسه قطعات
- ترجمههای تأییدشده
- مدل و نسخه دستور ترجمه
- واژهنامه استفادهشده
در اجرای بعدی، فقط دستههای ناقص را ادامه دهید. تطبیق فایل ورودی اهمیت دارد؛ ترجمه ذخیرهشده یک نسخه نباید به قطعات نسخه دیگری متصل شود.
این قابلیت در کد بالا پیادهسازی نشده است و برای پردازش طولانی باید به آن اضافه شود.
چگونه این برنامه را به سرویس تبدیل کنیم؟
همین منطق میتواند هسته یک ابزار ترجمه زیرنویس باشد.
در نسخه تحت وب، کاربر فایل را بارگذاری میکند، زبان و واژهنامه را انتخاب میکند و پس از تکمیل پردازش، خروجی را دریافت میکند.
برای فایلهای طولانی، پردازش را به Job پسزمینه تبدیل کنید تا کاربر مجبور نباشد یک درخواست HTTP طولانی را باز نگه دارد.
وضعیتهای مفید شامل این موارد هستند:
- دریافتشده
- در حال پردازش
- نیازمند بررسی
- تکمیلشده
- ناموفق
در محصول، نمایش متن اصلی و ترجمه کنار هم ارزش زیادی دارد. کاربر باید بتواند ترجمه یک قطعه را اصلاح کند و بدون ترجمه دوباره کل فایل، خروجی بگیرد.
کنترل هزینه ترجمه زیرنویس
مصرف این برنامه به حجم ورودی و خروجی، مدل و تعداد درخواستهای مجدد وابسته است.
برای کنترل هزینه:
- فقط متن لازم را ارسال کنید.
- واژهنامه را کوتاه و مرتبط نگه دارید.
- بافت همسایه را محدود کنید.
- دستههای موفق را در نسخه حرفهای ذخیره کنید.
- مدلها را روی نمونه ثابت مقایسه کنید.
ارزانترین درخواست الزاماً کمهزینهترین نتیجه نهایی نیست. اگر ترجمه نیازمند اصلاح زیاد یا تکرار پردازش باشد، هزینه کل افزایش پیدا میکند.
پرسشهای متداول
آیا این برنامه برای ترجمه زیرنویس به فارسی است؟
بله. دستور نمونه برای ترجمه فارسی تنظیم شده است.
آیا زمانبندی SRT تغییر میکند؟
کد زمانها را از ورودی نگه میدارد و پیش از ذخیره با خروجی تطبیق میدهد.
آیا به فایل ویدئو نیاز داریم؟
برای ترجمه خیر. برای بازبینی هماهنگی و خوانایی، مشاهده ویدئو مفید است.
آیا برنامه زیرنویس را از صدا میسازد؟
خیر. ورودی باید فایل SRT موجود باشد.
آیا همه مدلها خروجی JSON درست میدهند؟
خیر. خروجی باید اعتبارسنجی شود و مدل مناسب با آزمایش انتخاب شود.
آیا فایل دارای تگ پشتیبانی میشود؟
این نمونه فقط متن ساده را میپذیرد. حفظ تگها نیازمند توسعه جداگانه است.
آیا ترجمه آماده انتشار است؟
خروجی ساختاری بررسی میشود، اما کیفیت زبانی و خوانایی به بازبینی نیاز دارد.
آیا برنامه پس از قطع ارتباط ادامه میدهد؟
نسخه آموزشی چنین قابلیتی ندارد. برای ادامه از نقطه توقف، ذخیره نتایج هر دسته را اضافه کنید.
جمعبندی
برای ساخت مترجم زیرنویس، بهتر است ساختار فایل را به برنامه بسپارید و مدل را فقط برای ترجمه متن به کار بگیرید.
در نمونه این مقاله، Python قطعات را استخراج میکند، متنها را دستهای به API میفرستد، شناسههای برگشتی را بررسی میکند و خروجی را با زمانهای اصلی میسازد.
این معماری پایه مناسبی برای یک ابزار کاربردی است. برای استفاده گستردهتر، ذخیره نتایج، ادامه پس از توقف و ویرایشگر بازبینی را به آن اضافه کنید.
مقالات مرتبط
- ساخت زیرنویس خودکار فارسی با هوش مصنوعی
- ابزارهای ترجمه با هوش مصنوعی
- ترجمه PDF به فارسی با هوش مصنوعی
- آموزش هوش مصنوعی با Python وAPI
- JSON و کاربرد آن در API
- مدیریت خطای 429 و محدودیت درخواست
- پردازش غیرهمزمان درخواستهای هوش مصنوعی
منابع
- مستندات رسمی کتابخانهsrt
- مخزن رسمی کتابخانهsrt
- مستندات مدلهایPydantic
- مستندات argparse درPython
- مستندات pathlib درPython
- راهنمای عمومی زیرنویسNetflix
- مستندات API درواره
مترجم زیرنویس خود را با API درواره بسازید
اگر میخواهید ترجمه زیرنویس را به سایت، نرمافزار آموزشی یا ابزار داخلی خود اضافه کنید، میتوانید از API درواره برای اجرای بخش ترجمه استفاده کنید و کنترل فایل، زمانبندی و بازبینی را در برنامه خود نگه دارید.
با یک فایل کوتاه شروع کنید، چند مدل پشتیبانیشده را روی همان متن مقایسه کنید و بر اساس کیفیت فارسی، هزینه و زمان پاسخ، مدل مناسب را انتخاب کنید.
برای بررسی مدلها و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.