Corrective RAG چیست؟ آموزش CRAG و اصلاح بازیابی با Python
Corrective RAG چیست و چگونه نتایج ضعیف جستوجو را اصلاح میکند؟ در این راهنما، CRAG، ارزیابی منابع، مسیرهای اصلاح بازیابی و تفاوت با Self-RAG را همراه با کد Python و روش ارزیابی بررسی میکنیم.

یک سامانه RAG ممکن است پاسخ نامناسبی تولید کند، حتی اگر مدل زبانی آن قدرتمند باشد. گاهی مشکل پیش از تولید پاسخ رخ میدهد: موتور جستوجو منابع اشتباه را پیدا کرده است.
فرض کنید کاربر درباره «شرایط تمدید طرح سازمانی» میپرسد، اما نتایج جستوجو شامل راهنمای طرح شخصی هستند. متنها از نظر واژگانی مشابهاند، اما برای پاسخ به پرسش مناسب نیستند.
اگر این منابع بدون بررسی وارد زمینه مدل شوند، پاسخ میتواند روان و دارای استناد باشد، ولی درباره موضوع اشتباه توضیح دهد.
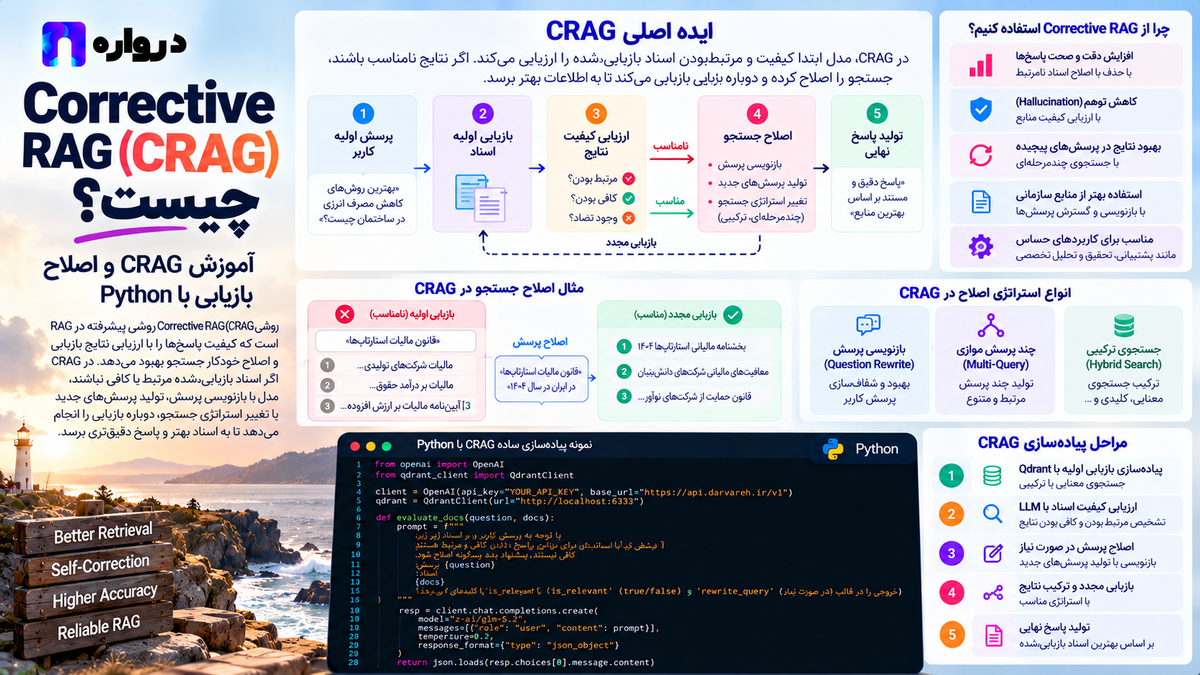
Corrective RAG یا CRAG برای مدیریت چنین وضعیتی طراحی شده است. ایده اصلی این است که کیفیت بازیابی را بررسی کنیم و بر اساس نتیجه، مسیر استفاده از اطلاعات را تغییر دهیم.
گاهی منابع اولیه مناسباند. گاهی باید آنها را کنار گذاشت و جستوجوی دیگری انجام داد. در بعضی موارد نیز بخشی از اطلاعات مفید است، اما به تکمیل نیاز دارد.
در این مقاله، منطق CRAG، تفاوت آن با RAG معمولی و Self-RAG، پیادهسازی آموزشی Python و روش ارزیابی این معماری را بررسی میکنیم.
Corrective RAGچیست؟
CRAGمخفف Corrective Retrieval-Augmented Generation است؛ یعنی تولید تقویتشده با بازیابی اصلاحی.
مقاله این روش توسط Shi-Qi Yan و همکاران در ژانویه ۲۰۲۴ منتشر شد. چارچوب پیشنهادی، کیفیت نتایج بازیابی را ارزیابی میکند و بر اساس آن، اقدام مناسب برای دریافت و استفاده از دانش را انتخاب میکند.
روش اصلی از یک ارزیاب بازیابی مبتنی بر T5 آموزشدیده استفاده میکند. جستوجوی وب و پالایش اطلاعات نیز از اجزای چارچوب هستند. arxiv.org
هدف CRAG این است که سامانه، نتیجه جستوجو را بدون بررسی وارد مرحله تولید نکند.
بااینحال، وجود ارزیاب به معنی تشخیص بیخطای منبع مناسب نیست. ارزیاب نیز یک مدل است و عملکرد آن باید سنجیده شود.
چرا RAG معمولی به مسیر اصلاح نیاز دارد؟
در یک خط لوله ساده، سامانه چند نتیجه برتر را دریافت میکند و آنها را به مدل پاسخگو میدهد.
این طراحی ممکن است با چند نوع مشکل روبهرو شود:
- پرسش مبهم است.
- نمایه، سند موردنیاز را ندارد.
- نام محصول درست تشخیص داده نشده است.
- نسخه قدیمی سند بازیابی شده است.
- اطلاعات پاسخ میان چند بخش پراکندهاند.
- قطعه مرتبط، شرط یا استثنای لازم را ندارد.
همه این خطاها با افزایش تعداد نتایج حل نمیشوند. دریافت اسناد بیشتر ممکن است فقط متن نامرتبط بیشتری وارد زمینه کند.
مسیر اصلاح باید متناسب با نوع مشکل انتخاب شود. برای مثال، بازنویسی پرسش میتواند تطبیق را بهتر کند، اما سندی را که در نمایه وجود ندارد به آن اضافه نمیکند.
سه مسیر اصلیCRAG
در چارچوب اصلی، نتایج بر اساس ارزیابی به سه وضعیت تقسیم میشوند:
| وضعیت | منطق کلی | اقدام |
|---|---|---|
Correct | دستکم یک نتیجه از آستانه بالایی عبور میکند | پالایش و استفاده از اطلاعات داخلی |
Incorrect | همه نتایج پایینتر از آستانه پایینیاند | دریافت اطلاعات از مسیر دیگر |
Ambiguous | شرایط دو حالت قبلی برقرار نیست | ترکیب اطلاعات داخلی و تکمیلی |
در مقاله، مسیر تکمیلی بر جستوجوی وب تکیه دارد. برای وضعیت مبهم، اطلاعات داخلی پالایششده با اطلاعات بیرونی ترکیب میشوند. arxiv.org
نام Correct در اینجا یک وضعیت تصمیمگیری درباره بازیابی است. نباید آن را به معنی «تمام محتوای منابع از نظر واقعی درست است» دانست.
ارتباط منبع با کافیبودن آن فرق دارد
فرض کنید سند درباره طرح سازمانی است و به پرسش کاربر ارتباط دارد، اما کاربر درباره «تمدید پس از پایان قرارداد» پرسیده است.
اگر سند فقط امکانات طرح را شرح دهد، ارتباط موضوعی دارد ولی برای پاسخ کافی نیست.
بنابراین، در طراحی محصول بهتر است دو بررسی جدا داشته باشید:
- آیا منبع به موضوع پرسش مربوط است؟
- آیا مجموعه منابع، اطلاعات لازم برای پاسخ را فراهم میکند؟
امتیاز ارتباط بالا میتواند دلیل نگهداشتن یک منبع باشد. اما برای پاسخ قطعی، باید شرطها، زمان، نسخه و دامنه کاربرد اطلاعات نیز بررسی شوند.
تفاوت CRAG وSelf-RAG
| ویژگی | Corrective RAG | Self-RAG اصلی |
|---|---|---|
| تمرکز | اصلاح استفاده از نتایج بازیابی | بازیابی و نقد در فرایند تولید |
| تصمیمگیری | ارزیاب و مسیرهای اصلاح | رفتار آموزشدیده و توکنهای بازاندیشی |
| اقدام شاخص | استفاده، جایگزینی یا تکمیل منابع | تصمیم درباره بازیابی و ارزیابی تولید |
| پیادهسازی آموزشی با API | قابل طراحی | قابل الهامگیری، با تفاوت از روش اصلی |
این روشها الزاماً رقیب نیستند. یک معماری میتواند منابع را ارزیابی کند و سپس پاسخ تولیدشده را نیز با شواهد تطبیق دهد.
در مخزن رسمی CRAG، علاوه بر اجرای CRAG، مسیرهایی برای آمادهسازی اطلاعات و اجرای ترکیبهایی با Self-RAG ارائه شده است. GitHub
CRAGنام یک بنچمارک دیگر هم هست
Comprehensive RAG Benchmark نیز با مخفف CRAG شناخته میشود. این پروژه، بنچمارک ارزیابی سامانههای RAG است و با الگوریتم Corrective Retrieval-Augmented Generation تفاوت دارد. GitHub
در کاربرد سازمانی، مسیر جایگزین چه میتواند باشد؟
در طراحی الهامگرفته از CRAG، مسیر تکمیلی میتواند متناسب با کاربرد انتخاب شود:
- جستوجوی واژگانی پس از بازیابی برداری
- نمایه مستندات رسمی محصول
- نسخه کامل سند بهجای قطعه کوتاه
- پایگاه دانش دیگری از همان سازمان
- جستوجو در سایت رسمی سازنده
- دریافت اطلاعات از یک API عملیاتی
برای سؤال درباره سیاست داخلی شرکت، یک صفحه عمومی وب معمولاً جایگزین سند داخلی نیست.
برای سؤال درباره وضعیت سفارش نیز منبع مناسب میتواند API سفارش باشد؛ شباهت معنایی یک مقاله به پرسش، وضعیت واقعی سفارش را مشخص نمیکند.
این انتخابها توسعههای کاربردی معماری هستند و نباید آنها را عین تنظیمات آزمایش مقاله معرفی کرد.
آموزش عملی مسیرهای اصلاح باPython
در مثال زیر، ابتدا منطق تصمیمگیری را بدون وابستگی به مدل میسازیم. سپس نحوه دریافت امتیاز از API و تولید پاسخ را اضافه میکنیم.
این نمونه از ایده CRAG الهام گرفته است و بازتولید مدل ارزیاب یا کل آزمایشهای مقاله نیست.
امتیازهای مثال در محدوده صفر تا یک تعریف شدهاند. آستانههای آن آموزشیاند و مقدار توصیهشده عمومی محسوب نمیشوند.
تعریف منبع و تابع تصمیمگیری
from dataclasses import dataclassfrom math import isfinitefrom typing import Callable, LiteralRoute = Literal[ "correct", "incorrect", "ambiguous",]@dataclass(frozen=True)class Source: id: str text: str score: float origin: strdef decide_route( sources: list[Source], lower: float = 0.3, upper: float = 0.8,) -> Route: if not 0 <= lower < upper <= 1: raise ValueError( "Expected 0 <= lower < upper <= 1" ) scores = [ source.score for source in sources ] if any( not isfinite(score)در این قرارداد، امتیاز دقیقاً برابر آستانهها، بهتنهایی مسیر مناسب یا نامناسب را فعال نمیکند و در حالت مبهم قرار میگیرد.
انتخاب رفتار مرزی باید مشخص و قابل تکرار باشد.
اجرای اصلاح و حذف نتایج تکراری
تابع بعدی، مسیر جایگزین را فقط وقتی لازم باشد اجرا میکند.
def corrective_retrieval( question: str, primary_sources: list[Source], alternative_search: Callable[ [str], list[Source] ], lower: float = 0.3, upper: float = 0.8,) -> dict: route = decide_route( primary_sources, lower=lower, upper=upper, ) external_sources = [] if route in {"incorrect", "ambiguous"}: external_sources = alternative_search( question ) # اعتبارسنجی امتیازهای مسیر تکمیلی decide_route( external_sources, lower=lower, upper=upper, ) if route == "correct":فیلد has_candidates فقط وجود منابع باقیمانده را نشان میدهد. این مقدار، کافیبودن شواهد یا صحت پاسخ را تأیید نمیکند.
مثال سه مسیر
def demo_alternative_search(
question: str,
) -> list[Source]:
return [
Source(
id="official-guide:renewal:v2",
text=(
"تمدید طرح سازمانی نیازمند تأیید "
"قرارداد جدید پیش از پایان دوره است."
),
score=0.91,
origin="alternative",
)
]
examples = {
"strong": [
Source(
id="internal:renewal:v2",
text=(
"شرایط تمدید طرح سازمانی در "
"قرارداد دوره بعد مشخص میشود."
),
score=0.92,
origin="primary",
)
],
"weak": [
Source(
id="personal-plan:features",
text="طرح شخصی برای استفاده فردی است.",
score=0.12,
origin="primary",
)
],
"uncertain": [
Source(
id="internal:general-subscription",
text=(
"شرایط اشتراک ممکن است با نوع "
"قرارداد متفاوت باشد."
),
score=0.55,
origin="primary",
)
],
}
for name, sources in examples.items():
result = corrective_retrieval(
question="شرایط تمدید طرح سازمانی چیست؟",
primary_sources=sources,
alternative_search=demo_alternative_search,
)
print(
name,
result["initial_route"],
result["alternative_search_used"],
[
source.id
for source in result["sources"]
],
)در این نمونه:
- حالت
strongاز منابع اولیه استفاده میکند. - حالت
weakمنابع اولیه را کنار میگذارد. - حالت
uncertainمنابع اولیه و تکمیلی را ترکیب میکند.
متنها و امتیازها فرضیاند. تابع جایگزین نیز خروجی ثابت دارد تا منطق برنامه روشن باشد؛ این بخش جستوجوی واقعی انجام نمیدهد.
امتیاز ارزیابی را چگونه از API بگیریم؟
برای نمونهسازی میتوان مدل زبانی را ارزیاب قرار داد. در این حالت باید خروجی را اعتبارسنجی کنید و عملکرد مدل را جداگانه بسنجید.
نصب کتابخانهها:
pip install openai pydanticتنظیم محیط:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
ساخت ارزیاب
import jsonimport osfrom openai import OpenAIfrom pydantic import ( BaseModel, ConfigDict, Field,)client = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1",)class RelevanceAssessment(BaseModel): model_config = ConfigDict( extra="forbid", allow_inf_nan=False, ) score: float = Field( ge=0, le=1, ) reason: strdef evaluate_source( question: str, text: str,) -> RelevanceAssessment: response = client.chat.completions.create( model=os.environ["DARVAREH_CHAT_MODEL"], messages=[ {این امتیاز، خروجی یک داوری مدلمحور است. عبارت «بسیار مرتبط» نیز باید با نمونههای واقعی تعریف و کالیبره شود.
آستانههای تابع قبلی را نمیتوان بدون آزمایش به این ارزیاب منتقل کرد.
تبدیل نتایج جستوجو به منابع امتیازدار
def score_search_results( question: str, results: list[dict], origin: str,) -> list[Source]: scored = [] for item in results: assessment = evaluate_source( question, item["text"], ) scored.append( Source( id=item["id"], text=item["text"], score=assessment.score, origin=origin, ) ) return scoredدر محصول واقعی، دلیل ارزیابی، نسخه مدل و متن دقیق ورودی را نیز برای تحلیل کیفیت نگه دارید.
امتیاز شباهت برداری را مستقیماً جای این امتیاز نگذارید. شباهت و ارزیابی ارتباط، تعریف و توزیع متفاوتی دارند.
تولید پاسخ از منابع اصلاحشده
def generate_answer( question: str, sources: list[Source],) -> str: if not sources: return ( "منبع مناسبی برای پاسخ در نتایج موجود نیست." ) evidence = [ { "id": source.id, "text": source.text, "origin": source.origin, } for source in sources ] response = client.chat.completions.create( model=os.environ["DARVAREH_CHAT_MODEL"], messages=[ { "role": "system", "content": ( "فقط از منابع ارائهشده پاسخ بده. " "شرایط و استثناها را حفظ کن. " "برای ادعاهای مستند، شناسه منبع "این نمونه برای تولید پاسخ آماده است، اما کنترل کفایت و تطبیق ادعاهای خروجی باید در ارزیابی محصول بررسی شود. انتخاب منابع اصلاحشده، بهتنهایی پاسخ نهایی را تأیید نمیکند.
پالایش منابع بدون حذف شروط مهم
پالایش یعنی اطلاعات نامرتبط را از زمینه کنار بگذاریم. اما حذف جملههای ظاهراً کمارتباط میتواند خطا بسازد.
برای مثال، این جمله پاسخ مستقیم را دارد:
تمدید اشتراک امکانپذیر است.
جمله بعدی شرط لازم را بیان میکند:
این امکان فقط برای قراردادهایی فراهم است که پیش از پایان دوره تأیید شدهاند.
اگر پالایش فقط جمله اول را حفظ کند، پاسخ عمومی و ناقص میشود.
در طراحی کاربردی، بهتر است بخشهای معنایی کامل را انتخاب کنید: حکم همراه شرط، جدول همراه سرستون، یا دستورالعمل همراه هشدار مرتبط.
همچنین متن اصلی و محل قطعات انتخابشده را نگه دارید تا پالایش قابل بررسی باشد.
مدیریت تعارض منابع
ترکیب منابع داخلی و تکمیلی ممکن است تعارض ایجاد کند.
برای نمونه، سند قدیمی تمدید خودکار را مجاز میداند و سند جدید تأیید قرارداد را لازم میداند. امتیاز ارتباط بالا برای هر دو، تعارض را حل نمیکند.
برای انتخاب منبع باید اطلاعات دیگری نیز داشته باشید:
- نسخه و تاریخ اعتبار
- محصول و طرح مربوط
- دامنه کاربرد
- وضعیت سند
- مرجع مسئول انتشار
تاریخ جدیدتر نیز بهتنهایی کافی نیست. یک صفحه جدید ممکن است درباره محصول دیگری باشد.
اگر تعارض قابل حل نیست، سامانه باید آن را مشخص کند و از ساخت حکم قطعی بپرهیزد.
اجرای مسیرها باWorkflow
برای نمونه کوچک، توابع Python کافیاند. در سامانه بزرگتر، میتوان مرحلهها را در یک Workflow تعریف کرد.
مستندات LangGraph میان گردشکارهای دارای مسیر از پیش تعریفشده و عاملهایی با تصمیمگیری پویاتر تفاوت میگذارد و الگوهای مسیریابی و ارزیابی را توضیح میدهد. Docs by LangChain
برای یک مسیر اصلاحی مشخص، لازم نیست تمام تصمیمها را به عامل واگذار کنید. برنامه میتواند سقف جستوجو، ترتیب منابع و شرایط توقف را تعیین کند.
خطای اتصال یا پاسخ نامعتبر ارزیاب نیز باید از وضعیت Incorrect جدا باشد. اولی خطای اجراست؛ دومی نتیجه ارزیابی بازیابی است.
ارزیابی علمیCRAG
برای فهم اثر اصلاح، چند حالت را مقایسه کنید:
| آزمایش | پرسش |
|---|---|
| RAG اولیه | کیفیت خط مبنا چقدر است؟ |
| حذف منابع ضعیف | فیلترکردن چه اثری دارد؟ |
| جستوجوی تکمیلی برای همه پرسشها | هزینه و کیفیت مسیر همیشگی چیست؟ |
| جستوجوی تکمیلی شرطی | تصمیم ارزیاب چه ارزشی ایجاد میکند؟ |
| مسیر اصلاح همراه پالایش | انتخاب بخشها چه اثری دارد؟ |
مجموعه آزمایش باید شامل بازیابی مناسب، بازیابی نامرتبط، منابع ناقص، اسناد متعارض و پرسشهای بدون پاسخ باشد.
این معیارها را ثبت کنید:
- درستی و کاملبودن پاسخ
- صحت استناد
- خطای ارزیاب در انتخاب مسیر
- تعداد جستوجوهای تکمیلی
- زمان پاسخ
- هزینه هر درخواست
- نرخ اعلام کمبود اطلاعات
فقط پاسخهای موفق را بررسی نکنید. ممکن است ارزیاب منابع مناسب را رد کند و مسیر پرهزینهای فعال شود که نتیجه بهتری ندارد.
نکات مهم برای فارسی
نام محصولات، نیمفاصله، حروف عربی و فارسی و ترکیب اصطلاحات انگلیسی میتوانند بر بازیابی اثر بگذارند.
پیش از افزودن مسیر اصلاح پیچیده، پیشپردازش پرسش و اسناد را هماهنگ کنید. برای ارزیاب فارسی نیز نمونههایی بسازید که تفاوتهای کوچک معنایی دارند:
- «قابل تمدید است» و «قابل تمدید نیست»
- «تا پایان دوره» و «پس از پایان دوره»
- «همه طرحها» و «فقط طرح سازمانی»
- «ثبت درخواست» و «تأیید درخواست»
اگر ارزیاب این تفاوتها را نبیند، مسیر اصلاح میتواند همان خطا را با منابع بیشتر ادامه دهد.
اشتباهات رایج
یکیدانستن امتیاز ارتباط و احتمال صحت
امتیاز مدل، بدون کالیبراسیون، احتمال معتبر درستبودن نیست.
انتقال آستانهها میان مدلها
تغییر مدل یا دستور ارزیابی میتواند توزیع امتیازها را تغییر دهد.
جایگزینی خودکار سند سازمانی با وب عمومی
منبع جایگزین باید برای همان نوع پرسش معتبر باشد.
پذیرش نتایج تکمیلی بدون بررسی
مسیر دوم نیز ممکن است منابع نامناسب برگرداند.
پالایش با حذف جملههای کوتاه
یک جمله کوتاه میتواند شرط اصلی پاسخ باشد.
افزایش نامحدود تلاشها
برای اصلاح، سقف زمان، هزینه و تعداد جستوجو تعیین کنید.
پرسشهای متداول
Corrective RAGچیست؟
معماریای برای ارزیابی کیفیت بازیابی و انتخاب اقدام اصلاحی پیش از تولید پاسخ است.
آیا CRAG خطاهای مدل را حذف میکند؟
خیر. بازیاب، ارزیاب و مدل مولد همچنان ممکن است خطا کنند.
آیا CRAG حتماً به جستوجوی وب نیاز دارد؟
روش اصلی از وب استفاده میکند. در طراحی کاربردی میتوان مسیر تکمیلی دیگری انتخاب کرد و تفاوت را مشخص کرد.
تفاوت Correct و صحیحبودن محتوا چیست؟
Correct وضعیت تصمیمگیری درباره بازیابی است؛ صحت همه ادعاهای منبع را تضمین نمیکند.
آیا میتوان ارزیاب را با API ساخت؟
بله، برای نمونهسازی. این کار جایگزین مستقیم مدل آموزشدیده مقاله نیست و باید ارزیابی شود.
آیا نتایج مسیر دوم هم باید بررسی شوند؟
بله. اجرای جستوجوی دیگر، مناسببودن خروجی آن را ثابت نمیکند.
آیا CRAG برای فارسی مناسب است؟
امکان پیادهسازی وجود دارد، اما کیفیت تمام اجزا باید روی داده فارسی سنجیده شود.
جمعبندی
CRAGیک پرسش مهم را وارد خط لوله میکند: اگر بازیابی مناسب نبود، سامانه چه اقدامی انجام دهد؟
استفاده از منابع اولیه، جایگزینی آنها و تکمیل اطلاعات، باید به تصمیمی مشخص و قابل ارزیابی تبدیل شوند.
برای شروع، منطق مسیرها را ساده نگه دارید، ارزیاب را روی نمونههای واقعی بسنجید و هزینه مسیر اصلاح را همراه کیفیت پاسخ گزارش کنید. منابع بیشتر زمانی ارزش دارند که شواهد مناسبتری فراهم کنند.
مقالات مرتبط
- RAGچیست؟
- Self-RAGو ارزیابی پاسخ
- ارزیابی بازیابی و تولید پاسخ درRAG
- جستوجوی ترکیبی با BM25 و بردار
- Contextual Retrievalو بازیابی زمینهمند
- Parent Document Retrieval
- Reranking و Cross-Encoder
منابع
- مقاله اصلیCorrective Retrieval Augmented Generation
- متن کامل مقالهCRAG
- کد رسمی و منابع اجرایCRAG
- Workflows and Agents — مستندات LangGraph
- Comprehensive RAG Benchmark
- مستندات API درواره
ساخت مسیر اصلاح بازیابی با درواره
برای آزمایش این معماری، میتوانید از مدلهای پشتیبانیشده درواره برای ارزیابی ارتباط منابع و تولید پاسخ استفاده کنید. مدل Embedding نیز میتواند مسیر معنایی بازیابی شما را فراهم کند؛ جستوجوی تکمیلی و منطق اصلاح در برنامه خودتان اجرا میشوند.
با پرسشهایی شروع کنید که سامانه فعلی در آنها سند اشتباه یا ناقص پیدا میکند. سپس بسنجید ارزیابی و مسیر جایگزین، کدام خطاها را با چه هزینهای اصلاح میکنند.
برای بررسی مدلها و شروع استفاده از API هوش مصنوعی، به درواره مراجعه کنید.
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.