پردازش هوشمند اسناد چیست؟ استخراج اطلاعات PDF با هوش مصنوعی
پردازش هوشمند اسناد، فایلهای PDF، فرمها و تصاویر را به اطلاعات ساختیافته و قابلاستفاده در نرمافزارها تبدیل میکند. در این راهنما معماری IDP و پیادهسازی آن با پایتون و API درواره را یاد میگیرید.
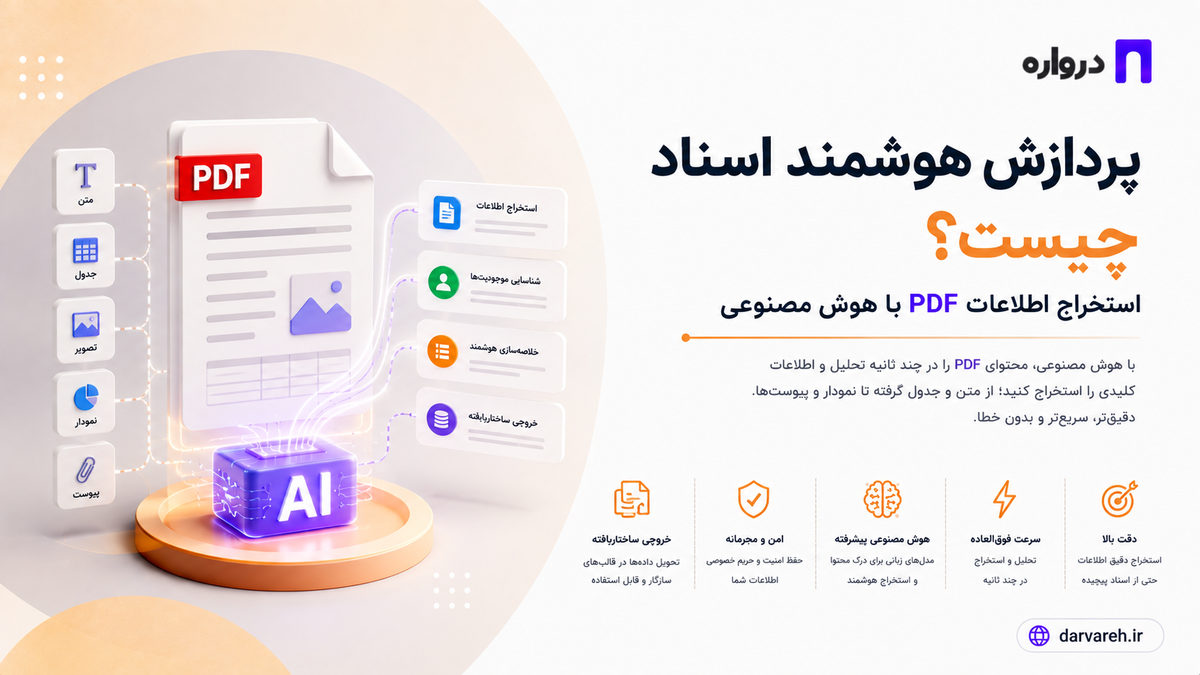
بخش زیادی از اطلاعات کسبوکارها هنوز داخل فایلهای PDF، فرمهای اسکنشده، سفارشها، رسیدها، گزارشها و تصاویر نگهداری میشود. این اسناد برای انسان قابلخواندن هستند، اما نرمافزارهای حسابداری، CRM، ERP و سامانههای اتوماسیون نمیتوانند مستقیماً اطلاعات موردنیاز را از آنها استخراج کنند.
پردازش هوشمند اسناد یا Intelligent Document Processing راهکاری برای تبدیل این فایلها به دادههای ساختیافته است. یک سیستم Document AI میتواند نوع سند را تشخیص دهد، متن و جدولها را بخواند، فیلدهای مهم را استخراج کند و خروجی استانداردی مانند JSON تولید کند.
برای مثال، بهجای اینکه کارشناس اطلاعات یک فرم سفارش را بهصورت دستی وارد نرمافزار کند، سیستم میتواند چنین خروجیای بسازد:
{
  "document_type": "purchase_order",
  "order_number": "PO-1405-218",
  "order_date": "1405/05/18",
  "department": "تدارکات",
  "supplier": "شرکت نمونه",
  "items": [
    {
      "title": "کالای آزمایشی",
      "quantity": 12,
      "unit": "عدد"
    }
  ],
  "total_amount": 48500000,
  "currency": "IRR"
}
این داده را میتوان مستقیماً به پایگاه داده، نرمافزار سازمانی یا یک گردش کار خودکار ارسال کرد.
پردازش هوشمند اسناد یا IDP چیست؟
پردازش هوشمند اسناد مجموعهای از روشهای پردازش تصویر، OCR، یادگیری ماشین و مدلهای چندوجهی است که اطلاعات غیرساختیافته اسناد را به داده قابلاستفاده تبدیل میکند.
طبق تعریف رسمی Google Cloud Document AI، سامانه Document AI داده غیرساختیافته موجود در اسناد را به داده ساختیافته و مناسب برای ذخیره در پایگاه داده تبدیل میکند. این فرایند میتواند شامل OCR، تشخیص چیدمان، استخراج موجودیتها، شناسایی کلید و مقدار، طبقهبندی و جداسازی اسناد باشد.
Azure Document Intelligence نیز پردازش سند را ترکیبی از OCR و فناوریهای درک سند برای استخراج متن، جدول، ساختار و زوجهای کلید-مقدار معرفی میکند.
بنابراین، پردازش هوشمند اسناد فقط «خواندن متن» نیست. هدف نهایی آن فهمیدن نقش اطلاعات و تبدیل سند به خروجی قابلپردازش است.
تفاوت OCR با پردازش هوشمند اسناد
OCR متن موجود در تصویر یا فایل اسکنشده را تشخیص میدهد. برای مثال، ممکن است عبارتهای زیر را از یک فرم استخراج کند:
شماره سفارش: ۲۱۸
تاریخ: ۱۴۰۵/۰۵/۱۸
واحد درخواستکننده: فروش
اما یک سامانه پردازش هوشمند اسناد تشخیص میدهد که:
- مقدار
۲۱۸شماره سفارش است. - مقدار
۱۴۰۵/۰۵/۱۸تاریخ سند است. - کلمه
فروشنام واحد درخواستکننده است. - سند در گروه «فرم سفارش» قرار میگیرد.
مقایسه این دو روش:
| قابلیت | OCR | پردازش هوشمند اسناد |
|---|---|---|
| تشخیص متن | دارد | دارد |
| تشخیص ساختار صفحه | محدود | دارد |
| استخراج جدول | محدود | دارد |
| تشخیص نوع سند | ندارد | دارد |
| استخراج فیلدهای مشخص | ندارد | دارد |
| تولید JSON | به پردازش تکمیلی نیاز دارد | دارد |
| اتصال به فرایند کسبوکار | مستقیم نیست | هدف اصلی سیستم است |
برای آشنایی عمیقتر با مرحله تشخیص متن، راهنمای تبدیل عکس به متن با هوش مصنوعی و OCR فارسی را بخوانید.
تفاوت Document AI با چتکردن با PDF
در سامانه چت با PDF، کاربر درباره محتوای یک سند سؤال میپرسد و پاسخ متنی دریافت میکند. هدف معمولاً جستوجو، خلاصهسازی یا درک محتوای سند است.
در پردازش هوشمند اسناد، هدف استخراج اطلاعات مشخص و ارسال آن به بخش دیگری از نرمافزار است.
برای مثال:
- چت با PDF: «تاریخ تحویل این سفارش چه زمانی است؟»
- Document AI: استخراج خودکار
delivery_dateو ثبت آن در ERP - چت با PDF: «موضوع اصلی گزارش چیست؟»
- Document AI: تشخیص نوع گزارش، استخراج نام پروژه و ثبت وضعیت آن
- چت با PDF: «این سند را خلاصه کن.»
- Document AI: تبدیل سند به JSON مطابق یک Schema مشخص
اگر هدف شما پرسش و پاسخ روی تعداد زیادی سند است، معماری RAG یا تولید تقویتشده با بازیابی انتخاب مناسبتری خواهد بود.
سیستم پردازش هوشمند اسناد چگونه کار میکند؟
یک خط پردازش استاندارد معمولاً چند مرحله دارد.
۱. دریافت سند
سند میتواند از مسیرهای مختلف وارد سامانه شود:
- پنل کاربری
- فرم وبسایت
- نرمافزار سازمانی
- پوشه اشتراکی
- API
- سامانه اتوماسیون
در این مرحله، فرمت فایل و تعداد صفحات نیز ثبت میشود.
۲. تشخیص نوع فایل
سیستم مشخص میکند که فایل از چه نوعی است:
- PDF متنی
- PDF اسکنشده
- تصویر
- فایل Word
- صفحه ترکیبی شامل متن و تصویر
PDF متنی معمولاً بدون OCR قابلاستخراج است. برای PDF اسکنشده ابتدا باید صفحه به تصویر تبدیل و متن آن خوانده شود.
۳. اصلاح چیدمان صفحه
در فایلهای اسکنشده ممکن است صفحه چرخیده، کج یا کمکیفیت باشد. پیشپردازش میتواند شامل اصلاح زاویه، بهبود خوانایی و حذف حاشیههای اضافی باشد.
۴. استخراج متن و ساختار
در این مرحله اجزای سند شناسایی میشوند:
- عنوانها
- پاراگرافها
- جدولها
- فهرستها
- فیلدهای فرم
- کلیدها و مقادیر
- شماره صفحه
- ترتیب خواندن محتوا
ابزار متنباز Docling میتواند فرمتهایی مانند PDF، DOCX، PPTX، XLSX، HTML و تصویر را پردازش کند و اطلاعات مربوط به چیدمان، ترتیب خواندن و ساختار جدول را نگه دارد.
برای PDFهای متنی ساده نیز میتوان از PyMuPDF استفاده کرد.
۵. طبقهبندی سند
سیستم تعیین میکند فایل به کدام دسته تعلق دارد. برای مثال:
- فرم سفارش
- پیشفاکتور
- گزارش پروژه
- درخواست خدمات
- رسید تحویل
- نامه اداری
- فرم ثبت محصول
طبقهبندی اهمیت زیادی دارد؛ زیرا فیلدهای مورد انتظار هر سند متفاوتاند. شماره سفارش در فرم سفارش مهم است، درحالیکه گزارش پروژه ممکن است شامل نام پروژه، وضعیت و اقدامات بعدی باشد.
۶. استخراج فیلدها و جدولها
پس از تعیین نوع سند، مدل اطلاعات موردنیاز را طبق یک ساختار مشخص استخراج میکند.
برای فرم سفارش میتوان فیلدهای زیر را تعریف کرد:
document_type
order_number
order_date
requester
department
supplier
items
total_amount
currency
delivery_date
هرچه تعریف فیلدها دقیقتر باشد، کنترل خروجی آسانتر خواهد بود.
۷. استانداردسازی دادهها
خروجی اولیه ممکن است شکلهای متفاوتی داشته باشد:
- ارقام فارسی و انگلیسی
- تاریخ شمسی با جداکنندههای مختلف
- مبلغ به ریال یا تومان
- فاصلههای اضافه
- نامهای نوشتهشده با «ی» و «ک» متفاوت
- تعداد همراه با واحد
مرحله استانداردسازی، این مقادیر را به قالب واحد تبدیل میکند.
۸. اعتبارسنجی خروجی
خروجی مدل نباید بدون بررسی وارد نرمافزار مقصد شود. اعتبارسنجی میتواند شامل موارد زیر باشد:
- الزامیبودن فیلدهای اصلی
- معتبر بودن نوع سند
- عددی بودن مبلغ و تعداد
- تطبیق قالب تاریخ
- خالی نبودن شماره سند
- کنترل جمع سطرها
- مشخصکردن فیلدهای نامطمئن
۹. ارسال به سامانه مقصد
پس از تأیید، داده میتواند به مقصد مناسب فرستاده شود:
- CRM
- ERP
- نرمافزار حسابداری
- سامانه مدیریت سفارش
- پایگاه داده
- پنل مدیریت
- گردش کار اتوماسیون
چه اسنادی را میتوان با هوش مصنوعی پردازش کرد؟
Document AI به یک نوع فایل محدود نیست. نمونههای رایج عبارتاند از:
فرمهای سفارش و خرید
سیستم میتواند شماره سفارش، اقلام، تعداد، واحد، نام تأمینکننده و تاریخ تحویل را استخراج کند.
گزارشهای پروژه
نام پروژه، وضعیت، درصد پیشرفت، موانع و اقدامهای بعدی میتوانند به فیلدهای قابلجستوجو تبدیل شوند.
فرمهای درخواست خدمات
نوع درخواست، واحد درخواستکننده، اولویت، زمان مورد انتظار و شرح مسئله از فرم استخراج میشود.
کاتالوگ و لیست محصولات
نام محصول، کد، ویژگیها، قیمت و مشخصات فنی را میتوان به داده مناسب فروشگاه یا نرمافزار مدیریت محصول تبدیل کرد.
نامهها و مکاتبات اداری
شماره، تاریخ، موضوع، فرستنده، گیرنده و اقدام مورد انتظار قابلاستخراجاند.
فرمهای کنترل کیفیت
نام محصول، شماره سری ساخت، نتیجه بررسی و موارد ثبتشده میتوانند وارد سامانه گزارشگیری شوند.
چه زمانی از ابزار سنتی و چه زمانی از مدل چندوجهی استفاده کنیم؟
برای تمام اسناد نباید از یک روش ثابت استفاده کرد.
| وضعیت سند | روش مناسب |
|---|---|
| PDF متنی با قالب ثابت | استخراج متن و قواعد برنامهنویسی |
| فرم ثابت با فیلدهای مشخص | OCR و پردازش قالب |
| سند با جدول منظم | ابزار استخراج جدول |
| قالبهای متنوع | مدل چندوجهی |
| متن طولانی و غیرساختیافته | مدل زبانی |
| سند ترکیبی شامل متن، جدول و تصویر | روش ترکیبی |
| پردازش انبوه یک قالب ثابت | خط پردازش اختصاصی و بهینه |
| فایلهای متنوع با تعداد کم | مدل چندوجهی با پرامپت دقیق |
در عمل، معماری ترکیبی معمولاً نتیجه بهتری دارد. ابتدا با ابزار محلی متن و ساختار استخراج میشود و تنها بخشهایی که نیازمند درک معنایی هستند به مدل هوش مصنوعی ارسال میشوند.
آموزش استخراج اطلاعات PDF با Python و API درواره
در این نمونه، ابتدا محتوای PDF با Docling به Markdown تبدیل میشود. سپس مدل هوش مصنوعی نوع سند و فیلدهای موردنظر را استخراج میکند.
نصب کتابخانهها
pip install docling openai
تنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL_ID="YOUR_MODEL_ID"
شناسه یک مدل فعال و مناسب را از فهرست فعلی مدلهای درواره انتخاب کنید. برای سندهای تصویری، مدل باید از ورودی تصویر پشتیبانی کند.
کد کامل استخراج اطلاعات
import json
import os
from docling.document_converter import DocumentConverter
from openai import OpenAI
PDF_PATH = "purchase-order.pdf"
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
model_id = os.environ["DARVAREH_MODEL_ID"]
def pdf_to_markdown(path: str) -> str:
converter = DocumentConverter()
result = converter.convert(path)
return result.document.export_to_markdown()
def clean_json_response(content: str) -> str:
content = content.strip()
if content.startswith("```json"):
content = content[7:]
if content.startswith("```"):
content = content[3:]
if content.endswith("```"):
content = content[:-3]
return content.strip()
def validate_document(data: dict) -> None:
allowed_types = {
"purchase_order",
"service_request",
"project_report",
"administrative_letter",
"unknown",
}
if data.get("document_type") not in allowed_types:
raise ValueError("نوع سند معتبر نیست")
required_keys = {
"document_type",
"document_number",
"document_date",
"summary",
"fields",
"missing_fields",
}
missing_keys = required_keys - data.keys()
if missing_keys:
raise ValueError(
f"کلیدهای الزامی وجود ندارند: {sorted(missing_keys)}"
)
document_text = pdf_to_markdown(PDF_PATH)
prompt = f"""
سند زیر را تحلیل و اطلاعات آن را استخراج کن.
قواعد:
1. فقط یک شیء JSON معتبر برگردان.
2. هیچ توضیحی بیرون از JSON ننویس.
3. اطلاعاتی را که در سند وجود ندارد حدس نزن.
4. مقدار ناموجود را null قرار بده.
5. ارقام فارسی را در فیلدهای عددی به عدد استاندارد تبدیل کن.
6. واحد مبلغ را در فیلدی جداگانه ثبت کن.
7. اگر نوع سند مشخص نیست، document_type را unknown قرار بده.
8. جدول اقلام را بهصورت آرایه استخراج کن.
ساختار خروجی:
{{
"document_type": "purchase_order | service_request | project_report | administrative_letter | unknown",
"document_number": "string | null",
"document_date": "string | null",
"summary": "string",
"fields": {{
"requester": "string | null",
"department": "string | null",
"supplier": "string | null",
"delivery_date": "string | null",
"total_amount": "number | null",
"currency": "IRR | IRT | null",
"items": [
{{
"title": "string",
"quantity": "number | null",
"unit": "string | null",
"unit_price": "number | null"
}}
]
}},
"missing_fields": ["string"]
}}
محتوای سند:
{document_text[:50000]}
"""
response = client.chat.completions.create(
model=model_id,
messages=[
{
"role": "system",
"content": (
"شما یک موتور استخراج داده از اسناد فارسی هستید. "
"خروجی باید دقیقاً مطابق ساختار درخواستشده باشد."
),
},
{
"role": "user",
"content": prompt,
},
],
temperature=0,
)
raw_content = response.choices[0].message.content
json_content = clean_json_response(raw_content)
document_data = json.loads(json_content)
validate_document(document_data)
print(
json.dumps(
document_data,
ensure_ascii=False,
indent=2,
)
)
API درواره با ساختار OpenAI سازگار است؛ بنابراین میتوانید از SDK رایج OpenAI استفاده کنید و فقط base_url، کلید و شناسه مدل را تغییر دهید. جزئیات بیشتر در مستندات API درواره در دسترس است.
چرا خروجی JSON اهمیت دارد؟
اگر مدل یک پاسخ توضیحی تولید کند، استفاده از آن در نرمافزار دشوار خواهد بود. JSON باعث میشود برنامه بتواند فیلدها را بررسی و در مقصد مناسب ذخیره کند.
برای مثال:
if document_data["document_type"] == "purchase_order":
    send_to_order_system(document_data)

elif document_data["document_type"] == "service_request":
    create_service_ticket(document_data)

else:
    add_to_review_queue(document_data)
در مدلهایی که از Structured Outputs پشتیبانی میکنند، میتوان Schema را در خود درخواست API تعریف کرد. برای جزئیات بیشتر، مقاله Structured Outputs چیست؟ را مطالعه کنید.
قابلیت Structured Outputs باید برای مدل انتخابی بررسی شود؛ زیرا تمام مدلها الزاماً تنظیمات یکسانی ندارند.
پردازش PDFهای اسکنشده چگونه انجام میشود؟
اگر متن PDF قابلانتخاب نیست، فایل احتمالاً اسکنشده است. در این حالت سه مسیر وجود دارد.
مسیر اول: OCR محلی
صفحات PDF به تصویر تبدیل میشوند و یک موتور OCR متن را استخراج میکند. سپس متن به مدل زبانی ارسال میشود.
این روش برای سندهای ساده و پرتعداد میتواند مقرونبهصرفه باشد.
مسیر دوم: مدل چندوجهی
تصویر صفحه مستقیماً به مدلی ارسال میشود که ورودی تصویر را پشتیبانی میکند. مدل علاوه بر متن، چیدمان صفحه و رابطه میان فیلدها را نیز بررسی میکند.
راهنمای ارسال تصویر با URL و Base64 در مقاله آموزش API تحلیل تصویر درواره ارائه شده است.
مسیر سوم: روش ترکیبی
ابتدا OCR انجام میشود. سپس تصویر، متن OCR و Schema مورد انتظار برای مدل فرستاده میشوند. این روش برای جدولها و فرمهای پیچیده مفید است.
نکات مهم برای پردازش اسناد فارسی
اسناد فارسی ویژگیهایی دارند که باید در مجموعه آزمایشی پروژه دیده شوند.
اعداد فارسی و انگلیسی
ممکن است در یک سند همزمان از ۱۲۵۰۰ و 12500 استفاده شده باشد. قبل از ذخیره، ارقام را استاندارد کنید.
ریال و تومان
فقط استخراج عدد کافی نیست. واحد مبلغ باید در فیلدی جداگانه ثبت شود تا اختلاف ریال و تومان باعث ثبت مقدار اشتباه نشود.
تاریخ شمسی
مدل نباید تاریخ شمسی را بدون درخواست به میلادی تبدیل کند. تاریخ اولیه و تاریخ استانداردشده را میتوان در دو فیلد مجزا نگه داشت.
حروف عربی و فارسی
حروف «ي» و «ك» ممکن است بهجای «ی» و «ک» وارد شده باشند. این تفاوت هنگام جستوجو و تطبیق نامها مشکل ایجاد میکند.
راستبهچپ بودن جدولها
در بعضی PDFها ترتیب ستونهای فارسی هنگام استخراج تغییر میکند. نام و محتوای ستونها باید روی نمونههای واقعی بررسی شوند.
مهر، امضا و دستنویس
این عناصر ممکن است روی متن قرار بگیرند یا بخشی از فیلدها را بپوشانند. چنین صفحات یا فیلدهایی بهتر است برای بازبینی علامتگذاری شوند.
چگونه کیفیت استخراج اطلاعات را ارزیابی کنیم؟
ارزیابی باید در سطح هر فیلد انجام شود، نه فقط در سطح کل سند.
شاخصهای مفید عبارتاند از:
- درصد تشخیص صحیح نوع سند
- دقت استخراج شماره سند
- دقت تاریخها
- دقت مبلغ و واحد پول
- کیفیت استخراج سطرهای جدول
- تعداد فیلدهای خالی اشتباه
- تعداد مقادیر حدسزدهشده
- نرخ اسنادی که به بازبینی نیاز دارند
- زمان متوسط پردازش هر سند
- هزینه متوسط پردازش هر صفحه
برای آزمایش، مجموعهای شامل قالبها، کیفیتها و حالتهای واقعی کسبوکار تهیه کنید. استفاده از چند فایل تمیز برای تصمیمگیری درباره عملکرد سیستم کافی نیست.
مستندات Google نیز برای پردازشگرهای Document AI بر آموزش و ارزیابی با دادههای واقعی و نماینده تأکید میکند. راهنمای آموزش و ارزیابی Document AI توضیح میدهد که کیفیت و تنوع داده آزمایشی بر ارزیابی پردازشگر اثر مستقیم دارد.
خطاهای رایج در ساخت سیستم Document AI
ارسال کل سند بدون تعیین هدف
درخواست «این PDF را تحلیل کن» بیش از حد کلی است. فیلدها، نوع خروجی و قواعد مربوط به اطلاعات ناموجود را دقیقاً مشخص کنید.
استفاده از یک پرامپت برای تمام اسناد
ساختار فرم سفارش با گزارش پروژه یکسان نیست. بهتر است ابتدا نوع سند تشخیص داده شود و سپس پرامپت و Schema متناسب با همان نوع انتخاب شود.
اعتماد به خروجی بدون اعتبارسنجی
خروجی باید از نظر نوع داده، فیلدهای الزامی، قالب تاریخ و واحد مبلغ بررسی شود.
تبدیل تمام صفحات به تصویر
اگر PDF دارای متن قابلاستخراج است، تبدیل تمام صفحات به تصویر معمولاً پردازش اضافه ایجاد میکند. ابتدا نوع فایل را تشخیص دهید.
نادیدهگرفتن صفحات چندسندی
یک PDF ممکن است شامل چند فرم یا چند نامه مستقل باشد. سیستم باید بتواند مرز اسناد را تشخیص دهد یا فایل را صفحهبهصفحه بررسی کند.
ارزیابی فقط روی یک قالب
فرمهای واقعی ممکن است فونت، جای فیلدها، تعداد سطرها و کیفیت متفاوتی داشته باشند. مجموعه آزمایشی باید این تنوع را پوشش دهد.
پردازش دوباره فایلهای تکراری
پیش از ارسال سند به مدل، میتوان برای فایل یک شناسه یا Hash ساخت و نتیجه قبلی را بررسی کرد. این کار از پردازش تکراری جلوگیری میکند.
معماری پیشنهادی برای محصول واقعی
یک معماری قابلتوسعه میتواند شامل بخشهای زیر باشد:
- دریافت و ثبت سند
- تشخیص PDF متنی یا اسکنشده
- استخراج متن، جدول و چیدمان
- تشخیص نوع سند
- انتخاب Schema مناسب
- استخراج اطلاعات با مدل هوش مصنوعی
- استانداردسازی اعداد، تاریخ و واحدها
- اعتبارسنجی فیلدها
- ارسال موارد نامطمئن به صف بازبینی
- ثبت خروجی در نرمافزار مقصد
- ذخیره نتیجه ارزیابی برای بهبود سیستم
در این معماری، درواره نقش لایه یکپارچه دسترسی به مدلهای هوش مصنوعی را دارد. دریافت فایل، مدیریت گردش کار، اعتبارسنجی و اتصال به نرمافزارهای سازمانی در برنامه شما پیادهسازی میشوند.
از چه ابزارهایی میتوان در ایران استفاده کرد؟
برای ساخت یک خط پردازش قابلاجرا میتوانید از این ترکیب استفاده کنید:
- Docling: استخراج ساختار PDF، Word، تصویر و جدول
- PyMuPDF: استخراج سریع متن و تصاویر PDF
- Tesseract OCR: تشخیص متن فایلهای اسکنشده
- Python: اعتبارسنجی، تبدیل و اتصال اجزای سیستم
- API درواره: دسترسی یکپارچه به مدلهای متنی و چندوجهی با پرداخت ریالی
- PostgreSQL یا MySQL: ذخیره خروجی ساختیافته
- n8n: اتصال نتیجه پردازش به گردش کارهای سازمانی
Docling، PyMuPDF، Tesseract، Python و n8n را میتوان روی زیرساخت خود اجرا کرد. برای بخش درک معنایی و استخراج فیلدهای پیچیده نیز میتوان از مدلهای موجود در API درواره استفاده کرد.
پردازش هوشمند اسناد چگونه به محصول تبدیل میشود؟
Document AI فقط یک قابلیت داخلی نیست و میتواند بخشی از محصول قابلفروش شما باشد.
قابلیت جدید برای نرمافزارهای سازمانی
توسعهدهندگان ERP، CRM و نرمافزارهای اتوماسیون میتوانند امکان ورود اطلاعات از طریق PDF یا تصویر را به محصول خود اضافه کنند.
افزونه ورود خودکار اطلاعات
کاربر فایل را بارگذاری میکند و فیلدهای فرم بهصورت خودکار تکمیل میشوند. کاربر فقط موارد استخراجشده را بررسی میکند.
API اختصاصی پردازش سند
میتوانید یک API بسازید که فایل دریافت کند و خروجی JSON استاندارد برگرداند. مشتریان این API را در سامانههای خود به کار میگیرند.
گردش کار خودکار
پس از تشخیص نوع سند، سیستم میتواند مرحله مناسب را فعال کند؛ برای مثال، فرم سفارش را به سامانه خرید و گزارش پروژه را به داشبورد مدیریت بفرستد.
چرا API درواره برای ساخت Document AI مناسب است؟
برای ساخت یک سامانه پردازش اسناد ممکن است در مرحلهای به مدل متنی، در مرحلهای به مدل Vision و در مرحلهای دیگر به مدلی سریعتر و اقتصادیتر نیاز داشته باشید.
API درواره این امکان را فراهم میکند که با یک ساختار سازگار با OpenAI به مدلهای مختلف متصل شوید. مزایای این رویکرد برای تیمهای ایرانی عبارتاند از:
- دسترسی به مدلهای مختلف از طریق یک API
- پرداخت ریالی
- استفاده از SDKهای رایج OpenAI
- تغییر مدل با اصلاح شناسه مدل
- مناسب برای Python، Node.js، PHP و سایر محیطهای Backend
- امکان ارزیابی چند مدل روی اسناد فارسی
- مدیریت سادهتر اعتبار و فراخوانیها
بهتر است پیش از انتخاب نهایی، چند مدل را روی مجموعه واقعی اسناد خود آزمایش و کیفیت، زمان پاسخ و هزینه آنها را مقایسه کنید.
برای شروع، در درواره حساب بسازید، یک کلید API دریافت کنید و مدل مناسب پردازش متن یا تصویر را از فهرست فعلی مدلها انتخاب کنید.
نقشه راه پیشنهادی پیادهسازی
مرحله اول: انتخاب یک نوع سند
با یک مسئله محدود شروع کنید؛ برای مثال، استخراج اطلاعات فرم سفارش. پردازش تمام اسناد سازمان در نسخه اول دامنه پروژه را بیش از حد بزرگ میکند.
مرحله دوم: تعریف Schema
فهرست دقیق فیلدها، نوع داده و قواعد مربوط به مقدار ناموجود را مشخص کنید.
مرحله سوم: جمعآوری نمونههای متنوع
نمونههای متنی، اسکنشده، چندصفحهای و دارای جدول را در مجموعه آزمایشی قرار دهید.
مرحله چهارم: ساخت نسخه اولیه
یک جریان ساده شامل استخراج محتوا، فراخوانی مدل، تولید JSON و اعتبارسنجی بسازید.
مرحله پنجم: مقایسه مدلها
کیفیت چند مدل را روی یک مجموعه یکسان بررسی کنید. بهترین مدل لزوماً بزرگترین مدل نیست.
مرحله ششم: اضافهکردن بازبینی
فیلدهای ناموجود یا نامطمئن باید در رابط بازبینی نمایش داده شوند.
مرحله هفتم: اتصال به نرمافزار مقصد
پس از رسیدن به کیفیت قابلقبول، خروجی را به CRM، ERP یا پایگاه داده متصل کنید.
پرسشهای متداول
پردازش هوشمند اسناد چیست؟
پردازش هوشمند اسناد یا IDP فرایند تبدیل PDF، فرم، تصویر و سایر اسناد به دادههای ساختیافته است. این فرایند میتواند شامل OCR، تشخیص نوع سند، استخراج فیلد، خواندن جدول و تولید JSON باشد.
تفاوت Document AI و OCR چیست؟
OCR متن را از تصویر استخراج میکند، اما Document AI ساختار و نقش اطلاعات را نیز تشخیص میدهد. OCR معمولاً یکی از اجزای سامانه پردازش هوشمند اسناد است.
آیا میتوان اطلاعات PDF فارسی را با هوش مصنوعی استخراج کرد؟
بله، اما کیفیت نتیجه باید روی اعداد فارسی، تاریخ شمسی، جدولهای راستبهچپ، ریال و تومان و قالبهای واقعی اسناد آزمایش شود.
آیا برای PDF متنی به مدل Vision نیاز داریم؟
الزاماً خیر. میتوان ابتدا متن PDF را با ابزارهایی مانند Docling یا PyMuPDF استخراج کرد و فقط متن را برای مدل فرستاد. مدل Vision بیشتر برای اسکن، تصویر و چیدمان پیچیده کاربرد دارد.
بهترین خروجی برای پردازش خودکار اسناد چیست؟
JSON با Schema مشخص معمولاً مناسبترین خروجی است؛ زیرا میتوان آن را اعتبارسنجی و مستقیماً در API، پایگاه داده یا نرمافزار سازمانی استفاده کرد.
آیا میتوان جدولهای PDF را استخراج کرد؟
بله. ابزارهای Document AI و کتابخانههایی مانند Docling میتوانند ساختار جدول را تشخیص دهند. برای جدولهای پیچیده یا اسکنشده، ترکیب استخراج ساختار و مدل چندوجهی مناسبتر است.
چگونه از حدسزدن اطلاعات توسط مدل جلوگیری کنیم؟
در پرامپت مشخص کنید که مدل نباید مقدار ناموجود را حدس بزند و باید آن را null قرار دهد. سپس تمام فیلدها را در برنامه اعتبارسنجی کنید.
آیا API درواره فایل PDF را بهتنهایی مدیریت میکند؟
درواره لایه دسترسی به مدلهای هوش مصنوعی را فراهم میکند. تبدیل PDF، مدیریت فایل، اعتبارسنجی و اتصال خروجی به سامانه مقصد باید در معماری برنامه شما پیادهسازی شود.
برای شروع چه نوع سندی مناسبتر است؟
سندی را انتخاب کنید که تعداد زیادی نمونه، فیلدهای مشخص و ارزش عملی قابلاندازهگیری داشته باشد؛ مانند فرم سفارش، درخواست خدمات یا گزارش استاندارد پروژه.
جمعبندی
پردازش هوشمند اسناد پلی میان فایلهای غیرساختیافته و نرمافزارهای کسبوکار است. این فناوری میتواند متن، جدول و فیلدهای موجود در PDF و تصویر را استخراج کند، نوع سند را تشخیص دهد و خروجی استاندارد JSON بسازد.
برای ساخت یک سامانه قابلاعتماد:
- با یک نوع سند مشخص شروع کنید.
- OCR را با Document AI اشتباه نگیرید.
- برای هر نوع سند Schema جداگانه تعریف کنید.
- از ابزارهای محلی برای استخراج اولیه استفاده کنید.
- مدل هوش مصنوعی را برای درک معنایی به کار بگیرید.
- خروجی مدل را پیش از ثبت اعتبارسنجی کنید.
- عملکرد را روی اسناد واقعی فارسی بسنجید.
- چند مدل را از نظر کیفیت، سرعت و هزینه مقایسه کنید.
با API سازگار با OpenAI درواره میتوانید مدلهای مختلف متنی و چندوجهی را بدون پیادهسازی چند اتصال جداگانه آزمایش کنید و قابلیت استخراج اطلاعات از اسناد را به نرمافزار یا محصول SaaS خود اضافه کنید.
مقالات مرتبط
- تبدیل عکس به متن با هوش مصنوعی و OCR فارسی
- آموزش API تحلیل تصویر با مدلهای Vision درواره
- هوش مصنوعی چندوجهی چیست؟
- Structured Outputs چیست؟
- RAG چیست و چگونه کار میکند؟
- اتوماسیون هوش مصنوعی چیست؟
منابع
- Google Cloud Document AI Overview
- Microsoft Azure Document Intelligence Overview
- Docling Documentation
- Docling DocumentConverter Reference
- PyMuPDF Documentation
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.