
Tokenizer چیست؟ آموزش توکنسازی متن فارسی، BPE و شمارش توکن با Python
Tokenizer چیست و چرا تعداد توکنهای متن فارسی با تعداد کلمهها برابر نیست؟ در این آموزش، روشهای BPE، WordPiece و Unigram، اثر نیمفاصله و نویسههای فارسی، شمارش توکن با Python و نقش توکنسازی در محدودیت ورودی و هزینه APIرا بررسی میکنیم.

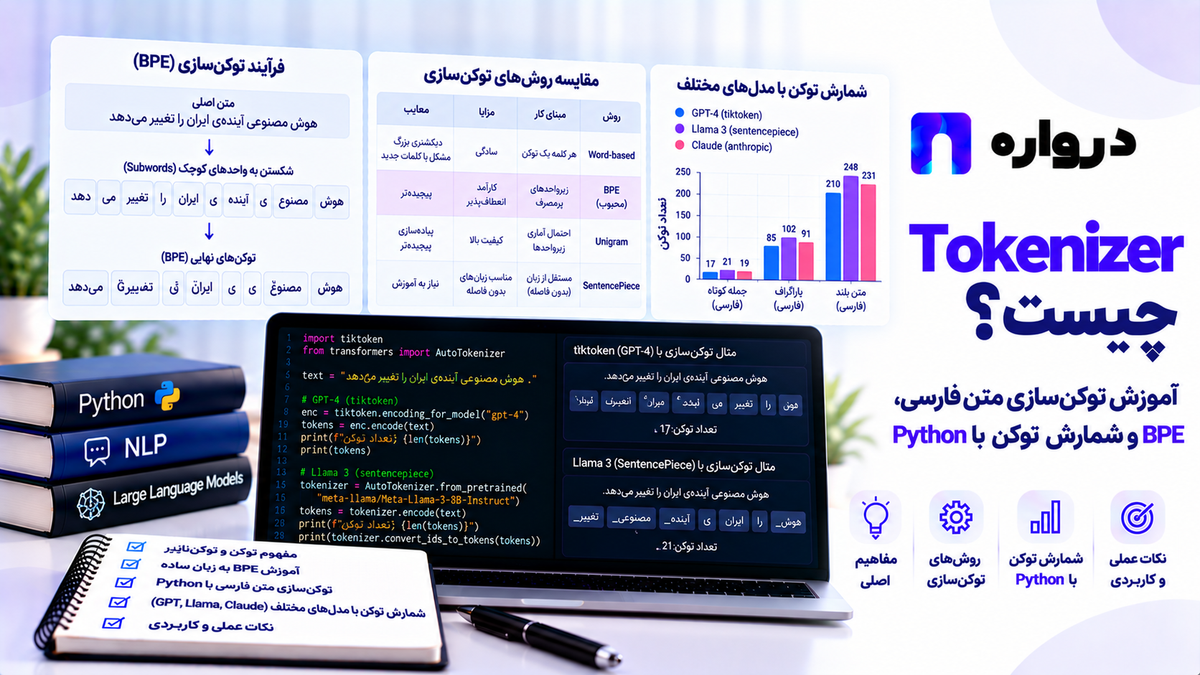
Tokenizer یا توکنساز ابزاری است که متن را به واحدهایی به نام توکن تبدیل میکند. مدل زبانی بهجای دریافت مستقیم حروف و کلمهها، شناسههای عددی این توکنها را پردازش میکند.
به همین دلیل، پرسش «این متن چند کلمه دارد؟» با پرسش «این متن برای مدل چند توکن است؟» یکسان نیست. یک واژه ممکن است یک توکن باشد، به چند توکن تقسیم شود یا همراه بخشی از فاصله و نشانهگذاری در یک توکن قرار بگیرد.
این تفاوت در کار عملی اهمیت دارد. تعداد توکنها میتواند بر موارد زیر اثر بگذارد:
- امکان جاگرفتن متن در ظرفیت ورودی مدل
- تعداد بخشهای لازم برای پردازش یک سند
- هزینه درخواستAPI
- زمان پردازش
- طول پاسخ قابل تولید
- مقایسه منصفانه مدلها و Tokenizerهای مختلف
در متن فارسی، نیمفاصله، شکلهای متفاوت «ی» و «ک»، ترکیب فارسی و انگلیسی و نشانهگذاری نیز ممکن است بر نتیجه توکنسازی اثر بگذارند.
در این مقاله، سازوکار Tokenizer را از پایه توضیح میدهیم، روشهای رایج را مقایسه میکنیم و با Python توکنهای یک متن فارسی را مشاهده خواهیم کرد.
Tokenizerچیست؟
Tokenizerبخشی از مسیر تبدیل متن به ورودی قابل پردازش برای مدل است.
برای نمونه، جمله زیر را در نظر بگیرید:
«هوش مصنوعی به توسعهدهندگان کمک میکند.»
Tokenizerممکن است آن را به چند واحد کوچکتر تقسیم کند. سپس هر واحد با یک شناسه عددی در واژگان مدل متناظر میشود.
مسیر کلی چنین است:
متن → توکنها → شناسههای عددی → ورودی مدلهنگام تولید پاسخ، مسیر برعکس طی میشود: شناسههای تولیدشده به توکن و سپس به متن قابل خواندن تبدیل میشوند.
نکته مهم: شکل دقیق توکنها به Tokenizer همان مدل وابسته است. نمیتوان بدون اجرای Tokenizer واقعی، با اطمینان گفت جمله بالا به چند توکن تبدیل میشود.
مستندات Hugging Face، Tokenizer را ابزار تبدیل متن به توکن و شناسههای عددی و آمادهسازی ورودی مدل معرفی میکند. Hugging Face
توکن چیست؟
توکن واحدی است که Tokenizer به مدل معرفی میکند. این واحد الزاماً یک کلمه کامل نیست.
بسته به روش توکنسازی، یک توکن میتواند نماینده یکی از موارد زیر باشد:
- یک کلمه
- بخشی از یک کلمه
- یک نویسه
- بخشی از دنباله بایتی
- یک علامت نگارشی
- فاصله همراه با بخشی از متن
- یک نشانه ویژه مانند آغاز یا پایان پیام
برای مثال، واژه «بازنویسی» ممکن است در یک Tokenizer یک توکن و در Tokenizer دیگر چند زیرواژه باشد.
بنابراین جمله «هر توکن تقریباً یک کلمه است» قاعده قابل اعتمادی برای شمارش متن فارسی نیست.
تفاوت توکن، کلمه، کاراکتر و بایت
| واحد | تعریف ساده | نمونه کاربرد |
|---|---|---|
| کلمه | واحد زبانی تقریبی در متن | شمارش واژههای مقاله |
| کاراکتر | واحد متنی مانند حرف یا نشانه | محدودیت طول یک فیلد |
| بایت | واحد نمایش داده در رایانه | اندازه فایل و انتقال داده |
| توکن | واحد تعریفشده توسط Tokenizer | ورودی و خروجی مدل زبانی |
این واحدها جایگزین یکدیگر نیستند. حتی شمارش «کاراکتر» نیز در متن یونیکد میتواند به روش شمارش وابسته باشد؛ برای نمونه، بعضی نشانهها بهصورت دنبالهای از چند جزء نمایش داده میشوند.
برای تصمیم درباره محدودیت ورودی یک مدل، خروجی Tokenizer همان مدل مبنای مناسبتری از شمارش کلمه یا کاراکتر است.
چرا مدلهای زبانی به Tokenizer نیاز دارند؟
مدل زبانی با داده عددی کار میکند. Tokenizer پلی میان متن انسان و شناسههایی است که مدل میتواند پردازش کند.
این پل دو کار اصلی انجام میدهد:
- متن را بر اساس قواعد و واژگان مشخص به توکن تبدیل میکند.
- هر توکن را به شناسه عددی متناظر نگاشت میکند.
در مرحله تولید، شناسههای خروجی دوباره به متن تبدیل میشوند.
کیفیت و طراحی این بخش میتواند بر طول دنباله، پوشش زبانها و شیوه نمایش واژههای ناآشنا اثر بگذارد. البته عملکرد نهایی مدل فقط به Tokenizer وابسته نیست؛ داده آموزشی، معماری و روش آموزش نیز اهمیت دارند.
واژگان یا Vocabulary چیست؟
هر Tokenizer مجموعهای از توکنهای شناختهشده دارد که به آن Vocabulary یا واژگان میگویند. هر عضو این مجموعه شناسه مشخصی دارد.
برای مشاهده مفهوم، فرض کنید یک واژگان ساختگی چنین اعضایی دارد:
| توکن ساختگی | شناسه ساختگی |
|---|---|
هوش | ۱۰۱ |
مصنوعی | ۱۰۲ |
می | ۱۰۳ |
کند | ۱۰۴ |
این اعداد فقط برای توضیح هستند و به مدل واقعی تعلق ندارند.
شناسه یک توکن معنای جهانی ندارد. عدد یکسان در دو مدل مختلف میتواند به توکنهای متفاوتی اشاره کند. حتی دو مدل از یک خانواده نیز ممکن است Tokenizer متفاوتی داشته باشند.
اگر کلمهای در واژگان نباشد چه میشود؟
روش پاسخ به واژه ناآشنا به نوع Tokenizer بستگی دارد.
در روشهای زیرواژهای، واژه ممکن است به قسمتهای کوچکتری شکسته شود. بعضی طراحیها از نمایش سطح بایت استفاده میکنند تا بتوانند دنبالههای متنی گستردهتری را پوشش دهند. بعضی Tokenizerها نیز ممکن است برای موارد خارج از پوشش خود از توکن ناشناخته استفاده کنند.
برای مثال، نام محصولی تازه یا واژهای تخصصی لزوماً نباید بهعنوان یک عضو کامل در واژگان وجود داشته باشد؛ Tokenizer میتواند آن را با چند واحد کوچکتر نمایش دهد.
این انعطاف یکی از دلایل کاربرد گسترده توکنسازی زیرواژهای است.
انواع اصلی توکنسازی متن
روشهای توکنسازی را میتوان از نظر اندازه واحد خروجی دستهبندی کرد.
توکنسازی در سطح کلمه
متن بر اساس کلمهها تقسیم میشود.
مزیت آن سادگی درک است، اما واژگان موردنیاز میتواند بسیار بزرگ شود و مدیریت واژههای تازه یا شکلهای صرفی مختلف دشوار باشد.
توکنسازی در سطح نویسه
متن به نویسههای کوچکتر تقسیم میشود.
این روش میتواند واژههای ناآشنا را نمایش دهد، ولی معمولاً دنبالههای طولانیتری تولید میکند. طول بیشتر دنباله ممکن است پردازش را پرهزینهتر کند.
توکنسازی زیرواژهای
Tokenizerاز ترکیبی از واحدهای کوتاه و بلند استفاده میکند. بخشهای رایج متن ممکن است بهصورت واحدهای بزرگتر و بخشهای کمتکرار بهصورت قطعههای کوچکتر نمایش داده شوند.
BPE، WordPiece و Unigram از روشهای شناختهشده در این خانوادهاند. مستندات Transformers آنها را بهعنوان الگوریتمهای مهم توکنسازی زیرواژهای معرفی میکند. Hugging Face
BPE یا Byte Pair Encodingچیست؟
BPE خانوادهای از روشهای ساخت واژگان زیرواژهای است. ایده کلی آن آغاز از واحدهای کوچکتر و ترکیب تدریجی جفتهای پرتکرار برای تشکیل واحدهای بزرگتر است.
اگر بخشی از متن در داده آموزشی بسیار تکرار شود، احتمال دارد به شکل یک واحد مستقلتر در واژگان قرار بگیرد. عبارتهای کمتکرار ممکن است به قطعههای بیشتری تقسیم شوند.
بااینحال، «BPE» به معنی وجود یک Tokenizer یکسان در همه مدلها نیست. نوع واحدهای اولیه، قواعد پیشپردازش، اندازه واژگان و جزئیات پیادهسازی بر خروجی اثر میگذارند.
BPEدر سطح بایت
در برخی طراحیها، ورودی در سطح بایت مدیریت میشود. این کار میتواند به پوشش گسترده متنها کمک کند، اما نمایش یک واژه برای کاربر ممکن است نامأنوس باشد. ممکن است قطعات نمایشدادهشده در ابزار تحلیل Tokenizer بهتنهایی شبیه متن خوانای فارسی نباشند.
برای قضاوت درباره نتیجه، باید دنباله کامل را Encode و سپس Decode کنید؛ نمایش ظاهری یک قطعه بهتنهایی کافی نیست.
WordPieceچیست؟
WordPiece نیز واژهها را به زیرواژهها تقسیم میکند، ولی راهبرد ساخت واژگان آن با BPE یکسان نیست.
در خروجی بعضی Tokenizerهای WordPiece، نشانهای مانند ## نشان میدهد یک قطعه ادامه کلمه قبلی است. این نمایش به قواعد همان Tokenizer وابسته است و نباید آن را شکل عمومی همه توکنسازها دانست.
برای مثال آموزشی، یک واژه ممکن است به قطعه آغازین و یک یا چند قطعه ادامه تقسیم شود. قطعهبندی دقیق واژههای فارسی را در بخش عملی با Tokenizer واقعی مشاهده میکنیم.
Unigramچیست؟
در روش Unigram، Tokenizerاز میان قطعهبندیهای ممکن، بر اساس مدلی که آموزش دیده است، یک قطعهبندی را انتخاب میکند.
این روش نیز از واحدهای زیرواژهای استفاده میکند، اما فرایند ساخت واژگان و انتخاب قطعهها با BPE و WordPiece تفاوت دارد.
مستندات Hugging Face این سه خانواده را جداگانه توضیح میدهد و تأکید میکند که رفتار آنها را باید با توجه به مدل و Tokenizer مشخص بررسی کرد. Hugging Face
آیا SentencePiece همان Unigram است؟
خیر. SentencePiece نام یک ابزار و چارچوب توکنسازی است و میتواند از روشهایی مانند Unigram یا BPE استفاده کند.
یکی از ویژگیهای مهم SentencePiece، توجه به مدیریت متن خام و فاصلهها در فرایند توکنسازی است. مستندات پروژه توضیح میدهد که قواعد نرمالسازی و قطعهبندی در مدل Tokenizer ذخیره میشوند. GitHub
بنابراین بهتر است هنگام معرفی Tokenizer یک مدل، نام ابزار پیادهسازی و الگوریتم قطعهبندی آن را با هم اشتباه نگیریم.
مقایسه BPE، WordPiece وUnigram
| روش | ایده کلی | نکته عملی |
|---|---|---|
| BPE | ساخت قطعات بزرگتر از ترکیبهای پرتکرار | خروجی به داده و جزئیات پیادهسازی وابسته است |
| WordPiece | ساخت واژگان زیرواژهای با معیار انتخاب متفاوت | در برخی مدلها ادامه واژه با نشانه مشخص دیده میشود |
| Unigram | انتخاب قطعهبندی با مدل احتمالاتی آموزشدیده | یک متن میتواند چند قطعهبندی قابل بررسی داشته باشد |
نام روش بهتنهایی برای پیشبینی شمار توکنهای فارسی کافی نیست. Tokenizerآموزشدیده همان مدل را اجرا کنید.
مراحل معمول در یکTokenizer
بسته به پیادهسازی، مسیر توکنسازی میتواند چند مرحله داشته باشد:
- نرمالسازی: اعمال قواعد مشخص روی متن.
- پیشتقسیمبندی: جداکردن اولیه بخشها بر اساس قواعدی مانند فاصله یا نشانهگذاری.
- قطعهبندی: تبدیل بخشها به توکنهای واژگان.
- افزودن توکنهای ویژه: افزودن نشانههای لازم برای مدل یا وظیفه.
- تبدیل به شناسه عددی: ساخت ورودی نهایی مدل.
ترتیب و وجود این مراحل در همه Tokenizerها یکسان نیست. مستندات کتابخانه tokenizers مسیر پردازش را به همین اجزای قابل تنظیم تقسیم میکند. tokenizers documentation
چرا متن فارسی به بررسی جداگانه نیاز دارد؟
در متن فارسی، شکل نوشتن یک مفهوم همیشه یکسان نیست. این تفاوتها میتوانند ورودی متفاوتی به Tokenizer بدهند.
چند نمونه:
میرومبا نیمفاصلهمی رومبا فاصله معمولیمیرومبدون فاصلهکتاببا «ک» فارسی- متنی با «ك» عربی
علیبا «ی» فارسی- متنی با «ي» عربی
این موارد ممکن است از دید خواننده نزدیک باشند، اما از دید دنباله نویسهها یکسان نیستند. نتیجه توکنسازی نیز میتواند متفاوت باشد.
البته نباید نتیجه گرفت هرچه متن را بیشتر یکدست کنیم، همیشه بهتر است. تبدیل یا حذف بیحساب نویسهها ممکن است معنا، نگارش یا امکان بازسازی دقیق متن را تغییر دهد.
نیمفاصله چه اثری بر شمار توکن دارد؟
نیمفاصله یا Zero Width Non-Joiner در بسیاری از ترکیبهای فارسی به کار میرود. برای مثال، در نوشتن «میروم» یا «کتابها» ممکن است حضور آن بر شکل نمایش واژه اثر بگذارد.
برای Tokenizer، وجود و محل نیمفاصله بخشی از ورودی است. اثر دقیق آن به قواعد نرمالسازی و واژگان همان Tokenizer بستگی دارد.
به همین دلیل، یک «ضریب ثابت تبدیل کلمه فارسی به توکن» وجود ندارد که برای همه متنها و مدلها دقیق باشد.
آیا اعداد، ایموجی و کد برنامهنویسی توکن مصرف میکنند؟
بله. Tokenizer تمام بخشهای ورودی را طبق قواعد خود پردازش میکند.
یک ورودی ممکن است شامل موارد زیر باشد:
- متن فارسی
- اعداد فارسی و لاتین
- نام فایل
- آدرس اینترنتی
- قطعه کد
- نشانههایMarkdown
- ایموجی
- دادهJSON
قطعهبندی هرکدام میتواند متفاوت باشد. برای مثال، یک رشته طولانی از شناسهها یا نشانیها ممکن است نسبت به تعداد کلمات ظاهریاش توکنهای زیادی مصرف کند.
در برنامههایی که اسناد، لاگها یا کد را برای مدل میفرستند، شمارش کلمات معمولاً تخمین مناسبی از حجم ورودی نیست.
آموزش عملی: مشاهده توکنهای متن فارسی باPython
در این مثال از یک Tokenizer آماده استفاده میکنیم. هدف، دیدن قطعهبندی واقعی چند متن فارسی است؛ از این آزمایش نباید درباره کیفیت تولید متن آن مدل نتیجهگیری کرد.
نصب کتابخانه
pip install transformersدر اولین اجرا، فایلهای Tokenizer دانلود میشوند.
بارگذاریTokenizer
from transformers import AutoTokenizer


MODEL_ID = "bert-base-multilingual-cased"

tokenizer = AutoTokenizer.from_pretrained(
    MODEL_ID,
    use_fast=True,
)

print(
    "Fast tokenizer:",
    tokenizer.is_fast,
)

print(
    "Vocabulary size:",
    tokenizer.vocab_size,
)
در اینجا فقط Tokenizer بارگذاری میشود؛ وزنهای کامل مدل برای مشاهده قطعهبندی متن لازم نیستند.
بررسی چند صورت نوشتاری
samples = [
"هوش مصنوعی به توسعهدهندگان کمک میکند.",
"هوش مصنوعی به توسعه دهندگان کمک می کند.",
"کتابها",
"کتاب ها",
"علی و رضا",
"علي و رضا",
]
for text in samples:
encoded = tokenizer(
text,
add_special_tokens=False,
)
token_ids = encoded["input_ids"]
tokens = tokenizer.convert_ids_to_tokens(
token_ids
)
print("\nTEXT:", repr(text))
print("TOKENS:", tokens)
print("TOKEN IDS:", token_ids)
print("COUNT:", len(token_ids))repr کمک میکند تفاوتهایی مانند وجود نیمفاصله را راحتتر ببینید. نتیجه دقیق را کد اجراشده نشان میدهد؛ نباید برای همه Tokenizerها خروجی یکسان انتظار داشت.
مقایسه تعداد کلمه و تعداد توکن
کد زیر یک شمارش بسیار ساده بر اساس فاصله را با شمار توکن مقایسه میکند:
texts = [ "این یک جمله کوتاه فارسی است.", "میخواهم درباره پردازش زبان فارسی بدانم.", "API مدل را با Python به برنامه وصل میکنیم.",]for text in texts: whitespace_parts = len( text.split() ) model_tokens = len( tokenizer( text, add_special_tokens=False, )["input_ids"] ) print( repr(text), "| بخشهای جداشده با فاصله:", whitespace_parts, "| توکنهای مدل:", model_tokens, )split() در این مثال شمارش دقیق کلمههای زبان فارسی نیست؛ فقط فاصلههای معمول را مبنای تقسیم قرار میدهد. از آن برای نشاندادن تفاوت دو روش شمارش استفاده کردهایم.
نمایش محل هر توکن در متن اصلی
Tokenizerهای سریع Hugging Faceمیتوانند اطلاعاتی درباره بازه نویسههای مرتبط با توکنها برگردانند. این قابلیت برای بررسی قطعهبندی یا اتصال پیشبینی مدل به متن اصلی مفید است. Hugging Face
text = ( "پردازش متن فارسی " "با نیمفاصله مهم است.")encoded = tokenizer( text, add_special_tokens=False, return_offsets_mapping=True,)tokens = tokenizer.convert_ids_to_tokens( encoded["input_ids"])for token, offsets in zip( tokens, encoded["offset_mapping"],): start, end = offsets source_fragment = text[ start:end ] print( f"{token:>20}", offsets, repr(source_fragment), )نکته: نمایش ظاهری توکن و قطعه متن اصلی لزوماً یکسان نیست. ممکن است Tokenizer نرمالسازی انجام دهد یا برای نشاندادن ادامه زیرواژه از علامت خاصی استفاده کند.
توکنهای ویژه چیستند؟
بعضی مدلها برای مشخصکردن ساختار ورودی از توکنهای ویژه استفاده میکنند؛ مانند نشانه آغاز دنباله، پایان بخش یا جداکننده متنها.
در مثال قبل، با add_special_tokens=False این توکنها را حذف کردیم تا قطعهبندی خود متن را ببینیم. حالا تفاوت را بررسی کنید:
text = "سلام، حالت چطور است؟"without_special = tokenizer( text, add_special_tokens=False,)with_special = tokenizer( text, add_special_tokens=True,)print( "Without special tokens:", tokenizer.convert_ids_to_tokens( without_special["input_ids"] ),)print( "With special tokens:", tokenizer.convert_ids_to_tokens( with_special["input_ids"] ),)print( "Counts:", len(without_special["input_ids"]), len(with_special["input_ids"]),)در یک درخواست گفتوگویی، ساختار پیامها و قالب مورد انتظار مدل نیز ممکن است توکنهای بیشتری به ورودی اضافه کند. بنابراین شمار توکن متن خام الزاماً برابر با شمار نهایی توکن درخواست نیست.
Chat Templateچه ارتباطی با توکنسازی دارد؟
مدل گفتوگویی معمولاً پیامهای دارای نقش، مانند پیام کاربر و دستیار، را در قالب مشخصی دریافت میکند.
کتابخانه یا سرویس ممکن است این پیامها را به یک دنباله مناسب همان مدل تبدیل کند. این فرایند میتواند نشانههای ویژه و متن قالببندی را وارد دنباله کند.
مستندات Hugging Face تأکید میکند که Chat Template مدل باید هنگام آمادهسازی پیامها رعایت شود؛ شکل توکنهای کنترلی میان مدلها یکسان نیست. huggingface.co
از همین رو، اگر میخواهید پیش از ارسال درخواست تعداد توکنها را دقیق پیشبینی کنید، فقط توکنکردن رشته پیام کاربر کافی نیست؛ باید قالب واقعی درخواست و Tokenizer واقعی مسیر اجرا را نیز بدانید.
ساخت یک Tokenizer آموزشی BPE باPython
برای فهم بهتر تفاوت «استفاده از Tokenizer آماده» و «آموزش Tokenizer»، یک نمونه کوچک BPE میسازیم.
این نمونه برای آموزش مفهوم است. چند جمله تکراری برای ساخت Tokenizer مناسب محصول یا زبان فارسی کافی نیست. Tokenizer واقعی به داده متنوع، ارزیابی و سازگاری با مدل نیاز دارد.
نصب
pip install tokenizersآموزش از داده در حافظه
from tokenizers import (
Tokenizer,
decoders,
models,
pre_tokenizers,
trainers,
)
sentences = [
"هوش مصنوعی به توسعه نرمافزار کمک میکند.",
"مدل زبانی متن را به توکن تبدیل میکند.",
"پردازش زبان فارسی به داده مناسب نیاز دارد.",
"برنامهنویسان از API هوش مصنوعی استفاده میکنند.",
"توکنسازی روی طول ورودی مدل اثر دارد.",
]
training_texts = sentences * 200
toy_tokenizer = Tokenizer(
models.BPE(
unk_token="[UNK]"
)
)
toy_tokenizer.pre_tokenizer = (
pre_tokenizers.ByteLevel(
add_prefix_space=False
)
)
toy_tokenizer.decoder = (
decoders.ByteLevel()
)
trainer = trainers.BpeTrainer(
vocab_size=500,
min_frequency=2,
initial_alphabet=(
pre_tokenizers.ByteLevel
.alphabet()
),
special_tokens=[
"[UNK]",
],
)
toy_tokenizer.train_from_iterator(
training_texts,
trainer=trainer,
)
sample = (
"توکنسازی متن فارسی "
"را بررسی میکنیم."
)
encoding = toy_tokenizer.encode(
sample
)
print(
"Tokens:",
encoding.tokens,
)
print(
"IDs:",
encoding.ids,
)
print(
"Count:",
len(encoding.ids),
)
print(
"Decoded:",
toy_tokenizer.decode(
encoding.ids
),
)در این آزمایش، پیشتقسیمبندی و بازسازی متن با روش ByteLevel انجام میشود. نمایش ظاهری توکنهای منفرد ممکن است برای فارسی نامأنوس باشد؛ خروجی decode() را نیز بررسی کنید.
مستندات رسمی کتابخانه tokenizers آموزش BPE از داده و ساخت Tokenizer از اجزای جداگانه را شرح میدهد. Hugging Face
آیا میتوان Tokenizer یک مدل را عوض کرد؟
از نظر فنی، میتوان Tokenizer دیگری ساخت؛ اما تعویض Tokenizer یک مدل آموزشدیده با یک Tokenizer دلخواه معمولاً کار سادهای نیست.
مدل با شناسهها و واژگان مشخصی آموزش دیده است. اگر Tokenizer جدید متن را به شناسههای متفاوت تبدیل کند، ورودی دیگر با معنایی که مدل برای آن شناسهها آموخته هماهنگ نخواهد بود.
حتی اگر اندازه واژگان را تغییر دهید، لایههای وابسته به شناسه توکنها نیز باید با آن سازگار شوند و معمولاً آموزش تکمیلی لازم است.
برای یک مدل آماده، از Tokenizer معرفیشده همراه همان مدل استفاده کنید؛ مگر اینکه فرایند سازگارسازی و آموزش را آگاهانه طراحی کرده باشید.
نرمالسازی متن فارسی قبل ازTokenizer
یک تصمیم رایج این است که شکلهای متفاوت نویسههای مشابه را در داده خود یکدست کنیم؛ برای مثال «ي» عربی را به «ی» فارسی و «ك» عربی را به «ک» فارسی تبدیل کنیم.
نمونه ساده:
def normalize_common_persian_forms(
    text: str,
) -> str:
    return (
        text
        .replace("ي", "ی")
        .replace("ك", "ک")
    )


original = (
    "پردازش متن فارسي "
    "با كد"
)

normalized = (
    normalize_common_persian_forms(
        original
    )
)

print(
    "Original:",
    original,
)

print(
    "Normalized:",
    normalized,
)

print(
    "Original tokens:",
    len(
        tokenizer(
            original,
            add_special_tokens=False,
        )["input_ids"]
    ),
)

print(
    "Normalized tokens:",
    len(
        tokenizer(
            normalized,
            add_special_tokens=False,
        )["input_ids"]
    ),
)
این کد فقط دو جایگزینی مشخص انجام میدهد. یک سامانه واقعی باید درباره نیمفاصله، فاصلههای اضافی، اعداد، نویسههای ترکیبی و شیوه نگهداری متن اصلی تصمیم روشن داشته باشد.
تعداد توکن کمتر تنها معیار خوبی نرمالسازی نیست. متن نهایی باید معنای موردنظر و سازگاری با کاربرد را نیز حفظ کند.
آیا هرچه تعداد توکن کمتر باشد بهتر است؟
نه همیشه.
تعداد توکن کمتر برای یک متن مشخص میتواند به استفاده بهتر از ظرفیت ورودی کمک کند، اما کیفیت یک Tokenizer را فقط با این عدد نمیسنجیم.
برای مثال، باید بررسی شود:
- آیا متن پس از Encode و Decode بهدرستی بازسازی میشود؟
- واژههای تخصصی چگونه نمایش داده میشوند؟
- متن فارسی و انگلیسی ترکیبی چه رفتاری دارد؟
- نامها، عددها و نشانهگذاری چگونه پردازش میشوند؟
- Tokenizerبا مدلی که قرار است از آن استفاده کند سازگار است؟
- نتیجه در وظیفه نهایی چقدر مناسب است؟
مقایسه دو Tokenizer صرفاً بر اساس یک جمله کوتاه میتواند گمراهکننده باشد.
ارتباط توکنسازی باContext Window
Context Window ظرفیت مدلی برای پردازش دنباله ورودی و، بسته به تعریف و محدودیتهای همان مدل، تولید خروجی است.
برای اینکه بدانید یک سند یا گفتوگو در درخواست جا میشود، باید به محدودیتهای واقعی مدل و تعداد توکنهای درخواست توجه کنید.
اگر سند طولانی باشد، راهکارهایی مانند این موارد مطرح میشوند:
- انتخاب بخشهای مرتبط
- تقسیم سند به بخشهای کوچکتر
- خلاصهسازی مناسب وظیفه
- محدودکردن تاریخچه ارسالی مکالمه
- انتخاب مدلی با ظرفیت ورودی مناسب
تقسیم متن فقط بر اساس «تعداد کاراکتر» ممکن است بخشهایی با تعداد توکن بسیار متفاوت بسازد. برای طراحی این بخش، مقاله Chunkingیا تقسیم متن برای مدلهای زبانی نیز مفید است.
توکنسازی در RAG چه اهمیتی دارد؟
در سامانههای بازیابی و تولید پاسخ، اسناد اغلب به بخشهای کوچکتر تقسیم و سپس پردازش میشوند.
توکنسازی در چند نقطه اهمیت پیدا میکند:
- تعیین اندازه بخشهای سند
- سنجش اینکه چند بخش در ورودی مدل پاسخدهنده جا میشود
- اختصاص فضا به دستور، پرسش کاربر و منابع بازیابیشده
- کنترل طول پاسخ مورد انتظار
- برآورد حجم درخواستها
اگر سامانه از مدل Embedding و مدل پاسخدهنده متفاوت استفاده کند، Tokenizerو محدودیت ورودی آنها نیز ممکن است متفاوت باشد. نباید شمار توکن یکی را بدون بررسی به دیگری تعمیم داد.
آیا شمارش توکن با tiktoken برای همه مدلها دقیق است؟
خیر. tiktoken کتابخانه متنباز OpenAI برای توکنسازی سازگار با Encodingهای پشتیبانیشده خود است. وجود این کتابخانه به معنی یکسانبودن Tokenizer همه مدلهای موجود در سرویسهای چندمدلی نیست. github.com
اگر مدل مقصد Tokenizer دیگری داشته باشد، عدد بهدستآمده از یک Encoding نامرتبط صرفاً یک تخمین است؛ حتی ممکن است اختلاف آن برای متن فارسی، کد یا داده ساختاریافته محسوس باشد.
برای شمارش دقیقتر:
- مستندات مدل مقصد را بررسی کنید.
- در صورت دسترسبودن، از Tokenizer همان مدل استفاده کنید.
- ساختار کامل پیامها و نشانههای قالب را لحاظ کنید.
- پس از فراخوانی، مقدار مصرف گزارششده توسط API را بررسی کنید.
شمارش توکن و هزینهAPI
در بسیاری از APIهای مدل زبانی، میزان مصرف بر اساس توکنهای ورودی و خروجی گزارش میشود. اما قواعد قیمتگذاری میتوانند بر اساس مدل، مسیر ارائه، نوع محتوا و شرایط سرویس تفاوت داشته باشند.
برای یک تخمین اولیه، شمار توکن کمککننده است. برای ثبت مصرف واقعی درخواست، گزارش API و مستندات قیمتگذاری همان سرویس را مبنا قرار دهید.
بهویژه در سرویس چندمدلی، نباید فرض کنید:
- همه مدلها Tokenizer یکسان دارند.
- هر تعداد کلمه فارسی به تعداد ثابتی توکن تبدیل میشود.
- شمار توکن متن خام با شمار توکن نهایی درخواست برابر است.
- همه بخشهای یک درخواست چندرسانهای مانند متن معمولی شمارش میشوند.
برای مفاهیم اولیه هزینه و مصرف، مقالههای توکن در API هوش مصنوعی و حداکثر توکن در مدلهای هوش مصنوعی را بخوانید.
بررسی مصرف واقعی یک درخواست در API درواره
اگر به API سازگار با OpenAI درواره دسترسی دارید، میتوانید پس از یک درخواست غیرجریانی، اطلاعات مصرف بازگرداندهشده را بررسی کنید.
ابتدا کتابخانه را نصب کنید:
pip install openaiمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_MODEL_ID"
سپس:
import osfrom openai import OpenAIclient = OpenAI( api_key=os.environ[ "DARVAREH_API_KEY" ], base_url=( "https://api.darvareh.ir/v1" ),)response = ( client.chat.completions.create( model=os.environ[ "DARVAREH_CHAT_MODEL" ], messages=[ { "role": "user", "content": ( "تفاوت توکن و کلمه " "را در سه جمله توضیح بده." ), } ], ))print( response.choices[0] .message.content)شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید و جزئیات پشتیبانی و مصرف را در مستندات API درواره بررسی کنید. وجود فیلد usage و جزئیات شمارش ممکن است به مدل و مسیر ارائه وابسته باشد؛ کد نبودن آن را نیز مدیریت میکند.
نکته مهم: اگر همان متن را با Tokenizer مدل دیگری بشمارید و عدد متفاوتی ببینید، این اختلاف بهتنهایی نشانه خطای API نیست. Tokenizer و قالب واقعی درخواست باید یکسان باشند تا مقایسه دقیق شود.
چگونه برای ورودی مدل بودجه توکن تعیین کنیم؟
برای برنامهای که سند و پرسش کاربر را به مدل میفرستد، میتوان ظرفیت ورودی را به بخشهای عملی تقسیم کرد:
- دستورهای ثابت برنامه
- تاریخچه لازم مکالمه
- پرسش جدید کاربر
- متنهای بازیابیشده از اسناد
- توکنهای لازم برای قالب پیامها
- ظرفیت موردنظر برای پاسخ
نباید تمام ظرفیت را به سند اختصاص دهید و برای دستورها یا پاسخ جایی باقی نگذارید.
روش قابل اتکا این است که با دادههای واقعی محصول، طول درخواستها را اندازه بگیرید. سپس برای درخواستهای بلند سیاست مشخصی داشته باشید: کوتاهسازی، انتخاب محتوای مرتبط یا درخواست پردازش مرحلهای.
چگونه Tokenizerها را برای متن فارسی مقایسه کنیم؟
برای مقایسه بهتر، مجموعهای متنوع از متنها بسازید؛ نه فقط چند جمله رسمی.
این مجموعه میتواند شامل موارد زیر باشد:
- پیامهای محاورهای کاربران
- متن رسمی و اداری
- واژههای فنی فارسی و انگلیسی
- نام اشخاص و محصولات
- اعداد فارسی و لاتین
- نشانی اینترنتی
- نیمفاصله و شکلهای مختلف «ی» و «ک»
- غلطهای تایپی متداول
- جدول، Markdown و قطعه کد
برای هر مدل، دستکم این موارد را ثبت کنید:
| معیار | پرسش |
|---|---|
| تعداد توکن | متن نمونه به چند واحد تبدیل میشود؟ |
| بازسازی متن | Decode تا چه حد متن مورد انتظار را برمیگرداند؟ |
| رفتار با نویسههای فارسی | نیمفاصله و شکلهای متفاوت حروف چه اثری دارند؟ |
| سازگاری | Tokenizer متعلق به همان مدل است؟ |
| عملکرد وظیفه | پاسخ مدل در کاربرد واقعی چقدر مناسب است؟ |
کمترشدن تعداد توکن میتواند مزیت عملی داشته باشد، اما جای ارزیابی کیفیت مدل را نمیگیرد.
خطاهای رایج هنگام شمارش توکن
برابر دانستن توکن با کلمه
یک کلمه ممکن است چند توکن باشد. نشانهگذاری و فاصلهها نیز میتوانند در توکنسازی دخیل باشند.
استفاده از Tokenizer مدل دیگر
شمارش با Tokenizer نامرتبط ممکن است برای مدل مقصد دقیق نباشد.
نادیدهگرفتن قالب گفتوگو
پیامهای نقشدار و توکنهای ویژه میتوانند به طول واقعی درخواست اضافه کنند.
حذف خودکار تمام نیمفاصلهها
این کار ممکن است نگارش یا معنای متن را تغییر دهد و لزوماً به نتیجه بهتر منجر نمیشود.
استنتاج کیفیت مدل از روی تعداد توکن
مدلی با توکن کمتر برای یک متن، الزاماً پاسخ بهتری به آن متن نمیدهد.
استفاده از شمارش کاراکتر برای برش قطعی سند
دو قطعه با تعداد کاراکتر برابر میتوانند تعداد توکن متفاوتی داشته باشند.
نادیدهگرفتن متن خروجی
در برنامهریزی ظرفیت درخواست، برای پاسخ نیز فضا در نظر بگیرید.
فرض ثابتماندن نتیجه پس از تغییر مدل
با تغییر مدل یا Tokenizer، شمار توکن و رفتار ورودی ممکن است تغییر کند. اندازهگیریها را برای مدل جدید تکرار کنید.
پرسشهای متداول
Tokenizerچیست؟
Tokenizerابزاری است که متن را به واحدهای قابل پردازش برای مدل، یعنی توکنها و شناسههای عددی آنها، تبدیل میکند.
Tokenizationچیست؟
Tokenization یا توکنسازی فرایند تقسیم و تبدیل متن بر اساس قواعد و واژگان Tokenizerاست.
آیا هر توکن یک کلمه است؟
خیر. توکن میتواند یک کلمه، بخشی از کلمه یا واحد دیگری متناسب با طراحی Tokenizer باشد.
چرا یک متن فارسی در دو مدل تعداد توکن متفاوتی دارد؟
چون مدلها ممکن است واژگان، قواعد نرمالسازی و الگوریتم توکنسازی متفاوتی داشته باشند.
BPEچیست؟
BPEخانوادهای از روشهای توکنسازی زیرواژهای است که با ترکیب تدریجی واحدهای پرتکرار، قطعههای واژگان را میسازد.
WordPiece و BPEیکساناند؟
خیر. هر دو برای توکنسازی زیرواژهای به کار میروند، اما روش ساخت واژگان و جزئیات آنها متفاوت است.
آیا نیمفاصله روی تعداد توکن اثر دارد؟
ممکن است اثر داشته باشد. نتیجه دقیق به Tokenizer مدل و قواعد نرمالسازی آن بستگی دارد.
آیا میتوان تعداد توکن API را فقط با شمارش کلمات تخمین زد؟
میتوان تخمین بسیار تقریبی ساخت، اما برای کنترل محدودیت ورودی یا برآورد دقیق مصرف، شمارش کلمات کافی نیست.
آیا باید برای استفاده از مدل آماده Tokenizer اختصاصی بسازم؟
معمولاً خیر. از Tokenizer معرفیشده همراه همان مدل استفاده کنید. ساخت Tokenizer جدید بدون سازگارسازی مدل میتواند ورودی آن را مختل کند.
بهترین راه فهم تعداد توکن واقعی یک درخواست چیست؟
اگر Tokenizer دقیق مدل و قالب کامل درخواست در دسترس است، آنها را اجرا کنید. برای مصرف ثبتشده یک فراخوانی API نیز اطلاعات بازگرداندهشده توسط همان سرویس را بررسی کنید.
جمعبندی
Tokenizer متن را به واحدهایی تبدیل میکند که مدل میتواند پردازش کند. این واحدها با کلمه، کاراکتر یا بایت یکسان نیستند و قطعهبندی آنها به Tokenizerمشخص هر مدل وابسته است.
روشهایی مانند BPE، WordPiece و Unigram راهکارهای متفاوتی برای ساخت و انتخاب زیرواژهها دارند. در فارسی نیز نیمفاصله، شکل نویسهها و ترکیب متن با عدد یا انگلیسی میتواند بر شمار توکن اثر بگذارد.
اگر با API هوش مصنوعی کار میکنید، تعداد توکن را برای مدل و قالب واقعی درخواست بسنجید. این کار به طراحی ورودی، مدیریت سندهای طولانی و برآورد مصرف کمک میکند؛ اما ارزیابی کیفیت پاسخ همچنان باید روی داده واقعی محصول انجام شود.
برای آزمایش مدلهای مختلف با یک اتصال API و بررسی گزینه مناسب برای کاربرد فارسی، مدلها و خدمات درواره را در darvareh.ir ببینید. سپس مصرف ثبتشده، کیفیت پاسخ و هزینه هر مدل را با درخواستهای واقعی خود مقایسه کنید.
مقالات مرتبط
- توکن در API هوش مصنوعی چیست؟
- حداکثر توکن در مدلهای هوش مصنوعی
- مدل زبانی بزرگ یا LLM چیست؟
- معماری Transformer وAttention
- Chunkingیا تقسیم متن چیست؟
- Context Engineeringبرای عاملهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- راهنمای الگوریتمهای توکنسازی درHugging Face Transformers
- مستندات Tokenizer درHugging Face Transformers
- آموزش ساخت Tokenizer با کتابخانهHugging Face Tokenizers
- مستندات مسیر پردازشTokenizer
- مستندات رسمیSentencePiece
- مخزن رسمیtiktoken
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدل و سرویس موردنظر و صفحه سلب مسئولیت درواره را مطالعه کنید.



