
SPLADE چیست؟ آموزش جستوجوی عصبی با بردارهای پراکنده در Python و Qdrant
SPLADE چیست و چگونه جستوجوی واژگانی را با یادگیری عمیق ترکیب میکند؟ در این راهنما، بردارهای پراکنده، گسترش واژگان، تفاوت با BM25 و Dense Embedding و پیادهسازی جستوجو با Python و Qdrant را میآموزید.

در جستوجوی اطلاعات، کاربران همیشه همان واژههایی را به کار نمیبرند که نویسنده سند استفاده کرده است.
کاربر ممکن است «برگشت پول» را جستوجو کند، در حالی که راهنمای محصول از عبارت «استرداد وجه» استفاده کرده باشد. یک سامانه جستوجو باید بتواند ارتباط این دو عبارت را تشخیص دهد.
از طرف دیگر، بعضی واژهها باید دقیق باقی بمانند. نام محصول، شناسه مدل، شماره نسخه یا کد خطا را نمیتوان صرفاً با شباهت موضوعی جایگزین کرد.
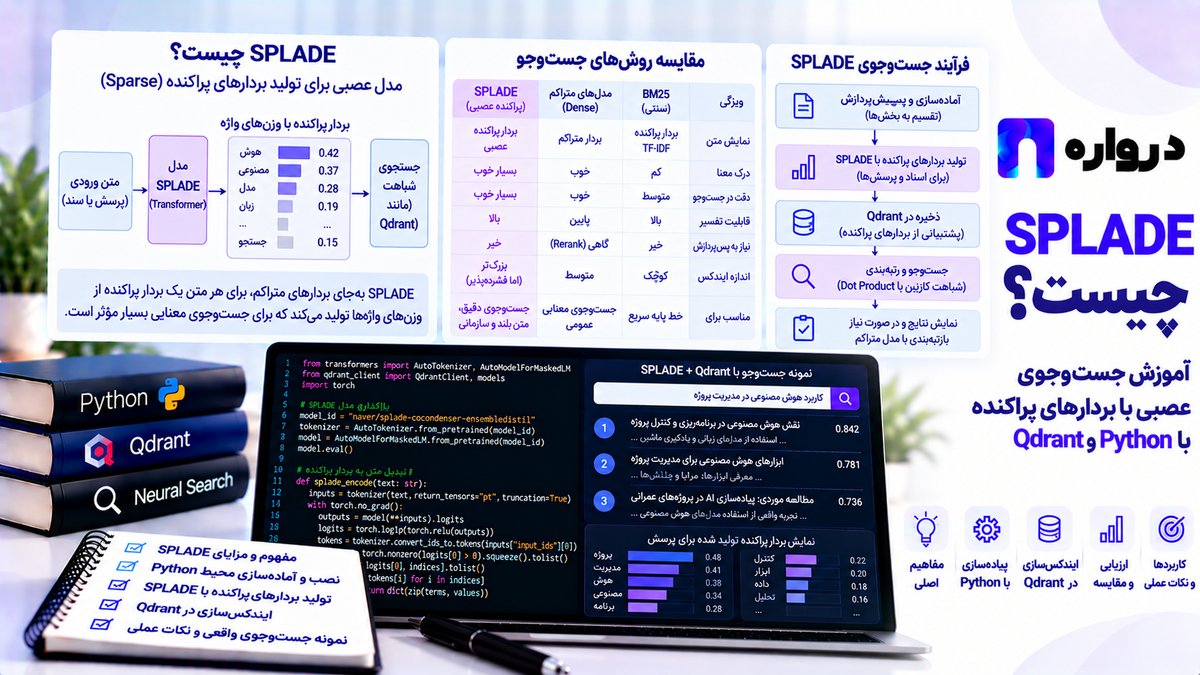
SPLADE یکی از روشهای بازیابی عصبی است که متن را به یک بردار پراکنده و وزندار در فضای واژگان مدل تبدیل میکند. این نمایش میتواند علاوه بر توکنهای موجود در متن، برای توکنهای مرتبط نیز وزن تولید کند.
مقاله اصلی SPLADE این روش را برای بازیابی مرحله اول معرفی کرد؛ با هدف استفاده از نمایشهای پراکنده آموختهشده و ویژگیهای مفید شاخصهای معکوس. arxiv.org
در این مقاله، سازوکار SPLADE، تفاوت آن با BM25 و Embedding متراکم، پیادهسازی عملی و روش ارزیابی آن در سامانههای جستوجو و RAG را بررسی میکنیم.
SPLADEچیست؟
SPLADEمخفف Sparse Lexical and Expansion Model است.
این نام به سه ویژگی اشاره دارد:
- Sparse: نمایش متن پراکنده است.
- Lexical: ابعاد نمایش به توکنهای واژگان مدل مرتبطاند.
- Expansion: مدل میتواند نمایش متن را با توکنهای مرتبط گسترش دهد.
در این روش، پرسش و سند به مجموعهای از شناسههای توکن و وزنهای متناظر تبدیل میشوند. سپس امتیاز ارتباط آنها از تطبیق همین نمایشها محاسبه میشود.
SPLADEیک مدل تولید پاسخ نیست. وظیفه آن پیدا کردن یا رتبهبندی اسنادی است که ممکن است برای پاسخگویی مناسب باشند.
بردار پراکنده یا Sparse Embedding چیست؟
بردار پراکنده برداری است که بسیاری از مقدارهای آن صفر هستند.
برای ذخیره چنین برداری، لازم نیست تمام صفرها نگه داشته شوند. میتوان فقط موقعیتهای فعال و مقدار آنها را ذخیره کرد.
برای مثال:
indices = [12, 81, 240]values = [0.7, 1.4, 0.3]این نمایش میگوید سه موقعیت بردار فعالاند و هر کدام وزن مشخصی دارند.
در SPLADE، موقعیتها به شناسه توکنهای واژگان مربوط میشوند. یک توکن نیز الزاماً یک کلمه کامل نیست؛ ممکن است بخشی از کلمه باشد.
پراکندهبودن با کمبعدبودن فرق دارد
یک بردار میتواند فضای بسیار بزرگی داشته باشد، اما فقط تعداد محدودی از موقعیتهای آن فعال باشند.
در مقابل، یک بردار متراکم ممکن است چند صد مقدار داشته باشد و تقریباً تمام آنها در محاسبه استفاده شوند.
بنابراین هنگام مقایسه هزینه، تنها تعداد ابعاد کافی نیست. تعداد مقدارهای غیرصفر و شیوه ذخیرهسازی نیز اهمیت دارد.
گسترش واژگان در SPLADE چگونه کار میکند؟
فرض کنید سندی درباره «خودرو» صحبت میکند، اما کاربر «ماشین» را جستوجو کرده است.
در یک نمایش صرفاً مبتنی بر حضور واژه، این دو عبارت ممکن است اشتراک مستقیمی نداشته باشند. در نمایش گسترشیافته، مدل میتواند برای توکنهای مرتبط نیز وزن ایجاد کند و امکان تطبیق را افزایش دهد.
این مثال فارسی برای توضیح مفهوم است؛ خروجی واقعی یک مدل مشخص محسوب نمیشود.
گسترش واژگان نیز به این معنا نیست که متن اصلی تغییر میکند. سند همان سند است؛ فقط نمایش مورد استفاده برای جستوجو متفاوت میشود.
همچنین هر توکن اضافهشده الزاماً مفید نیست. برای مثال، گسترش یک نام تجاری به موضوعات عمومیتر میتواند بعضی نتایج نامرتبط را نزدیک کند. اثر آن باید روی داده واقعی سنجیده شود.
SPLADEچگونه وزن توکنها را یاد میگیرد؟
در خانواده SPLADE، یک مدل زبانی برای ساخت نمایش وزندار استفاده میشود. فرایند آموزش باید دو نیاز را همزمان مدیریت کند:
- مرتبطبودن پرسش و سند بهخوبی تشخیص داده شود.
- نمایشها بیشازحد پرحجم و متراکم نشوند.
مقاله اصلی از منظمسازی پراکندگی و محدودکردن رشد وزنها استفاده میکند تا میان اثربخشی و هزینه بازیابی تعادل برقرار شود. arxiv.org
وزنهای خروجی را نباید احتمال حضور کلمه یا درصد اهمیت قطعی آن دانست. آنها بخشی از نمایش آموختهشده برای رتبهبندی هستند.
تفاوت SPLADE وBM25
BM25 یک روش امتیازدهی واژگانی است که به عواملی مانند فراوانی واژه، فراوانی سندی و طول متن توجه میکند. تنظیمات رسمی Elasticsearch نیز BM25را بهعنوان یکی از روشهای شباهت مستند میکند. Elasticsearch Reference
SPLADEوزنها و گسترش نمایش را با یک مدل عصبی یاد میگیرد.
| معیار | BM25 | SPLADE |
|---|---|---|
| ساخت وزنها | مبتنی بر آمار واژگان | مبتنی بر مدل آموختهشده |
| گسترش معنایی | نیازمند قابلیت جداگانه | در نمایش مدل امکانپذیر است |
| اجرای رمزگذار عصبی | در شکل معمول لازم نیست | لازم است |
| نمایش قابل بررسی | واژهها و امتیازها | توکنها و وزنها |
| نقطه شروع آزمایش | ساده و مناسب | مرحله بعدی مقایسه |
| برتری عمومی | قابل فرض نیست | قابل فرض نیست |
SPLADE را نباید جایگزین قطعی BM25دانست.
برای مجموعهای با نامها، شناسهها و عبارتهای مشخص، یک جستوجوی واژگانی خوب ممکن است نتیجه مناسبی بدهد. تصمیم به افزودن SPLADE باید از خطاهای واقعی و ارزیابی بیاید.
تفاوت SPLADE وDense Embedding
در بسیاری از مدلهای Dense Embedding، یک قطعه متن به برداری متراکم تبدیل میشود. موقعیتهای آن معمولاً نام یک توکن مشخص را ندارند.
در SPLADE، نمایش در فضای واژگان ساخته میشود و میتوان شناسههای فعال را به توکنها نگاشت کرد.
| معیار | SPLADE | Dense Embedding |
|---|---|---|
| نوع نمایش | پراکنده | متراکم |
| معنای موقعیتها | مرتبط با توکنهای واژگان | ویژگیهای آموختهشده |
| بررسی توکنهای فعال | امکانپذیر | معمولاً مستقیم نیست |
| سازوکار تطبیق | وزنهای موقعیتهای مشترک | شباهت بردارها |
| نیاز به ارزیابی زبان | دارد | دارد |
| امکان استفاده ترکیبی | دارد | دارد |
این دو نمایش میتوانند در یک سامانه استفاده شوند، اما ترکیب آنها نیز الزاماً بهتر از بهترین روش منفرد نیست.
امتیاز تطبیق بردارهای پراکنده
برای درک محاسبه، دو بردار ساختگی در نظر بگیرید:
query = { 1: 1.0, 3: 0.5,}document = { 1: 0.8, 3: 0.6, 5: 0.4,}فقط موقعیتهای مشترک در امتیاز نقش دارند. وزنهای متناظر ضرب میشوند و حاصلها با هم جمع میشوند.
پیادهسازی ساده:
def sparse_dot(left, right): if len(left) > len(right): left, right = right, left return sum( weight * right.get(index, 0.0) for index, weight in left.items() )print(sparse_dot(query, document))خروجی:
1.1این مثال فقط سازوکار ضرب داخلی پراکنده را نشان میدهد.
در یک سامانه واقعی، شناسهها و وزنها از مدل میآیند. همچنین بهجای بررسی تمام اسناد با یک حلقه Python، میتوان از شاخص مناسب استفاده کرد.
شاخص معکوس چه کمکی میکند؟
در یک شاخص معکوس، برای هر ویژگی فعال، فهرستی از اسنادی که آن ویژگی را دارند نگه داشته میشود.
برای مثال، میتوان فهمید کدام اسناد در موقعیت شماره ۲۴۰ وزن غیرصفر دارند. هنگام دریافت پرسش، موتور از موقعیتهای فعال آن برای یافتن اسناد قابلامتیازدهی استفاده میکند.
این ساختار یکی از دلایل توجه به نمایشهای پراکنده در بازیابی اطلاعات است.
بااینحال، تعداد موقعیتهای فعال اهمیت دارد. اگر گسترش نمایش بسیار زیاد شود، فهرستهای بیشتری باید خوانده و پردازش شوند. پراکندهبودن خروجی، بهتنهایی تضمین سرعت بالا نیست.
آموزش عملی SPLADE باFastEmbed
در این مثال از مدل prithivida/Splade_PP_en_v1 استفاده میکنیم. این مدل در مستندات رسمی FastEmbed بهعنوان پیادهسازی SPLADE++ برای انگلیسی معرفی شده است. Qdrant
بنابراین مثال انگلیسی است. برای فارسی باید مدل و کیفیت آن جداگانه بررسی شوند.
نصب کتابخانهها
pip install fastembed "qdrant-client>=1.14.2"تعریف مدل و اسناد
from fastembed import SparseTextEmbedding


encoder = SparseTextEmbedding(
    model_name="prithivida/Splade_PP_en_v1",
)

documents = [
    {
        "id": 0,
        "title": "Refund",
        "text": (
            "A refund returns the payment to the customer "
            "after an eligible order cancellation."
        ),
    },
    {
        "id": 1,
        "title": "Shipping",
        "text": (
            "Track the shipment using the tracking number "
            "provided after dispatch."
        ),
    },
    {
        "id": 2,
        "title": "Invoice",
        "text": (
            "Download the purchase invoice from "
            "the billing section of your account."
        ),
    },
    {
        "id": 3,
        "title": "Password reset",
        "text": (
            "Use the password reset page if you "
            "cannot sign in to your account."
        ),
    },
]

document_embeddings = list(
    encoder.embed(
        [item["text"] for item in documents],
        batch_size=4,
    )
)

query_text = "How can I get my money back after cancellation?"

query_embedding = list(
    encoder.query_embed(query_text)
)[0]
در اولین اجرا، فایل مدل دانلود میشود.
خروجی هر متن شامل indices و values است. این دو آرایه باید متناظر باشند: هر شناسه، وزن همان موقعیت را دارد.
مشاهده اندازه نمایشها
for document, embedding in zip(
    documents,
    document_embeddings,
):
    print(
        document["title"],
        "active_features=",
        len(embedding.indices),
    )
تعداد ویژگیهای فعال میتواند میان متنها متفاوت باشد.
برای برآورد هزینه واقعی، توزیع این تعداد را روی نمونهای نماینده از اسناد اندازه بگیرید؛ میانگین بهتنهایی ممکن است اسناد پرهزینه را پنهان کند.
رتبهبندی اولیه بدون پایگاه داده
برای مثال کوچک، خروجی مدل را به دیکشنری تبدیل میکنیم:
def to_sparse_dict(embedding):
    return {
        int(index): float(value)
        for index, value in zip(
            embedding.indices,
            embedding.values,
        )
    }


query_vector = to_sparse_dict(query_embedding)

ranked = []

for document, embedding in zip(
    documents,
    document_embeddings,
):
    score = sparse_dot(
        query_vector,
        to_sparse_dict(embedding),
    )

    ranked.append({
        "id": document["id"],
        "title": document["title"],
        "score": score,
    })

ranked.sort(
    key=lambda item: item["score"],
    reverse=True,
)

for item in ranked:
    print(
        item["title"],
        round(item["score"], 4),
    )
امتیازها و ترتیب واقعی را باید پس از اجرای مدل مشاهده کنید. در این مقاله، خروجی مدل از پیش فرض نشده است.
این حلقه برای آموزش مناسب است؛ طراحی استقرار برای مجموعه بزرگ به شاخص، پردازش دستهای و اندازهگیری نیاز دارد.
ذخیره و جستوجو درQdrant
Qdrantاز بردارهای پراکنده با شناسهها و وزنها پشتیبانی میکند. Qdrant
برای آزمایش از حالت حافظهای استفاده میکنیم:
from qdrant_client import QdrantClient, models


database = QdrantClient(":memory:")
collection_name = "splade_demo"

database.create_collection(
    collection_name=collection_name,
    vectors_config={},
    sparse_vectors_config={
        "splade": models.SparseVectorParams(),
    },
)

database.upsert(
    collection_name=collection_name,
    points=[
        models.PointStruct(
            id=document["id"],
            payload={
                "title": document["title"],
                "text": document["text"],
            },
            vector={
                "splade": models.SparseVector(
                    indices=embedding.indices.tolist(),
                    values=embedding.values.tolist(),
                ),
            },
        )
        for document, embedding in zip(
            documents,
            document_embeddings,
        )
    ],
)

response = database.query_points(
    collection_name=collection_name,
    query=models.SparseVector(
        indices=query_embedding.indices.tolist(),
        values=query_embedding.values.tolist(),
    ),
    using="splade",
    limit=3,
    with_payload=True,
)

for point in response.points:
    print(
        point.id,
        round(point.score, 4),
        point.payload["title"],
    )
این کد ادامه بخشهای قبلی است. داده حالت حافظهای با پایان برنامه پایدار نمیماند.
در استقرار واقعی، نسخه مدل و پردازش باید همراه شاخص ثبت شوند. برابر بودن شناسه عددی یک توکن در دو مدل متفاوت، به معنای برابر بودن معنای آن نیست.
ترکیب SPLADE با جستوجوی متراکم
یک طراحی قابلآزمایش این است که دو جستوجو مستقل انجام شوند:
- جستوجو با بردار پراکنده؛
- جستوجو با بردار متراکم.
سپس فهرست نتایج ادغام شود.
امتیاز خام این دو مسیر معمولاً مقیاس یکسانی ندارد. بنابراین جمع مستقیم آنها بدون تنظیم و ارزیابی ممکن است یک مسیر را غالب کند.
Reciprocal Rank Fusion یا RRF یکی از روشهای ادغام مبتنی بر رتبه است. Qdrant این روش را در مستندات جستوجوی ترکیبی ارائه میکند. Qdrant
مثال ساده ادغام رتبهها
در کد زیر، فهرستها ساختگیاند و نتیجه اجرای مدل نیستند:
def reciprocal_rank_fusion(rankings, constant=60):
    if constant <= 0:
        raise ValueError("constant must be positive.")

    scores = {}

    for ranking in rankings:
        seen = set()

        for rank, document_id in enumerate(
            ranking,
            start=1,
        ):
            if document_id in seen:
                continue

            seen.add(document_id)

            scores[document_id] = (
                scores.get(document_id, 0.0)
                + 1.0 / (constant + rank)
            )

    return sorted(
        scores.items(),
        key=lambda item: item[1],
        reverse=True,
    )


sparse_ranking = [0, 2, 1]
dense_ranking = [2, 0, 3]

print(
    reciprocal_rank_fusion([
        sparse_ranking,
        dense_ranking,
    ])
)
RRFاز جایگاه نتیجه استفاده میکند و نیازی به برابر بودن مقیاس امتیازهای دو مدل ندارد.
اما تعداد نامزدها و تنظیمات ادغام همچنان باید ارزیابی شوند. اگر سند درست در هیچیک از فهرستها نباشد، ادغام آن را پیدا نمیکند.
تفاوت SPLADE، SPLADE v2 وSPLADE++
SPLADEیک خانواده پژوهشی است و مدلهای آن الزاماً تنظیمات یکسان ندارند.
مقاله SPLADE v2 نسخه تکاملیافتهای از روش را ارائه میکند. پژوهش From Distillation to Hard Negative Sampling نیز نقش تقطیر و نمونههای منفی دشوار را در بهبود بازیابی عصبی پراکنده بررسی میکند. arxiv.org
نمونه منفی دشوار، سندی است که به پرسش نزدیک به نظر میرسد اما پاسخ درست را ندارد.
برای مثال:
- پرسش: «بازگشت وجه پس از لغو سفارش»
- سند مرتبط: شرایط استرداد مبلغ سفارش لغوشده
- سند دشوار اما نامرتبط: شرایط تغییر آدرس سفارش ارسالشده
هنگام انتخاب مدل، تنها نام SPLADE را کافی ندانید. زبان، داده آموزش، محدودیت ورودی، مجوز و روش ارزیابی همان Checkpoint را بررسی کنید.
SPLADE در سامانه RAGچه نقشی دارد؟
در RAG، ابتدا اسناد بازیابی میشوند و سپس مدل زبانی با استفاده از آنها پاسخ میسازد.
SPLADEمیتواند یکی از بازیابهای این معماری باشد. برای مثال، در کنار یک مدل متراکم، نامزدها را پیدا کند و نتایج ادغامشده وارد مرحله بازرتبهبندی شوند.
اما بهبود بازیابی باید از بهبود تولید پاسخ جدا سنجیده شود.
دو پرسش مستقل دارید:
- آیا سند پاسخگو در نتایج وجود دارد؟
- آیا مدل پاسخدهنده از آن سند درست استفاده میکند؟
اگر سند درست بازیابی شده باشد ولی پاسخ نهایی شرط مهمی را حذف کند، تغییر بازیاب لزوماً مشکل را حل نمیکند.
برای هر قطعه، شناسه و منبع را نگه دارید تا بتوان مسیر پاسخ را بررسی کرد.
استفاده از SPLADE برای فارسی
مدل انگلیسی مثال را نباید بدون ارزیابی بهعنوان بازیاب فارسی انتخاب کرد.
برای پروژه فارسی، سه مسئله را جدا بررسی کنید:
- آیا واژگان و رمزگذار برای فارسی مناسباند؟
- آیا مدل برای بازیابی فارسی آموزش یا ارزیابی شده است؟
- آیا روی اسناد واقعی شما نتیجه مناسبی دارد؟
مجموعه ارزیابی پیشنهادی
| گروه | نمونه |
|---|---|
| مترادف و بیان متفاوت | «برگشت پول» و «استرداد وجه» |
| محاورهای | «چرا پولم برنگشته؟» |
| ترکیبی | «خطای timeout هنگام پرداخت» |
| نام دقیق | نام محصول یا مدل |
| عدد و نسخه | «نسخه ۲٫۱» در برابر «نسخه ۲٫۲» |
| شرط و نفی | «لغو سفارش بدون کسر هزینه» |
برای هر پرسش، اسناد نزدیک اما نادرست نیز تهیه کنید. وجود یک سند واضح در میان چند متن کاملاً نامرتبط، آزمایش دشواری نیست.
پیشپردازش کنترلشده
یکسانسازی نویسهها و فاصلهها را مستند کنید، اما نامها و شناسهها را خراب نکنید.
حذف علامتها ممکن است عبارتی مانند C++، نسخه محصول یا کد خطا را تغییر دهد.
متن اصلی را برای نمایش و ارجاع نگه دارید و نسخه پردازششده را جداگانه بسازید.
گسترش واژگان چه محدودیتهایی دارد؟
نزدیککردن مفهومهای متفاوت
گسترش میتواند ارتباط مفید ایجاد کند، اما ممکن است دو موضوع نزدیک با کاربرد متفاوت را نیز به هم نزدیک کند.
رعایتنکردن شرط دقیق
اشتراک موضوعی، اثبات رعایت شرط نیست. عبارت «دارای GPU» با «بدون GPU» باید در ارزیابی جدا بررسی شود.
وابستگی به دامنه
مدلی که روی متن عمومی مناسب است، ممکن است روی اصطلاحات تخصصی سازمان نتیجه ضعیفتری داشته باشد.
محدودیت متن ورودی
اگر بخش تعیینکننده سند هنگام پردازش قطع شود، نمایش نمیتواند آن اطلاعات حذفشده را بازیابی کند.
تفسیرپذیری محدود
مشاهده توکنهای فعال به بررسی رفتار کمک میکند، اما توضیح کامل فرایند تصمیمگیری شبکه نیست.
آیا حذف وزنهای کوچک ایده خوبی است؟
میتوان برای کاهش تعداد ویژگیها، وزنهای کوچک را حذف کرد. اما این کار مدل و شاخص را وارد تنظیم جدیدی میکند که باید ارزیابی شود.
یک وزن کوچک ممکن است برای تطبیق یک عبارت کمتکرار اهمیت داشته باشد.
همچنین آستانه مناسب پرسش و سند الزاماً یکسان نیست.
برای آزمایش، چند تنظیم محدود را روی Validation مقایسه کنید و موارد زیر را ثبت کنید:
- تعداد ویژگیهای فعال؛
- حجم شاخص؛
- زمان بازیابی؛
- پوشش اسناد مرتبط؛
- کیفیت رتبههای اول.
کاهش تعداد ویژگیها را فقط زمانی بپذیرید که افت کیفیت آن برای کاربرد قابلقبول باشد.
چگونه SPLADE را ارزیابی کنیم؟
یک مقایسه پیشنهادی شامل این مسیرهاست:
- BM25با پردازش مناسب؛
- جستوجوی متراکم؛
- SPLADE؛
- ترکیب SPLADE و جستوجوی متراکم؛
- ترکیب به همراه بازرتبهبندی.
همه مسیرها باید روی مجموعه اسناد و پرسشهای یکسان آزمایش شوند.
| معیار | کاربرد |
|---|---|
| Recall@K | پوشش اسناد مرتبط |
| MRR | رتبه اولین نتیجه مرتبط |
| nDCG@K | کیفیت ترتیب با درجات ارتباط |
| تأخیر صدک ۹۵ | رفتار درخواستهای کند |
| زمان رمزگذاری پرسش | هزینه اجرای مدل |
| حجم شاخص | هزینه نگهداری |
| تعداد ویژگیهای فعال | میزان پراکندگی |
| کیفیت پاسخ RAG | اثر بر کاربرد نهایی |
سرعت رمزگذاری، جستوجو و تولید پاسخ را جدا اندازه بگیرید.
همچنین نتیجه را به تفکیک نوع پرسش گزارش کنید. میانگین مناسب ممکن است ضعف در نام محصول یا کد خطا را پنهان کند.
اشتباهات رایج
فرض اینکه Sparse یعنی بدون مدل
نمایش پراکنده است، اما تولید آن در SPLADE همچنان به رمزگذار عصبی نیاز دارد.
نرمالسازی خودکار خروجی
هر روش جستوجو نیازمند نرمالسازی یکسان نیست. وزنهای مدل را بدون بررسی دستور آن تغییر ندهید.
افزودن IDF بدون بررسی
یک تنظیم مناسب برای BM25 الزاماً برای وزنهای آموختهشده SPLADE مناسب نیست.
جمع مستقیم امتیازهای متفاوت
مقیاس امتیاز بازیاب پراکنده و متراکم ممکن است متفاوت باشد. روش ادغام را ارزیابی کنید.
تغییر مدل بدون بازسازی نمایشها
مدل جدید میتواند وزنها یا واژگان متفاوتی داشته باشد. سازگاری را از روی شکل خروجی فرض نکنید.
استفاده از امتیاز بهعنوان احتمال
امتیاز خام تطبیق، درصد اطمینان نیست.
جایگزینی BM25 بدون مقایسه
یک Baseline واژگانی مناسب بسازید و هزینه اجرای مدل جدید را نیز در تصمیم لحاظ کنید.
پرسشهای متداول
SPLADEچیست؟
روشی برای بازیابی عصبی است که پرسش و سند را به نمایشهای پراکنده و وزندار در فضای واژگان مدل تبدیل میکند.
Sparse Embeddingچیست؟
نمایشی است که بسیاری از موقعیتهای آن صفرند و میتوان فقط شناسهها و وزنهای فعال را ذخیره کرد.
آیا SPLADE فقط تطبیق دقیق واژه است؟
خیر. گسترش نمایش میتواند تطبیق میان عبارتهای متفاوت اما مرتبط را ممکن کند.
آیا SPLADE همیشه بهتر از BM25 است؟
خیر. کیفیت و هزینه باید روی داده واقعی مقایسه شوند.
آیا میتوان SPLADE و Dense Embedding را ترکیب کرد؟
بله. ادغام نتایج دو مسیر یکی از طراحیهای قابلآزمایش است.
آیا مدل مثال برای فارسی مناسب است؟
مدل مثال برای انگلیسی معرفی شده است. استفاده فارسی نیازمند انتخاب و ارزیابی مستقل است.
آیا SPLADE پاسخ تولید میکند؟
خیر. اسناد را بازیابی یا رتبهبندی میکند؛ تولید پاسخ وظیفه مرحله دیگری است.
آیا امتیاز آن درصد اطمینان است؟
خیر. امتیاز خام رتبهبندی را نباید احتمال دانست.
آیا برای مثال سرور Qdrant لازم است؟
خیر. نمونه از حالت حافظهای Qdrant Client استفاده میکند.
جمعبندی
SPLADEنمایش واژگانی پراکنده را با یادگیری عصبی و گسترش واژگان ترکیب میکند.
این روش میتواند برای آزمایش خطاهای ناشی از تفاوت بیان کاربر و سند مفید باشد. بااینحال، کیفیت زبان، هزینه رمزگذاری، میزان پراکندگی و رفتار شاخص باید همزمان بررسی شوند.
برای انتخاب عملی، SPLADE را با BM25 و بازیاب متراکم روی داده یکسان مقایسه کنید و اثر آن را بر پاسخ نهایی بسنجید.
اتصال جستوجوی ترکیبی به خدمات درواره
در یک سامانه جستوجو یا دستیار مبتنی بر اسناد، میتوانید بازیابی پراکنده را با ابزارهایی مانند SPLADE اجرا کنید و برای بخش Embedding متراکم یا تولید پاسخ، مدلهای در دسترس درواره را بررسی کنید.
مدل مناسب را بر اساس کیفیت فارسی، محدودیت ورودی و هزینه از مستندات درواره انتخاب کنید. خروجی یک API معمولی Embedding را نیز بدون مستندات، نمایش پراکنده SPLADE فرض نکنید.
یک شروع عملی، مقایسه مسیرهای بازیابی روی پرسشهای واقعی کسبوکار و سپس اتصال بهترین نتایج به مدل پاسخدهنده است.
برای بررسی مدلها و شروع ساخت جستوجوی معنایی یا دستیار هوش مصنوعی، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- Embeddingچیست؟
- جستوجوی ترکیبی با BM25 و بردار برایRAG
- بازرتبهبندی و Cross-Encoder درRAG
- Matryoshka Embeddingو کاهش ابعاد بردارها
- قطعهبندی متن یا Chunking چیست؟
- ارزیابی مدلهای هوش مصنوعی
منابع
- مقاله اصلیSPLADE
- مقالهSPLADE v2
- تقطیر و نمونههای منفی دشوار در بازیابی پراکنده
- مخزن رسمیSPLADE
- آموزش SPLADE باFastEmbed
- کارت مدل مثال
- مستندات بردارهای پراکندهQdrant
- مستندات جستوجوی ترکیبی وRRF
- تنظیمات شباهت و BM25 درElasticsearch
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



