
RoPE چیست؟ آموزش رمزگذاری موقعیت در Transformer با PyTorch
RoPE چیست و مدل زبانی چگونه ترتیب توکنها را تشخیص میدهد؟ در این آموزش، رمزگذاری موقعیت، تفاوت موقعیت مطلق و نسبی، نقش RoPE در Attention، محدودیت افزایش Context و پیادهسازی آموزشی با PyTorchرا بررسی میکنیم.

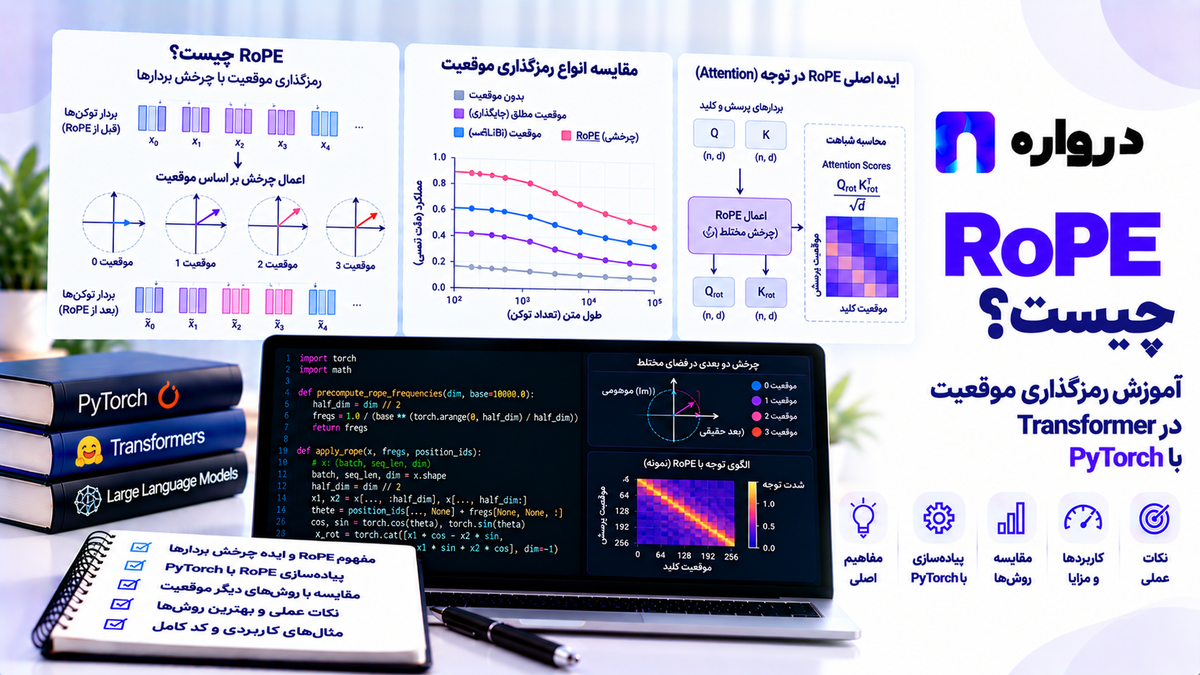
RoPE مخفف Rotary Position Embedding و یکی از روشهای واردکردن اطلاعات موقعیت توکنها به سازوکار Attention است. در این روش، بخشهایی از بردارهای Query و Key متناسب با موقعیت توکن چرخانده میشوند.
این چرخش به مدل امکان میدهد در محاسبه ارتباط میان توکنها، اطلاعات فاصله موقعیتی آنها را نیز لحاظ کند. RoPE یکی از اجزای معماری برخی مدلهای زبانی است و در بحث طول زمینه، اجرای مدل و مدیریت KV Cache اهمیت دارد.
برای فهم مسئله، این دو جمله را مقایسه کنید:
«علی از رضا کمک گرفت.»
«رضا از علی کمک گرفت.»
واژهها تقریباً یکساناند، اما جابهجایی آنها معنا را تغییر داده است. مدل باید علاوه بر محتوای توکنها، به ترتیب و جایگاه آنها نیز دسترسی داشته باشد.
در این مقاله، بدون استفاده از فرمولهای ریاضی در متن، بررسی میکنیم که اطلاعات موقعیت چگونه وارد Transformer میشود و سپس یک نمونه RoPE را با PyTorch پیادهسازی میکنیم.
چرا Transformer به اطلاعات موقعیت نیاز دارد؟
در Attention، نمایش توکنها با یکدیگر مقایسه میشود تا سهم اطلاعات هر موقعیت در خروجی مشخص شود.
اگر سازوکار Attention هیچ اطلاعاتی درباره موقعیت دریافت نکند و ماسک یا ساختار دیگری نیز ترتیب را مشخص نکند، از محتوای ورودی بهتنهایی نمیتواند همه تفاوتهای ناشی از جایگاه توکنها را تشخیص دهد.
به همین دلیل، معماری اصلی Transformer از Positional Encoding برای افزودن اطلاعات موقعیت استفاده میکند. مقاله «Attention Is All You Need» این بخش را در کنار نمایش محتوای توکنها معرفی کرده است. arxiv.org
در مدلهای مولد، ماسک علّی نیز ترتیب دسترسی را محدود میکند؛ اما این ماسک و رمزگذاری موقعیت دو جزء متفاوتاند.
Positional Encodingچیست؟
Positional Encoding یا رمزگذاری موقعیت روشی برای معرفی جایگاه توکنها به مدل است.
مدل ممکن است بداند یک واژه چه معنایی دارد، اما برای فهم جمله باید رابطه آن را با موقعیتهای دیگر نیز در نظر بگیرد. اطلاعات موقعیت میتواند به چند شکل وارد مدل شود:
- افزودن بردار موقعیت به نمایش توکن
- تغییر امتیاز Attention بر اساس فاصله موقعیتها
- تبدیل Query و Key بر اساس موقعیت
- استفاده از طراحیهای دیگری که ترتیب را در محاسبات وارد میکنند
RoPE در گروه روشهایی قرار میگیرد که اطلاعات موقعیت را از طریق تغییر Query و Key وارد Attentionمیکنند.
موقعیت مطلق و موقعیت نسبی چه تفاوتی دارند؟
موقعیت مطلق به جایگاه یک توکن در دنباله اشاره میکند؛ مثلاً توکن شماره ۵ یا شماره۲۰.
موقعیت نسبی به رابطه میان دو جایگاه اشاره دارد؛ مثلاً اینکه یک توکن سه موقعیت پیش از توکن دیگر قرار گرفته است.
| مفهوم | پرسش مرتبط | مثال |
|---|---|---|
| موقعیت مطلق | این توکن کجای دنباله است؟ | موقعیت ۱۲ |
| موقعیت نسبی | فاصله این توکن تا توکن دیگر چقدر است؟ | چهار موقعیت جلوتر |
| ماسک علّی | کدام موقعیتها اجازه مشارکت دارند؟ | توکنهای آینده مجاز نیستند |
روشهای مختلف ممکن است این اطلاعات را به شکلهای متفاوتی ترکیب کنند. در RoPE، هر بردار با موقعیت خودش تبدیل میشود، اما مقایسه بردارهای تبدیلشده ساختاری وابسته به اختلاف موقعیتها ایجاد میکند.
رمزگذاری موقعیت سینوسی چیست؟
در معماری اولیه Transformer، از الگوهای سینوسی برای ساخت اطلاعات موقعیت استفاده شده است. این بردارهای موقعیت به نمایش ورودی توکنها اضافه میشوند.
ایده آن است که موقعیتهای مختلف، الگوهای عددی متمایزی داشته باشند تا مدل بتواند در پردازش دنباله از آنها استفاده کند. این روش یک انتخاب معماری مشخص است؛ همه مدلهای Transformer از همین روش استفاده نمیکنند. arxiv.org
RoPEنیز از ساختارهای چرخشی مبتنی بر سینوس و کسینوس استفاده میکند، اما نحوه اعمال آن با افزودن بردار موقعیت به ورودی متفاوت است.
Learned Position Embeddingچیست؟
در نمایش موقعیت قابلآموزش، بردارهای مرتبط با موقعیتها طی آموزش یاد گرفته میشوند.
این روش به مدل اجازه میدهد نمایش موقعیت را با داده آموزشی تنظیم کند. در مقابل، استفاده از موقعیتهایی خارج از محدوده تعریفشده نیازمند بررسی طراحی و تنظیمات همان مدل است.
نام «قابلآموزش» به معنی برتری عمومی آن بر روشهای دیگر نیست. نتیجه به داده، معماری و هدف مدل بستگی دارد.
RoPEچگونه کار میکند؟
در یک پیادهسازی متداول RoPE، مؤلفههای Query و Key به جفتهای دوبعدی تقسیم میشوند. هر جفت، بر اساس موقعیت توکن و فرکانس مربوط به آن جفت، چرخانده میشود.
جفتهای مختلف با سرعتهای متفاوتی میچرخند. بنابراین تغییر موقعیت در بخشهای مختلف بردار اثر متفاوتی دارد.
وقتی Query و Key پس از این تبدیل با یکدیگر مقایسه میشوند، اثر اختلاف موقعیتها در امتیاز Attention ظاهر میشود.
مقاله RoFormer این روش را معرفی میکند و مستندات رسمی آن در Transformers نیز اعمال چرخش دوبعدی برای معرفی موقعیت را توضیح میدهد. arxiv.org
آیا RoPE به بردار توکن اضافه میشود؟
در شکل رایج مورد بحث، RoPE مستقیماً به Query و Key اعمال میشود. این روش با افزودن یک بردار موقعیت به Embedding ورودی تفاوت دارد.
این تمایز مهم است، چون جای اعمال اطلاعات موقعیت در مسیر محاسبات تغییر میکند. هنگام خواندن کد مدل باید بررسی کنید:
- RoPE به کدام Tensorها اعمال میشود؟
- تمام مؤلفههای هر سر تغییر میکنند یا فقط بخشی از آنها؟
- جفتبندی مؤلفهها چگونه است؟
- فرکانسها و تنظیمات موقعیت چگونه ساخته میشوند؟
دو پیادهسازی ممکن است از نظر مفهوم مشابه باشند، اما چینش مؤلفههایشان متفاوت باشد. انتقال وزن یا جایگزینی کد باید با قرارداد همان مدل سازگار باشد.
آیا RoPE به Value هم اعمال میشود؟
در بسیاری از پیادهسازیهای رایج، RoPE روی Query و Key اعمال میشود و Value همان تبدیل را دریافت نمیکند.
اما هنگام کار با مدل مشخص، پیادهسازی همان مدل را مبنا قرار دهید. وجود واژه RoPE در توضیح معماری، همه جزئیات مسیر اجرا را مشخص نمیکند.
در مثال آموزشی این مقاله نیز فقط Query و Key را میچرخانیم.
چرا چرخش مفید است؟
چرخش دوبعدی یک ویژگی کاربردی دارد: در محاسبه دقیق، اندازه بردار را حفظ میکند و جهت آن را تغییر میدهد.
در RoPE، از این تغییر جهت برای واردکردن موقعیت استفاده میشود. اگر دو بردار پایه ثابت را در موقعیتهای مختلف بچرخانیم، مقایسه آنها از فاصله موقعیتها اثر میگیرد.
این توضیح درباره سازوکار یک لایه است. نباید از آن نتیجه گرفت خروجی کامل مدل فقط تابع فاصله توکنهاست؛ محتوای ورودی، لایههای قبلی، ماسک و دیگر اجزا نیز نقش دارند.
مقایسه روشهای معرفی موقعیت
| روش | نحوه ورود موقعیت | نکته اصلی |
|---|---|---|
| موقعیت سینوسی افزودهشده | افزودن بردار موقعیت به نمایش ورودی | روش معرفیشده در Transformer اولیه |
| موقعیت قابلآموزش | یادگیری بردارهای موقعیت | وابسته به طراحی و دامنه موقعیتهای مدل |
| سوگیری موقعیت نسبی | تغییر امتیاز Attention بر اساس فاصله | رابطه موقعیتها را در امتیاز وارد میکند |
| RoPE | چرخاندن Query و Key | مقایسه بردارها از اختلاف موقعیت اثر میگیرد |
این جدول مقایسه مفهومی است. هر خانواده میتواند پیادهسازیها و تنظیمات متعددی داشته باشد.
RoPE چه ارتباطی با Context Windowدارد؟
Context Window ظرفیت دنبالهای است که مدل و مسیر اجرای آن پشتیبانی میکنند. روش معرفی موقعیت یکی از عوامل مؤثر در رفتار مدل روی طولهای مختلف است.
اما افزایش طول ورودی فقط مسئله موقعیت نیست. عوامل دیگر نیز اهمیت دارند:
- طول دنبالههای استفادهشده در آموزش
- کیفیت آموزش روی متنهای بلند
- حافظه و محاسباتAttention
- حافظهKV Cache
- محدودیت موتور استنتاج
- محدودیت ورودی و خروجی سرویس
- توانایی واقعی مدل در استفاده از اطلاعات دوردست
بنابراین وجود RoPE بهتنهایی تضمین نمیکند مدل روی هر طولی پاسخ قابل اعتماد بدهد.
RoPE Scalingچیست؟
RoPE Scaling نام کلی روشهایی است که نگاشت موقعیتها یا فرکانسهای RoPE را برای کار با طولهای متفاوت تغییر میدهند.
این روشها یکسان نیستند. مستندات Transformers گونههایی مانند Linear، Dynamic، YaRN و LongRoPE را معرفی میکند که هرکدام تنظیمات و قواعد مشخصی دارند. Hugging Face
تغییر تنظیمات باید با معماری، نسخه کتابخانه و روش توصیهشده برای مدل هماهنگ باشد. افزایش یک عدد در فایل پیکربندی، بهتنهایی اثبات نمیکند کیفیت مدل در زمینه بلند حفظ شده است.
آیا میتوان طول زمینه را فقط با تغییر RoPE افزایش داد؟
در بعضی روشها، تغییر RoPE بخشی از راهبرد گسترش طول زمینه است. برخی رویکردها به آموزش تکمیلی نیاز دارند و برخی تحت شرایط مشخص با تغییرات زمان اجرا آزمایش میشوند.
پژوهش YaRN، برای نمونه، یک روش مشخص برای گسترش زمینه مدلهای دارای RoPE ارائه میکند. نتیجه آن مربوط به مدلها، تنظیمات و ارزیابیهای همان پژوهش است. arxiv.org
برای استفاده عملی باید دو پرسش را جدا بررسی کنید:
- آیا مدل از نظر فنی ورودی بلندتر را میپذیرد؟
- آیا پاسخ آن روی این ورودیها همچنان کیفیت موردنیاز را دارد؟
پذیرفتهشدن درخواست، پاسخ پرسش دوم نیست.
RoPE چه ارتباطی با KV Cacheدارد؟
در تولید خودبازگشتی، Key و Value توکنهای گذشته معمولاً در کش نگهداری میشوند.
وقتی موقعیت در Key وارد شده است، موقعیت توکن بخشی از وضعیت محاسباتی مرتبط با آن میشود. بنابراین ادامه تولید باید با موقعیتهای درست و قرارداد کش مدل انجام شود.
برای مثال، اگر یک دنباله ۱۰۰ توکن پردازششده دارد، موقعیت توکن بعدی را نمیتوان بدون بررسی قرارداد مدل دوباره صفر در نظر گرفت.
در پیادهسازی سفارشی، این موارد اهمیت دارند:
- موقعیت مطلق توکنهای جدید
- جایگاه دادهها در کش
- ماسک توجه به توکنهای قبلی
- روش مدیریت پنجره لغزان
- نحوه اعمال RoPE در مدل مقصد
اگر از موتور آماده استفاده میکنید، این جزئیات معمولاً توسط همان موتور مدیریت میشوند. هنگام نوشتن حلقه تولید اختصاصی، باید آنها را صریح بررسی کنید.
تفاوت RoPE وCausal Mask
RoPE اطلاعات موقعیت را در نمایشهای Attention وارد میکند.
Causal Mask مشخص میکند هر موقعیت به چه موقعیتهایی اجازه توجه دارد. در مدل مولد، معمولاً توکنهای آینده از دسترس خارج میشوند.
این دو جایگزین هم نیستند. یک لایه میتواند هم از RoPE و هم از ماسک علّی استفاده کند.
در کد عملی، هر دو را بهصورت جداگانه خواهید دید.
آموزش عملی RoPE باPyTorch
در ادامه یک پیادهسازی آموزشی میسازیم. این کد:
- روی CPU اجرا میشود.
- به دانلود مدل یا دیتاست نیاز ندارد.
- جفتهای متوالی مؤلفهها را میچرخاند.
- برای آموزش مفهوم مناسب است.
این پیادهسازی را بدون بررسی قرارداد مدل، جایگزین RoPE یک مدل آماده نکنید. مدلها ممکن است چینش مؤلفه، نوع Scaling یا تنظیمات دیگری داشته باشند.
نصب
pip install torchساخت تابع اعمالRoPE
ورودی تابع در این مثال چهار بُعد دارد:
- تعداد نمونههایBatch
- تعداد سرهایAttention
- طول دنباله
- اندازه هر سر
import torchfrom torch import nnfrom torch.nn import functional as Fdef apply_rope( x: torch.Tensor, positions: torch.Tensor, base: float = 10000.0,) -> torch.Tensor: """ x: [batch, heads, sequence, head_dim] positions: [sequence] این مثال مؤلفههای متوالی را جفت میکند. """ if x.ndim != 4: raise ValueError( "Expected a 4D tensor." ) head_dim = x.size(-1) sequence_length = x.size(-2) if head_dim % 2 != 0: raise ValueError( "head_dim must be even." ) if ( positions.ndim != 1 or positions.numel() != sequence_length ): raise ValueError(فرکانسها در این مثال با float32 ساخته میشوند. برای مدلهای واقعی، دقت محاسبه فرکانس و طول موقعیتها باید متناسب با نیاز و پیادهسازی بررسی شود.
مشاهده خروجی تابع
torch.manual_seed(42)query = torch.randn( 1, 2, 6, 8,)positions = torch.arange( 6)rotated_query = apply_rope( query, positions,)print( "Input shape:", tuple(query.shape),)print( "Output shape:", tuple(rotated_query.shape),)print( "Position zero unchanged:", torch.allclose( query[:, :, 0], rotated_query[:, :, 0], ),)در این پیادهسازی، موقعیت صفر زاویه صفر دارد؛ بنابراین بردار آن موقعیت تغییر نمیکند. این یک بررسی ساده برای درستی رفتار تابع است.
بررسی حفظ اندازه بردار
چرخش استاندارد باید اندازه بردار را، در محدوده خطای عددی، حفظ کند:
original_norms = ( query.norm(dim=-1))rotated_norms = ( rotated_query.norm(dim=-1))print( "Norms preserved:", torch.allclose( original_norms, rotated_norms, atol=1e-5, rtol=1e-5, ),)print( "Maximum norm difference:", ( original_norms - rotated_norms ) .abs() .max() .item(),)اگر اختلاف زیاد باشد، جفتبندی مؤلفهها، علامتها و شکل Tensorها را بررسی کنید.
این ویژگی مربوط به چرخش استاندارد نمونه ماست. گونههایی که تبدیل یا مقیاسدهی اضافی دارند باید با قرارداد خودشان آزموده شوند.
بررسی اثر موقعیت نسبی
برای دیدن یک ویژگی مهم RoPE استاندارد، Query و Key پایه را ثابت نگه میداریم و همه موقعیتها را به یک اندازه جابهجا میکنیم.
key = torch.randn_like(
    query
)

original_positions = (
    torch.arange(6)
)

shifted_positions = (
    original_positions
    + 10
)

query_original = apply_rope(
    query,
    original_positions,
)

key_original = apply_rope(
    key,
    original_positions,
)

query_shifted = apply_rope(
    query,
    shifted_positions,
)

key_shifted = apply_rope(
    key,
    shifted_positions,
)

scores_original = (
    query_original
    @ key_original.transpose(
        -2,
        -1,
    )
)

scores_shifted = (
    query_shifted
    @ key_shifted.transpose(
        -2,
        -1,
    )
)

print(
    "Scores preserved after "
    "a shared position shift:",
    torch.allclose(
        scores_original,
        scores_shifted,
        atol=1e-5,
        rtol=1e-5,
    ),
)

print(
    "Maximum score difference:",
    (
        scores_original
        - scores_shifted
    )
    .abs()
    .max()
    .item(),
)
در این آزمون، محتوای بردارهای پایه تغییر نکرده و اختلاف موقعیتها نیز ثابت مانده است. نزدیکبودن امتیازها، ویژگی چرخش استاندارد را نشان میدهد.
این آزمون ثابت نمیکند پاسخ کامل یک مدل زبانی با جابهجایی دلخواه متن ثابت میماند. در مدل کامل، نمایشهای پایه و دیگر اجزا نیز از متن و مسیر پردازش اثر میگیرند.
ساخت Self-Attention باRoPE
اکنون تابع را داخل یک لایه Attention قرار میدهیم. Query و Key چرخانده میشوند و Value بدون همان چرخش وارد محاسبه میشود.
class RotarySelfAttention(nn.Module):
    def __init__(
        self,
        hidden_size=32,
        num_heads=4,
        dropout=0.0,
    ):
        super().__init__()

        if (
            hidden_size
            % num_heads
            != 0
        ):
            raise ValueError(
                "hidden_size must be divisible "
                "by num_heads."
            )

        self.hidden_size = (
            hidden_size
        )

        self.num_heads = (
            num_heads
        )

        self.head_dim = (
            hidden_size
            // num_heads
        )

        if self.head_dim % 2 != 0:
            raise ValueError(
                "head_dim must be even."
            )

        self.dropout = dropout

        self.qkv_projection = (
            nn.Linear(
                hidden_size,
                3 * hidden_size,
            )
        )

        self.output_projection = (
            nn.Linear(
                hidden_size,
                hidden_size,
            )
        )

    def forward(
        self,
        x,
        position_offset=0,
    ):
        batch_size, sequence_length, _ = (
            x.shape
        )

        qkv = (
            self.qkv_projection(x)
            .reshape(
                batch_size,
                sequence_length,
                3,
                self.num_heads,
                self.head_dim,
            )
            .permute(
                2,
                0,
                3,
                1,
                4,
            )
        )

        query, key, value = (
            qkv.unbind(dim=0)
        )

        positions = (
            torch.arange(
                sequence_length,
                device=x.device,
            )
            + position_offset
        )

        query = apply_rope(
            query,
            positions,
        )

        key = apply_rope(
            key,
            positions,
        )

        attention_output = (
            F.scaled_dot_product_attention(
                query,
                key,
                value,
                is_causal=True,
                dropout_p=(
                    self.dropout
                    if self.training
                    else 0.0
                ),
            )
        )

        attention_output = (
            attention_output
            .transpose(
                1,
                2,
            )
            .contiguous()
            .reshape(
                batch_size,
                sequence_length,
                self.hidden_size,
            )
        )

        return (
            self.output_projection(
                attention_output
            )
        )
این لایه برای یک دنباله کامل با طول برابر Query و Key نوشته شده است. position_offset موقعیت شروع را مشخص میکند، اما بهتنهایی پیادهسازی KV Cache نیست. افزودن کش به مدیریت Key و Value گذشته و ماسک مناسب نیز نیاز دارد.
اجرای لایه و بررسی گرادیان
layer = RotarySelfAttention(
    hidden_size=32,
    num_heads=4,
    dropout=0.0,
)

inputs = torch.randn(
    2,
    12,
    32,
)

outputs = layer(
    inputs
)

print(
    "Output shape:",
    tuple(outputs.shape),
)

loss = (
    outputs.square()
    .mean()
)

loss.backward()

gradient = (
    layer.qkv_projection
    .weight.grad
)

print(
    "Gradient exists:",
    gradient is not None,
)

print(
    "Gradient is finite:",
    torch.isfinite(
        gradient
    ).all().item(),
)
این بررسی نشان میدهد مسیر محاسبه نمونه ما گرادیان دارد. هنوز برای تبدیل آن به یک مدل زبانی، اجزایی مانند Embedding، لایههای Feed-Forward، نرمالسازی، اتصال باقیمانده و هدف آموزشی لازماند.
آیا RoPE برای فارسی طراحی متفاوتی دارد؟
RoPEروی بردارهای داخلی و موقعیت توکنها عمل میکند. قواعد آن مستقیماً به شکل حروف فارسی وابسته نیست.
اما تعداد و ترتیب توکنها به Tokenizer وابسته است. اگر یک عبارت فارسی در Tokenizer مدل به قطعات بیشتری تقسیم شود، موقعیتهای بیشتری در دنباله اشغال میکند.
بنابراین برای بررسی عملکرد فارسی، باید Tokenizer، داده آموزشی و کیفیت مدل را نیز در نظر گرفت. وجود RoPE بهتنهایی نشانه کیفیت مناسب فارسی نیست.
تفاوت RoPE وFlashAttention
| مفهوم | پرسش اصلی |
|---|---|
| RoPE | اطلاعات موقعیت چگونه وارد Query و Key شود؟ |
| FlashAttention | عملیات Attention چگونه کارآمدتر اجرا شود؟ |
| KV Cache | وضعیت توکنهای گذشته چگونه برای ادامه تولید نگه داشته شود؟ |
| Causal Mask | هر موقعیت اجازه توجه به کدام موقعیتها را دارد؟ |
یک مدل میتواند از همه این اجزا استفاده کند. هرکدام نقش مشخصی دارند و جایگزین دیگری نیستند.
چگونه مدل را روی Context بلند ارزیابی کنیم؟
برای بررسی افزایش طول زمینه، تنها یک آزمون پیداکردن عبارت کافی نیست. مجموعه ارزیابی باید با وظیفه محصول هماهنگ باشد.
موارد زیر را بررسی کنید:
- پاسخگویی به پرسشهایی که شواهدشان در ابتدای متن است
- شواهد در میانه و انتهای متن
- ترکیب اطلاعات چند بخش دور از هم
- خلاصهسازی با حفظ نکات مهم
- یافتن تناقض میان بخشها
- رعایت دستور در حضور متن طولانی
- کیفیت فارسی در طولهای مختلف
علاوه بر کیفیت، زمان پاسخ و حافظه را ثبت کنید. ممکن است یک تنظیم، پذیرش ورودی بلندتر را ممکن کند ولی هزینه اجرایی یا افت کیفیت نامناسبی داشته باشد.
خطاهای رایج هنگام پیادهسازیRoPE
جفتبندی متفاوت با مدل مقصد
بعضی پیادهسازیها مؤلفههای متوالی و بعضی چینش دیگری را به کار میبرند. جایگزینی بدون تطبیق میتواند رفتار مدل را تغییر دهد.
استفاده از موقعیت صفر برای هر گام تولید
در تولید با کش، موقعیت توکنهای تازه باید با دنباله و قرارداد مدل هماهنگ باشد.
یکی دانستن RoPE با ماسک علّی
RoPEاطلاعات موقعیت میدهد؛ ماسک دامنه دسترسی را تعیین میکند.
تغییر خودسرانه تنظیماتScaling
نام پارامترها و معنای آنها میان مدلها و نسخهها متفاوت است. تنظیمات مستند همان مدل را مبنا قرار دهید.
بررسی فقط پذیرش ورودی بلند
پذیرش درخواست، کیفیت فهم متن بلند را ثابت نمیکند.
فرض اینکه RoPE هزینه Attention را حذف میکند
RoPE جای روشهای مدیریت حافظه یا کرنلهای بهینه Attentionرا نمیگیرد.
تغییر Tokenizer همزمان با بررسی موقعیت
اگر Tokenizer تغییر کند، دنباله توکنها نیز تغییر میکند و تحلیل اثر RoPE دشوارتر میشود.
پرسشهای متداول
RoPEچیست؟
RoPE روشی برای معرفی موقعیت توکنها به Attention است که با چرخاندن جفت مؤلفههای Query و Keyکار میکند.
Positional Encodingچیست؟
رمزگذاری موقعیت، اطلاعات جایگاه توکنها را در محاسبات مدل وارد میکند تا مدل بتواند از ترتیب دنباله استفاده کند.
آیا RoPE همان موقعیت نسبی است؟
RoPEهر بردار را بر اساس موقعیت خودش تبدیل میکند، اما مقایسه بردارهای تبدیلشده ویژگی وابسته به اختلاف موقعیتها ایجاد میکند.
آیا RoPE یک لایه Attention کامل است؟
خیر. RoPE یکی از تبدیلهای مرتبط با موقعیت در مسیر Attention است. خود Attention به محاسبات و اجزای دیگری نیز نیاز دارد.
آیا RoPE طول Context را نامحدود میکند؟
خیر. معماری، آموزش، حافظه، تنظیمات اجرا و کیفیت مدل محدودیتهای دیگری ایجاد میکنند.
RoPE Scalingچیست؟
خانوادهای از روشها برای تغییر نگاشت موقعیت یا فرکانسهای RoPE با هدف کار در طولهای متفاوت است.
آیا برای استفاده از API باید RoPE را تنظیم کنم؟
معمولاً این تنظیم بخشی از معماری و زیرساخت ارائهدهنده مدل است. کاربر API باید محدودیت زمینه و کیفیت مدل را با درخواستهای واقعی بررسی کند.
آیا کد این مقاله را میتوان روی مدل آماده اعمال کرد؟
فقط پس از تطبیق کامل با قرارداد همان مدل. این کد آموزشی است و همه گونههای RoPE، Scaling و مدیریت کش را پوشش نمیدهد.
جمعبندی
RoPE اطلاعات موقعیت را با چرخاندن بخشهایی از Query و Key وارد Attentionمیکند. این طراحی به مقایسه بردارها ویژگی وابسته به اختلاف موقعیت میدهد و با روش افزودن بردار موقعیت به ورودی تفاوت دارد.
در کد این مقاله، حفظ اندازه بردار، اثر جابهجایی مشترک موقعیتها و استفاده از RoPE در یک لایه Attention بررسی شد. برای مدل واقعی باید چینش مؤلفهها، تنظیمات فرکانس، نوع Scaling و مدیریت KV Cache با معماری مقصد هماهنگ باشند.
اگر هدف شما پردازش اسناد فارسی طولانی است، مدل را با طولها و وظایف واقعی آزمایش کنید. برای بررسی مدلهای در دسترس و اتصال آنها به محصول، به darvareh.ir بروید و گزینهها را از نظر کیفیت پاسخ فارسی، ظرفیت زمینه، زمان پاسخ و هزینه مقایسه کنید.
مقالات مرتبط
- معماری Transformer وSelf-Attention
- Context Windowچیست؟
- مدل زبانی بزرگ یا LLM چیست؟
- تقسیم متن یاChunking
- آموزشPyTorch
- ارزیابی مدلهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- Attention Is All You Need
- مستندات RoFormer درHugging Face Transformers
- مستندات Rotary Embeddings درHugging Face Transformers
- YaRN: Efficient Context Window Extension of Large Language Models
- مستندات Scaled Dot Product Attention درPyTorch
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدل و ابزارهای موردنظر و صفحه سلب مسئولیت درواره را مطالعه کنید.



