
تشخیص فونت از روی عکس با هوش مصنوعی؛ آموزش پیدا کردن اسم فونت فارسی و انگلیسی
چگونه اسم فونت را از روی عکس پیدا کنیم؟ در این راهنما با بهترین سایتهای تشخیص فونت فارسی و انگلیسی آشنا میشوید، روش آمادهسازی تصویر را یاد میگیرید و یک ابزار Font Finder عملی با Python، مدل بینایی و API درواره میسازید.

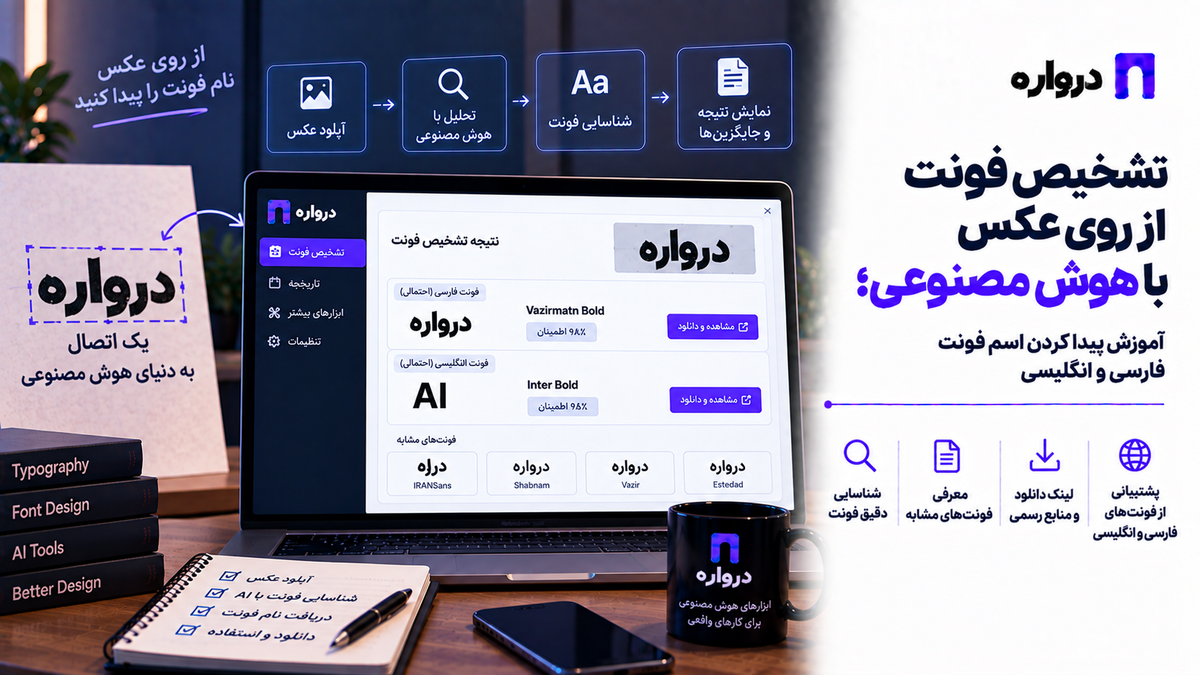
گاهی یک فونت جذاب را در پوستر، لوگو، بنر تبلیغاتی، پست اینستاگرام، رابط کاربری یا تصویر یک وبسایت میبینید، اما نام آن را نمیدانید. بررسی دستی صدها فونت وقتگیر است و شباهت زیاد بعضی فونتها نیز تشخیص را دشوار میکند.
ابزارهای تشخیص فونت از روی عکس با تحلیل فرم حروف، ضخامت، عرض، انحنا و فاصلهگذاری میتوانند فونتهای مشابه را پیدا کنند. ابزارهایی مانند WhatTheFont، Font Squirrel Matcherator و قابلیت Match Font فتوشاپ برای فونتهای لاتین مفید هستند؛ اما تشخیص فونت فارسی بهدلیل پیوستگی حروف و تنوع شکل آنها محدودیتهای بیشتری دارد.
در این مقاله یاد میگیرید:
- چگونه نام فونت را از روی عکس پیدا کنید.
- کدام سایت تشخیص فونت برای هر کاربرد مناسب است.
- چگونه دقت تشخیص فونت فارسی را افزایش دهید.
- تفاوت تشخیص دقیق فونت و پیشنهاد فونت مشابه چیست.
- چگونه با Python و API درواره یک ابزار Font Finder بسازید.
- چگونه نتیجه مدل را به فونتهای موجود در کاتالوگ خود محدود کنید.
- چگونه سرویس تشخیص فونت را به سایت یا اپلیکیشن متصل کنید.
آیا هوش مصنوعی واقعاً میتواند اسم فونت را از روی عکس تشخیص دهد؟
پاسخ کوتاه این است: در بسیاری از تصاویر بله، اما نه همیشه با قطعیت کامل.
یک سامانه تشخیص فونت معمولاً از دو روش استفاده میکند:
- تصویر حروف را با نمونههای موجود در پایگاه داده فونتها مقایسه میکند.
- ویژگیهای ظاهری تایپوگرافی را با مدل بینایی تحلیل میکند.
ابزارهای تخصصی مانند WhatTheFont بیشتر بر مقایسه تصویر با کاتالوگ فونت تکیه دارند. مدلهای چندوجهی نیز میتوانند نوع خط، وزن، ساختار حروف و نزدیکترین گزینهها را تحلیل کنند.
اگر فونت موردنظر در پایگاه داده ابزار وجود نداشته باشد، تغییر داده شده باشد یا تصویر کیفیت کافی نداشته باشد، نتیجه معمولاً یک «فونت مشابه» است، نه تشخیص قطعی فایل اصلی.
تشخیص فونت در چه مواردی کاربرد دارد؟
پیدا کردن فونت از روی عکس برای افراد و تیمهای مختلف کاربرد دارد:
- طراحان گرافیک و رابط کاربری
- مدیران شبکههای اجتماعی
- طراحان سایت
- تدوینگران ویدئو
- آژانسهای تبلیغاتی
- ناشران و صفحهآراها
- فروشگاههای فونت
- تیمهای بازطراحی برند
- توسعهدهندگان قالب و اپلیکیشن
- کاربران علاقهمند به ساخت پوستر و عکسنوشته
برای مثال، ممکن است تصویری از یک بنر قدیمی در اختیار داشته باشید و بخواهید نسخه جدید آن را با همان تایپوگرافی بسازید. ابزار تشخیص فونت میتواند فهرستی از گزینههای مشابه ارائه کند تا زمان جستوجو کاهش یابد.
بهترین سایتهای تشخیص فونت از روی عکس
WhatTheFont
WhatTheFont یکی از شناختهشدهترین ابزارهای پیدا کردن فونت از روی تصویر است. پس از بارگذاری عکس، محدوده متن را انتخاب میکنید و سامانه فونتهای مشابه موجود در کاتالوگ MyFonts را نمایش میدهد.
مزایا:
- رابط کاربری ساده
- پایگاه داده بزرگ فونتهای لاتین
- نمایش نمونههای نزدیک
- امکان رفتن به صفحه خرید یا مشاهده فونت
محدودیتها:
- تمرکز اصلی روی فونتهای لاتین است.
- برای متن فارسی ممکن است نتیجه دقیقی ارائه نکند.
- فونتهای تغییریافته یا طراحیشده برای لوگو سختتر شناسایی میشوند.
Font Squirrel Matcherator
Font Squirrel Matcherator تصویر نوشته را تحلیل و فونتهای مشابه را پیشنهاد میکند. یکی از مزایای Font Squirrel تمرکز آن بر فونتهایی است که بسیاری از آنها مجوز استفاده رایگان یا تجاری مشخصی دارند.
پیش از استفاده تجاری، مجوز دقیق هر فونت را جداگانه بررسی کنید؛ قرارگرفتن یک فونت در سایت به این معنا نیست که هر نوع استفادهای از آن آزاد است.
Match Font در فتوشاپ
فتوشاپ قابلیتی برای تطبیق فونت موجود در تصویر دارد. در این روش ابتدا بخش حاوی نوشته را انتخاب میکنید و سپس از قابلیت Match Font برای دریافت گزینههای نزدیک کمک میگیرید.
این قابلیت زمانی بهتر عمل میکند که:
- نوشته تقریباً افقی باشد.
- حروف اندازه مناسبی داشته باشند.
- پسزمینه ساده باشد.
- متن تار یا کشیده نشده باشد.
- چند حرف متمایز در تصویر وجود داشته باشد.
WhatFontIs
WhatFontIs نیز تصویر را با مجموعه بزرگی از فونتها مقایسه میکند و گزینههای مشابه رایگان و تجاری را نمایش میدهد. برای رسیدن به نتیجه بهتر، لازم است حروف از پسزمینه جدا و کنتراست تصویر مناسب باشد.
Adobe Capture
Adobe Capture برای موبایل طراحی شده است و میتواند از تصاویر محیط، عناصر طراحی مانند رنگ، شکل و تایپوگرافی استخراج کند. این ابزار برای طراحانی مناسب است که میخواهند با دوربین تلفن همراه از روی پوستر یا بستهبندی، گزینههای تایپوگرافی مشابه پیدا کنند.
مقایسه ابزارهای پیدا کردن فونت از روی عکس
| ابزار | مناسب برای | فونت لاتین | فونت فارسی | نوع خروجی |
|---|---|---|---|---|
| WhatTheFont | تشخیص سریع فونت تجاری | بسیار خوب | محدود | نام فونتهای مشابه |
| Font Squirrel Matcherator | جستوجوی فونت با مجوز روشن | خوب | محدود | فونتهای مشابه |
| Photoshop Match Font | کاربران فتوشاپ | خوب | وابسته به فونتهای در دسترس | فونت نصبشده یا مشابه |
| Adobe Capture | تشخیص با موبایل | خوب | محدود | پیشنهادهای تایپوگرافی |
| مدل بینایی هوش مصنوعی | تحلیل سبک و ویژگیهای فونت | خوب | متوسط تا خوب | مشخصات ظاهری و نامزدها |
| سامانه اختصاصی مبتنی بر کاتالوگ | تشخیص میان فونتهای مشخص | بسیار خوب | بسیار خوب | گزینه محدود و کنترلشده |
برای فونت فارسی، بهترین نتیجه معمولاً از ترکیب مدل بینایی با یک کاتالوگ مشخص از فونتهای فارسی به دست میآید.
چگونه از روی عکس فونت را تشخیص دهیم؟
مرحله اول: بخش متن را برش دهید
تمام پوستر یا صفحه را برای ابزار ارسال نکنید. فقط بخش حاوی یک خط واضح از متن را برش دهید.
بهتر است تصویر شامل موارد زیر نباشد:
- لوگو و آیکون
- چند فونت مختلف
- عکس چهره یا محصول
- بافت شلوغ
- سایههای بسیار سنگین
- حروفی که روی هم افتادهاند
مرحله دوم: تصویر را صاف کنید
اگر تصویر با زاویه گرفته شده است، آن را بچرخانید تا خط مبنای متن افقی شود. پرسپکتیو شدید باعث میشود شکل واقعی حروف تغییر کند.
مرحله سوم: کنتراست را افزایش دهید
متن تیره روی پسزمینه روشن یا متن روشن روی پسزمینه تیره معمولاً بهتر تحلیل میشود. در صورت نیاز:
- تصویر را خاکستری کنید.
- روشنایی را تنظیم کنید.
- نویز را کاهش دهید.
- پسزمینه را حذف کنید.
- لبه حروف را واضحتر کنید.
مرحله چهارم: یک کلمه متمایز انتخاب کنید
کلماتی که حروف متنوع دارند، برای تشخیص فونت مناسبترند. تصویری که فقط شامل چند حرف تکراری یا یک واژه بسیار کوتاه باشد، اطلاعات کافی در اختیار مدل قرار نمیدهد.
در متن فارسی وجود حروفی مانند «ک»، «گ»، «ی»، «م»، «س»، «ع» و «ه» در حالتهای مختلف میتواند به مقایسه دقیقتر کمک کند.
مرحله پنجم: چند نتیجه را مقایسه کنید
اولین نتیجه را قطعی در نظر نگیرید. سه تا پنج فونت پیشنهادی را با متن اصلی آزمایش و موارد زیر را مقایسه کنید:
- فرم نقطهها
- کشیدگی حروف
- شکل دندانهها
- ارتفاع حروف
- فاصله بین کلمات
- ضخامت خطوط
- شکل حروف ابتدا و انتهای کلمه
- فرم اعداد فارسی و لاتین
چرا تشخیص فونت فارسی دشوارتر است؟
حروف فارسی بر اساس موقعیت خود در کلمه شکل متفاوتی دارند. یک حرف ممکن است در حالت مستقل، ابتدایی، میانی و انتهایی ظاهر متفاوتی داشته باشد.
عوامل دیگری نیز بر نتیجه اثر میگذارند:
- پیوستهبودن حروف
- استفاده از کشیده
- تغییر فاصله حروف توسط طراح
- ترکیب چند وزن از یک خانواده
- تفاوت شکل اعداد فارسی
- استفاده از فونت دستنویس
- تغییر دستی حروف در لوگو
- کمبود فونت فارسی در پایگاه داده بعضی ابزارها
- تبدیل متن به مسیر برداری و تغییر فرم آن
به همین دلیل، یک مدل ممکن است سبک فونت را درست تشخیص دهد، اما نام دقیق خانواده را اشتباه اعلام کند.
تفاوت تشخیص فونت با تشخیص سبک فونت
این دو مفهوم را نباید یکسان دانست.
تشخیص دقیق فونت
در این حالت سامانه ادعا میکند فایل اصلی احتمالاً فونتی مانند Vazirmatn Bold یا Estedad Medium است. چنین نتیجهای زمانی قابلاعتمادتر است که فونت در مجموعه مرجع سامانه وجود داشته باشد.
تشخیص سبک فونت
در این حالت مدل ویژگیهای کلی را توضیح میدهد:
- سنسریف یا سریف
- هندسی یا دستنویس
- رسمی یا دوستانه
- باریک یا عریض
- ضخیم یا نازک
- مناسب تیتر یا متن طولانی
- مدرن، سنتی یا نمایشی
مدلهای بینایی در تحلیل سبک معمولاً قابلاعتمادتر از حدسزدن نام دقیق فونتی هستند که هرگز در اختیارشان قرار نگرفته است.
بهترین روش تشخیص فونت فارسی
برای فونت فارسی یک فرایند چندمرحلهای نتیجه بهتری ایجاد میکند:
- متن را از تصویر برش دهید.
- با مدل بینایی، نوع خط و ویژگیهای ظاهری را تحلیل کنید.
- نتیجه را به کاتالوگ فونتهای موجود خود محدود کنید.
- همان عبارت را با فونتهای نامزد رندر کنید.
- تصاویر رندرشده را با نمونه اصلی مقایسه کنید.
- نتیجه را با درصد شباهت نمایش دهید.
- انتخاب نهایی را به کاربر بسپارید.
برای نمونه، اگر سایت شما فقط این فونتها را ارائه میکند، مدل نباید نامی خارج از فهرست بسازد:
- Vazirmatn
- Estedad
- Shabnam
- Sahel
- Samim
- Lalezar
- Tanha
- Gandom
این محدودیت احتمال تولید نامهای اشتباه را کاهش میدهد.
ساخت ابزار تشخیص فونت با API درواره
اکنون یک نمونه عملی میسازیم که تصویر را دریافت و ویژگیهای فونت را با یک مدل بینایی تحلیل میکند.
این نمونه:
- تصویر را بررسی و کوچکسازی میکند.
- آن را به Data URL تبدیل میکند.
- فهرست فونتهای مجاز را همراه درخواست میفرستد.
- پاسخ JSON دریافت میکند.
- نتیجه را با Pydantic اعتبارسنجی میکند.
معماری پیشنهادی
کاربر
↓
بارگذاری تصویر نوشته
↓
برش و بهینهسازی تصویر
↓
سرور برنامه
↓
مدل بینایی از طریق API درواره
↓
تحلیل ویژگیهای تایپوگرافی
↓
انتخاب نامزدها از کاتالوگ مجاز
↓
نمایش فونتهای مشابه
کلید API باید فقط در سرور نگهداری شود و نباید در کد JavaScript مرورگر قرار بگیرد.
نصب کتابخانههای لازم
pip install openai pillow pydantic
متغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_VISION_MODEL="YOUR_VISION_MODEL_ID"
شناسه یک مدل دارای قابلیت پردازش تصویر را از فهرست فعلی مدلهای درواره انتخاب کنید.
کد کامل تحلیل فونت از روی تصویر
import base64
import io
import json
import os
from pathlib import Path
from typing import Literal
from openai import OpenAI
from PIL import Image, ImageOps
from pydantic import BaseModel, Field, ValidationError
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_VISION_MODEL"]
ALLOWED_FONTS = [
"Vazirmatn",
"Estedad",
"Shabnam",
"Sahel",
"Samim",
"Lalezar",
"Tanha",
"Gandom",
]
class FontCandidate(BaseModel):
name: str
similarity: int = Field(ge=0, le=100)
reason: str
class FontAnalysis(BaseModel):
detected_text: str
script: Literal["persian_arabic", "latin", "mixed", "unknown"]
category: str
apparent_weight: str
width: str
contrast: str
style_description: str
candidates: list[FontCandidate]
confidence: int = Field(ge=0, le=100)
limitations: list[str]
def prepare_image(image_path: str) -> tuple[str, str]:
path = Path(image_path)
if not path.exists():
raise FileNotFoundError(f"فایل پیدا نشد: {image_path}")
with Image.open(path) as source:
image = ImageOps.exif_transpose(source).convert("RGB")
image.thumbnail((1600, 1600))
output = io.BytesIO()
image.save(output, format="JPEG", quality=88, optimize=True)
encoded = base64.b64encode(output.getvalue()).decode("utf-8")
return "image/jpeg", encoded
def identify_font(image_path: str) -> FontAnalysis:
mime_type, encoded_image = prepare_image(image_path)
allowed_fonts = json.dumps(ALLOWED_FONTS, ensure_ascii=False)
prompt = f"""
تصویر یک نوشته را تحلیل کن.
هدف:
ویژگیهای تایپوگرافی را تشخیص بده و نزدیکترین فونتها را فقط
از فهرست مجاز انتخاب کن.
فهرست فونتهای مجاز:
{allowed_fonts}
قواعد:
- نام فونتی خارج از فهرست مجاز تولید نکن.
- اگر تصویر برای تشخیص کافی نیست، confidence را پایین قرار بده.
- similarity به معنای تخمین شباهت ظاهری است، نه تشخیص قطعی.
- حداکثر 4 نامزد برگردان.
- متن قابل مشاهده را تا حد ممکن استخراج کن.
- درباره مجوز استفاده فونت ادعایی مطرح نکن.
- پاسخ فقط JSON معتبر باشد.
- هیچ Markdown یا توضیحی خارج از JSON ننویس.
ساختار خروجی:
{{
"detected_text": "متن روی تصویر",
"script": "persian_arabic | latin | mixed | unknown",
"category": "دسته ظاهری فونت",
"apparent_weight": "وزن ظاهری",
"width": "عرض تقریبی",
"contrast": "میزان تفاوت ضخامت خطوط",
"style_description": "توضیح کوتاه درباره سبک",
"candidates": [
{{
"name": "نامی از فهرست مجاز",
"similarity": 0,
"reason": "دلیل انتخاب"
}}
],
"confidence": 0,
"limitations": ["محدودیت یا ابهام نتیجه"]
}}
"""
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0.1,
messages=[
{
"role": "system",
"content": (
"شما دستیار تحلیل تایپوگرافی هستید. "
"بین تشخیص قطعی و شباهت ظاهری تفاوت میگذارید "
"و فقط JSON معتبر تولید میکنید."
),
},
{
"role": "user",
"content": [
{
"type": "text",
"text": prompt,
},
{
"type": "image_url",
"image_url": {
"url": (
f"data:{mime_type};base64,"
f"{encoded_image}"
)
},
},
],
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("پاسخی از مدل دریافت نشد.")
try:
result = FontAnalysis.model_validate_json(content)
except ValidationError as error:
raise ValueError(
f"پاسخ مدل ساختار معتبر ندارد: {error}"
) from error
invalid_names = [
candidate.name
for candidate in result.candidates
if candidate.name not in ALLOWED_FONTS
]
if invalid_names:
raise ValueError(
f"مدل فونت خارج از کاتالوگ برگرداند: {invalid_names}"
)
return result
if __name__ == "__main__":
analysis = identify_font("font-sample.jpg")
print(analysis.model_dump_json(indent=2))
نمونه خروجی
{
"detected_text": "فروش ویژه تابستان",
"script": "persian_arabic",
"category": "نمایشی و هندسی",
"apparent_weight": "Bold",
"width": "نسبتاً فشرده",
"contrast": "کم",
"style_description": "فونت تیتر فارسی با خطوط ضخیم و فرمهای هندسی",
"candidates": [
{
"name": "Lalezar",
"similarity": 86,
"reason": "ضخامت بالا و فرم نمایشی حروف به نمونه نزدیک است."
},
{
"name": "Estedad",
"similarity": 68,
"reason": "ساختار هندسی مشابه است، اما نمونه تصویر نمایشیتر است."
}
],
"confidence": 74,
"limitations": [
"بخشی از حروف با افکت سایه پوشانده شده است.",
"نتیجه بیانگر شباهت ظاهری است و نام فونت اصلی را تضمین نمیکند."
]
}
چرا فهرست فونتهای مجاز اهمیت دارد؟
اگر فقط از مدل بپرسید «این چه فونتی است؟»، ممکن است نام یک فونت ناموجود یا بسیار دور از نمونه را اعلام کند. مدل بینایی به پایگاه کامل فایلهای فونت شما دسترسی ندارد.
محدودکردن پاسخ به یک کاتالوگ مشخص چند مزیت دارد:
- نتیجه قابلکنترل است.
- فونتهای پیشنهادی واقعاً در محصول شما وجود دارند.
- امکان نمایش صفحه دانلود یا خرید فراهم میشود.
- میتوان مجوز هر فونت را از قبل ثبت کرد.
- احتمال تولید نام اشتباه کاهش مییابد.
- مقایسه تصویری مرحله بعد سادهتر میشود.
مدل در این معماری نقش «فیلتر هوشمند نامزدها» را دارد، نه مرجع قطعی تشخیص مالکیت یا نام فونت.
تبدیل کد به API برای سایت
با FastAPI میتوانید سرویس را به وبسایت یا اپلیکیشن خود متصل کنید.
ابتدا کتابخانهها را نصب کنید:
pip install fastapi uvicorn python-multipart
نمونه API:
import shutil
import tempfile
from pathlib import Path
from fastapi import FastAPI, File, HTTPException, UploadFile
app = FastAPI(title="Persian Font Finder")
ALLOWED_CONTENT_TYPES = {
"image/jpeg": ".jpg",
"image/png": ".png",
"image/webp": ".webp",
}
@app.post("/identify-font")
async def identify_font_endpoint(
image: UploadFile = File(...),
):
suffix = ALLOWED_CONTENT_TYPES.get(image.content_type or "")
if not suffix:
raise HTTPException(
status_code=415,
detail="فرمت تصویر پشتیبانی نمیشود.",
)
with tempfile.NamedTemporaryFile(
suffix=suffix,
delete=False,
) as temporary_file:
temporary_path = Path(temporary_file.name)
shutil.copyfileobj(image.file, temporary_file)
try:
result = identify_font(str(temporary_path))
return result.model_dump()
except Exception as error:
raise HTTPException(
status_code=422,
detail=str(error),
) from error
finally:
temporary_path.unlink(missing_ok=True)
اجرای سرور:
uvicorn app:app --reload
ارسال درخواست آزمایشی:
curl -X POST \
  -F "image=@font-sample.jpg" \
  http://127.0.0.1:8000/identify-font
در نسخه واقعی بهتر است محدودیت حجم فایل، کنترل تعداد درخواست، ثبت خطا و زمان انقضای فایلهای موقت را نیز اضافه کنید.
چگونه ابزار را دقیقتر کنیم؟
رندر خودکار نامزدها
پس از دریافت چهار نامزد برتر، متن تشخیصدادهشده را با هر فونت رندر کنید. کاربر میتواند نمونه اصلی و گزینهها را کنار هم ببیند.
برای این مرحله میتوانید از Pillow استفاده کنید:
from PIL import Image, ImageDraw, ImageFont


def render_candidate(
    text: str,
    font_path: str,
    output_path: str,
):
    canvas = Image.new("RGB", (1200, 300), "white")
    draw = ImageDraw.Draw(canvas)
    font = ImageFont.truetype(font_path, size=72)

    draw.text(
        (60, 100),
        text,
        fill="black",
        font=font,
        direction="rtl",
    )

    canvas.save(output_path)
برای شکلدهی صحیح فارسی ممکن است به پشتیبانی مناسب موتور رندر و تنظیمات وابسته به محیط اجرا نیاز داشته باشید. پیش از استقرار، خروجی حروف متصل، نیمفاصله و جهت راستبهچپ را آزمایش کنید.
ذخیره ویژگیهای کاتالوگ
برای هر فونت اطلاعات زیر را در پایگاه داده نگه دارید:
| فیلد | نمونه |
|---|---|
| نام خانواده | Estedad |
| وزنهای موجود | 100 تا 900 |
| دسته | هندسی، سنسریف |
| کاربرد | متن، تیتر، رابط کاربری |
| زبان | فارسی، عربی، لاتین |
| نوع مجوز | OFL یا تجاری |
| مسیر فایل | /fonts/estedad.woff2 |
| صفحه معرفی | آدرس صفحه فونت |
| ویژگی ظاهری | خوانا، مدرن، فشرده |
مدل میتواند ابتدا براساس ویژگیها تعداد نامزدها را کاهش دهد و سپس سامانه مقایسه تصویری دقیقتری انجام دهد.
استفاده از Embedding تصویری
برای یک کاتالوگ بزرگ، میتوان از هر فونت چند تصویر نمونه تولید و بردار تصویری آنها را ذخیره کرد. هنگام دریافت تصویر کاربر:
- بخش نوشته استخراج میشود.
- بردار تصویر ساخته میشود.
- نزدیکترین نمونههای کاتالوگ بازیابی میشوند.
- مدل بینایی نامزدهای نهایی را تحلیل میکند.
- کاربر نتیجه را مقایسه میکند.
این روش برای فروشگاه فونت یا سامانه مدیریت هویت بصری مقیاسپذیرتر است.
پرامپت آماده برای تشخیص فونت
اگر میخواهید تصویر را مستقیماً به یک مدل بینایی بدهید، از پرامپتی شبیه نمونه زیر استفاده کنید:
این تصویر شامل یک نوشته فارسی است.
ابتدا ویژگیهای تایپوگرافی آن را تحلیل کن:
- نوع و سبک کلی
- وزن ظاهری
- عرض حروف
- شکل نقاط
- فرم دندانهها
- میزان هندسی یا دستنویس بودن
- کاربرد احتمالی در تیتر یا متن
سپس فقط از فهرست زیر حداکثر 4 فونت مشابه پیشنهاد بده:
Vazirmatn, Estedad, Shabnam, Sahel, Samim, Lalezar
برای هر گزینه:
- درصد تقریبی شباهت
- دلیل شباهت
- مهمترین تفاوت با تصویر
اگر شواهد کافی وجود ندارد، صریحاً اعلام کن.
نام فونت خارج از فهرست نساز.
تشخیص فونت لوگو از روی عکس
تشخیص فونت لوگو دشوارتر از متن معمولی است؛ زیرا لوگوتایپها اغلب از یک فونت پایه شروع میشوند و سپس طراح شکل حروف را تغییر میدهد.
ممکن است تغییرات زیر انجام شده باشد:
- اتصال اختصاصی دو حرف
- حذف یا جابهجایی نقطهها
- تغییر ضخامت بخشی از حرف
- کوتاه یا بلندکردن کشیدهها
- ترکیب چند فونت
- طراحی کامل حروف از ابتدا
- تبدیل حروف به فرم هندسی اختصاصی
در چنین شرایطی باید نتیجه را «فونت پایه احتمالی» یا «فونت مشابه» معرفی کرد. ادعای شناسایی قطعی فونت یک لوگوتایپ اختصاصی معمولاً دقیق نیست.
آیا میتوان فونت فارسی را از روی اسکرینشات سایت پیدا کرد؟
بله، اما پیش از استفاده از ابزار بینایی، یک روش دقیقتر وجود دارد.
اگر متن هنوز در خود صفحه وب قرار دارد:
- روی نوشته کلیک راست کنید.
- گزینه Inspect را انتخاب کنید.
- در DevTools بخش Computed را باز کنید.
- مقدار
font-familyرا بررسی کنید. - در قسمت Rendered Fonts نام فونت واقعاً رندرشده را ببینید.
اگر نوشته بخشی از تصویر، بنر یا ویدئو باشد، این روش کاربرد ندارد و باید از تشخیص تصویری استفاده کنید.
چگونه یک فونت مشابه انتخاب کنیم؟
گاهی پیدا کردن فایل دقیق فونت ممکن نیست، اما یک جایگزین مناسب برای پروژه کافی است. هنگام انتخاب فونت مشابه این ویژگیها را بررسی کنید:
کاربرد
فونتی که برای تیتر تبلیغاتی مناسب است، الزاماً برای مقاله یا رابط کاربری مناسب نیست.
وزن
اگر تصویر از فونت سنگین استفاده کرده است، نسخه Regular یک خانواده مشابه ممکن است حس متفاوتی ایجاد کند.
عرض حروف
فونتهای فشرده فضای کمتری اشغال میکنند. استفاده از فونت عریض میتواند ترکیببندی پوستر را تغییر دهد.
ارتفاع و خط مبنا
ارتفاع حروف و محل قرارگیری آنها نسبت به خط مبنا بر ظاهر کلی نوشته اثر زیادی دارد.
پشتیبانی از نویسهها
بررسی کنید فونت انتخابی از موارد زیر پشتیبانی کند:
- حروف فارسی
- نیمفاصله
- اعداد فارسی
- علائم نگارشی
- حروف عربی موردنیاز
- لاتین
- وزنهای مختلف
مجوز استفاده
رایگانبودن دانلود با مجازبودن استفاده تجاری یکسان نیست. مجوز فونت را از منبع رسمی آن بررسی کنید.
اشتباهات رایج در تشخیص فونت از روی عکس
ارسال کل پوستر
وجود چند نوشته، تصویر و افکت باعث کاهش تمرکز ابزار میشود. فقط یک بخش واضح از متن را ارسال کنید.
استفاده از عکس بسیار کوچک
اگر ارتفاع حروف چند پیکسل باشد، جزئیات لازم برای مقایسه از بین میرود.
اعتماد کامل به اولین نتیجه
خروجی ابزار یک پیشنهاد است. چند فونت را با عبارت اصلی آزمایش کنید.
نادیدهگرفتن وزن فونت
ممکن است خانواده فونت درست باشد، اما وزن آن اشتباه انتخاب شود.
یکیدانستن لوگوتایپ و فونت
بسیاری از لوگوها حروف سفارشی دارند و با تایپ ساده یک فونت بازتولید نمیشوند.
درخواست نام فونت بدون کاتالوگ مرجع
مدل بینایی ممکن است نامهایی پیشنهاد کند که در پروژه شما وجود ندارند. فهرست فونتهای قابلاستفاده را همراه درخواست ارسال کنید.
استفاده تجاری بدون بررسی مجوز
پیش از انتشار سایت، تبلیغ یا محصول چاپی، مجوز فونت را بررسی کنید.
ایدههای توسعه ابزار Font Finder
یک ابزار ساده تشخیص فونت را میتوان به محصول کاملتری تبدیل کرد:
- شناسایی همزمان چند نوشته در تصویر
- تشخیص فونت فارسی و انگلیسی جداگانه
- پیشنهاد جایگزین رایگان برای فونت تجاری
- نمایش پیشنمایش زنده متن کاربر
- پیشنهاد ترکیب فونت تیتر و بدنه
- استخراج رنگ متن و پسزمینه
- تولید CSS و متغیرهای طراحی
- ذخیره فونتهای منتخب در Brand Kit
- ساخت افزونه مرورگر برای تشخیص فونت تصاویر
- اتصال به فروشگاه فونت
- مقایسه خودکار تصویر اصلی با خروجی رندرشده
- پیشنهاد وزن، اندازه و فاصله خطوط
- تبدیل نتیجه به قالب آماده شبکههای اجتماعی
API درواره چه نقشی در این پروژه دارد؟
درواره یک رابط یکپارچه برای دسترسی به مدلهای مختلف هوش مصنوعی فراهم میکند. در پروژه تشخیص فونت میتوانید یک مدل دارای قابلیت بینایی را انتخاب و تصویر نوشته را برای تحلیل ارسال کنید.
تنظیمات اصلی اتصال عبارتاند از:
Base URL: https://api.darvareh.ir/v1
API Key: کلید ساختهشده در حساب درواره
Model ID: شناسه مدل بینایی انتخابشده
مزیت این ساختار برای توسعهدهنده آن است که شناسه مدل از منطق اصلی برنامه جدا میماند. در نتیجه میتوان مدلهای مختلف را روی مجموعه ثابتی از تصاویر فارسی مقایسه کرد و براساس کیفیت، سرعت و هزینه تصمیم گرفت.
پیش از انتخاب نهایی مدل، یک مجموعه ارزیابی شامل نمونههای زیر آماده کنید:
- متن فارسی ساده
- تیتر ضخیم
- متن دستنویس
- تصویر کمکیفیت
- متن روی پسزمینه شلوغ
- فونت فارسی همراه لاتین
- لوگوتایپ تغییریافته
- وزنهای مختلف یک خانواده
- اعداد فارسی و انگلیسی
پرسشهای متداول
چگونه اسم فونت را از روی عکس پیدا کنیم؟
بخش واضحی از نوشته را برش دهید و آن را در ابزارهایی مانند WhatTheFont یا Font Squirrel Matcherator بارگذاری کنید. برای فونت فارسی بهتر است از مدل بینایی همراه با فهرستی از فونتهای احتمالی استفاده کنید.
بهترین سایت تشخیص فونت فارسی چیست؟
ابزارهای عمومی معمولاً روی فونت لاتین عملکرد بهتری دارند. برای فونت فارسی، ترکیب تحلیل هوش مصنوعی، کاتالوگ محدود فونتها و مقایسه دستی نتیجه دقیقتری ایجاد میکند.
آیا تشخیص فونت از روی عکس رایگان است؟
بسیاری از ابزارهای شناسایی فونت امکان جستوجوی رایگان دارند، اما فونت پیشنهادی ممکن است تجاری باشد و برای استفاده به خرید مجوز نیاز داشته باشد.
آیا ChatGPT یا مدلهای بینایی میتوانند فونت را تشخیص دهند؟
مدلهای بینایی میتوانند سبک، وزن و فونتهای مشابه را پیشنهاد دهند، اما بدون کاتالوگ مرجع نباید نام اعلامشده را قطعی دانست.
چگونه فونت یک سایت را پیدا کنیم؟
اگر نوشته متن واقعی صفحه است، از Inspect و بخش Computed یا Rendered Fonts مرورگر استفاده کنید. اگر نوشته داخل تصویر قرار دارد، از ابزار تشخیص فونت تصویری کمک بگیرید.
آیا میتوان فونت لوگو را دقیق تشخیص داد؟
اگر لوگو بدون تغییر از یک فونت ساخته شده باشد، احتمال تشخیص وجود دارد. لوگوتایپهای سفارشی معمولاً فقط به یک فونت پایه شباهت دارند.
برای افزایش دقت چه تصویری مناسب است؟
تصویر باید واضح، مستقیم، دارای کنتراست مناسب و شامل چند حرف متمایز باشد. بهتر است افکت، سایه و پسزمینه شلوغ حذف شوند.
آیا میتوان سرویس تشخیص فونت فارسی ساخت؟
بله. میتوانید یک مدل بینایی را از طریق API درواره به کاتالوگ فونتهای خود متصل کنید، نامزدها را محدود و سپس نمونههای رندرشده را برای مقایسه به کاربر نمایش دهید.
جمعبندی
تشخیص فونت از روی عکس زمانی دقیقتر میشود که ابزار مناسب، تصویر واضح و یک مجموعه مرجع مشخص در اختیار داشته باشید. سایتهایی مانند WhatTheFont و Font Squirrel Matcherator برای جستوجوی فونت لاتین مفیدند، اما تشخیص فونت فارسی به فرایند کنترلشدهتری نیاز دارد.
برای ساخت یک ابزار حرفهای:
- بخش نوشته را از تصویر جدا کنید.
- کیفیت و کنتراست آن را بهبود دهید.
- ویژگیهای تایپوگرافی را با مدل بینایی استخراج کنید.
- انتخاب مدل را به کاتالوگ فونتهای واقعی محدود کنید.
- چند نامزد را با متن اصلی رندر کنید.
- نتیجه را بهعنوان شباهت احتمالی نمایش دهید.
- مجوز فونت را پیش از استفاده بررسی کنید.
- عملکرد مدل را با تصاویر واقعی فارسی ارزیابی کنید.
با استفاده از API درواره میتوانید این قابلیت را به سایت طراحی، فروشگاه فونت، سامانه مدیریت برند، افزونه گرافیکی یا اپلیکیشن موبایل خود اضافه کنید. برای شروع، مستندات API درواره را مطالعه و یک مدل دارای قابلیت پردازش تصویر انتخاب کنید.
مقالات مرتبط
- تبدیل عکس به متن با هوش مصنوعی؛ آموزش OCR فارسی
- ساخت عکسنوشته فارسی با هوش مصنوعی
- تبدیل متن به عکس با هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی در برنامهنویسی
- API هوش مصنوعی چیست؟
- درواره چیست؟ معرفی پلتفرم API هوش مصنوعی
منابع
- WhatTheFont by MyFonts
- Font Squirrel Matcherator
- راهنمای فونتها در Adobe Photoshop
- OpenAI Python Library
- Pillow Documentation
- Pydantic Documentation
- FastAPI Documentation
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



