
GRPO چیست؟ آموزش یادگیری تقویتی مدلهای زبانی با Python و TRL
GRPO چیست و چگونه مدلهای زبانی با مقایسه پاداش چند پاسخ آموزش میبینند؟ در این راهنما، تفاوت GRPO، PPO و DPO، طراحی تابع پاداش، ارتباط با DeepSeek و مثال آموزشی Python و TRLرا بررسی میکنیم.

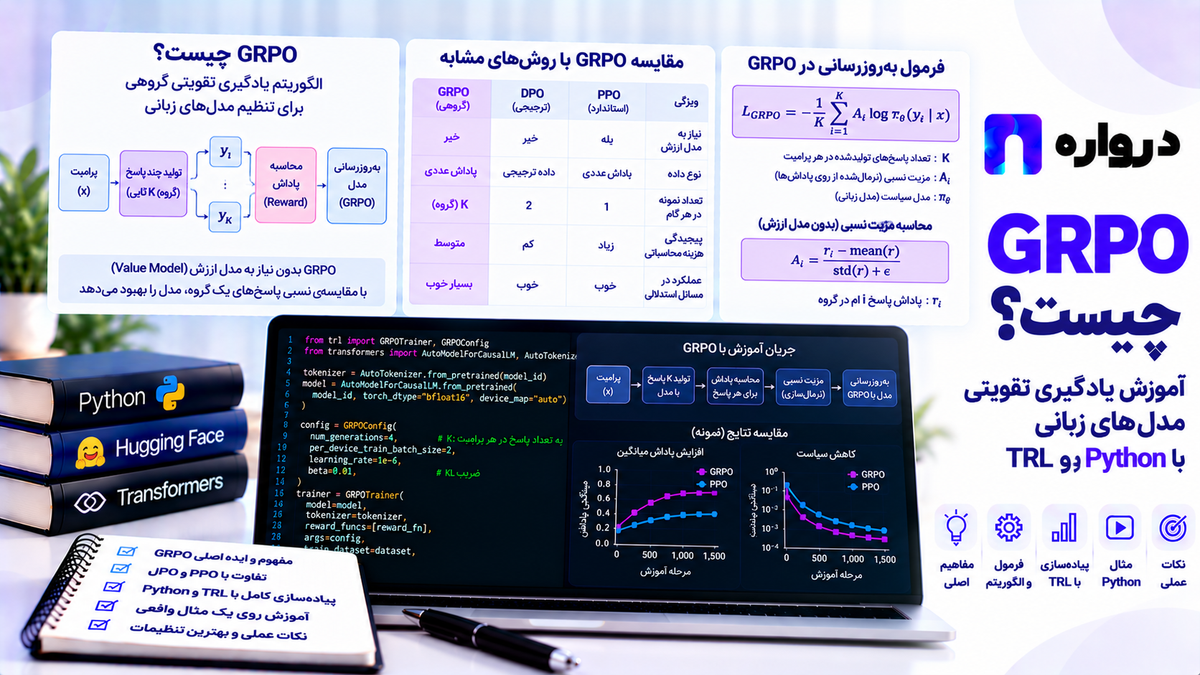
فرض کنید یک مدل زبانی برای یک مسئله، چهار پاسخ تولید میکند. بعضی پاسخها درستاند و بعضی اشتباه. اگر بتوانیم نتیجه هر پاسخ را بررسی کنیم، چگونه از این تفاوت برای آموزش مدل استفاده کنیم؟
GRPO یا Group Relative Policy Optimization یکی از روشهایی است که از مقایسه پاداش پاسخهای تولیدشده برای یک ورودی مشترک، سیگنال آموزشی میسازد.
در این روش، مدل فقط پاسخ آمادهای را تقلید نمیکند. چند پاسخ تولید میکند، پاسخها امتیاز میگیرند و عملکرد هرکدام نسبت به گروه سنجیده میشود.
GRPOدر مقاله DeepSeekMath بهعنوان روشی مرتبط با PPO معرفی شد که برای کاهش هزینههای ناشی از مدل ارزش مستقل و تقویت عملکرد در مسائل ریاضی طراحی شده بود. arxiv.org
در این مقاله، مفهوم پاداش نسبی، تفاوت GRPO با PPO و DPO، طراحی تابع پاداش و محدودیتهای ارزیابی را بررسی میکنیم. سپس یک مثال آموزشی با داده فارسی، Python و TRL میسازیم.
GRPOچیست؟
GRPOمخفف Group Relative Policy Optimization است. معادل فارسی آن «بهینهسازی سیاست بر اساس عملکرد نسبی گروه» است.
برای فهم آن، سه مفهوم را جدا کنید:
- سیاست: رفتار احتمالاتی مدل در تولید پاسخ.
- پاداش: امتیازی که پاسخ از یک ارزیاب دریافت میکند.
- گروه: چند پاسخ تولیدشده برای یک ورودی مشترک.
در یک مثال ساده، مدل برای یک سؤال چند پاسخ میسازد. به هر پاسخ امتیاز میدهیم و بررسی میکنیم کدام پاسخ نسبت به سایر اعضای گروه بهتر عمل کرده است.
این مقایسه نسبی، در اصلاح رفتار مدل نقش دارد.
چرا چند پاسخ برای یک سؤال تولید میشود؟
یک سؤال بهتنهایی مشخص نمیکند مدل چه رفتارهایی میتواند داشته باشد.
تولید چند پاسخ، امکان مشاهده تفاوت میان خروجیها را فراهم میکند:
- پاسخ صحیح و پاسخ اشتباه
- خروجی مطابق قالب و خروجی نامعتبر
- برنامهای که آزمونها را میگذراند و برنامهای که شکست میخورد
- راهحلی که هدف را برآورده میکند و راهحلی که نمیکند
در GRPO اصلی، پاداش پاسخها درون گروه مبنای محاسبه یک سیگنال نسبی قرار میگیرد. این روش از مقایسه اعضای همان گروه برای برآورد مزیت استفاده میکند. arxiv.org
پاداش با مزیت چه تفاوتی دارد؟
پاداش امتیازی است که ارزیاب به پاسخ میدهد.
مزیت یاAdvantage در این بحث، عملکرد پاسخ نسبت به مبنای مقایسه را بیان میکند.
برای مثال، چهار پاسخ امتیازهای زیر را میگیرند:
| پاسخ | پاداش |
|---|---|
| A | ۱ |
| B | ۰ |
| C | ۱ |
| D | ۰ |
پاسخهای A و C نسبت به میانگین این گروه بهترند.
اما اگر هر چهار پاسخ پاداش ۱ بگیرند، درون گروه برتریای میان آنها وجود ندارد. همین مسئله برای گروهی که همه پاسخهایش پاداش صفر دارند نیز پیش میآید.
در هدف نسبی، یک گروه بدون تفاوت پاداش، سیگنال تمایزبخش ایجاد نمیکند. البته اجزای دیگر هدف آموزشی، در صورت فعالبودن، میتوانند همچنان اثر داشته باشند.
مراحل مفهومی آموزش باGRPO
یک چرخه آموزشی را میتوان چنین توضیح داد:
- تعدادی ورودی انتخاب میشوند.
- برای هر ورودی چند پاسخ تولید میشود.
- ارزیاب به پاسخها پاداش میدهد.
- عملکرد نسبی پاسخها محاسبه میشود.
- وزنهای مدل بر اساس هدف آموزشی بهروزرسانی میشوند.
- چرخه با رفتار جدید مدل ادامه پیدا میکند.
در GRPO، تولید پاسخ بخشی از فرایند آموزش است. بنابراین هزینه آموزش فقط هزینه محاسبه گرادیان نیست؛ تولید و ارزیابی پاسخها نیز منابع مصرف میکنند.
تفاوت GRPO وPPO
PPO یا Proximal Policy Optimization خانوادهای از روشهای بهینهسازی سیاست در یادگیری تقویتی است. مقاله PPO، هدفی را برای محدودکردن تغییرات نامناسب سیاست در بهروزرسانیها بررسی میکند. arxiv.org
در مسیر رایج کاربرد PPO برای مدل زبانی، یک مدل ارزش یا Critic برای برآورد ارزش و ساخت سیگنال مزیت استفاده میشود.
GRPO اصلی از پاداشهای گروه برای ساخت این مبنا استفاده میکند و به Criticمستقل نیاز ندارد.
| معیار | GRPO اصلی | کاربرد رایج PPO برای مدل زبانی |
|---|---|---|
| تولید پاسخ هنگام آموزش | دارد | دارد |
| دریافت پاداش | دارد | دارد |
| مبنای برآورد مزیت | عملکرد پاسخهای گروه | معمولاً مدل ارزش |
| Critic مستقل | لازم نیست | معمولاً دارد |
| نیاز به ارزیاب پاداش | دارد | دارد |
| هزینه تولید پاسخ | وجود دارد | وجود دارد |
حذف Critic به معنای حذف همه هزینهها یا همه مدلهای کمکی نیست. ارزیاب پاداش میتواند یک تابع، یک مدل یا بخشی از محیط باشد.
تفاوت GRPO وDPO
در DPOآفلاین اصلی، داده شامل یک ورودی و دو پاسخ رتبهبندیشده است. مدل از جفت پاسخ ترجیحدادهشده و کمتر ترجیحدادهشده آموزش میبیند. arxiv.org
در GRPO، پاسخها در جریان آموزش تولید و سپس امتیازدهی میشوند.
| معیار | GRPO | DPO آفلاین اصلی |
|---|---|---|
| داده آغازین | ورودی و اطلاعات لازم برای ارزیابی | ورودی و جفت پاسخ رتبهبندیشده |
| پاسخ مورد استفاده | تولیدشده در چرخه آموزش | موجود در دیتاست |
| نوع سیگنال | پاداش و عملکرد نسبی گروه | ترجیح میان دو پاسخ |
| هزینه تولید در حلقه آموزش | دارد | الزاماً ندارد |
| مناسب برای پاسخ قابلآزمون | قابلبررسی است | با داده ترجیحی مناسب قابلبررسی است |
انتخاب میان آنها باید بر اساس نوع سیگنال در دسترس انجام شود. داشتن یک تابع بررسی معتبر با داشتن مجموعهای از مقایسههای انسانی، دو وضعیت متفاوت است.
ارتباط GRPO باDeepSeek-R1
پژوهش DeepSeek-R1، استفاده از یادگیری تقویتی برای توسعه رفتارهای مرتبط با استدلال را بررسی میکند.
گزارش آن میان دو مسیر تفاوت میگذارد:
- R1-Zero: آموزش تقویتی بدون مرحله اولیه SFT در همان مسیر گزارششده.
- R1: فرایندی چندمرحلهای شامل داده آغازین و مراحل آموزشی دیگر.
بنابراین موفقیت گزارششده را نباید به «یک الگوریتم و چند سؤال ساده» تقلیل داد. مدل پایه، داده، پاداش و کل فرایند آموزش اهمیت دارند. arxiv.org
مثال کوچک این مقاله، بازتولید آموزش DeepSeek-R1 نیست.
آیا GRPO همیشه به استدلال بهتر منجر میشود؟
خیر. ابتدا باید مشخص کنیم «بهتر» چگونه اندازهگیری میشود.
مدل میتواند پاداش بیشتری بگیرد، اما:
- فقط روی نوع محدودی از سؤالها پیشرفت کند.
- از ضعف ارزیاب استفاده کند.
- قالب را بهتر رعایت کند، بدون بهبود صحت.
- پاسخهای طولانیتری تولید کند.
- روی تواناییهای دیگر ضعیفتر شود.
پژوهش Understanding R1-Zero-Like Training نقش مدل پایه و بعضی سوگیریهای هدف آموزشی را بررسی میکند. این یافتهها نشان میدهند جزئیات فرایند را نباید از نتیجه جدا کرد. arxiv.org
تابع پاداش چیست؟
تابع پاداش پاسخ را دریافت میکند و امتیاز برمیگرداند.
چند نمونه:
| وظیفه | سیگنال پیشنهادی |
|---|---|
| پاسخ عددی | تطابق با پاسخ مرجع |
| تولید کد | نتیجه آزمونهای تعریفشده |
| خروجی ساختاریافته | اعتبار قالب همراه با صحت محتوا |
| برنامهریزی در محیط | رسیدن به هدف مشخص |
| پاسخ عمومی | ارزیابی با معیار یا مدل داور |
اینها گزینههای طراحیاند، نه تضمین کیفیت.
برای مثال، معتبر بودن JSON ثابت نمیکند مقادیر داخل آن درستاند. همچنین گذراندن چند آزمون کد، درستی برنامه در تمام ورودیها را اثبات نمیکند.
پاداش نتیجه و پاداش فرایند
پاداش نتیجه
خروجی نهایی را بررسی میکند؛ مثلاً آیا پاسخ عددی درست است؟
پاداش فرایند
بخشهایی از مسیر حل را ارزیابی میکند؛ مثلاً آیا یک مرحله مشخص معتبر است؟
پاداش نتیجه برای بعضی مسائل قابلمحاسبه، سادهتر تعریف میشود. اما از پاسخ نهایی درست نمیتوان نتیجه گرفت تمام توضیحات همراه آن درست بودهاند.
اگر هدف محصول، توضیح قابلاعتماد است، باید صحت توضیح را نیز ارزیابی کنید.
طراحی یک تابع پاداش فارسی
برای نمونه آموزشی، وظیفه را محدود میکنیم:
حاصل جمع دو عدد را فقط بهصورت یک عدد صحیح بنویس.
پاداش زمانی یک است که:
- خروجی فقط یک عدد صحیح باشد.
- عدد با پاسخ مرجع برابر باشد.
در غیر این صورت پاداش صفر است.
این قرارداد عمداً سختگیرانه است. پاسخ «حاصل ۱۲ است» با وجود داشتن عدد درست، قالب موردنظر را رعایت نمیکند.
پشتیبانی از رقمهای فارسی و عربی
import reDIGIT_TRANSLATION = str.maketrans( "۰۱۲۳۴۵۶۷۸۹٠١٢٣٤٥٦٧٨٩", "01234567890123456789",)def parse_integer(text: str) -> int | None: normalized = text.strip().translate( DIGIT_TRANSLATION ) if not re.fullmatch( r"[+-]?[0-9]{1,12}", normalized, ): return None return int(normalized)حداکثر ۱۲ رقم، یک محدودیت قراردادی برای همین مثال است.
بررسی رفتارParser
assert parse_integer("۱۲") == 12assert parse_integer(" ١٢ ") == 12assert parse_integer("-3") == -3assert parse_integer("answer: 12") is Noneassert parse_integer("12 13") is Noneassert parse_integer("12.0") is Noneassert parse_integer("") is Noneاین هفت حالت بررسی شدهاند. آزمودن Parser، صحت کل آموزش یا بهبود مدل را اثبات نمیکند.
تابع پاداش سازگار با داده گفتوگویی
def exact_answer_reward( completions, answer, **kwargs,): rewards = [] for messages, expected in zip( completions, answer, ): if ( len(messages) != 1 or messages[0].get("role") != "assistant" ): rewards.append(0.0) continue text = messages[0].get("content", "") if not isinstance(text, str): rewards.append(0.0) continue predicted = parse_integer(text) correct = ( predicted is not None and predicted == int(expected)در TRL، تابع پاداش میتواند خروجیهای تولیدشده و ستونهای اضافی دیتاست را دریافت کند و برای هر پاسخ یک امتیاز برگرداند. Hugging Face
آموزش نمونه GRPO باTRL
مثال زیر برای نمایش مسیر اجراست. ده مرحله آموزش روی جمعهای ساده، مبنایی برای ادعای ارتقای استدلال عمومی نیست.
نصب
ابتدا PyTorch سازگار با دستگاه را نصب کنید. سپس:
pip install "trl==0.29.0" peft datasetsمثال بر اساس رابط نسخه ۰٫۲۹ TRL نوشته شده است.
ساخت داده
from datasets import Datasetdef make_example( first: int, second: int,) -> dict: return { "prompt": [ { "role": "user", "content": ( f"حاصل جمع {first} و {second} " "را فقط بهصورت یک عدد صحیح بنویس. " "هیچ توضیحی اضافه نکن." ), } ], "answer": first + second, }train_dataset = Dataset.from_list([ make_example(first, second) for first in range(1, 11) for second in range(1, 11)])ستون answer به ارزیاب داده میشود؛ متن Prompt شامل پاسخ نیست.
در پروژه واقعی، داده ارزیابی را جدا آماده کنید. بازنویسی همان مسائل آموزشی، آزمون تعمیم قویای نمیسازد.
تنظیمTrainer
کد زیر به Parser، تابع پاداش و دیتاست بخشهای قبلی وابسته است:
import torchfrom peft import LoraConfigfrom transformers import AutoTokenizerfrom trl import GRPOConfig, GRPOTrainerMODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"tokenizer = AutoTokenizer.from_pretrained( MODEL_ID)if tokenizer.pad_token is None: tokenizer.pad_token = tokenizer.eos_tokenuse_bf16 = ( torch.cuda.is_available() and torch.cuda.is_bf16_supported())training_args = GRPOConfig( output_dir="persian-grpo-demo", max_steps=10, per_device_train_batch_size=4, gradient_accumulation_steps=1, num_generations=4, max_completion_length=32, temperature=0.8,پارامترهای تولید، گروهبندی و هدف آموزشی از تنظیمات GRPOConfig هستند. تعداد تولیدها باید با اندازه مؤثر گروه تولید در اجرای انتخابی سازگار باشد؛ برای اجرای توزیعشده، این سازگاری را دوباره بررسی کنید. GitHub
آموزش کامل این کد در محیط نگارش مقاله اجرا نشده است. مصرف حافظه و زمان به دستگاه، نسخهها و تنظیمات وابسته است.
چرا از LoRA استفاده کردیم؟
در مثال، LoRA برای تنظیم Adapter به کار رفته است.
این انتخاب، تعداد پارامترهای قابلآموزش را محدود میکند؛ اما هزینه تولید چند پاسخ و ارزیابی آنها را حذف نمیکند.
همچنین مدل مرجع یا سازوکار محاسبه رفتار مرجع، در صورت فعالبودن بخش مربوط در هدف، همچنان باید مدیریت شود.
بنابراین «آموزش با Adapter» را معادل «آموزش بدون هزینه حافظه» ندانید.
مدل مرجع و Beta درGRPO
در فرمولبندی دارای جریمه فاصله، مدل مرجع برای محدودکردن دورشدن سیاست آموزشدیده از رفتار مرجع به کار میرود.
اما همه پیادهسازیها، پیشفرضهای یکسانی ندارند. مستندات TRL نسخه مورد استفاده، مقدار پیشفرض beta را صفر معرفی میکند؛ در این حالت بخش جریمه KL فعال نیست. در مثال، آن را صریحاً غیرصفر قرار دادهایم. Hugging Face
عدد ۰٫۰۴ توصیه عمومی برای هر پروژه نیست. آن را همراه سایر تنظیمات و با ارزیابی مستقل انتخاب کنید.
اگر تمام پاسخها امتیاز یکسان بگیرند چه میشود؟
در مثال جمع، دو وضعیت محتمل است:
- مدل تقریباً همیشه پاسخ درست میدهد.
- مدل تقریباً همیشه قالب یا پاسخ را اشتباه تولید میکند.
در هر دو حالت ممکن است تعداد زیادی گروه بدون تفاوت پاداش داشته باشید.
برای بررسی این مسئله، علاوه بر میانگین پاداش، ثبت کنید:
- چند گروه کاملاً موفقاند؟
- چند گروه کاملاً ناموفقاند؟
- چند گروه ترکیبی از موفق و ناموفق دارند؟
- شکست بیشتر مربوط به محاسبه است یا قالب؟
اگر مدل از ابتدا مسئله را حل میکند، همان دیتاست ممکن است برای آزمایش یادگیری مناسب نباشد. اگر تقریباً هیچ پاسخ موفقی تولید نمیکند، ابتدا دشواری مسئله یا توانایی آغازین مدل را بررسی کنید.
Reward Hackingچیست؟
گاهی مدل راهی پیدا میکند که امتیاز بیشتری بگیرد، بدون اینکه هدف واقعی بهتر برآورده شود.
برای مثال، یک ارزیاب ضعیف ممکن است:
- وجود عدد مرجع در هر جای متن را قبول کند.
- قالب JSON را بدون بررسی محتوا موفق بداند.
- پاسخ بلندتر را همیشه بهتر ارزیابی کند.
- فقط چند آزمون بسیار محدود را اجرا کند.
در مثال این مقاله، استخراج هر عدد از متن را نپذیرفتیم؛ کل خروجی باید با قرارداد عدد صحیح سازگار باشد.
بااینحال، حتی این ارزیاب نیز فقط قرارداد محدود خودش را میسنجد. از آن نمیتوان صحت استدلال عمومی یا توضیحات مدل را نتیجه گرفت.
چرا نسخههای GRPO با هم تفاوت دارند؟
پژوهشهای بعدی، جزئیاتی مانند نرمالسازی پاداش، وزندهی توکنها، طول پاسخ و نحوه نمونهبرداری را بررسی کردهاند.
برای نمونه، پژوهش DAPO مجموعهای از تغییرات را برای آموزش تقویتی در مقیاس بزرگ ارائه میکند. این نتیجه نشان میدهد نام کلی الگوریتم برای توصیف دقیق یک آزمایش کافی نیست. arxiv.org
برای بازتولید، موارد زیر را ثبت کنید:
- نسخه Trainer و نوعLoss
- مدل وTokenizer
- تعداد پاسخ هر ورودی
- تنظیمات نمونهبرداری
- شیوه نرمالسازی پاداش
- محدودیت طول
- تابع پاداش
- نرخ یادگیری
- مدل مرجع و تنظیم فاصله
ارزیابی درست یک مدلGRPO
داده ندیده داشته باشید
مسائل آزمون باید از داده آموزش جدا باشند. برای مثال، نوع مسئله، بازه عددها یا ساختار درخواست را تغییر دهید.
تولید تکپاسخی را جدا بسنجید
اگر محصول یک پاسخ به کاربر میدهد، عملکرد همان حالت مهم است. نتیجه انتخاب بهترین پاسخ از چند نمونه را با آن مخلوط نکنید.
تعداد نمونه را در مقایسه ثابت نگه دارید
مدلی که فرصت تولید پاسخهای بیشتری داشته، لزوماً سیاست تکپاسخی بهتری ندارد.
صحت و قالب را جدا گزارش کنید
مشخص کنید چند شکست به جواب غلط و چند شکست به قالب نامعتبر مربوط است.
طول و هزینه را اندازه بگیرید
پاداش بیشتر با پاسخ طولانیتر ممکن است هزینه یا تأخیر محصول را افزایش دهد.
تواناییهای قبلی را بررسی کنید
دقت روی جمعهای ساده، عملکرد خلاصهسازی، فارسینویسی یا پیروی از دستور را نشان نمیدهد.
این موارد یک طرح پیشنهادی ارزیابیاند. معیار موفقیت باید از نیاز واقعی محصول استخراج شود.
اشتباهات رایج
برابرگرفتن پاداش با کیفیت عمومی
پاداش فقط چیزی را اندازه میگیرد که ارزیاب تعریف کرده است.
تصور اینکه GRPO بدون ارزیاب کار میکند
حذف Critic، نیاز به سیگنال پاداش را حذف نمیکند.
افزایش تعداد پاسخ بدون بررسی هزینه
پاسخهای بیشتر، هزینه تولید و ارزیابی بیشتری دارند.
اعلام موفقیت فقط با نمودار آموزش
پاداش آموزش باید با ارزیابی مستقل تکمیل شود.
استفاده از مسئلهای که مدل از ابتدا حل میکند
در این حالت ممکن است فرصت تمایز پاسخها محدود باشد.
اشتباهگرفتن آموزش و انتخاب پاسخ
انتخاب بهترین خروجی از چند پاسخ API، وزن مدل را تغییر نمیدهد.
ارتباط GRPO با خدمات درواره
پیش از آموزش اختصاصی، میتوانید مدلهای آماده را روی وظیفه قابلارزیابی خود آزمایش کنید.
این کار کمک میکند بفهمید:
- کدام مدل آغازین مناسبتر است؟
- چه خطاهایی تکرار میشوند؟
- چند پاسخ موفق در نمونهبرداری دیده میشود؟
- آیا ارزیاب شما خروجیهای واقعی را درست بررسی میکند؟
نمونه بررسی یک پاسخ با API درواره
pip install openaiکد زیر به تابع parse_integer بخش قبلی وابسته است:
import osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DARVAREH_API_KEY"], base_url="https://api.darvareh.ir/v1",)first = 17second = 26response = client.chat.completions.create( model=os.environ["DARVAREH_CHAT_MODEL"], messages=[ { "role": "user", "content": ( f"حاصل جمع {first} و {second} را " "فقط بهصورت یک عدد صحیح بنویس." ), }, ],)text = response.choices[0].message.content or ""predicted = parse_integer(text)expected = first + secondprint("Response:", text)شناسه مدل و قابلیتها را از مستندات درواره بررسی کنید.
این کد یک پاسخ را ارزیابی میکند و آموزش GRPO انجام نمیدهد. اجرای آموزش به دسترسی به مدل قابلآموزش و زیرساخت مناسب نیاز دارد.
پرسشهای متداول
GRPOچیست؟
روشی برای آموزش تقویتی مدل زبانی است که از پاداش نسبی چند پاسخ به یک ورودی مشترک استفاده میکند.
GRPOمخفف چیست؟
Group Relative Policy Optimization؛ بهینهسازی سیاست بر اساس عملکرد نسبی گروه.
آیا GRPO مدل پاداش میخواهد؟
به ارزیاب پاداش نیاز دارد. این ارزیاب میتواند تابع یا مدل باشد و الزاماً یک مدل عصبی مستقل نیست.
تفاوت GRPO و PPO چیست؟
GRPO اصلی از مقایسه پاداشهای گروه برای برآورد مزیت استفاده میکند و به Criticمستقل نیاز ندارد.
تفاوت GRPO و DPO چیست؟
GRPO پاسخها را در چرخه آموزش تولید و ارزیابی میکند. DPOآفلاین اصلی از جفت پاسخهای موجود در دیتاست استفاده میکند.
آیا GRPO فقط برای ریاضی است؟
خیر. میتوان آن را برای وظایفی با سیگنال پاداش مناسب بررسی کرد، اما موفقیت به طراحی ارزیاب و آزمایش وابسته است.
آیا جواب درست، استدلال درست را ثابت میکند؟
خیر. ارزیابی جواب نهایی با ارزیابی توضیح و مسیر حل متفاوت است.
آیا بیشترکردن تعداد تولیدها همیشه بهتر است؟
خیر. هزینه، تنوع پاسخ و نتیجه ارزیابی باید با هم بررسی شوند.
آیا GRPO را میتوان با Chat API اجرا کرد؟
فراخوانی معمول API وزن مدل را تغییر نمیدهد. میتوان پاسخها را ارزیابی کرد، اما این کار آموزش نیست.
جمعبندی
GRPO از تولید چند پاسخ و مقایسه پاداش آنها برای ساخت سیگنال آموزشی استفاده میکند. ویژگی مهم روش اصلی، استفاده از مبنای گروهی بهجای Criticمستقل است.
اما کیفیت نهایی از نام الگوریتم بهتنهایی به دست نمیآید. توانایی مدل پایه، تنوع پاسخها، طراحی پاداش و ارزیابی مستقل اهمیت دارند.
برای کاربرد واقعی، ابتدا یک مسئله محدود و ارزیاب قابلآزمون تعریف کنید. سپس مدلهای آماده را بسنجید و فقط با شواهد روشن درباره آموزش اختصاصی تصمیم بگیرید.
برای آزمایش مدلهای هوش مصنوعی روی وظایف واقعی فارسی و اتصال آنها به نرمافزار خود، از درواره شروع کنید و مدل مناسب را از طریق API یکپارچه انتخاب کنید.
مقالات مرتبط
- یادگیری تقویتی، Q-Learning وRLHF
- مدل استدلالی چیست؟
- Test-Time Scalingدر مدلهای زبانی
- Fine-tuning با LoRA و QLoRA
- ارزیابی مدلهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Proximal Policy Optimization Algorithms
- Direct Preference Optimization
- مستندات GRPOTrainer در TRL نسخه۰٫۲۹
- کد تنظیمات GRPO در TRL نسخه۰٫۲۹
- DAPO: An Open-Source LLM Reinforcement Learning System at Scale
- Understanding R1-Zero-Like Training: A Critical Perspective
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدلها و کتابخانهها و صفحه سلب مسئولیت را مطالعه کنید.



