
DPO چیست؟ آموزش تنظیم مدل زبانی با داده ترجیحی، TRL و LoRA
DPO چیست و چگونه مدل زبانی از مقایسه پاسخ بهتر و ضعیفتر یاد میگیرد؟ در این راهنما، تفاوت DPO، SFT و RLHF، طراحی داده ترجیحی فارسی، آموزش با TRLو ارزیابی کیفیت مدل را بررسی میکنیم.

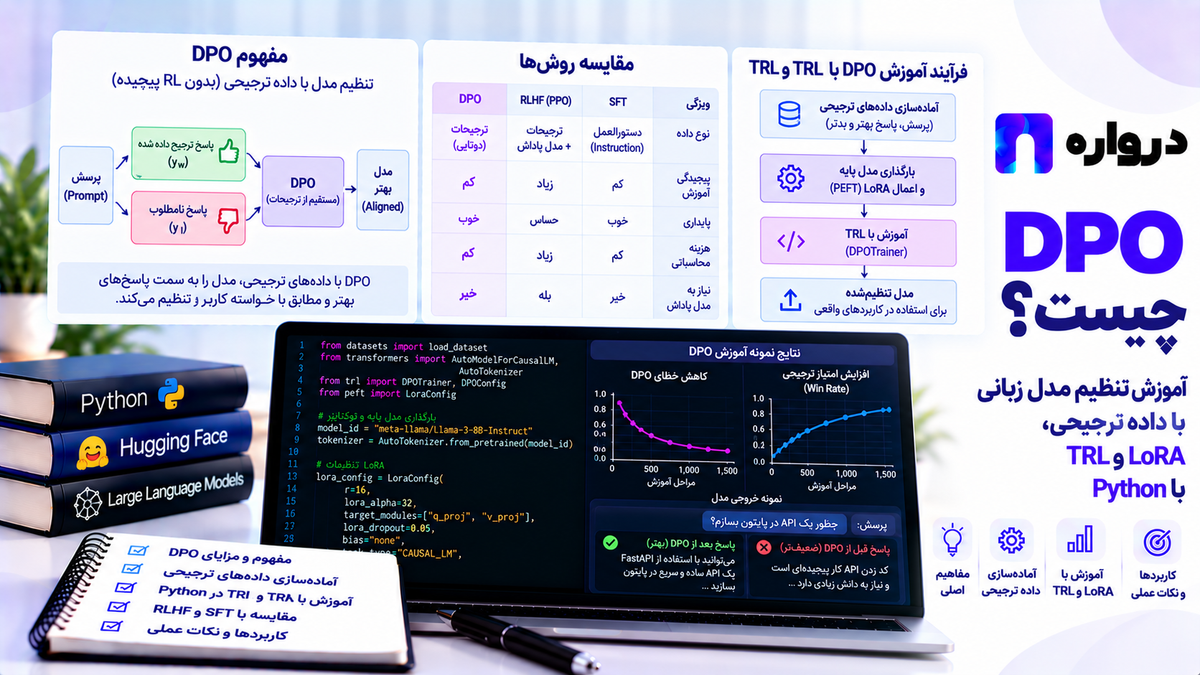
یک مدل زبانی ممکن است برای یک سؤال چند پاسخ معتبر تولید کند، اما همه آنها برای کاربر به یک اندازه مفید نباشند.
برای مثال، کاربر میپرسد:
تفاوت نسخه پشتیبان و آرشیو چیست؟ کوتاه و با مثال توضیح بده.
یک پاسخ میتواند دقیق، کوتاه و همراه مثال باشد. پاسخ دیگر ممکن است طولانی، تکراری یا خارج از قالب درخواستی نوشته شود.
چگونه میتوان این تفاوت را به مدل آموزش داد؟
DPO یا Direct Preference Optimization روشی برای تنظیم مدل زبانی با داده ترجیحی است. در این دادهها، برای یک ورودی مشترک، دو پاسخ داریم و مشخص میکنیم کدام پاسخ ترجیح داده میشود.
DPO از این مقایسهها برای اصلاح وزنهای مدل استفاده میکند. در روش اصلی، برخلاف مسیر متداول آموزش با مدل پاداش و PPO،لازم نیست یک مدل پاداش مستقل آموزش دهیم و سپس یک حلقه یادگیری تقویتی مبتنی بر آن اجرا کنیم. arxiv.org
در این مقاله، سازوکار DPO را بدون فرمول ریاضی توضیح میدهیم، آن را با SFT و RLHF مقایسه میکنیم و یک مثال آموزشی با TRL و LoRA میسازیم.
DPOچیست؟
DPOمخفف Direct Preference Optimization است؛ معادل فارسی آن «بهینهسازی مستقیم ترجیحات» است.
داده آموزشی معمول آن سه بخش دارد:
- Prompt: پرسش یا سابقه گفتوگوی مشترک.
- Chosen: پاسخ ترجیحدادهشده.
- Rejected: پاسخ کمتر ترجیحدادهشده.
برای مثال:
| بخش | نمونه |
|---|---|
| Prompt | در یک جمله بگو API چیست. |
| Chosen | API رابطی است که به نرمافزارها اجازه میدهد با قواعد مشخص با یکدیگر ارتباط برقرار کنند. |
| Rejected | API موضوع بسیار مهم و گستردهای در فناوری است که برای توضیح آن ابتدا باید تاریخ رایانش را بررسی کنیم. |
پاسخ دوم الزاماً شامل گزارهای کاملاً غلط نیست؛ مشکل آن میتواند رعایتنکردن درخواست کاربر باشد.
بنابراین ترجیح فقط به «درست و غلط» محدود نمیشود. دقت، ارتباط، قالب، لحن و میزان توضیح نیز میتوانند در تعریف آن نقش داشته باشند.
DPOچگونه کار میکند؟
در DPO اصلی، مدل در حال آموزش و یک مدل مرجع، احتمال پاسخهای ترجیحدادهشده و کمتر ترجیحدادهشده را برای ورودی مشترک ارزیابی میکنند.
هدف، اصلاح ترجیح نسبی مدل با توجه به رفتار مرجع است.
توضیح دقیقتر از عبارت «احتمال پاسخ خوب را بالا میبرد» این است که DPO روی مقایسه نسبی دو پاسخ کار میکند. تغییر میتواند از افزایش احتمال یک پاسخ، کاهش احتمال دیگری یا ترکیبی از آنها حاصل شود.
این روش در زمان آموزش وزنها را تغییر میدهد؛ یک ابزار رتبهبندی لحظهای برای انتخاب میان پاسخهای API نیست. arxiv.org
مدل مرجع در DPO چه نقشی دارد؟
مدل مرجع یک نقطه مقایسه برای رفتار مدل فراهم میکند. در اجرای استاندارد، معمولاً از نسخه ثابت مدل آغازین استفاده میشود.
اما مدل مرجع نقش داور انسانی را ندارد:
- مشخص نمیکند پاسخ از نظر واقعی درست است.
- برچسب
chosenوrejectedرا تولید نمیکند. - جای ارزیابی کیفیت را نمیگیرد.
پیادهسازی مرجع DPO، مرحله تنظیم نظارتشده و مرحله یادگیری ترجیحات را جدا ارائه میکند و مدل آغازین مرحله ترجیحی را مبنای مقایسه قرار میدهد. GitHub
این نکته برای تفسیر نتیجه مهم است: داده ترجیحی نامناسب با داشتن مدل مرجع به داده مناسب تبدیل نمیشود.
تفاوت DPO وSFT
SFT یا Supervised Fine-Tuning مدل را با نمونههای پاسخ مطلوب آموزش میدهد.
برای یک ورودی، پاسخ هدف را ارائه میکنیم و مدل یاد میگیرد آن را تولید کند.
در DPO، علاوه بر پاسخ مطلوب، یک پاسخ کمتر مطلوب نیز داریم و از مقایسه آنها استفاده میکنیم.
مستندات SFT در TRL، آموزش با دادههای متنی و گفتوگویی را پشتیبانی میکند. Hugging Face
| معیار | SFT | DPO |
|---|---|---|
| داده اصلی | ورودی و پاسخ مطلوب | ورودی و دو پاسخ رتبهبندیشده |
| سیگنال آموزشی | تقلید پاسخ هدف | یادگیری ترجیح نسبی |
| نیاز به پاسخ ضعیفتر | ندارد | در قالب جفتی دارد |
| کاربرد نمونه | آموزش قالب و شیوه پاسخ | اصلاح ترجیح میان رفتارهای مختلف |
| نیاز به دسترسی آموزشی مدل | دارد | دارد |
چه زمانی SFT نقطه شروع مناسبتری است؟
اگر مدل هنوز شیوه پاسخگویی موردنظر را نمیشناسد و شما نمونههای صحیح و منظمی دارید، ابتدا یک آزمایش SFT میتواند روشنتر باشد.
برای مثال:
- تولید پاسخ با ساختار ثابت.
- استفاده از اصطلاحات سازمان.
- نوشتن در لحن مشخص.
- انجام یک وظیفه تخصصی با نمونههای هدف.
چه زمانی DPO را بررسی کنیم؟
اگر مدل پاسخهای مختلف تولید میکند و میتوانید تفاوت کیفیت آنها را بهطور پایدار رتبهبندی کنید، داده ترجیحی میتواند سیگنال اضافی فراهم کند.
این پیشنهاد یک مسیر آزمایشی است؛ لازم نیست هر پروژه حتماً هر دو مرحله را اجرا کند.
تفاوت DPO وRLHF
RLHF عنوان گستردهای برای یادگیری از بازخورد انسانی است.
در مسیر شناختهشده InstructGPT، ابتدا تنظیم نظارتشده انجام شد، سپس از مقایسههای انسانی برای آموزش مدل پاداش استفاده شد و مدل زبانی با PPO بهینه شد. arxiv.org
DPOنیز میتواند از ترجیحات انسانی استفاده کند، اما روش بهینهسازی آن با این مسیر تفاوت دارد.
| معیار | DPO اصلی | مسیر RLHF با مدل پاداش و PPO |
|---|---|---|
| داده مقایسهای | دارد | برای آموزش مدل پاداش استفاده میشود |
| مدل پاداش مستقل | لازم نیست | دارد |
| تولید پاسخ در حلقه بهینهسازی | در DPO آفلاین اصلی لازم نیست | معمولاً بخشی از فرایند است |
| مدل مرجع | معمولاً دارد | برای کنترل فاصله از مدل آغازین به کار میرود |
| تعداد اجزای آموزشی | کمتر | بیشتر |
| برتری قطعی در تمام مسائل | ندارد | ندارد |
عبارت «DPO همیشه بهتر از RLHF است» دقیق نیست. روش مناسب به داده، هدف، منابع و نتیجه ارزیابی وابسته است.
DPOچه مسئلهای را حل نمیکند؟
برای جلوگیری از انتخاب اشتباه، مسئله محصول را دقیق تعریف کنید.
اطلاعات بهروز
اگر مدل باید آخرین وضعیت سفارش یا قیمت فعلی را بداند، DPO جای اتصال به منبع اطلاعات را نمیگیرد.
محاسبات قطعی
اگر خروجی باید با یک محاسبه مالی یا منطقی دقیق سازگار باشد، ابزار محاسبه و اعتبارسنجی همچنان لازم است.
رعایت تضمینی قالب
داده ترجیحی میتواند رفتار قالببندی را هدف قرار دهد، اما برای یک قرارداد نرمافزاری سختگیرانه، خروجی باید اعتبارسنجی شود.
تشخیص حقیقت
ترجیح انسانی با حقیقت یکسان نیست. ممکن است پاسخ خوشبیانتر، نادرست باشد.
دسترسی به اطلاعات سازمان
وقتی پاسخ به اسناد یا داده عملیاتی وابسته است، ابتدا مسیر دسترسی به آن اطلاعات را طراحی کنید.
این تفکیک یک تصمیم مهندسی است: آموزش رفتار و تأمین اطلاعات، دو نیاز مستقلاند.
چگونه داده ترجیحی فارسی بسازیم؟
پیش از تولید جفت پاسخ، یک معیار ترجیح بنویسید.
برای نمونه، در دستیار آموزشی:
- پاسخ باید به سؤال مرتبط باشد.
- اطلاعات باید درست و قابلبررسی باشند.
- قالب خواستهشده رعایت شود.
- سطح توضیح با مخاطب هماهنگ باشد.
- متن فارسی روان باشد.
اگر این معیارها تعارض دارند، ترتیب اهمیت آنها را مشخص کنید. مثلاً پاسخ کوتاهتر اما غلط، نباید فقط بهدلیل کوتاهی انتخاب شود.
نمونه ترجیح بر اساس قالب
Prompt:
سه کاربرد API را فقط بهصورت فهرست بنویس.
Chosen:
- اتصال نرمافزارها
- دریافت داده از سرویسها
- خودکارسازی فرایندها
Rejected:
APIکاربردهای فراوانی دارد. برای شناخت آن بهتر است ابتدا ساختار شبکه و تاریخچه ارتباط نرمافزارها را بررسی کنیم.
نمونه ترجیح بر اساس دقت
Prompt:
آیا Embedding همان متن اصلی است؟
Chosen:
خیر. Embedding یک نمایش عددی از داده است و نباید آن را نسخه متنی ورودی دانست.
Rejected:
بله، Embedding همان متن اصلی است که فقط داخل یک فایل دیگر ذخیره شده است.
نمونه ترجیح بر اساس سطح توضیح
Prompt:
برای یک کاربر مبتدی توضیح بده توکن چیست.
Chosen:
توکن واحدی است که مدل متن را با آن پردازش میکند؛ یک توکن ممکن است بخشی از یک کلمه، یک کلمه یا نشانه باشد.
Rejected:
توکن را باید از منظر نگاشت فضای واژگان به نمایشهای گسسته در زنجیره پردازش زیرواحدهای زبانی تحلیل کرد.
این نمونهها آموزشیاند. برای دیتاست واقعی، از درخواستهای متنوع و پاسخهای نزدیکتر به رفتار مدل استفاده کنید.
پاسخ ضعیفتر چقدر باید ضعیف باشد؟
اگر تمام پاسخهای rejected آشکارا بیربط باشند، داده فقط مقایسههای بسیار آسان خواهد داشت.
برای آزمایش جدی، مقایسههایی بسازید که تفاوتهای واقعی محصول را منعکس کنند:
- دو پاسخ مرتبط که یکی دقیقتر است.
- دو پاسخ درست که یکی قالب را رعایت میکند.
- دو خلاصه که یکی نکته مهمی را حذف کرده است.
- دو توضیح که یکی برای مخاطب قابلفهمتر است.
از طرف دیگر، اگر ارزیابان نتوانند بهطور پایدار یکی را ترجیح دهند، تحمیل یک برچسب قطعی میتواند کیفیت داده را کاهش دهد.
مراقب سوگیری طول پاسخ باشید
پاسخ طولانیتر ممکن است حرفهایتر به نظر برسد، حتی وقتی اطلاعات مفید بیشتری ندارد.
اگر بیشتر پاسخهای انتخابشده طولانیتر باشند، مدل ممکن است بخشی از سیگنال ترجیح را با طول مرتبط کند.
پژوهش Disentangling Length from Quality in Direct Preference Optimization این مسئله را بررسی کرده و روشی برای کاهش بهرهبرداری از طول در آموزش ترجیحی پیشنهاد میکند. arxiv.org
برای داده فارسی، پیشنهاد میشود:
- طول دو پاسخ را ثبت کنید.
- جفتهایی با پاسخ بهترِ کوتاهتر نیز داشته باشید.
- کاملبودن را از پرگویی جدا ارزیابی کنید.
- درخواستهای کوتاه و بلند را مستقل بسنجید.
قالب داده درTRL
TRL برای DPO،داده ترجیحی در قالب استاندارد یا گفتوگویی میپذیرد.
قالب گفتوگویی نمونه:
example = { "prompt": [ { "role": "user", "content": "API را در یک جمله تعریف کن.", } ], "chosen": [ { "role": "assistant", "content": ( "API رابطی است که ارتباط میان " "نرمافزارها را با قواعد مشخص ممکن میکند." ), } ], "rejected": [ { "role": "assistant", "content": ( "API موضوعی گسترده است که برای " "تعریف آن باید چند فصل کتاب بخوانیم." ), } ],}در این ساختار، ورودی مشترک در prompt قرار دارد و دو پاسخ ادامه آن هستند. مستندات قالب داده TRL این ساختارها را از داده معمول تنظیم نظارتشده تفکیک میکند. Hugging Face
آموزش نمونه DPO با TRL وLoRA
در این مثال، یک مدل کوچک Instruct را با چند جفت آموزشی تنظیم میکنیم.
هدف این کد، نمایش مسیر اجراست. دیتاست چندنمونهای آن برای اثبات بهبود کیفیت کافی نیست.
از مدل Qwen/Qwen2.5-0.5B-Instruct استفاده میکنیم. این شناسه متعلق به مدل رسمی است، اما کوچکبودن مدل تضمینکننده کیفیت مناسب فارسی نیست. Hugging Face
نصب
ابتدا PyTorch سازگار با دستگاه را نصب کنید. سپس:
pip install "trl==0.29.0" peft datasetsمثال بر اساس رابط مستندشده TRL نسخه ۰٫۲۹ نوشته شده است. نسخه کتابخانهها را برای بازتولید آزمایش ثبت کنید.
ساخت دیتاست آموزشی کوچک
from datasets import Datasetdef preference_pair( prompt: str, chosen: str, rejected: str,) -> dict: return { "prompt": [ { "role": "user", "content": prompt, } ], "chosen": [ { "role": "assistant", "content": chosen, } ], "rejected": [ { "role": "assistant", "content": rejected, } ], }train_dataset = Dataset.from_list([ preference_pair( "API را در یک جمله تعریف کن.", "API رابطی برای ارتباط نرمافزارها با قواعد مشخص است.",مجموعه ارزیابی تکنمونهای این مثال فقط برای نمایش اجرای ارزیابی است؛ معیار قابلاتکایی برای کیفیت محصول نمیسازد.
تنظیم آموزش
import torchfrom peft import LoraConfigfrom transformers import AutoTokenizerfrom trl import DPOConfig, DPOTrainerMODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"tokenizer = AutoTokenizer.from_pretrained( MODEL_ID)if tokenizer.pad_token is None: tokenizer.pad_token = tokenizer.eos_tokenuse_bf16 = ( torch.cuda.is_available() and torch.cuda.is_bf16_supported())training_args = DPOConfig( output_dir="qwen-persian-dpo-demo", max_steps=10, per_device_train_batch_size=1, per_device_eval_batch_size=1, gradient_accumulation_steps=2, learning_rate=1e-5, beta=0.1,مستندات DPOTrainer، استفاده از داده گفتوگویی، اعمال Chat Template و اتصال PEFT برای آموزش Adapter را پشتیبانی میکند. Hugging Face
کد در محیط نگارش مقاله اجرا نشده است. تنظیمات بالا نمونه آموزشیاند و کیفیت، حافظه یا زمان مشخصی را تضمین نمیکنند.
LoRA چه نقشی در DPOدارد؟
LoRA و DPOدو مفهوم متفاوتاند:
- DPOهدف آموزش و نوع داده ترجیحی را مشخص میکند.
- LoRAروشی برای تنظیم تعداد محدودتری از پارامترهاست.
در LoRA، وزنهای اصلی ثابت میمانند و پارامترهای کمرتبه قابلآموزش به برخی تبدیلهای شبکه اضافه میشوند. مقاله اصلی آن کاهش تعداد پارامترهای قابلآموزش را بررسی میکند. arxiv.org
بنابراین میتوان از DPO برای آموزش کامل وزنها یا آموزش Adapter استفاده کرد.
کاهش پارامترهای قابلآموزش نیز به معنای حذف تمام هزینه حافظه نیست؛ مدل، فعالسازیها و محاسبات پاسخها همچنان منابع مصرف میکنند.
پارامتر Beta درDPO
beta یکی از تنظیمات هدف DPO است و در فرمولبندی اصلی، با کنترل فاصله از مدل مرجع ارتباط دارد.
اما نباید آن را یک دکمه ساده «کیفیت بیشتر» دانست.
تأثیر آن با داده، نرخ یادگیری و مقدار آموزش همراه است. پیشنهاد عملی این است که چند مقدار محدود را با معیار یکسان مقایسه کنید و فقط بر اساس Loss انتخاب نکنید.
همچنین رفتار پارامترها میتواند میان انواع Loss تغییر کند؛ تعریف نسخه و روش انتخابی را بخوانید.
چرا پایینآمدن Loss کافی نیست؟
مدل ممکن است جفتهای آموزشی را بهتر رتبهبندی کند، اما پاسخهای تازه آن برای کاربر بهتر نشده باشند.
در یک ارزیابی کاربردی، دو سؤال را جدا کنید:
- آیا مدل ترجیحات داده ارزیابی را بهتر منعکس میکند؟
- آیا هنگام تولید پاسخ تازه، کیفیت واقعی افزایش یافته است؟
برای پاسخ دوم، روی پرسشهایی که در آموزش نبودهاند، خروجی مدل پایه و مدل تنظیمشده را تولید کنید.
چگونه مدل DPO را ارزیابی کنیم؟
معیارها را پیش از دیدن پاسخها بنویسید
برای هر وظیفه مشخص کنید چه چیزی مهم است: صحت، ارتباط، قالب، کاملبودن یا اختصار.
مقایسه را بدون نمایش نام مدل انجام دهید
نام مدل پایه و تنظیمشده میتواند ارزیاب را تحتتأثیر قرار دهد.
جای دو پاسخ را تغییر دهید
پاسخ مدل تنظیمشده همیشه در جایگاه اول نباشد.
گزینه تساوی داشته باشید
هر مقایسه الزاماً برنده روشنی ندارد.
طول و هزینه را ثبت کنید
اگر بهبود ظاهری با چندبرابرشدن خروجی همراه باشد، این تغییر برای محصول اهمیت دارد.
وظایف خارج از دیتاست را هم بررسی کنید
مدل باید روی تواناییهای قبلی و درخواستهای متفاوت نیز آزمایش شود.
داده مشابه را میان مجموعهها پخش نکنید
نسخههای بازنویسیشده یک پرسش یا نمونههای یک گفتوگو میتوانند ارزیابی را خوشبینانه کنند.
این مراحل، یک طرح پیشنهادی ارزیابی هستند؛ نتیجه آنها به مجموعه آزمون شما وابسته است.
اشتباهات رایج درDPO
انتخاب پاسخ خوشبیان اما غلط
ترجیح باید با معیار صحت همراه باشد.
ردکردن همه پاسخهای کوتاه
این کار میتواند اختصار مفید را از داده حذف کند.
ساختن جفتهای بسیار آسان
داده باید تفاوتهای واقعی رفتار مدل را منعکس کند.
تنظیم با داده بسیار کم و اعلام موفقیت
اجرای موفق آموزش، اثبات بهبود نیست.
تغییر همزمان مدل و Prompt و داده
در این حالت، مشخص نمیشود نتیجه از کدام تغییر آمده است.
بیتوجهی به قطعشدن متن
اگر محدودیت توکن بخش تعیینکننده پاسخ را حذف کند، جفت آموزشی معنای دیگری پیدا میکند.
استفاده از Test برای انتخاب تنظیمات
انتخاب مدل باید با Validation انجام شود و Test برای گزارش نهایی باقی بماند.
DPOاختصاصی یا استفاده از مدل آماده؟
| وضعیت | اقدام پیشنهادی برای شروع |
|---|---|
| کیفیت فعلی مدل نامناسب است | چند مدل پایه مناسبتر را مقایسه کنید |
| فقط قالب پاسخ مشکل دارد | Prompt و اعتبارسنجی خروجی را آزمایش کنید |
| اطلاعات پاسخ در مدل نیست | دسترسی به سند یا ابزار را طراحی کنید |
| ترجیح رفتاری تکرارشونده دارید | جمعآوری داده ترجیحی را بررسی کنید |
| به وزن مدل دسترسی ندارید | مدل قابلآموزش یا سرویس آموزشی مناسب انتخاب کنید |
این جدول ترتیب قطعی همه پروژهها نیست؛ کمک میکند پیش از هزینه آموزش، محل مشکل روشن شود.
ارتباط DPO با خدمات درواره
برای تصمیم درباره آموزش اختصاصی، ابتدا یک مدل پایه قابلقبول و مجموعه ارزیابی مناسب نیاز دارید.
APIدرواره میتواند در آزمایش مدلهای در دسترس، تولید پاسخهای اولیه و ساخت نمونه محصول استفاده شود. سپس میتوانید خروجیها را بررسی کنید و ببینید چه نوع خطایی تکرار میشود.
نمونه تولید پاسخ برای بررسی کیفیت
import os

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["DARVAREH_API_KEY"],
    base_url="https://api.darvareh.ir/v1",
)

response = client.chat.completions.create(
    model=os.environ["DARVAREH_CHAT_MODEL"],
    messages=[
        {
            "role": "user",
            "content": (
                "برای یک کاربر مبتدی، تفاوت "
                "Embedding و متن اصلی را "
                "در دو جمله توضیح بده."
            ),
        },
    ],
)

print(response.choices[0].message.content)
شناسه مدل و قابلیتها را از مستندات درواره بررسی کنید.
این فراخوانی، آموزش DPO انجام نمیدهد. پاسخهای API میتوانند مواد اولیه ارزیابی یا دادهسازی باشند، اما رتبهبندی و تأیید کیفیت آنها مرحلهای جداست.
پرسشهای متداول
DPOچیست؟
روشی برای تنظیم مدل زبانی از طریق مقایسه پاسخ ترجیحدادهشده و کمتر ترجیحدادهشده برای ورودی مشترک است.
آیا DPO مدل پاداش میخواهد؟
روش اصلی به آموزش یک مدل پاداش مستقل نیاز ندارد؛ معمولاً از مدل مرجع استفاده میکند.
آیا پاسخ Rejected باید کاملاً غلط باشد؟
خیر. میتواند از نظر قالب، ارتباط، دقت یا سطح توضیح ضعیفتر باشد.
آیا قبل از DPO باید SFT انجام داد؟
همیشه الزام نیست. انتخاب مرحله آغازین به توانایی مدل و نوع داده بستگی دارد.
آیا DPO بدون GPU ممکن است؟
از نظر فنی برای تنظیمات کوچک ممکن است، اما هزینه زمانی و حافظه باید بررسی شود. مدل کوچک نیز آموزش رایگان ندارد.
آیا DPO با LoRA سازگار است؟
بله. DPO هدف آموزشی است و LoRA روش تنظیم بخشی از پارامترها.
آیا DPO اطلاعات مدل را بهروز میکند؟
آن را نباید جایگزین دسترسی به اطلاعات بهروز دانست. هدف اصلی، یادگیری ترجیح رفتاری است.
آیا میتوان فقط با API گفتوگو DPO اجرا کرد؟
فراخوانی Chat API وزن مدل را تغییر نمیدهد. آموزش به دسترسی یا قابلیت آموزشی مشخص نیاز دارد.
آیا کاهش Loss نشانه بهبود قطعی است؟
خیر. تولید پاسخ روی داده ندیده و ارزیابی کاربردی نیز ضروری است.
جمعبندی
DPO از مقایسه دو پاسخ برای یک ورودی مشترک، سیگنال آموزشی میسازد. مزیت روش اصلی، حذف نیاز به مدل پاداش مستقل و حلقه متداول PPOاست.
بااینحال، مهمترین مسئله فقط اجرای Trainer نیست. معیار ترجیح، کیفیت جفتها، سوگیری طول، تفکیک داده و ارزیابی پاسخهای تازه تعیین میکنند آموزش برای محصول مفید بوده است یا خیر.
پیش از آموزش، مدلهای مناسب را روی درخواستهای واقعی بسنجید و مشخص کنید مشکل به رفتار، اطلاعات یا انتخاب مدل مربوط است.
برای آزمایش مدلهای هوش مصنوعی در برنامه خود و ساخت یک مجموعه ارزیابی فارسی، از درواره شروع کنید؛ سپس با شواهد روشن درباره تنظیم اختصاصی مدل تصمیم بگیرید.
مقالات مرتبط
- Fine-tuning مدل زبانی با LoRA و QLoRA
- ارزیابی مدلهای هوش مصنوعی
- مدل زبانی بزرگ چیست؟
- تقطیر دانش در یادگیری ماشین
- Embeddingچیست؟
- آموزش استفاده از API هوش مصنوعی
منابع
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model
- پیادهسازی مرجعDPO
- Training Language Models to Follow Instructions with Human Feedback
- مستندات DPOTrainer در TRL نسخه۰٫۲۹
- مستندات SFTTrainer در TRL نسخه۰٫۲۹
- قالب دادههایTRL
- Disentangling Length from Quality in Direct Preference Optimization
- LoRA: Low-Rank Adaptation of Large Language Models
- کارت رسمیQwen2.5-0.5B-Instruct
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدلها و کتابخانهها و صفحه سلب مسئولیت را مطالعه کنید.



