
تفاوت مدل Base و Instruct چیست؟ راهنمای انتخاب مدل زبانی با مثالPython
تفاوت مدل Base و Instruct چیست و برای چتبات، تولید محتوا یا Fine-tuning کدام مناسبتر است؟ در این راهنما، پیشآموزش، تنظیم دستورپذیری، قالب گفتوگو و ارزیابی فارسی را بررسی میکنیم و دو مدل همخانواده را با Python آزمایش میکنیم.

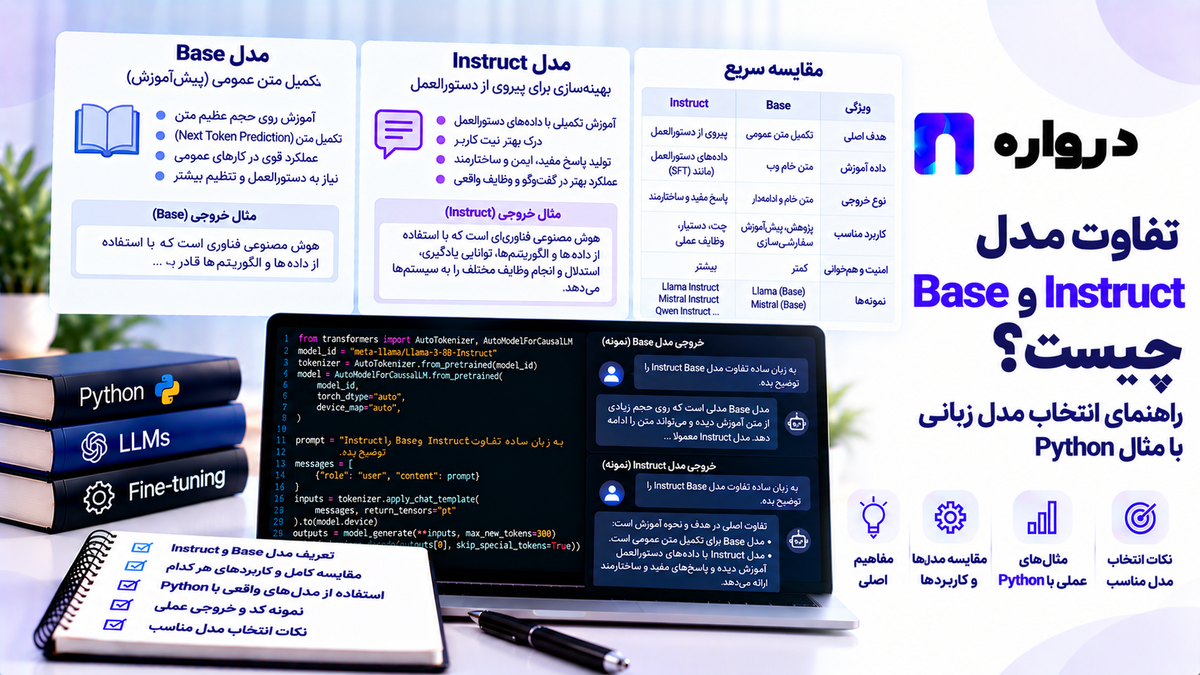
وقتی مدلهای زبانی را بررسی میکنید، ممکن است نسخههایی با نام Base، Instruct یا Chat ببینید. این نامها معمولاً به تفاوت در مراحل آموزش و رفتار مورد انتظار مدل اشاره دارند.
مدلBase نقطه شروعی است که از پیشآموزش روی داده به دست آمده است. در مدلهای مولد خودبازگشتی، هدف اصلی این مرحله یادگیری پیشبینی ادامه دنباله است.
مدلInstruct معمولاً با آموزش تکمیلی روی دستورها و پاسخهای مطلوب آماده شده تا درخواست کاربر را بهتر دنبال کند. برخی مدلها مراحل دیگری برای ترجیح پاسخهای مناسبتر نیز طی میکنند.
این تفاوت هنگام ساخت محصول اهمیت دارد. مدلی که ادامه متن را خوب تولید میکند، الزاماً در پاسخگویی به یک درخواست، رعایت قالب یا ادامه گفتوگو همان رفتار موردنیاز شما را ندارد.
در این مقاله بررسی میکنیم:
- مدل Base و Instruct چگونه آماده میشوند؟
- آیا Instruct همیشه بهتر است؟
- Chat Templateچه نقشی دارد؟
- برای چتبات فارسی یا Fine-tuning کدام انتخاب مناسبتر است؟
- چگونه دو نسخه همخانواده را با Python آزمایش کنیم؟
- چه معیارهایی برای انتخاب مدل در API لازم است؟
مدل Base چیست؟
Base Model یا مدل پایه معمولاً به نسخهای اشاره دارد که مرحله پیشآموزش را پشت سر گذاشته، اما هنوز تنظیم اختصاصی لازم برای رفتار گفتوگویی یا پیروی از دستور را دریافت نکرده است.
در یک مدل زبانی خودبازگشتی، پیشآموزش به مدل کمک میکند الگوهای متن و رابطه میان توکنها را یاد بگیرد. این الگوها میتوانند شامل زبان، ساختار جمله، قالب اسناد، کد و اطلاعات موجود در داده آموزشی باشند.
وقتی به چنین مدلی متن میدهید، رفتار طبیعی آن اغلب ادامهدادن دنباله است. البته با قالب مناسب و چند نمونه، ممکن است برخی وظایف را نیز انجام دهد.
مستندات Hugging Face، مدلهای فاقد پشتیبانی گفتوگویی را معمولاً با عنوان Base یا Pretrained معرفی میکند. Hugging Face
مدل Instruct چیست؟
Instruct Model مدلی است که برای دنبالکردن دستورها آموزش تکمیلی دیده است.
در این مرحله، نمونههایی از درخواست و پاسخ مطلوب به مدل داده میشود. برای مثال:
- «این متن را خلاصه کن.»
- «سه عنوان پیشنهاد بده.»
- «اطلاعات سفارش را از پیام استخراج کن.»
- «پاسخ را بهصورت فهرست بنویس.»
- «کد زیر را توضیح بده.»
پژوهش FLAN نشان داد تنظیم مدل با مجموعهای از وظایف دارای دستور متنی میتواند عملکرد آن را روی وظایف دیدهنشده بهبود دهد. میزان نتیجه به داده، مقیاس مدل و طراحی آموزش وابسته است. arxiv.org
Instructبودن تضمین اطاعت کامل از هر دستور نیست. این برچسب درباره مسیر آمادهسازی و هدف رفتار مدل اطلاعات میدهد؛ کیفیت واقعی باید آزموده شود.
مدل Chat چیست؟
نام Chat معمولاً برای نسخهای استفاده میشود که رفتار گفتوگویی آن تنظیم شده است؛ مثلاً نقشهای کاربر و دستیار، تاریخچه مکالمه و نوبتهای پاسخ را در قالب مورد انتظار دریافت میکند.
بااینحال، Base، Instruct و Chat یک نظام نامگذاری کاملاً یکسان میان همه سازندگان نیستند. ممکن است یک نسخه Instruct از گفتوگوی چندمرحلهای هم پشتیبانی کند یا نام نسخه رفتار آن را بهطور کامل نشان ندهد.
برای انتخاب، این موارد را بخوانید:
- کارت مدل
- توضیح مراحل آموزش
- قالب پیامهای مورد انتظار
- قابلیتها و محدودیتها
- نمونههای استفاده رسمی
- نتایج ارزیابی مرتبط با کاربرد شما
تفاوت پیشآموزش و تنظیم دستورپذیری
| مرحله | هدف معمول | نوع نمونه |
|---|---|---|
| پیشآموزش | یادگیری الگوهای داده و پیشبینی دنباله | متن، کد و سایر دادههای آموزشی |
| تنظیم دستورپذیری | یادگیری پاسخ مناسب به درخواست | دستور و پاسخ مطلوب |
| بهینهسازی ترجیح | ترجیح پاسخهای مناسبتر بر اساس معیار آموزشی | مقایسه یا ارزیابی پاسخها |
همه مدلها دقیقاً همین مراحل را طی نمیکنند. نوع داده، هدف آموزشی و ترتیب مراحل ممکن است متفاوت باشد.
در پژوهش InstructGPT، ابتدا از نمونههای پاسخ مطلوب برای تنظیم نظارتشده استفاده شد و سپس بازخورد ترجیحی در مراحل بعدی آموزش وارد شد. این یک روش مشخص پژوهشی است و نباید آن را روند ثابت تمام مدلهای Instruct دانست. arxiv.org
SFTچیست؟
Supervised Fine-Tuning یا SFT یعنی تنظیم مدل با نمونههایی که خروجی مطلوب آنها مشخص است.
در تنظیم دستورپذیری، یک نمونه میتواند شامل درخواست و پاسخ مناسب باشد. مدل در آموزش تلاش میکند پاسخ مطلوب را تولید کند.
مثال مفهومی:
| درخواست | پاسخ آموزشی مطلوب |
|---|---|
| «این پیام را رسمیتر کن.» | نسخه رسمیتر پیام |
| «شهر و شماره سفارش را استخراج کن.» | اطلاعات استخراجشده |
| «پاسخ را در دو جمله بنویس.» | پاسخ دو جملهای مرتبط |
این مرحله میتواند رفتار مدل را برای کاربرد بهتر تنظیم کند، اما کیفیت و تنوع داده اهمیت زیادی دارد. آموزش روی نمونههای ضعیف، تکراری یا نامتناسب با کاربرد میتواند نتیجه نامطلوبی داشته باشد.
چرا مدل Base گاهی پاسخ عجیب میدهد؟
فرض کنید به مدل پایه مینویسید:
«سه مزیت استفاده از API را توضیح بده.»
مدل ممکن است پاسخ مناسب تولید کند، اما ممکن است:
- متن را مانند بخشی از یک مقاله ادامه دهد.
- پرسشهای دیگری به آن اضافه کند.
- یک گفتوگوی ساختگی بسازد.
- دستور را تکرار کند.
- به قالبی شبیه داده آموزشی برود.
این رفتار لزوماً خرابی مدل نیست. شما از مدلی با هدف اصلی ادامه دنباله، رفتار دستیار خواستهاید.
نسخه Instruct برای چنین تعاملهایی آمادهتر است، ولی همچنان باید کیفیت، قالب و درستی پاسخ آن بررسی شود.
آیا مدل Base هیچ دستوری را دنبال نمیکند؟
خیر. مدلهای پایه ممکن است با Prompt مناسب یا مثالهای داخل ورودی، بعضی دستورها را انجام دهند.
برای نمونه، اگر چند مثال تبدیل جمله غیررسمی به رسمی را در ورودی قرار دهید، مدل میتواند الگو را ادامه دهد. این روش بخشی از یادگیری در متن درخواست است و با تغییر وزنهای مدل تفاوت دارد.
بااینحال، انجام چند نمونه موفق به معنی پایداری رفتار در درخواستهای متنوع نیست. برای یک محصول، میزان موفقیت روی مجموعه ارزیابی نماینده را بسنجید.
آیا مدل Instruct همیشه از Base بهتر است؟
پاسخ به وظیفه بستگی دارد.
برای دستیار و پاسخ به درخواستهای مستقیم، نسخه Instruct معمولاً گزینه منطقیتری برای شروع است. اما برای پژوهش، طراحی رفتار اختصاصی یا بعضی مسیرهای آموزش تکمیلی، مدل پایه میتواند گزینه مناسبی باشد.
| کاربرد | نقطه شروع قابل بررسی |
|---|---|
| چتبات عمومی | Instruct یا Chat |
| خلاصهسازی با دستور | Instruct |
| استخراج داده با قالب مشخص | Instruct با ارزیابی و اعتبارسنجی |
| پژوهش درباره پیشآموزش | Base |
| آموزش رفتار کاملاً اختصاصی | Base یا Instruct، بسته به طراحی |
| ادامه متن با قالب خاص | هر دو، پس از آزمون |
این جدول توصیه اولیه است. تصمیم نهایی باید از مقایسه واقعی به دست آید.
آیا Instruct بودن درستی پاسخ را تضمین میکند؟
خیر. پیروی از دستور و درستی محتوا دو معیار متفاوتاند.
ممکن است مدل:
- قالب خواستهشده را رعایت کند، اما عدد اشتباه بدهد.
- پاسخ روان بنویسد، اما منبع ناموجود معرفی کند.
- داده را استخراج کند، اما بخشی از آن را حدس بزند.
- پاسخ کوتاه بدهد، اما نکته لازم را حذف کند.
برای ارزیابی، دستکم این سه مورد را جدا ثبت کنید:
- درستی محتوا
- رعایت دستور
- رعایت قالب خروجی
ظاهر حرفهای پاسخ جای ارزیابی درستی را نمیگیرد.
Chat Templateچیست؟
مدل گفتوگویی معمولاً پیامها را در قالبی مشخص دریافت میکند. این قالب تعیین میکند نقشها و مرز پیامها چگونه به دنباله ورودی تبدیل شوند.
برای نمونه، برنامه شما ممکن است چنین ساختاری داشته باشد:
messages = [
    {
        "role": "user",
        "content": "سلام!",
    }
]
اما مدل در نهایت یک دنباله از توکنها دریافت میکند. Chat Template ساختار پیامها را به شکل مورد انتظار همان مدل تبدیل میکند.
مستندات Transformers توضیح میدهد که مدلهای مختلف ممکن است قالبها و توکنهای کنترلی متفاوت داشته باشند؛ حتی اگر از یک مدل پایه مشترک تنظیم شده باشند. Hugging Face
چرا قالب نادرست نتیجه را ضعیف میکند؟
مدل Instruct با ساختار مشخصی آموزش دیده است. اگر پیامها را با ساختاری متفاوت بدهید، ممکن است مرز نقشها یا محل آغاز پاسخ را درست دریافت نکند.
پیامدهای احتمالی عبارتاند از:
- تکرار متن ورودی
- تولید ادامه پیام کاربر
- ساخت نوبتهای گفتوگوی اضافی
- رعایتنکردن دستور
- ظاهرشدن نشانههای قالب در خروجی
قبل از نتیجهگیری درباره ضعف مدل، قالب رسمی ورودی و Tokenizer آن را بررسی کنید.
آیا باید برای مدل Base قالب Chat بگذاریم؟
فقط اگر مستندات یا طراحی آموزش همان مدل چنین قالبی را تعریف کرده باشد.
اضافهکردن توکنهای کنترلی یک مدل دیگر به مدل پایه، خودبهخود آن را به مدل گفتوگویی تبدیل نمیکند. بهتر است ورودی را متناسب با وظیفه ادامه متن یا نمونههای مورد استفاده طراحی کنید.
همچنین نبودن chat_template در فایلهای Tokenizer ممکن است کاملاً با نوع مدل سازگار باشد.
آموزش عملی مقایسه Base و Instruct باPython
برای یک آزمایش آموزشی، از دو نسخه کوچک همخانواده استفاده میکنیم:
HuggingFaceTB/SmolLM2-135MHuggingFaceTB/SmolLM2-135M-Instruct
کارت رسمی این خانواده، نسخه پایه و نسخه تنظیمشده را معرفی میکند. همچنین توضیح میدهد که این مدلها عمدتاً برای انگلیسی هستند؛ بنابراین مثال ما معیار انتخاب مدل فارسی نیست. Hugging Face
مدلها در اولین اجرا دانلود میشوند. کد را میتوان روی CPU اجرا کرد، اما به حافظه و فضای ذخیرهسازی کافی نیاز دارید.
نصب
pip install torch transformersساخت تابع تولید پاسخ
مدلها را یکییکی بارگذاری میکنیم تا هر دو همزمان در حافظه نگهداری نشوند.
import gc

import torch

from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
)


def generate_answer(
    model_id: str,
    request: str,
    use_chat_template: bool,
):
    tokenizer = (
        AutoTokenizer.from_pretrained(
            model_id
        )
    )

    model = (
        AutoModelForCausalLM.from_pretrained(
            model_id
        )
    )

    model.eval()

    if use_chat_template:
        if tokenizer.chat_template is None:
            raise ValueError(
                "This tokenizer has no "
                "chat template."
            )

        messages = [
            {
                "role": "user",
                "content": request,
            }
        ]

        inputs = (
            tokenizer.apply_chat_template(
                messages,
                tokenize=True,
                add_generation_prompt=True,
                return_dict=True,
                return_tensors="pt",
            )
        )

    else:
        inputs = tokenizer(
            request,
            return_tensors="pt",
        )

    input_length = (
        inputs["input_ids"]
        .shape[-1]
    )

    with torch.inference_mode():
        output_ids = (
            model.generate(
                **inputs,
                max_new_tokens=96,
                do_sample=False,
                pad_token_id=(
                    tokenizer.eos_token_id
                ),
            )
        )

    new_token_ids = output_ids[
        0,
        input_length:,
    ]

    answer = tokenizer.decode(
        new_token_ids,
        skip_special_tokens=True,
    )

    result = {
        "answer": answer,
        "input_tokens": input_length,
        "output_tokens": (
            new_token_ids.numel()
        ),
    }

    del model
    del tokenizer
    del inputs
    del output_ids

    gc.collect()

    return result
در حالت Instruct، قالب خود Tokenizer استفاده میشود. در حالت Base، متن مستقیم وارد میشود.
این مقایسه رفتار دو نسخه را با قالب متناسب با هرکدام نشان میدهد. تعداد توکن ورودی ممکن است بهدلیل قالب گفتوگو متفاوت باشد؛ آن را در خروجی ثبت میکنیم.
اجرای یک درخواست یکسان
request = (
    "Explain three benefits of using "
    "an AI API. Use exactly three "
    "short bullet points."
)

base_result = generate_answer(
    model_id=(
        "HuggingFaceTB/"
        "SmolLM2-135M"
    ),
    request=request,
    use_chat_template=False,
)

instruct_result = generate_answer(
    model_id=(
        "HuggingFaceTB/"
        "SmolLM2-135M-Instruct"
    ),
    request=request,
    use_chat_template=True,
)

print("BASE OUTPUT")
print(base_result["answer"])

print("\nINSTRUCT OUTPUT")
print(instruct_result["answer"])

print(
    "\nBase token counts:",
    base_result["input_tokens"],
    base_result["output_tokens"],
)

print(
    "Instruct token counts:",
    instruct_result["input_tokens"],
    instruct_result["output_tokens"],
)بهجای انتظار یک خروجی از پیش تعیینشده، این موارد را بررسی کنید:
- آیا مدل به موضوع درخواست پاسخ داده است؟
- آیا دقیقاً سه مورد نوشته است؟
- آیا موارد کوتاهاند؟
- آیا متن اضافی تولید کرده است؟
- آیا مطالب درست و قابل فهماند؟
یک آزمایش واحد برای اثبات برتری عمومی مدل کافی نیست.
آزمایش وظایف مختلف
برای مقایسه بهتر، چند نوع درخواست استفاده کنید:
requests = [
    (
        "Rewrite this sentence formally: "
        "'Hey, send me the file today.'"
    ),
    (
        "Summarize this text in one sentence: "
        "The team released a new feature, "
        "collected user feedback, and fixed "
        "two issues during the same week."
    ),
    (
        "Return only the city name from "
        "this text: 'The meeting will "
        "take place in London.'"
    ),
]میتوانید هر درخواست را با تابع قبلی اجرا کنید. این نسخه تابع برای سادگی در هر فراخوانی مدل را دوباره بارگذاری میکند؛ برای ارزیابی پرتعداد، مدل را یکبار بارگذاری و همه موارد را در همان اجرا پردازش کنید.
این کد بنچمارک سرعت نیست. زمان دانلود و بارگذاری را نیز نباید با زمان استنتاج درخواست اشتباه گرفت.
چگونه رعایت قالب را بررسی کنیم؟
برای بعضی وظایف، میتوان بررسی خودکار محدودی ساخت. مثلاً اگر خروجی باید JSON باشد، نخست بررسی کنید آیا قابل تجزیه است.
import json


def is_valid_json(text: str) -> bool:
    try:
        json.loads(text)
        return True
    except (
        json.JSONDecodeError,
        TypeError,
    ):
        return False
این تابع فقط معتبربودن نحوی JSON را بررسی میکند. ممکن است JSON معتبر باشد، اما فیلدهای لازم را نداشته باشد یا داده غلط در آن قرار گرفته باشد.
برای خروجی ساختاریافته، سه سطح را جدا بررسی کنید:
- معتبربودن ساختار
- وجود و نوع فیلدها
- درستی محتوای فیلدها
Instructبودن مدل هیچیک از این سطوح را بهتنهایی تضمین نمیکند.
برای چتبات فارسی Base انتخاب کنیم یا Instruct؟
برای شروع یک چتبات، نسخه Instruct یا Chat که پشتیبانی فارسی آن ارزیابی شده باشد معمولاً انتخاب مناسبتری است.
اما عبارت «پشتیبانی چندزبانه» یا «Instruct» برای تصمیم کافی نیست. درخواستهای فارسی واقعی را امتحان کنید:
- گفتوگوی رسمی و محاورهای
- دستورهای چندبخشی
- متن دارای نیمفاصله
- ترکیب فارسی و انگلیسی
- پاسخ بر اساس منبع ارائهشده
- استخراج عدد و نام
- رعایت قالب خروجی
ممکن است یک مدل در متن انگلیسی خوب عمل کند و در درخواست مشابه فارسی ضعیفتر باشد. ارزیابی زبان محصول را مستقل انجام دهید.
برای Fine-tuning کدام نسخه مناسبتر است؟
انتخاب نقطه شروع به هدف آموزش وابسته است.
شروع ازBase
وقتی میخواهید مسیر تنظیم رفتار را خودتان طراحی کنید یا برنامه آموزش متفاوتی دارید، مدل پایه میتواند مناسب باشد. این انتخاب معمولاً نیازمند داده و ارزیابی دقیق است.
شروع ازInstruct
وقتی رفتار دستیار موجود به هدف شما نزدیک است و میخواهید آن را برای دامنه یا قالب مشخص سازگار کنید، نسخه Instruct میتواند نقطه شروع مفیدی باشد.
اما آموزش تکمیلی ممکن است بعضی تواناییهای قبلی را تغییر دهد. بعد از Fine-tuning، هم وظیفه اختصاصی و هم قابلیتهای عمومی لازم برای محصول را ارزیابی کنید.
انتخاب Base یا Instruct را با چند نمونه موفق یا نام مدل نهایی نکنید؛ آزمایش محدود و قابل مقایسه انجام دهید.
آیا RAG مدل Base را به Instruct تبدیل میکند؟
RAG اطلاعات مرتبط را به ورودی اضافه میکند تا مدل بتواند هنگام پاسخ از آن استفاده کند.
این کار بهخودیخود وزنهای مدل را تغییر نمیدهد و آموزش دستورپذیری محسوب نمیشود. اگر مدل در رعایت دستور یا استفاده از منابع مشکل دارد، افزودن متن بیشتر الزاماً آن مشکل را حل نمیکند.
برای سامانه پرسشوپاسخ بر اساس اسناد، باید این موارد را بررسی کنید:
- بازیابی منابع درست
- قالب ارائه منابع به مدل
- توانایی مدل در استخراج پاسخ
- تفکیک اطلاعات منبع از حدس
- رفتار مدل هنگام نبودن پاسخ
نسخه Instruct مناسب میتواند نقطه شروع بهتری برای چنین تعاملی باشد، اما همچنان به ارزیابی نیاز دارد.
نقش System Prompt چیست؟
در مدلها و قالبهایی که نقش system را پشتیبانی میکنند، این پیام میتواند دستورهای عمومی تعامل را مشخص کند؛ مثلاً سبک پاسخ یا شیوه برخورد با اطلاعات ناکافی.
اما System Prompt جای آموزش مدل را نمیگیرد. نوشتن «همیشه درست پاسخ بده» درستی پاسخ را تضمین نمیکند.
همچنین همه مدلها نقشها و قالب یکسانی ندارند. مستندات همان مدل و API را بررسی کنید.
آیا تعداد پارامتر بیشتر ضعف دستورپذیری را جبران میکند؟
تعداد پارامترها یکی از ویژگیهای مدل است، اما رفتار تعاملی به مراحل آموزش و قالب ورودی نیز وابسته است.
یک مدل پایه بزرگ ممکن است در بعضی وظایف توانمند باشد، ولی برای تعامل مستقیم کاربر، نسخه کوچکتر تنظیمشده رفتار مناسبتری نشان دهد. برعکس، پیچیدگی بعضی وظایف ممکن است ظرفیت بیشتری نیاز داشته باشد.
برای محصول، سه پرسش را همزمان بررسی کنید:
- آیا مدل وظیفه را درست انجام میدهد؟
- آیا رفتار و قالب موردنیاز را رعایت میکند؟
- آیا زمان و هزینه آن قابل قبول است؟
چارچوب ارزیابی Base وInstruct
یک مجموعه نمونه نماینده بسازید و نتایج را بر اساس معیارهای مشخص ثبت کنید.
| معیار | نمونه بررسی |
|---|---|
| درستی | آیا عدد، نتیجه یا توضیح صحیح است؟ |
| رعایت دستور | آیا تعداد موارد و محدودیت خواستهشده رعایت شده؟ |
| قالب | آیا فقط خروجی خواستهشده آمده است؟ |
| کیفیت فارسی | آیا متن روان، طبیعی و قابل فهم است؟ |
| استفاده از منبع | آیا پاسخ با متن ارائهشده سازگار است؟ |
| طول پاسخ | آیا پاسخ کافی و متناسب است؟ |
| زمان | آیا تأخیر برای کاربرد مناسب است؟ |
| مصرف | ورودی و خروجی چه تعداد توکن دارند؟ |
برای مقایسه قابل اتکا:
- وظایف یکسان باشند.
- قالب صحیح هر مدل استفاده شود.
- تنظیمات تولید ثبت شوند.
- محدودیت خروجی روشن باشد.
- موارد شکست نیز در گزارش بمانند.
اشتباهات رایج هنگام انتخاب مدل
استفاده از مدل Base در چتبات بدون ارزیابی
ادامهدادن متن و رفتار دستیار دو هدف نزدیک اما متفاوتاند.
استفاده از قالب یک مدل برای مدل دیگر
Chat Templateباید با مدل مقصد سازگار باشد.
اعتماد به پسوندInstruct
نام نسخه درباره کیفیت فارسی، دقت یا پایداری محصول تضمین نمیدهد.
برابر دانستن پاسخ روان با پاسخ درست
درستی و روانی را جدا بررسی کنید.
مقایسه دو مدل با تنظیمات متفاوت
اگر طول پاسخ، نمونهبرداری یا ورودی فرق کند، مقایسه زمان و کیفیت دشوار میشود.
تصور اینکه Prompt طولانی همیشه رفتار را اصلاح میکند
دستور بیشتر میتواند هزینه و پیچیدگی را افزایش دهد. اثر آن را اندازه بگیرید.
شروع Fine-tuning پیش از ساختBaseline
ابتدا نسخه آماده را با Prompt و قالب صحیح امتحان کنید. ممکن است برای نیاز فعلی کافی باشد.
انتخاب مدل از طریق API درواره
برای استفاده از مدلهای آماده، معمولاً نیازی نیست خودتان وزن مدل یا Chat Template داخلی سرویس را مدیریت کنید. بااینحال، باید قابلیتها، مدل مقصد و ساختار درخواست پشتیبانیشده را بررسی کنید.
نمونه اتصال به API درواره:
pip install openaiمتغیرهای محیطی:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_MODEL_ID"
درخواست نمونه:
import osfrom openai import OpenAIclient = OpenAI( api_key=os.environ[ "DARVAREH_API_KEY" ], base_url=( "https://api.darvareh.ir/v1" ),)response = ( client.chat.completions.create( model=os.environ[ "DARVAREH_CHAT_MODEL" ], messages=[ { "role": "user", "content": ( "سه مزیت استفاده از API " "هوش مصنوعی را بنویس. " "پاسخ فقط سه مورد کوتاه باشد." ), } ], ))print( response.choices[0] .message.content)شناسه مدل را از فهرست فعلی انتخاب کنید و قابلیتهای مسیر موردنظر را در مستندات API درواره بررسی کنید. همه مدلها لزوماً از قابلیتها یا پارامترهای یکسان پشتیبانی نمیکنند.
برای مقایسه مدلها، همین درخواست و مجموعهای از نمونههای واقعی محصول را با گزینههای مختلف اجرا و کیفیت، زمان و مصرف را ثبت کنید.
پرسشهای متداول
تفاوت Base و Instruct چیست؟
Base معمولاً نسخه پیشآموزشدیده مدل است. Instructبرای پاسخگویی بهتر به دستورها آموزش تکمیلی دیده است.
آیا مدل Base میتواند پاسخ سؤال بدهد؟
بله، ممکن است با قالب مناسب یا نمونههای داخل ورودی پاسخ دهد. میزان پایداری آن باید آزموده شود.
برای چتبات کدام مناسبتر است؟
نسخه Instruct یا Chat با کیفیت ارزیابیشده در زبان و وظیفه موردنظر، معمولاً نقطه شروع مناسبتری است.
آیا Instruct همان Chat است؟
نامگذاری سازندگان کاملاً یکسان نیست. قابلیت گفتوگو و قالب پیامها را در مستندات همان مدل بررسی کنید.
آیا Instruct پاسخ درست را تضمین میکند؟
خیر. پیروی از دستور، کیفیت قالب و درستی محتوا معیارهای جداگانهاند.
Chat Templateچیست؟
قالبی است که پیامها و نقشها را به دنباله مورد انتظار مدل گفتوگویی تبدیل میکند.
آیا میتوان مدل Base را با System Prompt به Instruct تبدیل کرد؟
Promptممکن است رفتار را هدایت کند، اما جای آموزش تنظیم دستورپذیری را نمیگیرد.
برای Fine-tuning باید از Base شروع کرد؟
الزاماً خیر. Base و Instruct هر دو میتوانند بسته به هدف، داده و برنامه آموزشی نقطه شروع باشند.
آیا Instruct برای فارسی بهتر است؟
باید نسخههای مشخص را مقایسه کرد. برچسب Instruct بهتنهایی کیفیت فارسی را تعیین نمیکند.
جمعبندی
مدل Base از پیشآموزش به دست میآید و در مدل مولد، رفتار اصلی آن پیشبینی ادامه دنباله است. مدل Instruct با آموزش تکمیلی برای پاسخگویی به دستورها آماده میشود.
برای استفاده درست، نسخه مدل، Tokenizer و قالب پیامها باید هماهنگ باشند. انتخاب مدل نیز باید بر اساس درستی پاسخ، رعایت دستور، کیفیت فارسی، زمان و هزینه انجام شود.
برای آزمایش مدلهای آماده و انتخاب گزینه مناسب محصول، مدلها و خدمات API درواره را در darvareh.ir بررسی کنید. چند مدل را با درخواستهای واقعی فارسی مقایسه کنید و تصمیم را بر اساس نتیجه ثبتشده بگیرید.
مقالات مرتبط
- مدل زبانی بزرگ یا LLM چیست؟
- معماری Transformer وAttention
- Fine-tuning با LoRA و QLoRA
- مدل کوچک زبانی یا SLM چیست؟
- ارزیابی مدلهای هوش مصنوعی
- مسیریابی مدلهای هوش مصنوعی
- آموزش استفاده از API هوش مصنوعی
منابع
- Finetuned Language Models Are Zero-Shot Learners
- Training Language Models to Follow Instructions with Human Feedback
- مستندات Chat Templates درHugging Face Transformers
- مستندات گفتوگو با مدلها درTransformers
- مدلSmolLM2-135M
- مدلSmolLM2-135M-Instruct
- مستندات API درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی مدل و سرویس موردنظر و صفحه سلب مسئولیت درواره را مطالعه کنید.



