
ColBERT چیست؟ آموزش جستوجوی چندبرداری و Late Interaction با Python
ColBERT چیست و چگونه با جستوجوی چندبرداری، ارتباط پرسش و سند را بررسی میکند؟ در این راهنما، Late Interaction، امتیاز MaxSim، تفاوت با Cross-Encoder و پیادهسازی عملی با Python و Qdrant را میآموزید.

در یک سامانه جستوجوی معنایی، پیدا کردن سندی که درباره موضوع پرسش صحبت میکند کافی نیست. سند باید جزئیات موردنظر کاربر را نیز پوشش دهد.
فرض کنید کاربر میپرسد:
چگونه مدل هوش مصنوعی را روی CPU و بدون کارت گرافیک اجرا کنیم؟
سندی درباره «آموزش مدل با چند GPU» از نظر موضوعی به این پرسش نزدیک است، اما پاسخ مناسبی ارائه نمیدهد. عبارتهای «روی CPU» و «بدون کارت گرافیک» در این جستوجو تعیینکنندهاند.
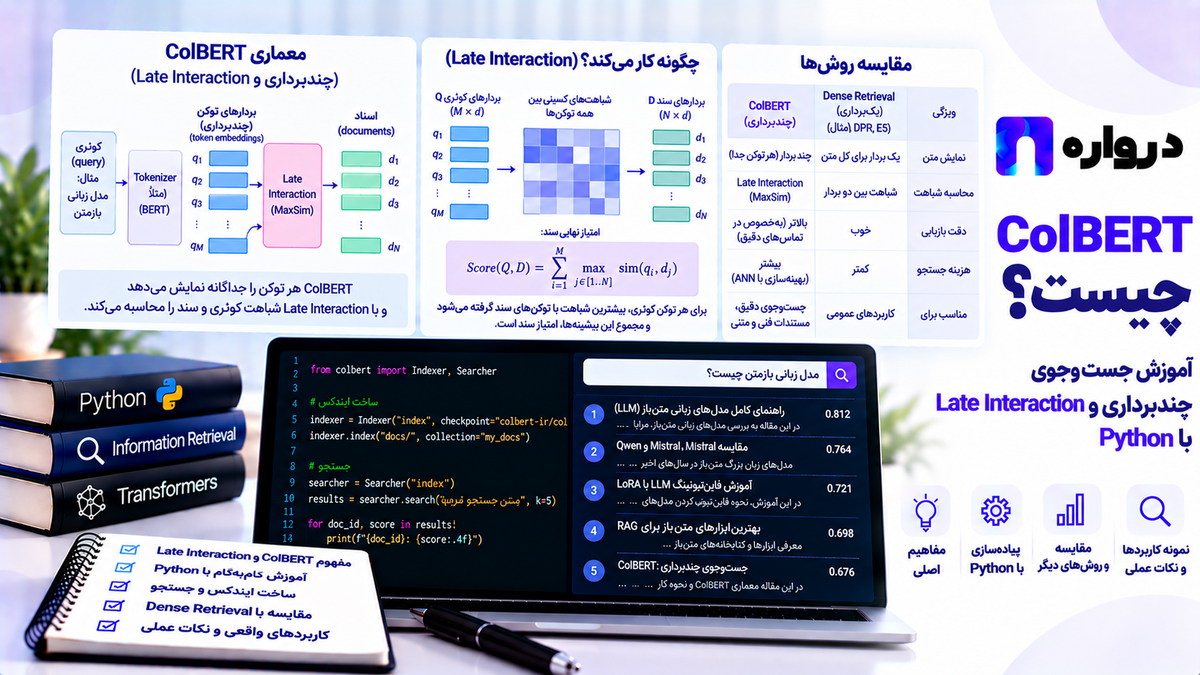
ColBERT رویکردی برای بازیابی اطلاعات است که پرسش و سند را با مجموعهای از بردارهای وابسته به توکن نمایش میدهد. سپس ارتباط این بردارها را برای امتیازدهی به سند بررسی میکند.
این معماری به خانواده روشهای Late Interactionیا تعامل دیرهنگام تعلق دارد. مقاله اصلی ColBERT این روش را برای ترکیب نمایشهای زمینهمند BERT با محاسبات قابلاستفاده در جستوجوی اسناد معرفی کرد. arxiv.org
در این مقاله، تفاوت ColBERT با Embedding معمولی و Cross-Encoder را بررسی میکنیم، سازوکار MaxSim را با یک مثال عددی میسازیم و سپس جستوجوی چندبرداری را با FastEmbed و Qdrant پیادهسازی میکنیم.
ColBERTچیست؟
ColBERTمدلی برای ارزیابی ارتباط پرسش و متن است.
در بسیاری از مدلهای Embedding، هر قطعه متن به یک بردار تبدیل میشود. در ColBERT، نمایش متن یک ماتریس از بردارهای توکن است؛ بنابراین اطلاعات متن پیش از مقایسه با پرسش، به یک بردار نهایی واحد خلاصه نمیشود.
واژه «زمینهمند» در اینجا اهمیت دارد. نمایش یک توکن به جملهای که در آن قرار گرفته وابسته است. در نتیجه، بردار یک عبارت صرفاً برچسب ثابتی برای آن کلمه نیست.
برای مثال، معنای «مدل» در «مدل زبانی» با کاربرد آن در «مدل کسبوکار» متفاوت است. یک رمزگذار زمینهمند تلاش میکند این تفاوت را در نمایش توکن منعکس کند.
ColBERTبرای بازیابی و رتبهبندی متن طراحی شده است. پاسخ نهایی یک چتبات معمولاً در مرحلهای جداگانه، توسط مدل زبانی تولید میشود.
جستوجوی تکبرداری و چندبرداری چه تفاوتی دارند؟
در جستوجوی تکبرداری، یک پرسش و هر سند با یک بردار نمایش داده میشوند. موتور جستوجو نزدیکی این بردارها را محاسبه میکند.
در جستوجوی چندبرداری، هر متن چند بردار دارد و امتیاز نهایی از مقایسه مجموعه بردارهای پرسش با مجموعه بردارهای سند به دست میآید.
| ویژگی | جستوجوی تکبرداری | جستوجوی چندبرداری |
|---|---|---|
| نمایش هر قطعه متن | یک بردار | مجموعهای از بردارها |
| سطح مقایسه | نمایش کلی متن | نمایشهای جزئیتر متن |
| حجم داده برداری | معمولاً کمتر | معمولاً بیشتر |
| محاسبه امتیاز | مقایسه دو بردار | ترکیب چندین مقایسه |
| پیادهسازی اولیه | سادهتر | نیازمند پشتیبانی چندبرداری |
| انتخاب مناسب | بر اساس ارزیابی مسئله | بر اساس ارزیابی مسئله |
نگهداری چند بردار میتواند امکان تطبیق دقیقتری میان بخشهای پرسش و سند فراهم کند، اما هزینه ذخیرهسازی و محاسبات را نیز افزایش میدهد. این مبادله در مستندات رسمی Qdrant برای نمایشهای چندبرداری توضیح داده شده است. Qdrant
چندبرداریبودن بهتنهایی تضمین نمیکند نتیجه بهتر باشد. کیفیت مدل، زبان داده، نحوه قطعهبندی و روش بازیابی نیز باید بررسی شوند.
Late Interactionچیست؟
Late Interactionیعنی پرسش و سند ابتدا مستقل از یکدیگر رمزگذاری شوند و تعامل میان نمایشهای آنها بعداً، هنگام امتیازدهی، انجام شود.
این جداسازی یک مزیت عملی دارد: بردارهای اسناد را میتوان پیش از دریافت پرسش محاسبه و ذخیره کرد.
هنگام جستوجو، سامانه نمایش پرسش را میسازد و آن را با نمایشهای آماده اسناد مقایسه میکند.
در مقابل، یک Cross-Encoder معمولاً پرسش و سند را با هم وارد شبکه میکند. بنابراین برای هر جفت پرسش و سند باید یک پردازش مشترک انجام شود. مستندات Sentence Transformers همین تفاوت را میان Cross-Encoder و مدلهای دارای رمزگذاری مستقل توضیح میدهد. Sentence Transformers documentation
تفاوت ColBERT باCross-Encoder
برای انتخاب میان این دو، بهتر است ببینید سامانه چه تعداد سند را بررسی میکند و چه مقدار تأخیر قابلقبول است.
| معیار | ColBERT | Cross-Encoder |
|---|---|---|
| ورودی رمزگذار | پرسش و سند بهصورت جداگانه | جفت پرسش و سند |
| نمایش ذخیرهشده سند | قابلاستفاده مجدد | معمولاً نمایش مستقل کافی برای امتیاز نهایی ندارد |
| محل تعامل پرسش و سند | پس از رمزگذاری | داخل شبکه |
| خروجی مورد استفاده | نمایشهای توکن و امتیاز تطبیق | امتیاز جفت پرسش و سند |
| کاربرد | بازیابی یا بازرتبهبندی | معمولاً بازرتبهبندی نامزدها |
از این تفاوت نمیتوان نتیجه گرفت که ColBERT همیشه دقیقتر یا سریعتر است. برای نمونه، زمان رمزگذاری پرسش، تعداد نامزدها و طول متنها میتوانند نتیجه مقایسه را تغییر دهند.
یک آزمایش مفید این است که هر دو مدل، همان مجموعه نامزدها را رتبهبندی کنند. به این ترتیب، تفاوت کیفیت مرحله اول جستوجو با تفاوت کیفیت بازرتبهبندی اشتباه گرفته نمیشود.
MaxSimچیست؟
MaxSim روش اصلی ترکیب شباهتهای توکن در ColBERTاست.
سازوکار آن را میتوان بدون فرمول به این صورت توضیح داد:
- یک بردار از پرسش انتخاب میشود.
- شباهت آن با تمام بردارهای سند محاسبه میشود.
- بیشترین شباهت نگه داشته میشود.
- این کار برای بردارهای دیگر پرسش تکرار میشود.
- مقدارهای انتخابشده با هم جمع میشوند.
بنابراین هر بخش از پرسش، بهترین تطبیق خود را در سند پیدا میکند.
Qdrantنیز مقایسهگر MAX_SIM را برای نمایشهای چندبرداری ارائه میکند. Qdrant
امتیاز MaxSim چه معنایی ندارد؟
امتیاز بالا به معنای احتمال قطعی مرتبطبودن سند نیست.
همچنین این امتیاز ثابت نمیکند که سند:
- پاسخ کامل دارد؛
- اطلاعات بهروز ارائه میکند؛
- تمام شرطهای پرسش را رعایت کرده است؛
- فاقد تناقض است.
MaxSimیک سیگنال برای رتبهبندی است. ارزیابی پاسخ نهایی همچنان به بررسی محتوای سند و رفتار مدل پاسخدهنده نیاز دارد.
چرا ترتیب پرسش و سند اهمیت دارد؟
در این روش، بیشینه شباهت برای هر بردار پرسش انتخاب میشود.
اگر جای پرسش و سند عوض شود، تعداد و معنای تطبیقها تغییر میکند. بنابراین نباید این امتیاز را مانند یک فاصله متقارن عمومی میان دو متن در نظر گرفت.
همچنین یک بردار سند میتواند بهترین تطبیق چند بردار پرسش باشد؛ تطبیقها الزاماً یکبهیک نیستند.
پیادهسازی MaxSim باNumPy
ابتدا فقط سازوکار امتیازدهی را پیادهسازی میکنیم. این مثال به دانلود مدل نیاز ندارد.
نصب کتابخانه:
pip install numpyتابع زیر ردیفهای ماتریس را نرمال میکند و امتیاز مبتنی بر شباهت کسینوسی را محاسبه میکند:
import numpy as np


def normalize_rows(matrix):
    matrix = np.asarray(matrix, dtype=np.float32)

    if matrix.ndim != 2 or matrix.shape[0] == 0:
        raise ValueError("Expected a non-empty 2D matrix.")

    norms = np.linalg.norm(
        matrix,
        axis=1,
        keepdims=True,
    )

    return matrix / np.maximum(norms, 1e-12)


def maxsim(query_vectors, document_vectors):
    query_vectors = normalize_rows(query_vectors)
    document_vectors = normalize_rows(document_vectors)

    if query_vectors.shape[1] != document_vectors.shape[1]:
        raise ValueError("Vector dimensions must match.")

    similarities = query_vectors @ document_vectors.T
    best_matches = similarities.max(axis=1)

    return float(best_matches.sum())
اکنون دو سند فرضی را مقایسه میکنیم:
query = np.array([
    [1.0, 0.0],
    [0.0, 1.0],
])

document_a = np.array([
    [1.0, 0.0],
    [0.0, 1.0],
])

document_b = np.array([
    [1.0, 0.0],
    [1.0, 0.0],
])

print(maxsim(query, document_a))
print(maxsim(query, document_b))
خروجی:
2.0
1.0
سند اول برای هر دو جهت پرسش تطبیق کامل دارد. سند دوم فقط یکی از جهتها را پوشش میدهد.
این بردارها ساختگیاند و نمایش معنایی جمله واقعی نیستند. مثال صرفاً نشان میدهد امتیاز چگونه از چند تطبیق جزئی ساخته میشود.
تولید بردارهای واقعی ColBERT باFastEmbed
برای مثال عملی از مدل colbert-ir/colbertv2.0 استفاده میکنیم.
کارت رسمی این مدل، زبان آن را انگلیسی معرفی میکند؛ به همین دلیل داده این بخش انگلیسی است. اجرای موفق کد با متن فارسی، بهتنهایی مدرک کیفیت مناسب بازیابی فارسی نخواهد بود. Hugging Face
نصب کتابخانهها:
pip install fastembed numpy "qdrant-client>=1.14.2"ساخت مدل و تعریف اسناد:
from fastembed import LateInteractionTextEmbedding


encoder = LateInteractionTextEmbedding(
    model_name="colbert-ir/colbertv2.0",
)

documents = [
    {
        "id": 0,
        "title": "CPU inference",
        "text": (
            "Run a small language model on a CPU "
            "without a dedicated graphics card."
        ),
    },
    {
        "id": 1,
        "title": "Multi-GPU training",
        "text": (
            "Train a large language model using "
            "multiple GPUs and distributed training."
        ),
    },
    {
        "id": 2,
        "title": "Image preprocessing",
        "text": (
            "Resize images and normalize pixel values "
            "before training a vision model."
        ),
    },
]

document_vectors = list(
    encoder.embed([
        document["text"]
        for document in documents
    ])
)

query_text = "How can I run a language model without a GPU?"

query_vectors = list(
    encoder.query_embed(query_text)
)[0]

for document, vectors in zip(documents, document_vectors):
    print(document["title"], vectors.shape)
FastEmbedبرای متن سند از embed و برای پرسش از query_embed استفاده میکند. این تفاوت را حفظ کنید؛ پیشپردازش پرسش و سند در ColBERT یکسان نیست. Qdrant
در اولین اجرا، فایلهای مدل دانلود میشوند. خروجی هر سند یک ماتریس است و تعداد ردیفهای آن به پردازش توکنهای متن وابسته خواهد بود.
رتبهبندی اسناد با تابعMaxSim
تابعی را که در بخش قبل ساختیم روی بردارهای واقعی اجرا میکنیم:
ranked_results = []

for document, vectors in zip(documents, document_vectors):
    ranked_results.append({
        "id": document["id"],
        "title": document["title"],
        "text": document["text"],
        "score": maxsim(query_vectors, vectors),
    })

ranked_results.sort(
    key=lambda result: result["score"],
    reverse=True,
)

for result in ranked_results:
    print(
        result["id"],
        result["title"],
        round(result["score"], 4),
    )
این پیادهسازی تمام اسناد مثال را بررسی میکند. برای سه سند مناسب است، اما نباید همین حلقه را بدون طراحی شاخص و اندازهگیری هزینه روی میلیونها قطعه متن اجرا کرد.
امتیازها و ترتیب واقعی را باید هنگام اجرای مدل مشاهده کرد؛ برای این مثال، خروجی مدل از پیش فرض نشده است.
ذخیره بردارها و جستوجو باQdrant
برای آزمایش محلی میتوان از حالت حافظهای Qdrant Client استفاده کرد. داده این حالت با پایان برنامه پایدار نمیماند.
کد زیر ادامه مثال قبلی است:
from qdrant_client import QdrantClient, models


database = QdrantClient(":memory:")
collection_name = "colbert_demo"

database.create_collection(
    collection_name=collection_name,
    vectors_config=models.VectorParams(
        size=int(document_vectors[0].shape[1]),
        distance=models.Distance.COSINE,
        multivector_config=models.MultiVectorConfig(
            comparator=models.MultiVectorComparator.MAX_SIM,
        ),
    ),
)

database.upsert(
    collection_name=collection_name,
    points=[
        models.PointStruct(
            id=document["id"],
            vector=vectors.tolist(),
            payload={
                "title": document["title"],
                "text": document["text"],
            },
        )
        for document, vectors in zip(
            documents,
            document_vectors,
        )
    ],
)

search_response = database.query_points(
    collection_name=collection_name,
    query=query_vectors.tolist(),
    limit=3,
    with_payload=True,
)

for point in search_response.points:
    print(
        point.id,
        point.score,
        point.payload["title"],
    )
در این ساختار، هر سند یک نقطه است و چند بردار در نمایش همان نقطه ذخیره میشوند. امتیاز بازگشتی نیز برای سند است، نه یک خروجی مستقل برای هر توکن.
ColBERT در RAGچه نقشی دارد؟
در RAG، مدل زبانی پاسخ را با استفاده از متنهای بازیابیشده تولید میکند. ColBERT میتواند در انتخاب یا مرتبسازی این متنها نقش داشته باشد.
دو طراحی قابلآزمایش وجود دارد.
استفاده برای بازیابی اولیه
پرسش مستقیماً با شاخص چندبرداری جستوجو میشود.
این طراحی نیازمند موتور بازیابی مناسب است. مثال کوچک Qdrant را نباید معادل یک سامانه بهینهشده در مقیاس بزرگ دانست.
استفاده برای بازرتبهبندی
ابتدا یک جستوجوی واژگانی، برداری یا ترکیبی، مجموعهای از اسناد نامزد را پیدا میکند. سپس ColBERT ترتیب این نامزدها را اصلاح میکند.
مستندات Qdrant این الگو را برای محدودکردن هزینه مقایسه چندبرداری بررسی میکند. در چنین کاربردی، ساخت شاخص HNSW برای تمام بردارهای توکن همیشه ضروری نیست و باید با طراحی مرحله اول هماهنگ شود. Qdrant
برای شروع، میتوانید چند اندازه متفاوت برای مجموعه نامزدها آزمایش کنید و ببینید افزایش آن چه اثری بر کیفیت و تأخیر دارد.
محدودیت مهم بازرتبهبندی
اگر سند پاسخگو وارد مجموعه نامزدها نشده باشد، بازرتبهبندی نمیتواند آن را بازیابی کند.
برای مثال، اگر پاسخ صحیح در رتبه ۳۰۰ مرحله اول قرار گرفته باشد، بازرتبهبندی ۵۰ نتیجه اول به آن دسترسی ندارد.
به همین دلیل، ابتدا باید پوشش مرحله بازیابی و سپس کیفیت ترتیب نتایج را اندازهگیری کرد.
ColBERTv2چه چیزی را تغییر داد؟
یکی از مشکلات نمایش توکنمحور، حجم زیاد داده برداری است.
ColBERTv2 با ترکیب فشردهسازی باقیمانده و روش آموزش مبتنی بر نظارت پالایششده، کیفیت و هزینه ذخیرهسازی را هدف قرار داد. مقاله آن کاهش حجم نمایشهای Late Interactionرا در شرایط آزمایش خود گزارش میکند. arxiv.org
بااینحال، بارگذاری وزنهای ColBERTv2 به این معنا نیست که هر پایگاه برداری، بهصورت خودکار شاخص فشرده مقاله را میسازد.
در مثال این مقاله، ماتریسهای خروجی در Qdrant ذخیره میشوند. برای مقایسه هزینه واقعی، باید قالب ذخیره، تنظیمات موتور و روش فشردهسازی را نیز مشخص کنید.
PLAIDچیست؟
PLAID یک موتور بهینهشده برای بازیابی Late Interactionاست.
این موتور از نمایشهای مبتنی بر مرکز خوشه و حذف زودهنگام نامزدهای کمامتیاز استفاده میکند تا هزینه جستوجو کاهش یابد. مقاله PLAID نتایج سرعت خود را روی پیکربندیها و مجموعهدادههای مشخص گزارش کرده است. arxiv.org
نکته عملی این است که مدل و موتور جستوجو دو انتخاب جداگانهاند. یک مدل مناسب با حلقه مقایسه ساده ممکن است در مجموعه بزرگ کند باشد؛ همان مدل با شاخص تخصصی میتواند رفتار متفاوتی داشته باشد.
اعداد سرعت یک مقاله را بدون بازتولید شرایط، به سامانه خود تعمیم ندهید.
هزینه ذخیرهسازی چندبرداری چقدر است؟
برای برآورد اولیه، یک مثال فرضی در نظر بگیریم:
- هر قطعه متن ۱۰۰ بردار دارد.
- هر بردار ۱۲۸ مقدار دارد.
- هر مقدار با
float32ذخیره میشود.
فقط داده خام برداری چنین قطعهای حدود ۵۰ کیبیبایت فضا میگیرد.
در مقابل، یک بردار ۷۶۸بعدی با همین نوع داده حدود ۳ کیبیبایت است.
| نمایش فرضی | فضای خام هر قطعه |
|---|---|
| یک بردار ۷۶۸بعدی | ۳ کیبیبایت |
| ۱۰۰ بردار ۱۲۸بعدی | ۵۰ کیبیبایت |
این مقایسه درباره دو قالب فرضی است؛ نه برآورد قطعی یک محصول.
متن سند، فراداده، شاخص جستوجو، نسخههای تکراری و سربار پایگاه داده در این محاسبه نیامدهاند. فشردهسازی نیز میتواند نتیجه را تغییر دهد.
برای تخمین واقعی، ابتدا چند هزار قطعه نماینده را وارد موتور کنید و مصرف حافظه و دیسک را اندازه بگیرید.
استفاده از ColBERT برای متن فارسی
برای پروژه فارسی، پیشنهاد میشود یک مجموعه ارزیابی کوچک اما متنوع پیش از انتخاب مدل آماده کنید.
این مجموعه بهتر است شامل موارد زیر باشد:
- پرسش رسمی و محاورهای؛
- عبارتهای فارسی و انگلیسی در یک جمله؛
- نام محصول و کد مدل؛
- شکلهای متفاوت نیمفاصله؛
- اعداد فارسی و لاتین؛
- پرسشهای دارای شرط و نفی.
شرطهای پرسش را جداگانه آزمایش کنید
برای مثال، این پرسشها نباید صرفاً به دلیل شباهت موضوعی، نتایج یکسانی داشته باشند:
- «اجرای مدل باGPU»
- «اجرای مدل بدونGPU»
- «اجرای مدل با کمتر از هشت گیگابایت حافظه»
- «اجرای مدل روی CPU بدون اتصال اینترنت»
برای هر پرسش، چند سند مرتبط و چند سند نزدیک اما نادرست آماده کنید. این نمونههای دشوار نشان میدهند مدل تا چه حد شرطهای تعیینکننده را رعایت میکند.
پیشپردازش را مستند کنید
یکسانسازی «ی» و «ک» میتواند بخشی از خط پردازش باشد، اما تغییر متن باید کنترلشده انجام شود.
برای اسناد فنی، حذف علامتها ممکن است نامهایی مانند C++ یا کدهای خطا را خراب کند. بهتر است متن اصلی برای نمایش و ارجاع نگه داشته شود و نسخه پردازششده، جداگانه ساخته شود.
همان نسخه پیشپردازش باید در ارزیابی و استقرار استفاده شود.
قطعهبندی اسناد را چگونه تنظیم کنیم؟
قطعهبندی را همراه با مدل بازیابی آزمایش کنید.
قطعه بسیار کوتاه ممکن است شرط لازم برای فهم پاسخ را از بخش اصلی جدا کند. قطعه بسیار بلند نیز ممکن است اطلاعات نامرتبط زیادی داشته باشد یا در پردازش مدل قطع شود.
برای مثال، جداشدن جمله «این قابلیت فقط در نسخه سازمانی فعال است» از توضیح اصلی قابلیت، میتواند باعث پاسخ ناقص شود.
یک آزمایش اولیه میتواند چند تنظیم متفاوت داشته باشد:
| تنظیم | هدف آزمایش |
|---|---|
| قطعات کوتاه با همپوشانی کم | بررسی بازیابی جزئیات محدود |
| قطعات متوسط با حفظ عنوان بخش | حفظ زمینه موضوعی |
| قطعهبندی بر اساس بند و ساختار سند | جلوگیری از جداشدن شرطها و استثناها |
اندازه مناسب را از روی کیفیت پاسخ و هزینه انتخاب کنید. عدد ثابت و عمومی برای همه اسناد وجود ندارد.
چگونه کیفیت ColBERT را ارزیابی کنیم؟
برای ارزیابی، هر پرسش باید اسناد مرتبط مشخصی داشته باشد. این برچسبها میتوانند با بررسی متخصص موضوع تهیه شوند.
سپس چند سامانه را روی داده یکسان مقایسه کنید:
- جستوجوی واژگانی؛
- جستوجوی تکبرداری؛
- جستوجوی ترکیبی؛
- همان جستوجو با بازرتبهبندی ColBERT؛
- همان نامزدها باCross-Encoder.
معیارهای پیشنهادی
| معیار | پرسشی که پاسخ میدهد |
|---|---|
| Recall@K | چه سهمی از اسناد مرتبط در نتایج منتخب آمدهاند؟ |
| MRR | اولین نتیجه مرتبط معمولاً در چه رتبهای است؟ |
| nDCG@K | ترتیب نتایج با درجه ارتباط آنها چقدر سازگار است؟ |
| تأخیر میانه | درخواست معمولی چقدر زمان میبرد؟ |
| تأخیر صدک ۹۵ | درخواستهای کندتر چه وضعیتی دارند؟ |
| مصرف حافظه و دیسک | هزینه نگهداری شاخص چقدر است؟ |
| زمان بهروزرسانی | افزودن یا اصلاح سند چقدر طول میکشد؟ |
معیار انتخاب نهایی باید با کاربرد هماهنگ باشد. در سامانهای که فقط سه قطعه وارد مدل زبانی میکند، کیفیت رتبههای اول اهمیت ویژهای دارد.
ارزیابی بازیابی را از ارزیابی پاسخ جدا کنید
دو آزمایش انجام دهید:
- آیا سند درست بازیابی شد؟
- آیا مدل زبانی با همان سند، پاسخ درست تولید کرد؟
اگر سند درست در ورودی مدل موجود باشد اما پاسخ اشتباه تولید شود، تغییر بازیاب الزاماً مشکل را حل نمیکند.
همچنین متن تکراری میتواند چند جایگاه برتر را اشغال کند. حذف نتایج تکراری را در طراحی آزمایش لحاظ کنید.
اشتباهات رایج در استفاده ازColBERT
تبدیل خروجی به میانگین یک بردار
اگر بردارهای توکن را میانگین بگیرید، دیگر همان سازوکار چندبرداری MaxSim را ارزیابی نمیکنید.
استفاده از رمزگذاری سند برای پرسش
در نمونه FastEmbed، مسیر query_embed را برای پرسش نگه دارید. جایگزینکردن آن با embed ممکن است رفتار مدل را تغییر دهد.
فرض کیفیت فارسی از روی اجرای موفق
قابلپردازشبودن یک متن با توانایی رتبهبندی درست آن برابر نیست.
تنظیم آستانه عمومی روی امتیاز خام
آستانهای که برای یک مدل و مجموعه پرسش مناسب است، الزاماً برای مدل یا داده دیگر معتبر نیست.
مقایسه با Baseline ضعیف
اگر جستوجوی تکبرداری پیشپردازش یا قطعهبندی مناسبی ندارد، برتری سامانه جدید ممکن است ناشی از همین تفاوت باشد.
اندازهگیری فقط زمان امتیازدهی
زمان کل شامل پردازش پرسش، بازیابی نامزدها، دریافت داده، بازرتبهبندی و آمادهسازی متن برای مدل زبانی است.
چه زمانی ColBERT را آزمایش کنیم؟
ColBERTگزینهای قابلآزمایش است وقتی خطای اصلی سامانه به انتخاب اسنادی مربوط باشد که موضوع کلی را دارند اما جزئیات پرسش را پوشش نمیدهند.
برای مثال:
- جستوجوی مستندات فنی با شرط نسخه یا سختافزار؛
- بازیابی راهنمای محصول؛
- جستوجو میان مقالات تخصصی؛
- مرتبسازی نتایج یک سامانه RAG؛
- جستوجوی پرسشهای چندبخشی.
اگر مشکل از نبود سند، اطلاعات قدیمی یا قطعهبندی ناقص باشد، ابتدا همان مشکل را اصلاح کنید.
برای تصمیم عملی، یک آزمایش محدود با داده واقعی معمولاً مفیدتر از تعویض کامل زیرساخت است.
پرسشهای متداول
ColBERTچیست؟
ColBERTیک مدل بازیابی اطلاعات است که متن را با نمایشهای برداری وابسته به توکن رمزگذاری میکند و ارتباط پرسش و سند را با تعامل دیرهنگام میسنجد.
Late Interactionیعنی چه؟
یعنی پرسش و سند جداگانه رمزگذاری میشوند و مقایسه نمایشهای آنها پس از رمزگذاری انجام میشود.
آیا ColBERT یک مدل تولید متن است؟
خیر. وظیفه اصلی آن بازیابی یا رتبهبندی متن است. تولید پاسخ میتواند به مدل زبانی دیگری سپرده شود.
تفاوت ColBERT با Embedding معمولی چیست؟
در بسیاری از مدلهای Embedding، هر متن یک بردار دارد. ColBERT چند نمایش توکن را برای مقایسه نگه میدارد.
آیا ColBERT همیشه از Cross-Encoder بهتر است؟
خیر. کیفیت و سرعت باید روی داده، سختافزار و تعداد نامزدهای یکسان مقایسه شوند.
آیا مدل مثال برای فارسی مناسب است؟
مدل colbert-ir/colbertv2.0 در کارت رسمی با زبان انگلیسی معرفی شده است. برای فارسی باید مدل مناسب انتخاب و کیفیت آن مستقلاً ارزیابی شود.
آیا امتیاز MaxSim احتمال مرتبطبودن سند است؟
خیر. امتیاز خام رتبهبندی را نباید بدون کالیبراسیون، احتمال یا درصد اطمینان دانست.
آیا ColBERT جای قطعهبندی را میگیرد؟
خیر. حفظ زمینه، محدودیت ورودی مدل و هزینه پردازش همچنان به قطعهبندی وابستهاند.
آیا برای مثال مقاله سرور Qdrant لازم است؟
خیر. مثال از حالت حافظهای Qdrant Client استفاده میکند. برای نگهداری پایدار و استقرار، طراحی دیگری لازم است.
جمعبندی
ColBERT با نگهداری نمایشهای توکن و مقایسه آنها از طریق Late Interaction،روشی متفاوت برای بازیابی متن ارائه میکند.
مزیت مورد انتظار آن، بررسی ارتباط در سطح جزئیتر است؛ هزینه آن نیز باید در ذخیرهسازی، پردازش و نگهداری شاخص سنجیده شود.
برای استفاده موفق، کیفیت بازیابی اولیه، سازگاری زبان مدل، قطعهبندی و ارزیابی پاسخ نهایی را کنار هم بررسی کنید. انتخاب ColBERT زمانی توجیه دارد که در مقایسه منصفانه با روشهای سادهتر، بهبود قابلاندازهگیری ایجاد کند.
از بازیابی اسناد تا پاسخگویی با درواره
در یک سامانه RAG میتوانید لایه بازیابی را با ابزارهایی مانند ColBERT و Qdrant بسازید و متنهای منتخب را برای تولید پاسخ به مدل زبانی متصل کنید.
برای اتصال بخش پاسخگویی به خدمات درواره، مدل و شیوه درخواست را از مستندات درواره انتخاب کنید. در طراحی برنامه، شناسه هر قطعه را همراه متن نگه دارید تا پاسخ نهایی امکان ارجاع به منبع داشته باشد.
این معماری اجازه میدهد دو تصمیم را مستقل ارزیابی کنید: کدام روش اسناد مناسب را پیدا میکند و کدام مدل، با استفاده از همان اسناد، پاسخ بهتری مینویسد.
برای بررسی مدلها و شروع اتصال هوش مصنوعی به سامانه جستوجو یا دستیار خود، به darvareh.ir مراجعه کنید.
مقالات مرتبط
- Embeddingچیست؟
- جستوجوی ترکیبی با BM25 و بردار برایRAG
- بازرتبهبندی و Cross-Encoder درRAG
- قطعهبندی متن یا Chunking چیست؟
- ارزیابی مدلهای هوش مصنوعی
- آموزش اتصال برنامه به API هوش مصنوعی
منابع
- مقاله اصلیColBERT
- مقالهColBERTv2
- مقالهPLAID
- کارت رسمی مدلColBERTv2
- تولید بردارهای ColBERT باFastEmbed
- مستندات بردارها و MaxSim درQdrant
- نمایشهای چندبرداری برای بازرتبهبندی درQdrant
- مستندات Cross-Encoder درSentence Transformers
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی ابزارها و سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



