
هوش مصنوعی در بیمه؛ کاربردها و راهنمای ساخت دستیار بررسی خسارت
هوش مصنوعی میتواند دریافت پرونده خسارت، استخراج اطلاعات از توضیحات و مدارک، تشخیص نقص پرونده و آمادهسازی خلاصه برای کارشناس بیمه را سریعتر کند. در این راهنما، معماری و نمونه کد ساخت دستیار بررسی اولیه خسارت با API را بررسی میکنیم.

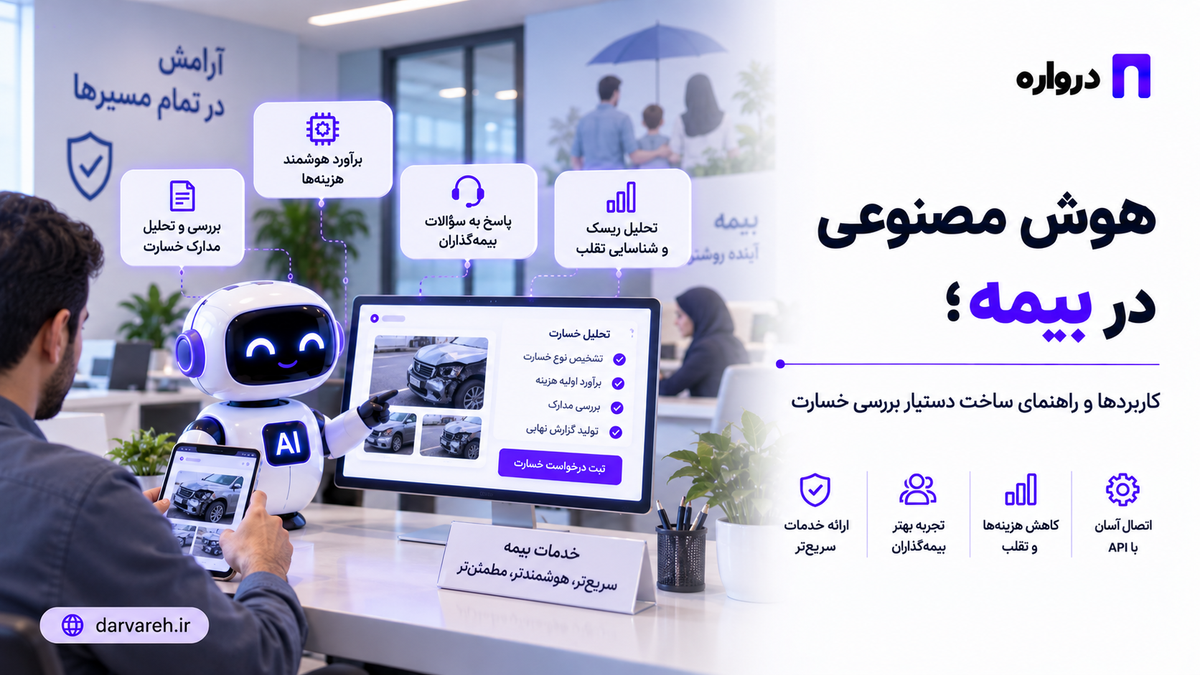
شرکتهای بیمه روزانه با حجم زیادی از فرمها، توضیحات متنی، تصاویر، مکاتبات، شرایط بیمهنامه و درخواستهای مشتریان سروکار دارند. بخش مهمی از زمان کارشناسان نیز صرف خواندن این اطلاعات، ورود داده و تشخیص اقدام بعدی میشود.
هوش مصنوعی میتواند در مراحل مختلف این فرایند به کارشناسان کمک کند؛ برای مثال:
- استخراج اطلاعات از شرح حادثه
- دستهبندی نوع خسارت
- خلاصهسازی پرونده
- شناسایی مدارک احتمالیِ ناقص
- جستوجو در شرایط بیمهنامه
- تهیه پیشنویس پاسخ به بیمهگذار
- اولویتبندی پروندهها برای بررسی
- تبدیل مکالمات مرکز تماس به گزارش ساختاریافته
هدف مناسب، جایگزینکردن قضاوت کارشناس بیمه با یک مدل زبانی نیست. معماری مطمئنتر این است که مدل اطلاعات پراکنده را به خروجی ساختاریافته تبدیل کند و تصمیمهای مالی، حقوقی و قراردادی همچنان بر اساس قوانین سامانه و تأیید افراد مجاز انجام شوند.
در این مقاله، کاربردهای هوش مصنوعی در صنعت بیمه و روش ساخت یک دستیار بررسی اولیه پرونده خسارت با API درواره را بررسی میکنیم.
هوش مصنوعی در بیمه چیست؟
هوش مصنوعی در بیمه به استفاده از مدلهای زبانی، پردازش سند، بینایی ماشین، یادگیری ماشین و سایر فناوریهای هوشمند در فرایندهای بیمهای گفته میشود.
این فناوری میتواند در بخشهای مختلف چرخه بیمه به کار رود:
- معرفی و فروش بیمهنامه
- صدور و تمدید
- پاسخگویی به بیمهگذاران
- دریافت اعلام خسارت
- بررسی اسناد پرونده
- ارزیابی و رسیدگی به خسارت
- شناسایی الگوهای غیرعادی
- مدیریت دانش و آییننامهها
- تهیه گزارشهای مدیریتی
در بسیاری از این کاربردها، مدل زبانی مسئول تصمیم نهایی نیست. نقش آن بیشتر خواندن، استخراج، خلاصهسازی، پیشنهاد و آمادهکردن اطلاعات برای کارشناس است.
بررسیهای صنعت نیز پردازش اسناد، متنها و تصاویر را از کاربردهای مهم هوش مصنوعی مولد در بیمه معرفی میکنند. IBM درباره راهکارهای هوش مصنوعی در بیمه بر فرصتهای مربوط به اسناد و حجم زیاد اطلاعات متنی تأکید کرده است.
هوش مصنوعی چه مشکلاتی را در شرکتهای بیمه حل میکند؟
اطلاعات غیرساختاریافته
شرح حادثه معمولاً به زبان طبیعی نوشته یا در تماس تلفنی بیان میشود. مدارک نیز ممکن است شامل تصویر، فایل PDF، نامه، گزارش و فرمهای مختلف باشند.
نرمافزارهای سنتی برای پردازش این نوع اطلاعات به فرمها و قواعد از پیش تعیینشده وابستهاند. مدلهای هوش مصنوعی میتوانند متن آزاد را بخوانند و اطلاعات موردنیاز را به ساختاری مانند JSON تبدیل کنند.
ورود دستی اطلاعات
ممکن است کارشناس اطلاعات موجود در ایمیل، فرم یا مکالمه را دوباره در سامانه خسارت ثبت کند. این کار زمانبر است و احتمال خطای ورود داده را افزایش میدهد.
دستیار هوشمند میتواند فیلدهای پیشنهادی را استخراج کند؛ اما بهتر است کارشناس پیش از ثبت نهایی آنها را تأیید کند.
پراکندگی شرایط و دستورالعملها
کارشناس برای پاسخگویی ممکن است به شرایط عمومی، شرایط خصوصی، بخشنامهها و راهنماهای داخلی مراجعه کند.
با استفاده از معماری RAG میتوان پاسخ مدل را به اسناد تأییدشده شرکت متصل کرد. در این حالت، مدل بهجای اتکا به حافظه عمومی خود، بخشهای مرتبط اسناد را بازیابی و بر اساس آنها پاسخ پیشنهادی تولید میکند.
برای آشنایی با این معماری میتوانید مقاله RAG چیست و چگونه کار میکند؟ را مطالعه کنید.
ارتباطات پرتکرار با مشتری
پرسشهایی مانند وضعیت پرونده، مدارک موردنیاز، نحوه ارسال اسناد و مراحل بررسی بارها تکرار میشوند.
هوش مصنوعی میتواند پیشنویس پاسخ را با توجه به وضعیت واقعی پرونده آماده کند. دسترسی به وضعیت باید از سامانه بیمه انجام شود؛ مدل نباید شماره پرونده، مبلغ یا مرحله رسیدگی را حدس بزند.
کاربردهای هوش مصنوعی در صنعت بیمه
پاسخگویی درباره بیمهنامهها
یک دستیار متصل به اطلاعات محصولات بیمهای میتواند به پرسشهای اولیه مشتری پاسخ دهد؛ برای مثال:
- تفاوت دو نوع پوشش چیست؟
- برای صدور چه مدارکی لازم است؟
- فرایند تمدید چگونه انجام میشود؟
- فرانشیز به چه معناست؟
- هر پوشش در چه شرایطی قابل استفاده است؟
پاسخها باید از متن رسمی و نسخه معتبر شرایط بیمهنامه استخراج شوند. همچنین باید بین توضیح عمومی و اعلام قطعی پوشش یک پرونده تفاوت وجود داشته باشد.
کمک به نمایندگان فروش
هوش مصنوعی میتواند مکالمه با مشتری را خلاصه کند، نیازهای بیانشده را استخراج کند و پیشنویس پیگیری بسازد.
بااینحال، پیشنهاد نهایی محصول باید شرایط قانونی، اطلاعات واقعی متقاضی و قواعد شرکت را در نظر بگیرد. مدل زبانی بهتنهایی ابزار مناسبی برای محاسبه حق بیمه یا تضمین شرایط صدور نیست.
پردازش فرمها و مدارک
مدلهای پردازش سند و بینایی میتوانند اطلاعاتی مانند شماره بیمهنامه، تاریخ، مشخصات وسیله یا نوع مدرک را از فایل استخراج کنند.
مایکروسافت نیز پردازش فرمهای بیمه و پروندههای خسارت را از سناریوهای پردازش اسناد سازمانی معرفی میکند. سناریوهای پردازش سند در Microsoft 365
نتیجه استخراج باید پیش از ثبت در سامانه اعتبارسنجی شود. برای نمونه:
- تاریخ باید قالب معتبر داشته باشد.
- شماره بیمهنامه باید در پایگاه داده وجود داشته باشد.
- اطلاعات هویتی باید با منبع اصلی تطبیق داده شود.
- مبلغ استخراجشده باید از نظر نوع و واحد مشخص باشد.
دریافت و دستهبندی اعلام خسارت
هنگام دریافت درخواست، مدل میتواند شرح مشتری را تحلیل و موارد زیر را استخراج کند:
- نوع خسارت اعلامشده
- زمان و محل ذکرشده
- اشخاص یا اموال درگیر
- مدارک ارسالشده
- اطلاعاتی که در توضیح وجود ندارد
- واحد مناسب برای ارجاع
- خلاصه مناسب برای کارشناس
این مرحله «ثبت و آمادهسازی پرونده» است، نه تأیید وقوع خسارت یا تعیین تعهد شرکت.
خلاصهسازی پرونده خسارت
یک پرونده ممکن است شامل چندین گزارش، پیام، یادداشت و مدرک باشد. مدل زبانی میتواند خلاصهای زمانمحور برای کارشناس تولید کند:
- چه اتفاقی گزارش شده است؟
- چه مدارکی دریافت شدهاند؟
- چه اقداماتی انجام شدهاند؟
- کدام اطلاعات هنوز مشخص نیست؟
- آخرین وضعیت ثبتشده چیست؟
تمام گزارههای خلاصه باید به رکورد یا سند منبع قابل ردیابی باشند. اگر اطلاعات در اسناد وجود ندارد، مدل باید بهصراحت مقدار آن را «نامشخص» اعلام کند.
شناسایی مدارک ناقص
سامانه میتواند ابتدا نوع پرونده را مشخص و سپس فهرست مدارک موردنیاز را از موتور قواعد دریافت کند. مدل وظیفه دارد مدارک موجود را دستهبندی کند و نتیجه را برای مقایسه در اختیار سامانه قرار دهد.
ترتیب مناسب چنین است:
- دریافت نوع خسارت
- دریافت فهرست رسمی مدارک از سامانه
- طبقهبندی فایلهای ارسالشده
- مقایسه فهرست موجود و موردنیاز
- نمایش نتیجه به کارشناس
- ارسال درخواست تکمیل پس از تأیید
بهتر است مدل خودش فهرست مدارک قانونی را از حافظه تولید نکند؛ زیرا این فهرست ممکن است میان محصولات، شرکتها و دورههای زمانی متفاوت باشد.
تهیه پیشنویس مکاتبات
هوش مصنوعی میتواند با استفاده از دادههای تأییدشده، پیشنویس پیامهایی مانند موارد زیر را آماده کند:
- تأیید دریافت اعلام خسارت
- درخواست تکمیل مدرک
- اعلام ارجاع پرونده
- توضیح مرحله بعدی
- پاسخ اولیه به اعتراض یا پرسش
پیشنویس باید پیش از ارسال بررسی شود، بهویژه اگر درباره پذیرش خسارت، مبلغ، مسئولیت یا تفسیر قرارداد صحبت میکند.
جستوجوی هوشمند در آییننامهها
یک دستیار داخلی میتواند به کارشناسان در یافتن بندهای مرتبط کمک کند. پاسخ مناسب باید همراه با اطلاعات منبع باشد:
- نام سند
- شماره یا نسخه سند
- بخش مرتبط
- تاریخ اعتبار
- پیوند یا شناسه داخلی سند
این قابلیت را میتوان با Embedding، جستوجوی معنایی و RAG ساخت. مقاله Embedding چیست و چه کاربردی دارد؟ جزئیات این روش را توضیح میدهد.
تشخیص موارد غیرعادی
مدل زبانی میتواند تناقضهای متنی یا اطلاعات ناقص را برای بررسی علامتگذاری کند، اما تشخیص تقلب یک مسئله تخصصیتر است.
برای این کاربرد معمولاً به ترکیبی از منابع زیر نیاز است:
- دادههای تاریخی
- قواعد ضدتقلب
- مدلهای آماری
- ارتباط میان پروندهها
- بررسی تصاویر و اسناد
- ارزیابی کارشناسان متخصص
پرچمگذاری یک پرونده به معنی اثبات تقلب نیست. این نتیجه فقط میتواند علت ارجاع پرونده به بررسی تکمیلی باشد.
تحلیل تماسهای مرکز ارتباط
پس از تبدیل گفتار به متن، مدل میتواند مکالمه را خلاصه و موضوع آن را دستهبندی کند. خروجی میتواند شامل موارد زیر باشد:
- علت تماس
- شماره پرونده ذکرشده
- پرسش مشتری
- تعهد یا اقدام اعلامشده
- لحن کلی مکالمه
- اقدام پیگیری پیشنهادی
در این فرایند نیز شمارهها و وضعیت پرونده باید با سامانه اصلی کنترل شوند.
کدام تصمیمها را نباید مستقیماً به مدل زبانی سپرد؟
مدل زبانی ممکن است خروجی نادرست، ناقص یا متناقض تولید کند. به همین دلیل نباید بدون کنترلهای تکمیلی مسئول تصمیمهای اثرگذار باشد.
موارد حساس عبارتاند از:
- قبول یا رد نهایی خسارت
- تعیین مبلغ پرداخت
- تفسیر قطعی مفاد قرارداد
- محاسبه حق بیمه
- تغییر وضعیت حقوقی پرونده
- متهمکردن فرد به تقلب
- تأیید هویت
- پرداخت وجه
- حذف یا تغییر مدارک
- ارسال پیام رسمی و تعهدآور
گزارش NAIC درباره استفاده بیمهگران از مدلهای هوش مصنوعی نشان میدهد که یکی از کاربردهای رایج مدلهای خسارت، فراهمکردن اطلاعات برای ارزیابان بوده است؛ موضوعی که اهمیت نقش پشتیبان مدل را نشان میدهد. گزارش NAIC درباره هوش مصنوعی در عملیات خسارت
اصول مطرحشده در اسناد NAIC نیز بر انصاف، پاسخگویی، شفافیت، رعایت مقررات و استحکام سامانه تأکید دارند. الزامات دقیق هر پروژه باید جداگانه و بر اساس مقررات محل فعالیت، نوع بیمه و سیاستهای سازمان بررسی شوند.
معماری پیشنهادی دستیار هوش مصنوعی بیمه
یک مدل زبانی نباید مستقیماً به پایگاه داده خسارت دسترسی آزاد داشته باشد. بهتر است ارتباط در یک لایه سمت سرور کنترل شود.
درخواست بیمهگذار
↓
سامانه یا اپلیکیشن بیمه
↓
کنترل هویت و مجوز دسترسی
↓
آمادهسازی داده و حذف اطلاعات غیرضروری
↓
API مدل هوش مصنوعی
↓
اعتبارسنجی خروجی ساختاریافته
↓
قواعد قطعی سامانه بیمه
↓
بررسی و تأیید کارشناس
↓
ثبت اقدام و گزارش ممیزیدر این معماری، هر بخش مسئولیت مشخصی دارد:
| بخش | مسئولیت |
|---|---|
| مدل هوش مصنوعی | استخراج، طبقهبندی، خلاصهسازی و تولید پیشنهاد |
| سامانه بیمه | بازیابی اطلاعات واقعی و اجرای قواعد |
| موتور گردش کار | تعیین مرحله، مسئول و اقدام مجاز |
| کارشناس | بررسی ابهامها و اتخاذ تصمیم |
| گزارش ممیزی | ثبت ورودی، خروجی، نسخه مدل و نتیجه انسانی |
آموزش ساخت دستیار بررسی اولیه خسارت با API درواره
در این مثال، یک سرویس ساده پایتون میسازیم که شرح فارسی خسارت را دریافت و اطلاعات اولیه را استخراج میکند.
خروجی مدل فقط برای آمادهسازی پرونده استفاده میشود و هیچ تصمیمی درباره پذیرش، رد یا مبلغ خسارت نمیگیرد.
نصب کتابخانهها
pip install openai pydanticتنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL="YOUR_MODEL_ID"
شناسه مدل را از فهرست فعلی مدلهای درواره انتخاب کنید.
کد پایتون
import os
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel, Field, ValidationError
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
MODEL_ID = os.environ["DARVAREH_MODEL"]
class ClaimIntake(BaseModel):
claim_type: Literal[
"vehicle",
"property",
"travel",
"health",
"liability",
"other",
"unclear",
]
incident_summary: str = Field(max_length=600)
mentioned_date: str | None
mentioned_location: str | None
involved_items: list[str]
available_documents: list[str]
missing_information: list[str]
suggested_queue: Literal[
"vehicle_claims",
"property_claims",
"travel_claims",
"health_claims",
"liability_claims",
"general_review",
]
needs_urgent_human_review: bool
urgency_reason: str | None
customer_response_draft: str
def analyze_claim_description(description: str) -> ClaimIntake:
prompt = f"""
شرح اعلام خسارت زیر را برای ثبت اولیه تحلیل کن.
قواعد:
- درباره پوشش بیمهای، پذیرش یا رد خسارت تصمیم نگیر.
- هیچ مبلغی را محاسبه یا پیشنهاد نکن.
- فقط اطلاعاتی را استخراج کن که در متن وجود دارد.
- اگر نوع خسارت روشن نیست، claim_type را unclear قرار بده.
- اگر تاریخ یا محل بیان نشده، مقدار آن null باشد.
- missing_information فقط شامل اطلاعات غایب یا مبهم باشد.
- suggested_queue فقط برای ارجاع اولیه است.
- needs_urgent_human_review فقط در صورت اشاره به خطر جانی،
مصدومیت، حادثه در حال وقوع یا شرایط فوری true باشد.
- customer_response_draft نباید پذیرش تعهد یا پرداخت را وعده دهد.
- پاسخ را فقط به شکل JSON معتبر برگردان.
- خارج از JSON هیچ متن یا Markdown ننویس.
شرح مشتری:
{description}
"""
completion = client.chat.completions.create(
model=MODEL_ID,
temperature=0.1,
messages=[
{
"role": "system",
"content": (
"شما دستیار ثبت اولیه پرونده بیمه هستید. "
"اطلاعات را دقیق استخراج میکنید، چیزی را حدس "
"نمیزنید و فقط JSON معتبر تولید میکنید."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("پاسخی از مدل دریافت نشد.")
try:
return ClaimIntake.model_validate_json(content)
except ValidationError as error:
raise ValueError(
f"ساختار پاسخ مدل معتبر نیست: {error}"
) from error
result = analyze_claim_description(
"""
دیشب حدود ساعت ۹ در خیابان آزادی یک خودرو از عقب
با ماشین من برخورد کرد. از محل و آسیب سپر عکس گرفتهام
و گزارش پلیس هم دارم، اما مشخصات بیمهنامه طرف مقابل
فعلاً دستم نیست. کسی مصدوم نشده است.
"""
)
print(result.model_dump_json(indent=2))نمونه خروجی
{
"claim_type": "vehicle",
"incident_summary": "بیمهگذار برخورد یک خودرو از عقب با خودروی خود را گزارش کرده است. حادثه حدود ساعت ۹ شب در خیابان آزادی رخ داده و طبق اظهارات او کسی مصدوم نشده است.",
"mentioned_date": null,
"mentioned_location": "خیابان آزادی",
"involved_items": [
"خودروی بیمهگذار",
"خودروی طرف مقابل",
"سپر خودرو"
],
"available_documents": [
"تصاویر محل حادثه",
"تصاویر آسیب سپر",
"گزارش پلیس"
],
"missing_information": [
"تاریخ دقیق حادثه",
"مشخصات بیمهنامه طرف مقابل"
],
"suggested_queue": "vehicle_claims",
"needs_urgent_human_review": false,
"urgency_reason": null,
"customer_response_draft": "اعلام خسارت اولیه شما دریافت شد. تصاویر و گزارش پلیس در پرونده قابل بررسی هستند. برای تکمیل اطلاعات، تاریخ دقیق حادثه و در صورت دسترسی مشخصات بیمهنامه طرف مقابل نیز موردنیاز است. نتیجه پس از بررسی کارشناسی اعلام خواهد شد."
}این خروجی نباید مستقیماً پرونده را تأیید کند. سرور باید ابتدا موارد زیر را کنترل کند:
- معتبر بودن JSON
- مجاز بودن مقادیر دستهبندی
- وجود بیمهنامه در سامانه
- تطبیق اطلاعات با فرم و مدارک
- مجاز بودن صف ارجاع
- ثبت نتیجه بهعنوان «پیشنهاد مدل»
- تأیید یا اصلاح توسط کارشناس
اتصال دستیار به مدارک پرونده
اگر پرونده شامل تصویر یا PDF است، یک خط لوله چندمرحلهای مناسبتر خواهد بود.
مرحله اول: تشخیص نوع مدرک
ابتدا مشخص کنید فایل ارسالشده چه نوع مدرکی است:
- تصویر خسارت
- گزارش حادثه
- فرم اعلام خسارت
- مدرک هویتی
- بیمهنامه
- فاکتور
- مدرک نامرتبط
- مدرک نامشخص
مرحله دوم: استخراج فیلدها
برای هر نوع مدرک، ساختار خروجی جداگانه تعریف کنید. فیلدهای یک گزارش حادثه با فاکتور یا بیمهنامه یکسان نیستند.
مرحله سوم: اعتبارسنجی
خروجی مدل را با قواعد برنامه بررسی کنید. برای مثال، اگر مدل یک شماره بیمهنامه استخراج کرد، وجود آن را از سامانه اصلی استعلام کنید.
مرحله چهارم: تطبیق میان اسناد
اطلاعات مشترک مانند تاریخ، نام و شماره پرونده را میان اسناد مقایسه کنید. اختلاف فقط باید علامتگذاری شود؛ مدل نباید خودسرانه تعیین کند کدام نسخه درست است.
مرحله پنجم: تأیید انسانی
فیلدهای استخراجشده را همراه با تصویر یا بخش منبع به کارشناس نشان دهید تا امکان بررسی سریع وجود داشته باشد.
چگونه خروجی هوش مصنوعی را قابلاعتمادتر کنیم؟
خروجی JSON تعریف کنید
خروجی متنی آزاد برای اتصال مستقیم به گردش کار مناسب نیست. با تعریف طرح مشخص، میتوانید مقادیر را قبل از استفاده اعتبارسنجی کنید.
گزینهها را محدود کنید
بهجای درخواست «نوع پرونده را تشخیص بده»، مقادیر مجاز را مشخص کنید:
vehicle | property | travel | health | liability | other | unclearوجود گزینه unclear مهم است؛ زیرا مدل نباید برای کاملکردن پاسخ، اطلاعات نامطمئن را حدس بزند.
داده منبع را نمایش دهید
برای فیلدهای مهم، متن یا صفحهای را که اطلاعات از آن استخراج شده ذخیره کنید. این کار بررسی کارشناس و اصلاح خطا را آسانتر میکند.
قواعد مالی را در کد نگه دارید
سقفها، فرانشیز، وضعیت بیمهنامه، مجوز پرداخت و شرایط قطعی باید توسط کد یا موتور قواعد ارزیابی شوند، نه متن تولیدشده توسط مدل.
از مجموعه ارزیابی ثابت استفاده کنید
پیش از انتشار، نمونههایی از پروندههای واقعی و بدون اطلاعات غیرضروری آماده کنید:
- شرحهای کامل و ناقص
- تاریخهای شمسی و نسبی
- غلطهای املایی
- متن محاورهای
- چند حادثه در یک پیام
- موارد خارج از دستهبندی
- درخواستهای دارای اطلاعات متناقض
بعد از تغییر مدل یا پرامپت، همان نمونهها را دوباره اجرا کنید و نتیجه را مقایسه کنید.
اطمینان مدل را با واقعیت اشتباه نگیرید
حتی اگر مدل پاسخی روان و قطعی تولید کند، پاسخ الزاماً صحیح نیست. امتیاز اطمینان خوداظهاری مدل نیز اثبات صحت محسوب نمیشود.
برای فیلدهای مهم، صحت باید با سند، پایگاه داده یا بررسی انسانی تأیید شود.
مدیریت داده در پروژههای بیمهای
پروندههای بیمه ممکن است شامل اطلاعات هویتی، مالی، درمانی یا قراردادی باشند. پیش از ارسال اطلاعات به هر سرویس باید نیاز واقعی پروژه و الزامات سازمان بررسی شود.
اقدامات پایه عبارتاند از:
- ارسالنکردن اطلاعات غیرضروری
- حذف یا پوشاندن شناسهها در صورت امکان
- کنترل دسترسی بر اساس نقش
- نگهداری کلید API فقط در سمت سرور
- ثبت دسترسیها و اقدامات
- تعیین دوره نگهداری داده
- بررسی قرارداد و شرایط پردازش داده سرویس
- تفکیک محیط آزمایش و عملیاتی
- استفاده از داده ساختگی یا ناشناس در توسعه
- تعریف فرایند رسیدگی به خطا
این موارد جایگزین بررسی حقوقی، امنیتی و مقرراتی متناسب با سازمان نیستند.
چگونه مدل مناسب را انتخاب کنیم؟
مدل مناسب باید روی داده و وظیفه واقعی آزمایش شود. صرفاً بزرگتر یا مشهورتر بودن مدل، انتخاب آن را توجیه نمیکند.
معیارهای مهم عبارتاند از:
کیفیت زبان فارسی
مدل را روی متن رسمی، محاورهای، دارای غلط املایی و ترکیب عدد و تاریخ فارسی آزمایش کنید.
استخراج دقیق اطلاعات
برای هر فیلد معیار جداگانه داشته باشید. ممکن است مدل در خلاصهسازی خوب باشد اما تاریخ یا شمارهها را با دقت کافی استخراج نکند.
تولید JSON معتبر
در یک فرایند خودکار، ثبات ساختار خروجی بهاندازه کیفیت متن اهمیت دارد.
سرعت پاسخ
ثبت اولیه و چت تعاملی به پاسخ سریع نیاز دارند، درحالیکه پردازش دستهای اسناد ممکن است تأخیر بیشتری را تحمل کند.
هزینه
تعداد صفحات، طول ورودی، حجم خروجی و تعداد درخواستها را اندازهگیری کنید. برای دستهبندی ساده همیشه به قویترین مدل نیاز ندارید.
برای برآورد بهتر میتوانید از راهنمای محاسبه هزینه API هوش مصنوعی استفاده کنید.
امکان تغییر مدل
شناسه مدل را در تنظیمات یا متغیر محیطی نگه دارید تا بتوانید بدون تغییر گسترده کد، مدلهای مختلف را ارزیابی کنید.
شاخصهای ارزیابی دستیار بیمه
موفقیت پروژه فقط با «خوببودن پاسخها» سنجیده نمیشود. شاخصها باید برای هر وظیفه جداگانه تعریف شوند.
| قابلیت | شاخص پیشنهادی |
|---|---|
| دستهبندی پرونده | دقت انتخاب صف صحیح |
| استخراج اطلاعات | دقت و پوشش هر فیلد |
| تشخیص نقص | درصد مدارک ناقص درست شناساییشده |
| خلاصهسازی | صحت، کاملبودن و نبود اطلاعات ساختگی |
| پیشنویس پاسخ | میزان اصلاح موردنیاز کارشناس |
| پردازش عملیاتی | زمان ثبت اولیه پرونده |
| کیفیت فنی | نرخ JSON معتبر |
| کنترل هزینه | هزینه متوسط هر پرونده |
| نظارت انسانی | نرخ تأیید، اصلاح و رد پیشنهاد مدل |
خطاهای مختلف هزینه یکسانی ندارند. استخراج اشتباه یک توضیح کماهمیت با ثبت نادرست مبلغ یا وضعیت مصدومیت قابل مقایسه نیست. ارزیابی باید وزن و شدت خطا را نیز در نظر بگیرد.
مسیر پیشنهادی اجرای اولین پروژه
مرحله اول: یک کاربرد محدود انتخاب کنید
برای نمونه، فقط دستهبندی شرح خسارت و ساخت خلاصه اولیه را اجرا کنید. شروع همزمان با صدور، خسارت، فروش و پشتیبانی ارزیابی نتیجه را دشوار میکند.
مرحله دوم: خروجی مطلوب را تعریف کنید
فیلدها، مقادیر مجاز و موارد نیازمند ارجاع انسانی را پیش از انتخاب مدل مشخص کنید.
مرحله سوم: نمونه واقعی آماده کنید
مجموعهای از ورودیهای متنوع و پاسخ تأییدشده کارشناسان بسازید. اطلاعات حساس غیرضروری را حذف کنید.
مرحله چهارم: چند مدل را مقایسه کنید
کیفیت فارسی، دقت استخراج، نرخ خروجی معتبر، سرعت و هزینه را روی نمونههای یکسان بسنجید.
مرحله پنجم: اجرای آزمایشی در کنار کارشناس
ابتدا خروجی مدل را فقط به کارشناس نمایش دهید و اجازه ندهید بهتنهایی وضعیت پرونده را تغییر دهد.
مرحله ششم: خطاها را دستهبندی کنید
مشخص کنید خطا از کدام بخش ناشی شده است:
- متن ورودی
- استخراج سند
- پرامپت
- مدل
- قواعد برنامه
- داده مرجع
- رابط کاربری
مرحله هفتم: خودکارسازی محدود
تنها اقداماتی را خودکار کنید که کمریسک، قابل بازگشت و دارای کنترل قطعی هستند. تصمیمهای مالی و قراردادی را در مسیر تأیید مناسب نگه دارید.
اشتباهات رایج در پیادهسازی
شروع با تصمیم نهایی خسارت
این هدف هم پرریسک است و هم برای نسخه اولیه ارزیابی دشواری دارد. استخراج و خلاصهسازی، نقطه شروع عملیتری هستند.
استفاده از یک پرامپت برای تمام اسناد
ساختار و معیارهای استخراج هر سند متفاوت است. برای هر گروه سند، طرح خروجی و آزمون جداگانه تعریف کنید.
اعتماد به متن روان مدل
روانبودن پاسخ نشانه صحت آن نیست. خروجی باید با منبع و قواعد برنامه کنترل شود.
نبود گزینه «نامشخص»
اگر مدل مجبور باشد همیشه یکی از پاسخها را انتخاب کند، احتمال حدسزدن افزایش مییابد.
ثبت مستقیم خروجی در سامانه اصلی
خروجی مدل ابتدا باید اعتبارسنجی و در مراحل حساس توسط کارشناس تأیید شود.
نداشتن گزارش نسخهها
برای بررسی خطا باید بدانید هر نتیجه با کدام مدل، پرامپت، داده مرجع و تنظیمات تولید شده است.
ترکیب پیشنهاد مدل با واقعیت پرونده
در رابط کاربری مشخص کنید هر فیلد از کدام منبع آمده است:
- اظهار بیمهگذار
- سند استخراجشده
- پایگاه داده شرکت
- پیشنهاد مدل
- تأیید کارشناس
آیا درواره برای ساخت راهکار بیمهای مناسب است؟
درواره یک لایه دسترسی یکپارچه به مدلهای مختلف هوش مصنوعی ارائه میکند. توسعهدهندگان میتوانند با یک API سازگار با OpenAI، قابلیتهایی مانند تحلیل متن، استخراج اطلاعات، خلاصهسازی و تولید پاسخ را به نرمافزار بیمه متصل کنند.
امکانات اصلی عبارتاند از:
- دسترسی به مدلهای مختلف
- API سازگار با OpenAI
- یک کلید API
- کیف پول و پرداخت ریالی
- امکان مقایسه مدلها
- گزارش مصرف
- آدرس پایه یکپارچه
آدرس پایه API درواره:
https://api.darvareh.ir/v1درواره جایگزین سامانه صدور، مدیریت خسارت، موتور قواعد یا پایگاه داده بیمه نیست. منطق بیمهای، کنترل دسترسی، نگهداری پرونده و تصمیمهای نهایی باید در نرمافزار سازمان مدیریت شوند.
برای شروع میتوانید مستندات API درواره را بررسی کنید.
پرسشهای متداول
مهمترین کاربرد هوش مصنوعی در بیمه چیست؟
پردازش اسناد، ثبت اولیه خسارت، خلاصهسازی پرونده، پاسخگویی به مشتری و جستوجو در دستورالعملها از کاربردهای عملی آن هستند. بهترین نقطه شروع به حجم کار و کیفیت داده هر شرکت بستگی دارد.
آیا هوش مصنوعی میتواند خسارت را تأیید یا رد کند؟
از نظر فنی میتوان سامانههایی برای پشتیبانی از این تصمیم ساخت، اما سپردن تصمیم نهایی به یک مدل زبانی عمومی مناسب نیست. چنین تصمیمی به قواعد قرارداد، داده معتبر، مقررات، امکان توضیح و نظارت انسانی نیاز دارد.
آیا میتوان مدارک خسارت را با هوش مصنوعی پردازش کرد؟
بله. مدلهای پردازش سند و بینایی میتوانند نوع مدرک و فیلدهای آن را استخراج کنند. نتیجه باید با ساختار مشخص تولید و پیش از ثبت نهایی اعتبارسنجی شود.
آیا هوش مصنوعی تقلب بیمهای را تشخیص میدهد؟
هوش مصنوعی میتواند الگوهای غیرعادی یا تناقضها را برای بررسی علامتگذاری کند، اما این علامت به معنی اثبات تقلب نیست. بررسی تخصصی و شواهد معتبر همچنان ضروریاند.
چگونه از تولید اطلاعات ساختگی جلوگیری کنیم؟
امکان حذف کامل خطا وجود ندارد، اما میتوان آن را با اتصال به منابع معتبر، خروجی ساختاریافته، گزینه «نامشخص»، اعتبارسنجی سمت سرور، نمایش منبع و نظارت انسانی کاهش داد.
آیا درواره از OpenAI SDK پشتیبانی میکند؟
بله. API درواره با ساختار OpenAI سازگار است و میتوانید در بسیاری از پروژهها با تنظیم base_url، کلید API و شناسه مدل از کتابخانه OpenAI استفاده کنید.
آیا باید از یک مدل برای همه فرایندهای بیمه استفاده کرد؟
خیر. ممکن است یک مدل برای استخراج اطلاعات سریع و اقتصادی باشد و مدل دیگری در خلاصهسازی پروندههای پیچیده نتیجه بهتری بدهد. انتخاب باید بر اساس آزمون واقعی هر وظیفه انجام شود.
جمعبندی
هوش مصنوعی میتواند بخشهای زمانبر صنعت بیمه، بهویژه پردازش متن و سند، ثبت اولیه خسارت، خلاصهسازی و آمادهسازی پاسخ را بهبود دهد.
برای اجرای موفق این فناوری:
- با یک فرایند محدود و قابلاندازهگیری شروع کنید.
- نقش مدل را از قواعد قطعی سامانه جدا نگه دارید.
- خروجی را به شکل JSON و با مقادیر محدود دریافت کنید.
- اطلاعات استخراجشده را با منابع واقعی اعتبارسنجی کنید.
- برای دادههای حساس، دسترسی و نگهداری کنترلشده تعریف کنید.
- تصمیمهای مالی، قراردادی و اتهام تقلب را به مدل نسپارید.
- تأیید و اصلاح کارشناس را ثبت کنید.
- چند مدل را از نظر کیفیت فارسی، سرعت و هزینه مقایسه کنید.
- تغییر مدل و پرامپت را پیش از انتشار ارزیابی کنید.
- تمام اقدامات مهم را قابل ردیابی نگه دارید.
اگر شرکت بیمه، کارگزاری یا تیم نرمافزاری شما قصد دارد پردازش اسناد، ثبت خسارت یا پاسخگویی هوشمند را به محصول خود اضافه کند، API درواره امکان آزمایش مدلهای مختلف و ساخت نمونه اولیه را با یک اتصال یکپارچه فراهم میکند.
مقالات مرتبط
- هوش مصنوعی بهعنوان سرویس چیست؟
- API هوش مصنوعی چیست؟
- آموزش اتصال API هوش مصنوعی به نرمافزار
- راهنمای API سازگار با OpenAI
- RAG چیست و چگونه کار میکند؟
- Embedding چیست و چه کاربردی دارد؟
- مدیریت دانش با هوش مصنوعی
- هوش مصنوعی در مرکز تماس
- محاسبه هزینه API هوش مصنوعی
منابع
- IBM: هوش مصنوعی در صنعت بیمه
- IBM: راهکارهای مبتنی بر هوش مصنوعی برای شرکتهای بیمه
- Microsoft: سناریوهای پردازش اسناد سازمانی
- NAIC: گزارش کاربرد هوش مصنوعی در عملیات بیمه
- OpenAI Python Library
- Pydantic Documentation
- مستندات API درواره
این مقاله با هدف آموزش عمومی تهیه شده است و توصیه حقوقی، بیمهای یا مقرراتی محسوب نمیشود. پیش از استفاده عملی، الزامات قانونی، قراردادی و فنی مرتبط با محل فعالیت و نوع بیمه را بررسی کنید. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.



