مدیریت دانش با هوش مصنوعی چیست؟ آموزش ساخت دستیار دانش سازمانی
مدیریت دانش با هوش مصنوعی، اسناد پراکنده سازمان را به یک منبع قابلجستوجو و پاسخگو تبدیل میکند. در این راهنما معماری و ساخت یک نمونه عملی را بررسی میکنیم.
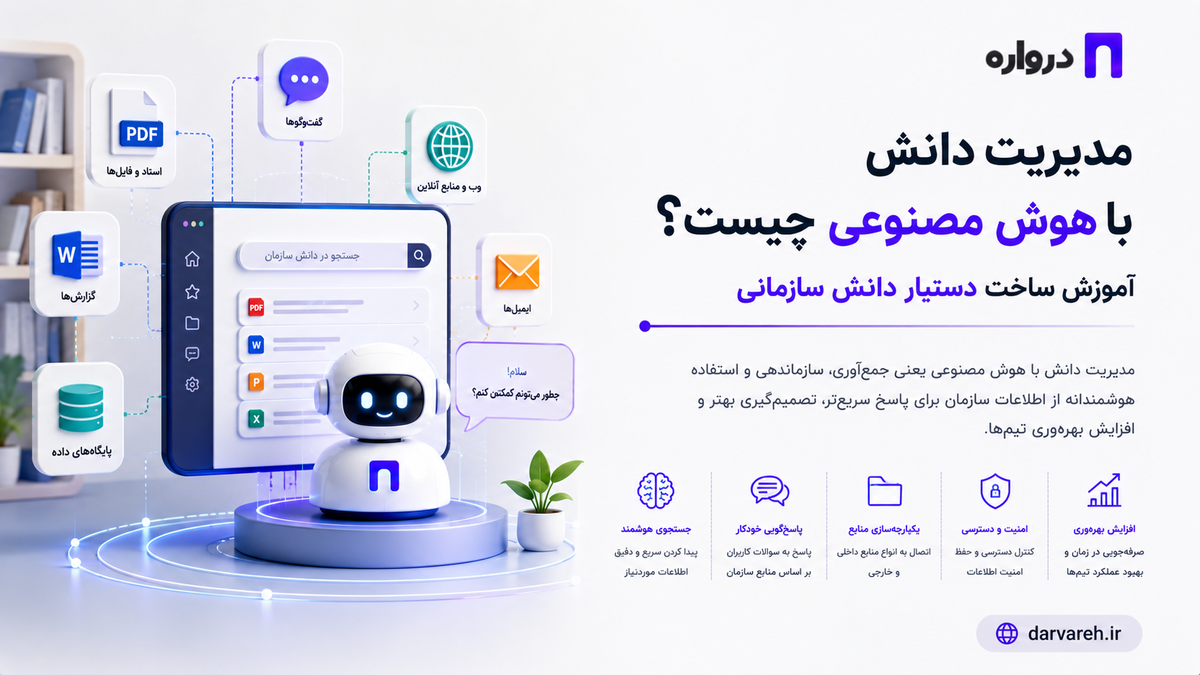
بخش زیادی از دانش یک سازمان در فایلها، ایمیلها، سامانههای داخلی، مکالمات کارکنان، مستندات محصول و تجربه افراد پراکنده است.
ممکن است پاسخ یک سؤال مهم در یکی از این منابع وجود داشته باشد:
- فایل PDF یک آییننامه
- گزارش قدیمی پروژه
- صفحهای از مستندات محصول
- مکالمه تیم پشتیبانی
- صورتجلسه
- قرارداد
- سامانه CRM
- تیکتهای قبلی
- فایلهای Word و Excel
- ذهن یکی از کارکنان باتجربه
مشکل اصلی معمولاً نبود اطلاعات نیست؛ بلکه پیداکردن اطلاعات صحیح در زمان مناسب است.
مدیریت دانش با هوش مصنوعی تلاش میکند این منابع پراکنده را سازماندهی، جستوجو و قابلاستفاده کند. بهجای جستوجوی دستی در پوشهها، کاربر میتواند سؤال خود را با زبان طبیعی مطرح کند و پاسخ مرتبط را همراه منبع دریافت کند.
برای مثال:
شرایط استفاده از مرخصی ساعتی چیست و درخواست آن باید توسط چه کسی تأیید شود؟
یک دستیار دانش سازمانی میتواند اسناد مرتبط را جستوجو کند، بند مناسب آییننامه را پیدا کند، پاسخ کوتاهی تولید کند و لینک یا عنوان منبع را نیز نمایش دهد.
در این راهنما بررسی میکنیم مدیریت دانش با هوش مصنوعی چیست، چه تفاوتی با یک چتبات یا سیستم RAG دارد و چگونه میتوان یک دستیار دانش سازمانی را با API درواره پیادهسازی کرد.
مدیریت دانش چیست؟
مدیریت دانش یا Knowledge Management فرایند شناسایی، جمعآوری، سازماندهی، ذخیره، بهروزرسانی و بهاشتراکگذاری دانش در یک سازمان است.
براساس تعریف IBM از مدیریت دانش، هدف مدیریت دانش این است که اطلاعات و تجربه موجود در سازمان به شکلی سازماندهی شود که افراد بتوانند آن را پیدا و استفاده کنند.
مدیریت دانش فقط به نگهداری فایلها محدود نیست. یک سیستم مدیریت دانش باید به پرسشهای زیر پاسخ دهد:
- چه اطلاعاتی در سازمان وجود دارد؟
- اطلاعات در کجا نگهداری میشوند؟
- کدام نسخه معتبر و بهروز است؟
- چه کسی مالک هر محتواست؟
- چه افرادی اجازه دسترسی دارند؟
- اطلاعات چگونه پیدا میشوند؟
- دانش کارکنان چگونه ثبت میشود؟
- مطالب قدیمی چگونه شناسایی میشوند؟
- چه سؤالهایی هنوز پاسخ مشخصی ندارند؟
اگر سازمان فقط فایلها را در پوشههای مشترک ذخیره کند، الزاماً یک سیستم مدیریت دانش ایجاد نکرده است. اطلاعات زمانی به دانش قابلاستفاده تبدیل میشوند که معتبر، قابلدسترسی، قابلجستوجو و متناسب با نیاز کاربر باشند.
مدیریت دانش با هوش مصنوعی چیست؟
مدیریت دانش با هوش مصنوعی به استفاده از مدلهای هوش مصنوعی برای سازماندهی، بازیابی، خلاصهسازی و استفاده بهتر از اطلاعات سازمان گفته میشود.
هوش مصنوعی میتواند در بخشهای مختلف چرخه دانش کمک کند:
- استخراج متن از اسناد
- دستهبندی خودکار محتوا
- تولید برچسب
- شناسایی موضوع سند
- خلاصهسازی گزارشها
- تشخیص اسناد مشابه
- جستوجوی معنایی
- پاسخگویی براساس منابع
- پیشنهاد محتوای مرتبط
- استخراج سؤالهای پرتکرار
- شناسایی شکافهای دانشی
- تبدیل جلسه یا مکالمه به دانش مستند
- تهیه پیشنویس مقاله پایگاه دانش
در این معماری، مدل زبانی جایگزین منابع سازمان نمیشود. مدل کمک میکند اطلاعات موجود بهتر پیدا، ترکیب و توضیح داده شوند.
مشکل جستوجوی سنتی در اسناد سازمان
جستوجوی سنتی معمولاً بر تطابق کلمات متکی است.
اگر کاربر عبارت «شرایط دورکاری» را جستوجو کند، ممکن است سند اصلی با عنوان «آییننامه حضور غیرحضوری کارکنان» ثبت شده باشد. در این شرایط جستوجوی کلمهای ساده ممکن است سند را پیدا نکند.
جستوجوی معنایی میتواند ارتباط مفهومی میان این عبارتها را تشخیص دهد:
- دورکاری
- حضور غیرحضوری
- کار خارج از محل شرکت
- فعالیت از راه دور
این قابلیت با استفاده از مدلهای Embedding پیادهسازی میشود. Embedding متن را به یک نمایش عددی تبدیل میکند تا شباهت معنایی میان سؤال و بخشهای مختلف اسناد قابلمقایسه باشد.
برای آشنایی بیشتر میتوانید مقاله Embedding چیست؟ را مطالعه کنید.
انواع دانش در سازمان
دانش صریح
دانش صریح یا Explicit Knowledge اطلاعاتی است که ثبت و مستند شده است.
برای مثال:
- آییننامه
- راهنمای محصول
- قرارداد
- دستورالعمل
- گزارش
- مقاله پایگاه دانش
- مستند فنی
- صورتجلسه
- پرسشهای متداول
- فرایند اجرایی
این نوع دانش سادهتر وارد سیستم مدیریت دانش میشود؛ زیرا منبع مشخص و محتوای قابلپردازش دارد.
دانش ضمنی
دانش ضمنی یا Tacit Knowledge تجربهای است که در ذهن کارکنان قرار دارد و هنوز به سند تبدیل نشده است.
برای مثال:
- روش تشخیص یک مشتری نامناسب
- تجربه رفع یک خطای خاص
- دلیل انتخاب یک تأمینکننده
- روش مذاکره با یک گروه از مشتریان
- نکتهای که فقط کارشناس باتجربه میداند
- تاریخچه تصمیمهای یک پروژه
هوش مصنوعی میتواند به استخراج و مستندسازی این دانش کمک کند. برای مثال، متن جلسه یا مصاحبه با کارشناس را خلاصه و به مقالهای ساختاریافته تبدیل کند.
بااینحال، خروجی باید توسط صاحب دانش بررسی و تأیید شود. مدل ممکن است توضیحات مختلف را اشتباه ترکیب کند یا بخشی از جزئیات را نادیده بگیرد.
دانش ساختاریافته
این اطلاعات در سیستمهایی مانند پایگاه داده، CRM یا نرمافزار منابع انسانی نگهداری میشوند.
برای مثال:
- وضعیت سفارش
- اطلاعات مشتری
- موجودی محصول
- فهرست کارکنان
- وضعیت قرارداد
- تاریخ اعتبار خدمات
برای دسترسی به این اطلاعات معمولاً به جستوجوی سندی نیاز نداریم. برنامه باید از API یا Query کنترلشده استفاده کند و نتیجه را در اختیار مدل قرار دهد.
دانش بدون ساختار
بخش بزرگی از اطلاعات سازمان در قالب متن آزاد نگهداری میشود:
- Word
- ایمیل
- مکالمه
- فایل صوتی
- تصویر اسکنشده
- یادداشت
- پیام
- گزارش متنی
پردازش این منابع یکی از مهمترین کاربردهای مدلهای زبانی و چندوجهی در مدیریت دانش است.
دستیار دانش سازمانی چیست؟
دستیار دانش سازمانی یک برنامه مبتنی بر هوش مصنوعی است که به کاربران کمک میکند اطلاعات موردنیاز خود را از منابع تأییدشده سازمان پیدا کنند.
این دستیار میتواند:
- سؤال کاربر را درک کند.
- منابع مجاز را جستوجو کند.
- بخشهای مرتبط را بازیابی کند.
- پاسخ کوتاه و قابلفهم تولید کند.
- منابع استفادهشده را نمایش دهد.
- در صورت نبود اطلاعات، از پاسخدادن خودداری کند.
- سؤال را به واحد یا کارشناس مناسب ارجاع دهد.
- بازخورد کاربر را ثبت کند.
تفاوت اصلی دستیار دانش با چتبات عمومی این است که پاسخ باید به منابع مشخص و کنترلشده متکی باشد.
تفاوت چتبات، جستوجوی سازمانی و دستیار دانش
| قابلیت | چتبات عمومی | جستوجوی سازمانی | دستیار دانش |
|---|---|---|---|
| دریافت سؤال طبیعی | بله | گاهی | بله |
| جستوجو در منابع داخلی | معمولاً خیر | بله | بله |
| تولید پاسخ ترکیبی | بله | معمولاً خیر | بله |
| نمایش منبع | محدود | بله | باید پشتیبانی شود |
| کنترل دسترسی | وابسته به ابزار | بله | ضروری |
| تشخیص نبود پاسخ | نامطمئن | فهرست نتیجه خالی | باید طراحی شود |
| استفاده از مدل زبانی | بله | الزامی نیست | بله |
| اتصال به گردش کار | محدود | محدود | قابلپیادهسازی |
جستوجوی سازمانی معمولاً فهرستی از اسناد را نمایش میدهد. دستیار دانش تلاش میکند پاسخ را از بخشهای بازیابیشده استخراج کند، اما همچنان باید امکان مشاهده منبع اصلی را در اختیار کاربر قرار دهد.
تفاوت مدیریت دانش با RAG
RAG یا تولید تقویتشده با بازیابی، یک روش فنی برای متصلکردن مدل زبانی به منابع خارجی است.
مدیریت دانش مفهوم بزرگتری است و موضوعاتی مانند این موارد را نیز پوشش میدهد:
- مالکیت محتوا
- اعتبار سند
- چرخه بهروزرسانی
- نسخهبندی
- دسترسی کاربران
- ثبت دانش جدید
- حذف اطلاعات منقضی
- تعیین منبع رسمی
- دریافت بازخورد
- شناسایی شکاف دانشی
- فرهنگ بهاشتراکگذاری دانش
RAG میتواند موتور بازیابی و پاسخگویی یک سیستم مدیریت دانش باشد، اما تمام سیستم مدیریت دانش نیست.
برای مطالعه معماری فنی به مقاله RAG چیست؟ مراجعه کنید.
هوش مصنوعی چگونه مدیریت دانش را بهبود میدهد؟
جستوجو با زبان طبیعی
کاربر لازم نیست عنوان دقیق سند یا واژه رسمی استفادهشده در آن را بداند. سؤال میتواند با زبان طبیعی مطرح شود.
برای مثال:
اگر مشتری درخواست لغو سرویس سالانه را داشته باشد، چه مراحلی باید انجام شود؟
سیستم میتواند بخش مرتبط را از میان آییننامه مالی، شرایط استفاده و راهنمای پشتیبانی پیدا کند.
خلاصهسازی اسناد
مدل میتواند یک گزارش طولانی را به خلاصه مدیریتی، فهرست تصمیمها یا اقدامات بعدی تبدیل کند.
خلاصه نباید جایگزین کامل سند اصلی شود. کاربر باید بتواند برای بررسی جزئیات به منبع مراجعه کند.
دستهبندی و برچسبگذاری
هنگام ورود یک سند جدید، مدل میتواند موارد زیر را پیشنهاد دهد:
- موضوع
- واحد مرتبط
- نوع محتوا
- کلیدواژهها
- سطح اهمیت
- تاریخ بازبینی
- اسناد مشابه
این اطلاعات باید پیش از ثبت نهایی توسط قوانین نرمافزاری یا مالک محتوا بررسی شوند.
استخراج اطلاعات
میتوان اطلاعات مشخصی را از اسناد استخراج کرد:
- نام قرارداد
- تاریخ شروع و پایان
- طرفهای قرارداد
- مسئول اجرا
- موضوع سند
- شماره نسخه
- واحد مالک
- اقدامات ثبتشده در صورتجلسه
تولید پیشنویس مقاله دانش
مدل میتواند از روی تیکتهای پرتکرار، گزارشهای رفع خطا یا مکالمه با کارشناس، پیشنویس یک مقاله پایگاه دانش را تولید کند.
فرایند صحیح:
منابع اولیه
↓
استخراج نکات
↓
تولید پیشنویس
↓
بررسی کارشناس
↓
تأیید مالک محتوا
↓
انتشار در پایگاه دانششناسایی شکافهای دانشی
اگر کاربران بارها سؤال مشابهی بپرسند اما سیستم نتواند منبع مناسبی پیدا کند، احتمالاً یک شکاف دانشی وجود دارد.
سیستم میتواند این موارد را گزارش کند:
- سؤالهای بدون پاسخ
- موضوعات پرتکرار
- اسناد کماستفاده
- پاسخهای دارای بازخورد منفی
- منابع قدیمی
- اصطلاحات دارای چند تعریف
- پرسشهایی که دائماً به کارشناس ارجاع میشوند
معماری دستیار دانش سازمانی
یک معماری پایه شامل دو جریان اصلی است:
جریان ورود و آمادهسازی دانش
اسناد و منابع سازمان
↓
استخراج متن
↓
پاکسازی و استانداردسازی
↓
تقسیم سند به بخشهای کوچکتر
↓
ثبت فراداده و سطح دسترسی
↓
تولید Embedding
↓
ذخیره در پایگاه داده برداریجریان پاسخگویی
سؤال کاربر
↓
شناسایی هویت و سطح دسترسی
↓
بازنویسی یا آمادهسازی سؤال
↓
جستوجوی معنایی و کلمهای
↓
اعمال فیلتر دسترسی
↓
انتخاب بخشهای مرتبط
↓
ارسال Context به مدل
↓
تولید پاسخ همراه منبع
↓
اعتبارسنجی و نمایش نتیجه
↓
ثبت بازخورداجزای اصلی پایگاه دانش هوشمند
منابع داده
ابتدا باید مشخص شود کدام منابع معتبرند.
ممکن است سازمان چند نسخه متفاوت از یک آییننامه داشته باشد. ورود همه نسخهها بدون تعیین اعتبار میتواند پاسخهای متناقض ایجاد کند.
برای هر منبع بهتر است اطلاعات زیر ثبت شود:
- شناسه سند
- عنوان
- نوع سند
- واحد مالک
- تاریخ انتشار
- تاریخ آخرین ویرایش
- شماره نسخه
- وضعیت اعتبار
- سطح دسترسی
- تاریخ بازبینی بعدی
- نشانی منبع اصلی
پردازش سند
فایلهای مختلف باید به متن قابلپردازش تبدیل شوند.
این مرحله ممکن است شامل موارد زیر باشد:
- استخراج متن PDF
- خواندن فایل Word
- تبدیل صوت به متن
- تشخیص متن تصویر
- حذف سربرگ و فوتر تکراری
- اصلاح فاصله و نویسههای فارسی
- تشخیص ساختار عنوانها
- استخراج جدول
- جداکردن ضمیمهها
کیفیت پایین استخراج متن مستقیماً بر کیفیت بازیابی اثر میگذارد.
تقسیمبندی اسناد
سند باید به بخشهایی تقسیم شود که هرکدام معنای نسبتاً مستقلی داشته باشند.
تقسیمبندی فقط براساس تعداد ثابت کلمات همیشه مناسب نیست. ساختار سند نیز باید در نظر گرفته شود:
- عنوان فصل
- عنوان بخش
- بند آییننامه
- ردیف جدول
- سؤال و پاسخ
- مرحله یک فرایند
- ماده قرارداد
برای توضیحات بیشتر میتوانید مقاله Chunking چیست؟ را مطالعه کنید.
فراداده
فراداده یا Metadata به سیستم کمک میکند نتایج را محدود و کنترل کند.
نمونه فراداده:
{
"document_id": "HR-POLICY-014",
"title": "آییننامه مرخصی کارکنان",
"department": "human_resources",
"version": "3.1",
"status": "active",
"access_level": "employees",
"updated_at": "2026-08-10"
}با استفاده از فراداده میتوان فقط اسناد معتبر و مجاز را جستوجو کرد.
مدل Embedding
مدل Embedding برای تبدیل سؤال و بخشهای اسناد به بردار استفاده میشود.
مدل مناسب باید روی دادههای واقعی سازمان آزمایش شود، بهخصوص اگر منابع فارسی، دوزبانه یا دارای اصطلاحات تخصصی باشند.
پایگاه داده برداری
پایگاه داده برداری، Embeddingها و فراداده مرتبط را نگهداری میکند و بخشهای مشابه با سؤال کاربر را پیدا میکند.
مقاله Vector Database چیست؟ این موضوع را کاملتر بررسی میکند.
بازیاب
Retriever مسئول انتخاب اطلاعات مناسب است.
یک بازیاب حرفهای ممکن است چند روش را ترکیب کند:
- جستوجوی معنایی
- جستوجوی کلمهای
- فیلتر فراداده
- محدودکردن نتایج براساس دسترسی
- بازرتبهبندی نتایج
- حذف نتایج تکراری
- افزایش تنوع منابع
ترکیب جستوجوی کلمهای و معنایی با عنوان Hybrid Search شناخته میشود.
برای اطلاعات بیشتر به مقاله Hybrid Search چیست؟ مراجعه کنید.
مدل تولیدکننده پاسخ
پس از بازیابی، بخشهای مرتبط همراه سؤال به مدل زبانی ارسال میشوند.
مدل باید دستور مشخصی دریافت کند:
- فقط از Context استفاده کند.
- در صورت نبود اطلاعات پاسخ قطعی نسازد.
- منبع هر بخش را مشخص کند.
- تناقض منابع را پنهان نکند.
- میان متن منبع و برداشت خود تفاوت بگذارد.
- پاسخ را کوتاه و متناسب با سؤال تولید کند.
چرا نمایش منبع ضروری است؟
پاسخ روان الزاماً پاسخ صحیح نیست.
نمایش منبع به کاربر اجازه میدهد:
- پاسخ را بررسی کند.
- متن اصلی را ببیند.
- تاریخ و نسخه سند را کنترل کند.
- تناقض احتمالی را تشخیص دهد.
- برای تصمیم مهم به سند رسمی مراجعه کند.
منبع بهتر است شامل این اطلاعات باشد:
- عنوان سند
- بخش یا صفحه مرتبط
- شماره نسخه
- تاریخ آخرین ویرایش
- لینک مشاهده سند
- شناسه منبع
در راهنمای Microsoft درباره RAG نیز اتصال پاسخ به دانش مورداعتماد سازمان یکی از اهداف اصلی بازیابی پیش از تولید معرفی شده است.
مدیریت نسخه و تازگی اطلاعات
یکی از مهمترین چالشها، قدیمیشدن محتواست.
اگر آییننامه جدید منتشر شود اما نسخه قدیمی همچنان در نتایج جستوجو حضور داشته باشد، مدل ممکن است پاسخ نادرستی تولید کند.
برای هر سند باید وضعیت مشخصی وجود داشته باشد:
- پیشنویس
- در انتظار تأیید
- فعال
- جایگزینشده
- منقضی
- بایگانیشده
در زمان بازیابی، معمولاً فقط اسناد فعال باید استفاده شوند؛ مگر آنکه کاربر بهطور مشخص درباره سابقه یا نسخه قدیمی سؤال کند.
فرایند همگامسازی نیز باید مشخص باشد:
تغییر منبع اصلی
↓
تشخیص تغییر
↓
پردازش مجدد بخش تغییرکرده
↓
ساخت Embedding جدید
↓
حذف یا غیرفعالکردن نسخه قبلی
↓
بهروزرسانی فهرست جستوجوکنترل دسترسی در پایگاه دانش
وجود یک سند در پایگاه دانش به این معنا نیست که تمام کاربران باید آن را ببینند.
برای مثال:
- اسناد عمومی برای تمام کارکنان
- اطلاعات مالی فقط برای واحد مالی
- پرونده منابع انسانی فقط برای افراد مجاز
- مستندات پروژه فقط برای اعضای همان پروژه
- قراردادها فقط برای مدیران و واحد حقوقی
فیلتر دسترسی باید پیش از ارسال متن به مدل اعمال شود.
روش نادرست:
جستوجو در تمام اسناد
↓
ارسال نتایج به مدل
↓
حذف بخش غیرمجاز از پاسخ نهاییروش مناسبتر:
شناسایی کاربر
↓
تعیین منابع مجاز
↓
جستوجو فقط در منابع مجاز
↓
ارسال نتایج مجاز به مدلمدل نباید مسئول تشخیص سطح دسترسی کاربر باشد. این کنترل باید در نرمافزار و لایه بازیابی اجرا شود.
چه زمانی سیستم باید از پاسخدادن خودداری کند؟
یک دستیار دانش خوب نباید برای تمام سؤالها پاسخ قطعی تولید کند.
در شرایط زیر بهتر است پاسخ محدود یا متوقف شود:
- هیچ منبع مرتبطی پیدا نشده است.
- نتیجه بازیابی ضعیف است.
- چند سند معتبر با یکدیگر تناقض دارند.
- منبع منقضی شده است.
- کاربر به سند موردنیاز دسترسی ندارد.
- سؤال خارج از محدوده سیستم است.
- پاسخ نیازمند تصمیم تخصصی است.
- اطلاعات برای نتیجهگیری کافی نیست.
نمونه پاسخ مناسب:
در منابع مجاز فعلی، پاسخ مشخصی برای این سؤال پیدا نشد. لطفاً موضوع را با واحد منابع انسانی بررسی کنید.
این رفتار از تولید یک پاسخ ظاهراً قانعکننده اما بدون پشتوانه بهتر است.
ساخت نمونه دستیار دانش با API درواره
در این نمونه ساده:
- چند سند کوتاه تعریف میکنیم.
- با مدل Embedding بردار آنها را میسازیم.
- نزدیکترین اسناد به سؤال را پیدا میکنیم.
- بخشهای بازیابیشده را به مدل زبانی میدهیم.
- پاسخ را همراه شناسه منابع دریافت میکنیم.
این نمونه برای آموزش است. در پروژه واقعی باید از پایگاه داده، کنترل دسترسی و فرایند همگامسازی استفاده شود.
ابتدا کتابخانهها را نصب کنید:
pip install openai numpy pydanticمتغیرهای محیطی را تنظیم کنید:
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_CHAT_MODEL="YOUR_CHAT_MODEL_ID"
export DARVAREH_EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ID"
شناسه مدلهای فعال را از فهرست مدلهای درواره انتخاب کنید.
کد پایتون:
import os
import numpy as np
from openai import OpenAI
from pydantic import BaseModel, ValidationError
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1",
)
CHAT_MODEL = os.environ["DARVAREH_CHAT_MODEL"]
EMBEDDING_MODEL = os.environ["DARVAREH_EMBEDDING_MODEL"]
DOCUMENTS = [
{
"id": "HR-LEAVE-01",
"title": "آییننامه مرخصی کارکنان",
"text": (
"درخواست مرخصی روزانه باید پیش از شروع مرخصی "
"در سامانه منابع انسانی ثبت و توسط مدیر مستقیم تأیید شود. "
"در موارد اضطراری، ثبت درخواست در اولین زمان ممکن الزامی است."
),
},
{
"id": "IT-ACCESS-02",
"title": "راهنمای درخواست دسترسی نرمافزاری",
"text": (
"درخواست دسترسی به نرمافزارهای سازمانی باید توسط مدیر واحد "
"ثبت شود. واحد فناوری اطلاعات پس از بررسی سطح دسترسی، "
"حساب کاربری را ایجاد یا دسترسی موجود را تغییر میدهد."
),
},
{
"id": "FIN-PURCHASE-03",
"title": "فرایند درخواست خرید",
"text": (
"درخواست خرید باید شامل شرح کالا یا خدمت، تعداد، بودجه پیشنهادی "
"و زمان موردنیاز باشد. درخواست پس از تأیید مدیر واحد "
"برای بررسی به واحد تدارکات ارسال میشود."
),
},
]
class KnowledgeAnswer(BaseModel):
answer_found: bool
answer: str
sources: list[str]
def create_embeddings(texts: list[str]) -> list[list[float]]:
response = client.embeddings.create(
model=EMBEDDING_MODEL,
input=texts,
)
return [item.embedding for item in response.data]
def cosine_similarity(
first_vector: list[float],
second_vector: list[float],
) -> float:
first = np.array(first_vector)
second = np.array(second_vector)
denominator = np.linalg.norm(first) * np.linalg.norm(second)
if denominator == 0:
return 0.0
return float(np.dot(first, second) / denominator)
def retrieve_documents(
question: str,
limit: int = 2,
) -> list[dict]:
document_texts = [
f"{document['title']}\n{document['text']}"
for document in DOCUMENTS
]
document_vectors = create_embeddings(document_texts)
question_vector = create_embeddings([question])[0]
scored_documents = []
for document, vector in zip(
DOCUMENTS,
document_vectors,
strict=True,
):
score = cosine_similarity(question_vector, vector)
scored_documents.append(
{
**document,
"score": score,
}
)
scored_documents.sort(
key=lambda item: item["score"],
reverse=True,
)
return scored_documents[:limit]
def answer_from_knowledge_base(
question: str,
) -> KnowledgeAnswer:
retrieved_documents = retrieve_documents(question)
context_parts = []
for document in retrieved_documents:
context_parts.append(
f"""
شناسه منبع: {document["id"]}
عنوان: {document["title"]}
متن:
{document["text"]}
""".strip()
)
context = "\n\n---\n\n".join(context_parts)
prompt = f"""
براساس منابع زیر به سؤال کاربر پاسخ بده.
قواعد:
- فقط از اطلاعات موجود در منابع استفاده کن.
- اگر پاسخ در منابع وجود ندارد، answer_found را false قرار بده.
- اطلاعات جدید یا حدسی اضافه نکن.
- شناسه منابع استفادهشده را در sources قرار بده.
- اگر منابع با یکدیگر تناقض دارند، تناقض را در پاسخ توضیح بده.
- پاسخ را فقط بهصورت JSON معتبر برگردان.
- هیچ متن یا Markdown خارج از JSON ننویس.
ساختار خروجی:
{{
"answer_found": true,
"answer": "پاسخ فارسی",
"sources": ["SOURCE-ID"]
}}
منابع:
{context}
سؤال کاربر:
{question}
"""
completion = client.chat.completions.create(
model=CHAT_MODEL,
temperature=0.1,
messages=[
{
"role": "system",
"content": (
"شما دستیار پایگاه دانش سازمان هستید. "
"پاسخها باید فقط براساس منابع ارائهشده باشند."
),
},
{
"role": "user",
"content": prompt,
},
],
)
content = completion.choices[0].message.content
if not content:
raise ValueError("پاسخی از مدل دریافت نشد.")
try:
return KnowledgeAnswer.model_validate_json(content)
except ValidationError as error:
raise ValueError(
f"ساختار پاسخ مدل معتبر نیست: {error}"
) from error
result = answer_from_knowledge_base(
"برای گرفتن مرخصی روزانه باید چه کاری انجام بدهم؟"
)
print(result.model_dump_json(indent=2))نمونه خروجی:
{
  "answer_found": true,
  "answer": "درخواست مرخصی روزانه باید پیش از شروع مرخصی در سامانه منابع انسانی ثبت و توسط مدیر مستقیم تأیید شود. در شرایط اضطراری، درخواست باید در اولین زمان ممکن ثبت شود.",
  "sources": [
    "HR-LEAVE-01"
  ]
}
در رابط کاربری، شناسه منبع باید به صفحه یا فایل اصلی متصل شود تا کاربر بتواند متن کامل و نسخه سند را مشاهده کند.
محدودیتهای نمونه آموزشی
کد بالا برای توضیح جریان RAG نوشته شده و برای استفاده مستقیم در محیط عملیاتی کافی نیست.
در نسخه واقعی باید این قابلیتها اضافه شوند:
- ذخیره Embedding اسناد
- جلوگیری از تولید مجدد بردار در هر درخواست
- استفاده از پایگاه داده برداری
- فیلتر دسترسی کاربر
- ثبت نسخه سند
- حذف منابع منقضی
- تعیین حداقل کیفیت بازیابی
- مدیریت Timeout
- Retry محدود
- ثبت میزان مصرف
- کش پرسشهای پرتکرار
- ارزیابی خودکار
- گزارش سؤالهای بدون پاسخ
- لینک مستقیم به منبع
- ثبت بازخورد کاربر
چگونه کیفیت دستیار دانش را ارزیابی کنیم؟
ارزیابی فقط نباید روی روانبودن پاسخ تمرکز کند.
سامانه RAG از دو بخش اصلی تشکیل شده است:
- بازیابی اطلاعات
- تولید پاسخ
ممکن است مدل پاسخگوی خوبی باشد، اما بازیاب سند اشتباهی را انتخاب کند. همچنین ممکن است سند درست پیدا شود، اما مدل بخشی از آن را نادرست توضیح دهد.
ارزیابی بازیابی
بررسی کنید:
- آیا منبع صحیح در نتایج وجود دارد؟
- آیا منبع صحیح در رتبههای اول قرار گرفته است؟
- آیا اسناد نامرتبط حذف شدهاند؟
- آیا نسخه فعال سند انتخاب شده است؟
- آیا فیلتر دسترسی درست عمل کرده است؟
- آیا سؤالهای فارسی و معادلهای مختلف بازیابی میشوند؟
ارزیابی پاسخ
بررسی کنید:
- آیا پاسخ با منبع سازگار است؟
- آیا اطلاعاتی خارج از منبع اضافه شده است؟
- آیا پاسخ به سؤال اصلی مرتبط است؟
- آیا نبود اطلاعات را تشخیص میدهد؟
- آیا منابع درست نمایش داده میشوند؟
- آیا تناقض اسناد مشخص شده است؟
- آیا پاسخ فارسی روان و قابلفهم است؟
مایکروسافت در مستندات ارزیابی سامانههای RAG نیز بازیابی و پاسخ نهایی را بهعنوان بخشهای مرتبط اما قابلارزیابی جداگانه در نظر میگیرد.
ساخت مجموعه آزمون
برای ارزیابی اولیه، مجموعهای از سؤالهای واقعی آماده کنید.
انواع سؤالها:
- پاسخ مستقیم در یک سند
- پاسخ پراکنده در چند بخش
- سؤال با واژه متفاوت از متن سند
- سؤال مبهم
- سؤال خارج از محدوده
- سؤال دارای اطلاعات ناقص
- سؤال درباره سند منقضی
- سؤال دارای منابع متناقض
- سؤال درباره محتوای غیرمجاز
- سؤال فارسی محاورهای
- سؤال دارای اشتباه تایپی
برای هر سؤال این اطلاعات را ثبت کنید:
- پاسخ موردانتظار
- منابع صحیح
- منابع غیرمجاز
- رفتار مطلوب در صورت نبود پاسخ
- نیاز یا عدم نیاز به ارجاع انسانی
پس از تغییر مدل، Embedding، روش Chunking یا تنظیمات بازیابی، همین مجموعه باید دوباره اجرا شود.
بازخورد کاربران چه کاربردی دارد؟
برای هر پاسخ میتوان گزینههای سادهای در نظر گرفت:
- پاسخ مفید بود.
- پاسخ ناقص بود.
- منبع اشتباه بود.
- اطلاعات قدیمی بود.
- پاسخ پیدا نشد.
- نیاز به توضیح بیشتر دارد.
بازخورد نباید فقط به یک امتیاز کلی محدود شود. نوع مشکل مشخص میکند کدام بخش باید اصلاح شود.
| بازخورد | علت احتمالی |
|---|---|
| منبع اشتباه بود | ضعف بازیابی یا Embedding |
| پاسخ ناقص بود | Context ناکافی یا دستور نامناسب |
| اطلاعات قدیمی بود | مشکل همگامسازی یا نسخهبندی |
| پاسخ پیدا نشد | نبود محتوا یا ضعف جستوجو |
| پاسخ با منبع سازگار نبود | مشکل مدل یا پرامپت |
| دسترسی اشتباه بود | اشکال در کنترل سطح دسترسی |
چگونه هزینه دستیار دانش را کنترل کنیم؟
Embedding را فقط هنگام تغییر سند بسازید
بردار اسناد نباید در هر سؤال دوباره تولید شود. هنگام ورود یا ویرایش سند، بخشهای تغییرکرده پردازش و ذخیره میشوند.
فقط بخشهای مرتبط را ارسال کنید
ارسال تعداد زیادی سند هزینه و احتمال حواسپرتی مدل را افزایش میدهد. بازیاب باید Context محدود و مرتبطی ایجاد کند.
از مدل متناسب با وظیفه استفاده کنید
یک مدل اقتصادی ممکن است برای پاسخهای ساده کافی باشد. سؤالهای پیچیده را میتوان به مدل قویتری ارسال کرد.
پاسخ را کوتاه نگه دارید
دستیار دانش معمولاً باید پاسخ دقیق و قابلبررسی ارائه کند، نه مقالهای طولانی برای هر سؤال.
پرسشهای پرتکرار را کش کنید
اگر محتوا تغییر نکرده باشد، پاسخ برخی سؤالهای پرتکرار را میتوان برای مدت مشخصی ذخیره کرد.
مصرف را براساس واحد ثبت کنید
میزان استفاده واحدهای منابع انسانی، پشتیبانی، فروش و فناوری اطلاعات را جداگانه بررسی کنید.
مدیریت دانش با API درواره
در یک دستیار دانش، معمولاً حداقل به دو نوع مدل نیاز دارید:
- مدل Embedding برای بازیابی معنایی
- مدل زبانی برای تولید پاسخ
درواره امکان دسترسی به مدلهای مختلف را از طریق یک API سازگار با OpenAI فراهم میکند.
آدرس پایه:
https://api.darvareh.ir/v1استفاده از یک رابط یکپارچه کمک میکند مدلهای مختلف را بدون ایجاد اتصال کاملاً جداگانه مقایسه کنید.
در Backend میتوانید شناسه مدلها را از طریق تنظیمات تعیین کنید:
DARVAREH_CHAT_MODEL
DARVAREH_EMBEDDING_MODEL
با این روش، تعویض مدل نیازمند تغییر بخشهای مختلف کد نیست.
مسیر اجرای پروژه مدیریت دانش با هوش مصنوعی
مرحله اول: انتخاب یک حوزه محدود
بهجای واردکردن تمام اسناد سازمان، با یک حوزه مشخص شروع کنید:
- راهنمای محصول
- آییننامه منابع انسانی
- مستندات فنی
- پاسخهای پشتیبانی
- فرایندهای فروش
- راهنمای عملیات
مرحله دوم: تعیین منابع رسمی
مشخص کنید کدام اسناد معتبرند و مالک هر محتوا چه کسی است.
مرحله سوم: پاکسازی محتوا
نسخههای تکراری، قدیمی یا ناقص را شناسایی کنید. فناوری نمیتواند تناقض موجود در منابع را بهطور قابلاعتماد برطرف کند.
مرحله چهارم: ساخت نمونه ارزیابی
پیش از توسعه کامل، سؤالهای واقعی و پاسخهای موردانتظار را جمعآوری کنید.
مرحله پنجم: ساخت نمونه اولیه
جریان سادهای برای ورود اسناد، بازیابی و تولید پاسخ ایجاد کنید.
مرحله ششم: اجرای آزمایشی
سیستم را ابتدا برای گروه کوچکی از کاربران فعال کنید و بازخورد دقیق بگیرید.
مرحله هفتم: اصلاح بازیابی و محتوا
خطاها را براساس منشأ آنها دستهبندی کنید:
- مشکل سند
- مشکل پردازش
- مشکل Chunking
- مشکل بازیابی
- مشکل مدل
- مشکل دستور
- مشکل رابط کاربری
مرحله هشتم: توسعه تدریجی
پس از رسیدن به کیفیت قابلقبول، منابع و واحدهای بیشتری را اضافه کنید.
اشتباهات رایج
واردکردن تمام فایلها بدون پاکسازی
اگر منابع تکراری، منقضی و متناقض باشند، دستیار نیز پاسخهای متناقض تولید میکند.
تمرکز کامل روی مدل زبانی
در بسیاری از پروژههای مدیریت دانش، کیفیت داده و بازیابی بیشتر از انتخاب مدل تولیدکننده بر نتیجه اثر میگذارد.
نداشتن منبع در پاسخ
پاسخی که قابلبررسی نباشد، برای استفاده سازمانی اعتمادپذیری کمتری دارد.
استفاده از یک سطح دسترسی برای همه
دسترسی باید پیش از بازیابی اعمال شود، نه پس از تولید پاسخ.
پاسخ اجباری به تمام سؤالها
سیستم باید بتواند نبود اطلاعات کافی را اعلام کند.
بهروزرسانی دستی و نامنظم
اگر منبع اصلی تغییر کند اما فهرست جستوجو بهروز نشود، پاسخها بهمرور قدیمی میشوند.
نداشتن مالک محتوا
هر حوزه باید فرد یا واحد مشخصی برای تأیید و بازبینی محتوا داشته باشد.
سنجش کیفیت فقط با رضایت ظاهری
پاسخ روان ممکن است اشتباه باشد. صحت منبع و سازگاری پاسخ با سند باید جداگانه ارزیابی شوند.
پرسشهای متداول
مدیریت دانش با هوش مصنوعی چیست؟
مدیریت دانش با هوش مصنوعی به استفاده از مدلهای هوش مصنوعی برای سازماندهی، جستوجو، خلاصهسازی و استفاده بهتر از اطلاعات سازمان گفته میشود.
دستیار دانش سازمانی چیست؟
دستیار دانش سازمانی برنامهای است که منابع مجاز سازمان را جستوجو کرده و براساس اطلاعات بازیابیشده به سؤال کاربران پاسخ میدهد.
آیا دستیار دانش همان چتبات است؟
خیر. چتبات ممکن است فقط براساس دانش عمومی مدل پاسخ دهد، اما دستیار دانش باید به منابع سازمان متصل باشد و پاسخ را همراه منبع ارائه کند.
تفاوت مدیریت دانش با RAG چیست؟
مدیریت دانش یک فرایند سازمانی شامل تولید، اعتبارسنجی، نگهداری و انتشار دانش است. RAG یک روش فنی برای بازیابی اطلاعات و قراردادن آنها در اختیار مدل زبانی است.
آیا برای ساخت پایگاه دانش هوشمند به Fine-tuning نیاز داریم؟
در بیشتر پروژهها خیر. RAG اجازه میدهد اطلاعات سازمان بدون آموزش مجدد مدل در زمان پاسخگویی استفاده شوند.
آیا میتوان از فایلهای PDF و Word استفاده کرد؟
بله. ابتدا متن و ساختار فایل استخراج میشود و سپس بخشهای مناسب برای جستوجو آماده میشوند.
آیا پاسخهای RAG همیشه صحیح هستند؟
خیر. بازیابی ممکن است منبع اشتباهی انتخاب کند یا مدل Context را نادرست تفسیر کند. ارزیابی، نمایش منبع و امکان اعلام نبود پاسخ ضروری است.
چگونه از اطلاعات قدیمی جلوگیری کنیم؟
برای اسناد باید نسخه، وضعیت اعتبار، تاریخ و مالک محتوا ثبت شود. هنگام انتشار نسخه جدید، نسخه قبلی باید غیرفعال یا بایگانی شود.
آیا میتوان دسترسی کاربران را محدود کرد؟
بله. سطح دسترسی باید پیش از جستوجو اعمال شود تا فقط منابع مجاز وارد Context مدل شوند.
درواره چه نقشی در این معماری دارد؟
درواره دسترسی API به مدلهای زبانی و مدلهای Embedding را فراهم میکند. مدیریت اسناد، دسترسی کاربران، پایگاه داده و گردش کار در نرمافزار سازمان پیادهسازی میشود.
جمعبندی
مدیریت دانش با هوش مصنوعی فقط ساخت یک چتبات روی چند فایل PDF نیست. موفقیت چنین سامانهای به کیفیت منابع، مالکیت محتوا، نسخهبندی، کنترل دسترسی، بازیابی دقیق، نمایش منبع و ارزیابی مداوم وابسته است.
برای ساخت یک دستیار دانش سازمانی:
- یک حوزه محدود انتخاب کنید.
- منابع رسمی و معتبر را مشخص کنید.
- اسناد قدیمی و تکراری را پاکسازی کنید.
- برای هر سند فراداده و سطح دسترسی ثبت کنید.
- محتوا را متناسب با ساختار آن تقسیم کنید.
- از Embedding و جستوجوی معنایی برای بازیابی استفاده کنید.
- فقط اطلاعات مرتبط را به مدل زبانی بدهید.
- پاسخ را همراه منبع نمایش دهید.
- در صورت نبود اطلاعات از پاسخ قطعی خودداری کنید.
- کیفیت بازیابی و پاسخ را جداگانه ارزیابی کنید.
- بازخورد کاربران را به اصلاح محتوا و سیستم متصل کنید.
- منابع را بهصورت منظم همگامسازی و بازبینی کنید.
اگر قصد دارید پایگاه دانش، دستیار داخلی کارکنان یا سامانه پاسخگویی براساس اسناد بسازید، میتوانید از مستندات API درواره شروع کنید.
API سازگار با OpenAI درواره امکان آزمایش مدلهای مختلف زبانی و Embedding را از طریق یک اتصال یکپارچه فراهم میکند.
مقالات مرتبط
- هوش مصنوعی سازمانی چیست؟
- RAG چیست؟
- Embedding چیست؟
- Vector Database چیست؟
- Chunking چیست؟
- Semantic Search چیست؟
- Hybrid Search چیست؟
- LlamaIndex چیست؟
- پردازش هوشمند اسناد چیست؟
- AIaaS چیست؟
منابع
- IBM: What Is Knowledge Management?
- IBM: Generative AI for Knowledge Management
- Microsoft: Retrieval-Augmented Generation
- Microsoft: Advanced RAG Systems
- Microsoft: RAG Evaluation
- Google Cloud: What Is RAG?
- AWS: Knowledge Bases for Amazon Bedrock
- مستندات API درواره
- OpenAI Python Library
- NumPy Documentation
- Pydantic Documentation
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، اعتبار منابع، مجوزهای دسترسی، مستندات سرویسها و صفحه سلب مسئولیت درواره را بررسی کنید.