سیستم پیشنهاددهنده چیست؟ آموزش پیشنهاد محصول با هوش مصنوعی
سیستم پیشنهاددهنده با تحلیل ویژگی محصولات، رفتار کاربران و Context فعلی، گزینههای مرتبط را رتبهبندی میکند. در این راهنما انواع سیستم توصیهگر و ساخت نمونه عملی پیشنهاد محصول با API درواره را بررسی میکنیم.
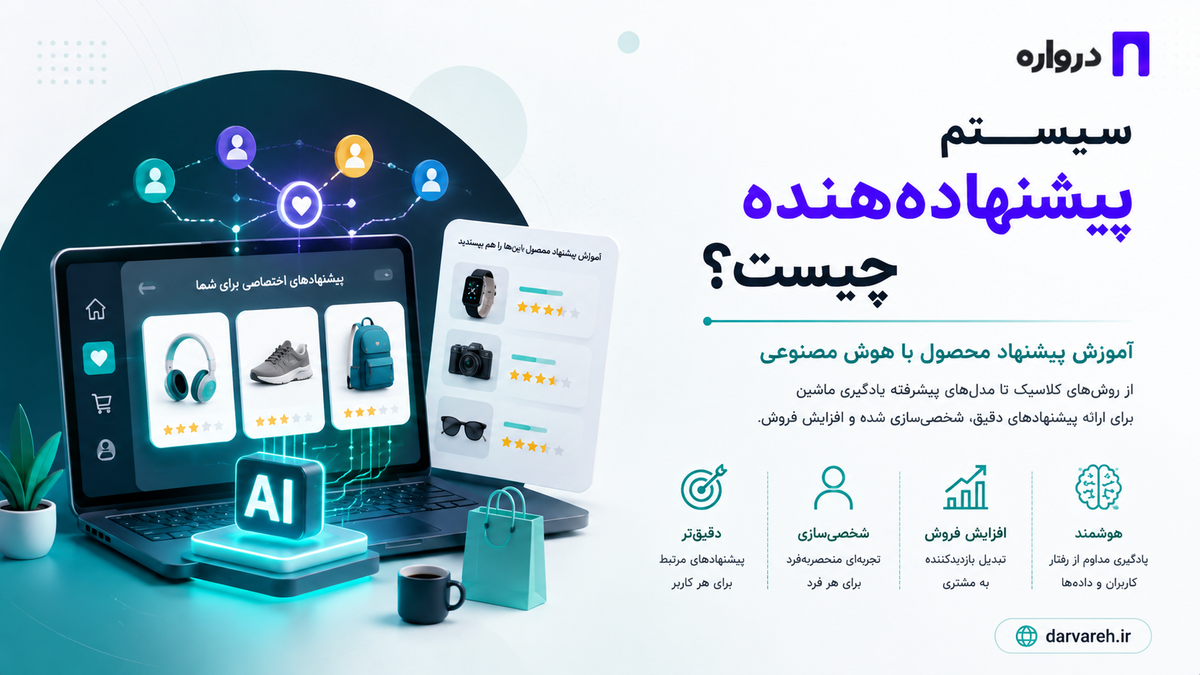
وقتی یک فروشگاه اینترنتی محصول مرتبط نمایش میدهد، یک سرویس پخش فیلم محتوای بعدی را پیشنهاد میکند یا یک نرمافزار آموزشی درس مناسب هر کاربر را انتخاب میکند، معمولاً یک سیستم پیشنهاددهنده در پشت این تجربه قرار دارد.
سیستم پیشنهاددهنده یا Recommendation System سامانهای است که از میان تعداد زیادی گزینه، مواردی را انتخاب و رتبهبندی میکند که احتمالاً برای کاربر مرتبطتر هستند.
این سیستم میتواند برای پیشنهاد موارد مختلف استفاده شود:
- محصول
- فیلم و سریال
- موسیقی
- مقاله
- ویدئو
- دوره آموزشی
- شغل
- رستوران
- خبر
- کتاب
- قابلیت نرمافزار
- پاسخ یا اقدام بعدی
در نسل جدید سیستمهای پیشنهاددهنده، مدلهای زبانی و هوش مصنوعی مولد نیز به معماری اضافه شدهاند. این مدلها میتوانند درخواست طبیعی کاربر را بفهمند، ویژگیهای محصولات را استخراج کنند، گزینههای بازیابیشده را دوباره رتبهبندی کنند و دلیل هر پیشنهاد را به زبان قابلفهم توضیح دهند.
برای مثال، کاربر میتواند بهجای انتخاب چند فیلتر بنویسد:
برای یک تیم فروش پنجنفره، یک نرمافزار ساده میخواهم که گزارشگیری داشته باشد و راهاندازی آن پیچیده نباشد.
سیستم میتواند این درخواست را تحلیل کند، محصولات واقعی کاتالوگ را بازیابی کند و تنها گزینههایی را پیشنهاد دهد که با نیاز کاربر سازگار هستند.
سیستم پیشنهاددهنده چیست؟
سیستم پیشنهاددهنده نرمافزاری است که گزینههای موجود را براساس اطلاعات کاربر، ویژگی آیتمها، تعاملات گذشته و شرایط فعلی رتبهبندی میکند.
هدف سیستم این نیست که همیشه «بهترین گزینه جهان» را پیدا کند؛ بلکه باید گزینه مناسبتر برای همان کاربر و همان موقعیت را پیشنهاد دهد.
دو کاربر ممکن است وارد یک فروشگاه شوند و پیشنهادهای متفاوتی ببینند:
- کاربر اول قبلاً محصولات اقتصادی خریده است.
- کاربر دوم بیشتر محصولات حرفهای را مشاهده کرده است.
- کاربر سوم هنوز هیچ سابقهای ندارد و از طریق جستوجوی مشخصی وارد شده است.
سیستم پیشنهاددهنده باید برای هرکدام از این شرایط راهبرد متفاوتی داشته باشد.
طبق دوره رسمی Google درباره Recommendation Systems، سیستمهای پیشنهاددهنده به کاربران کمک میکنند در مجموعههای بزرگ، محتوای مرتبط و جدید را کشف کنند؛ کاری که فقط با جستوجوی مستقیم یا مرور دستهبندیها همیشه ساده نیست.
تفاوت سیستم پیشنهاددهنده و موتور جستوجو
موتور جستوجو و سیستم پیشنهاددهنده هر دو برای یافتن گزینههای مرتبط استفاده میشوند، اما نقطه شروع آنها متفاوت است.
در جستوجو، کاربر معمولاً نیاز خود را بهصورت مستقیم بیان میکند:
گوشی با حافظه ۲۵۶ گیگابایت
در پیشنهاددهی، سیستم میتواند حتی بدون Query صریح، گزینههایی را نمایش دهد:
پیشنهاد برای شما
محصولات مشابه
کاربران دیگر این محصولات را نیز دیدهاند
ادامه مشاهده
مناسب برای خرید بعدی
| ویژگی | موتور جستوجو | سیستم پیشنهاددهنده |
|---|---|---|
| نقطه شروع | Query کاربر | کاربر، آیتم یا Context |
| هدف | یافتن پاسخ برای درخواست مشخص | کشف گزینههای مرتبط |
| شخصیسازی | اختیاری | معمولاً مهم |
| سابقه تعامل | همیشه ضروری نیست | اغلب مفید است |
| زمان استفاده | هنگام جستوجوی مستقیم | در صفحه اصلی، محصول یا مراحل مختلف |
| نوع خروجی | نتایج منطبق با Query | فهرست رتبهبندیشده پیشنهادی |
در بسیاری از محصولات، جستوجو و پیشنهاددهی در یک معماری مشترک استفاده میشوند.
برای مثال، کاربر ابتدا عبارت «لپتاپ برنامهنویسی» را جستوجو میکند. موتور جستوجو محصولات مرتبط را بازیابی میکند و سیستم پیشنهاددهنده نتایج را براساس نیاز، موجودی، ویژگیها و ترجیحات کاربر رتبهبندی میکند.
سیستم پیشنهاددهنده چگونه کار میکند؟
معماریهای واقعی میتوانند بسیار پیچیده باشند، اما بیشتر آنها سه مرحله اصلی دارند:
- تولید نامزدها
- امتیازدهی و رتبهبندی
- بازرتبهبندی نهایی
گوگل نیز در راهنمای معماری سیستمهای پیشنهاددهنده این ساختار سهمرحلهای را معرفی میکند.
مرحله اول: تولید نامزدها
در این مرحله، سیستم از میان تعداد زیادی آیتم، مجموعه کوچکتری از گزینههای مرتبط را پیدا میکند.
فرض کنید یک فروشگاه یک میلیون محصول دارد. ارسال تمام محصولات به مدل رتبهبندی یا مدل زبانی عملی نیست.
Candidate Generation میتواند یک میلیون محصول را به چندصد گزینه کاهش دهد.
نامزدها میتوانند از منابع مختلف به دست آیند:
- محصولات مشابه محصول فعلی
- محصولات محبوب
- خریدهای قبلی کاربر
- رفتار کاربران مشابه
- نتایج جستوجوی متنی
- جستوجوی معنایی
- دستهبندی موردعلاقه کاربر
- کالاهای موجود
- آیتمهای تازه منتشرشده
مرحله دوم: امتیازدهی و رتبهبندی
در این مرحله، سیستم بررسی میکند کدام نامزدها برای کاربر مناسبتر هستند.
اطلاعات مورد استفاده میتواند شامل این موارد باشد:
- ویژگی محصول
- دستهبندی
- قیمت
- سابقه مشاهده
- سابقه خرید
- کلیکهای قبلی
- زمان تعامل
- نوع دستگاه
- عبارت جستوجو
- آیتم فعلی
- زمان یا فصل
- محبوبیت
- تازگی محتوا
خروجی این مرحله یک فهرست مرتبشده است.
مرحله سوم: بازرتبهبندی
در مرحله Re-ranking، فهرست اولیه براساس قواعد تکمیلی تنظیم میشود.
برای مثال:
- محصولات ناموجود حذف شوند.
- گزینههای بسیار مشابه پشت سر هم نمایش داده نشوند.
- محصولات تازه نیز فرصت نمایش داشته باشند.
- تنوع دستهبندی حفظ شود.
- قیمتهای متفاوت در نتایج وجود داشته باشند.
- فقط محصولات قابلارائه نمایش داده شوند.
راهنمای رسمی Google درباره Re-ranking توضیح میدهد که در مرحله پایانی میتوان نامزدها را براساس معیارها و محدودیتهای تکمیلی دوباره مرتب یا فیلتر کرد.
انواع سیستمهای پیشنهاددهنده
سیستم پیشنهاددهنده محبوبیتمحور
سادهترین روش این است که گزینههای محبوب به همه کاربران پیشنهاد شوند.
نمونهها:
- پرفروشترین محصولات هفته
- پربازدیدترین مقالات
- محبوبترین ویدئوها
- دورههای پرثبتنام
- محصولات ترند
این روش به اطلاعات شخصیسازیشده نیاز ندارد و برای شروع یک محصول جدید مفید است.
اما اگر همه کاربران همیشه پیشنهادهای یکسان ببینند، سیستم تفاوت نیازها را در نظر نمیگیرد.
سیستم پیشنهاددهنده محتوامحور
Content-Based Filtering براساس ویژگی آیتمهایی کار میکند که کاربر قبلاً به آنها علاقه نشان داده است.
فرض کنید کاربری چند لپتاپ با این ویژگیها را مشاهده کرده است:
- نمایشگر ۱۵ اینچ
- حافظه زیاد
- مناسب برنامهنویسی
- وزن متوسط
- بازه قیمت مشخص
سیستم محصولات دیگری با ویژگیهای مشابه پیشنهاد میدهد.
طبق راهنمای Content-Based Filtering گوگل، این روش از ویژگی آیتمها و تعاملات قبلی کاربر برای پیشنهاد موارد مشابه استفاده میکند.
مزایای این روش:
- توضیحپذیری مناسب
- امکان پیشنهاد براساس ویژگیهای محصول
- کاربرد برای آیتمهای جدید
- نیاز کمتر به رفتار کاربران دیگر
محدودیت اصلی این است که پیشنهادها ممکن است بیش از حد شبیه علاقههای قبلی باشند و گزینههای متفاوت کشف نشوند.
فیلتر مشارکتی
Collaborative Filtering از الگوهای تعامل میان کاربران و آیتمها استفاده میکند.
ایده ساده آن چنین است:
کاربرانی که رفتار مشابهی داشتهاند، احتمالاً به گزینههای مشابه دیگری نیز علاقه نشان میدهند.
برای مثال:
- کاربر اول محصولات A و B را خریده است.
- کاربر دوم محصولات A و B و C را خریده است.
- سیستم محصول C را به کاربر اول پیشنهاد میدهد.
این روش الزاماً نیاز ندارد تمام ویژگیهای محتوایی محصول بهصورت دستی تعریف شوند. مدل میتواند الگوهای پنهان میان کاربران و آیتمها را از تعاملات یاد بگیرد.
گوگل در راهنمای Collaborative Filtering توضیح میدهد که این روش با استفاده همزمان از شباهت کاربران و آیتمها میتواند گزینههایی فراتر از موارد کاملاً مشابه پیشنهاد دهد.
سیستم پیشنهاددهنده ترکیبی
Hybrid Recommendation چند روش را با یکدیگر ترکیب میکند.
برای مثال:
- پیشنهاد محتوامحور
- فیلتر مشارکتی
- محصولات محبوب
- جستوجوی معنایی
- قواعد کسبوکار
- رتبهبندی با مدل زبانی
بیشتر سیستمهای حرفهای ترکیبی هستند؛ زیرا هیچ روش واحدی برای تمام کاربران و شرایط بهترین نتیجه را ارائه نمیدهد.
سیستم پیشنهاددهنده مبتنی بر Session
Session-Based Recommendation براساس تعاملات همان جلسه کاربر کار میکند.
این روش زمانی مفید است که اطلاعات قبلی زیادی در دسترس نباشد.
برای مثال، کاربر در یک Session این محصولات را مشاهده کرده است:
- دوربین بدون آینه
- لنز پرتره
- سهپایه سبک
سیستم میتواند براساس همین توالی، کیف دوربین یا کارت حافظه مناسب را پیشنهاد دهد.
در آموزش Sequential Retrieval در TensorFlow Recommenders، ترتیب تعاملات قبلی برای پیشبینی آیتم بعدی موردتوجه قرار میگیرد.
سیستم پیشنهاددهنده Context-Aware
در این روش، شرایط فعلی نیز در پیشنهاد اثر میگذارند:
- صفحه فعلی
- زمان
- مکان تقریبی
- دستگاه
- نوع کاربر
- مرحله خرید
- وضعیت موجودی
- فصل
- کمپین جاری
ممکن است یک محصول در صفحه اصلی انتخاب مناسبی باشد، اما در سبد خرید بهتر باشد مکمل محصول دیگری نمایش داده شود.
سیستم پیشنهاددهنده مکالمهای
Conversational Recommendation به کاربر اجازه میدهد نیاز خود را با زبان طبیعی توضیح دهد.
مثال:
برای هدیه تولد یک نوجوان علاقهمند به نقاشی، محصولی تا سه میلیون تومان پیشنهاد بده.
سیستم مکالمهای میتواند:
- هدف را تشخیص دهد.
- سؤال تکمیلی بپرسد.
- محدودیتها را استخراج کند.
- کاتالوگ واقعی را جستوجو کند.
- چند گزینه را مقایسه کند.
- دلیل هر پیشنهاد را توضیح دهد.
- براساس بازخورد کاربر پیشنهادها را اصلاح کند.
این نوع سیستمها از ترکیب موتور پیشنهاددهنده، مدل زبانی، جستوجو و قواعد کسبوکار ساخته میشوند.
سیستم پیشنهاددهنده مولد چیست؟
Generative Recommendation رویکرد جدیدتری است که از مدلهای زبانی و مدلهای مولد در بخشهای مختلف سیستم پیشنهاددهنده استفاده میکند.
مدل مولد میتواند در این وظایف کمک کند:
- فهم درخواست طبیعی کاربر
- استخراج ویژگیهای موردنیاز
- ساخت پروفایل متنی از نیاز
- غنیسازی توضیحات آیتمها
- تولید داده آموزشی
- رتبهبندی مجدد نامزدها
- توضیح دلیل پیشنهاد
- ساخت پاسخ مکالمهای
- دریافت بازخورد و اصلاح نتایج
مدل زبانی نباید فهرست محصولات را از حافظه خود ایجاد کند. محصولات، قیمت، موجودی و مشخصات قطعی باید از کاتالوگ واقعی دریافت شوند.
معماری مناسب:
درخواست کاربر
↓
تحلیل نیاز با مدل هوش مصنوعی
↓
استخراج فیلترها و ویژگیها
↓
بازیابی محصولات واقعی از کاتالوگ
↓
رتبهبندی اولیه
↓
بازرتبهبندی نامزدها با مدل
↓
اعمال قواعد کسبوکار
↓
تولید توضیح برای پیشنهادها
در این معماری، مدل زبانی جایگزین کامل Recommendation Engine نیست. مدل بیشتر در درک زبان، رتبهبندی معنایی و توضیح نتایج کمک میکند.
تفاوت سیستم پیشنهاددهنده سنتی و مولد
| ویژگی | پیشنهاددهنده سنتی | پیشنهاددهنده مولد |
|---|---|---|
| ورودی رایج | کلیک، خرید و ویژگیها | داده رفتاری همراه با زبان طبیعی |
| خروجی | فهرست رتبهبندیشده | فهرست همراه با توضیح و گفتوگو |
| درک درخواست پیچیده | محدودتر | مناسبتر |
| سؤال تکمیلی | معمولاً ندارد | قابلپیادهسازی |
| توضیح دلیل پیشنهاد | محدود | تولید متن قابلفهم |
| نیاز به کاتالوگ واقعی | بله | بله |
| اجرای قواعد قطعی | در برنامه | در برنامه |
| نقش مدل زبانی | ندارد یا محدود | تحلیل، رتبهبندی و توضیح |
بهترین معماری در بسیاری از پروژهها، ترکیب سیستم سنتی با مدل مولد است.
کاربرد سیستم پیشنهاددهنده در فروشگاه اینترنتی
پیشنهاد محصولات مشابه
در صفحه محصول، گزینههایی با ویژگی یا کاربرد مشابه نمایش داده میشوند.
محصولات مکمل
سیستم محصولاتی را پیشنهاد میدهد که همراه محصول فعلی کاربرد دارند:
- لپتاپ و کیف
- دوربین و کارت حافظه
- کفش و محصولات نگهداری
- گوشی و قاب
- نرمافزار و افزونه مرتبط
شخصیسازی صفحه اصلی
دستهها و محصولات صفحه اصلی میتوانند براساس علاقهها یا Session فعلی مرتب شوند.
پیشنهاد در سبد خرید
پیش از تکمیل خرید میتوان محصولات مرتبط یا مکمل نمایش داد؛ اما پیشنهاد باید واقعاً با محتوای سبد سازگار باشد.
پیشنهاد جایگزین
اگر محصولی موجود نیست، سیستم میتواند نزدیکترین گزینههای واقعی را براساس ویژگیها پیشنهاد دهد.
راهنمای انتخاب مکالمهای
کاربر نیاز خود را توضیح میدهد و سیستم با چند سؤال کوتاه، گزینهها را محدود میکند.
مقاله هوش مصنوعی در فروشگاه اینترنتی کاربردهای گستردهتر هوش مصنوعی در تجارت الکترونیک را بررسی میکند.
کاربرد سیستم توصیهگر در SaaS و نرمافزارهای سازمانی
سیستم پیشنهاددهنده فقط برای فروشگاه نیست.
پیشنهاد قابلیت بعدی
یک نرمافزار میتواند براساس رفتار کاربر، قابلیت یا گزارش مرتبط را پیشنهاد دهد.
پیشنهاد اقدام بعدی در CRM
سیستم میتواند براساس وضعیت فرصت فروش، چند اقدام قابلبررسی پیشنهاد دهد:
- تماس پیگیری
- ارسال دمو
- تکمیل اطلاعات
- برنامهریزی جلسه
- ارسال پیشنهاد اولیه
تصمیمهای قطعی و قواعد فروش باید در CRM باقی بمانند و مدل نقش پیشنهاددهنده داشته باشد.
پیشنهاد محتوای راهنما
اگر کاربر در بخشی از نرمافزار متوقف شده است، مقاله یا ویدئوی آموزشی مرتبط نمایش داده شود.
پیشنهاد Workflow
براساس نوع تیم و الگوی استفاده، قالب گردشکار مناسب پیشنهاد شود.
پیشنهاد مدل هوش مصنوعی
یک پلتفرم چندمدلی میتواند براساس نوع وظیفه، سرعت موردنیاز و بودجه، چند مدل مناسب را برای آزمایش پیشنهاد دهد.
کاربرد در محتوا و آموزش
پیشنهاد مقاله
براساس موضوع مقاله فعلی، تاریخچه مطالعه و سطح کاربر، مطالب مرتبط پیشنهاد میشوند.
پیشنهاد ویدئو
سیستم میتواند ادامه یک مجموعه یا ویدئوهای مرتبط با موضوع فعلی را نمایش دهد.
پیشنهاد مسیر یادگیری
در یک پلتفرم آموزشی، درس بعدی میتواند براساس این عوامل پیشنهاد شود:
- دورههای تکمیلشده
- سطح فعلی
- نتیجه آزمون
- هدف آموزشی
- زمان در دسترس
- پیشنیازها
پیشنهاد تمرین
سیستم میتواند تمرین متناسب با نقاط ضعف یا مباحث اخیر پیشنهاد دهد.
چالش شروع سرد چیست؟
Cold Start زمانی رخ میدهد که اطلاعات کافی درباره کاربر یا آیتم جدید وجود ندارد.
کاربر جدید
سیستم هنوز نمیداند کاربر به چه چیزهایی علاقه دارد.
راهکارهای قابلاستفاده:
- نمایش گزینههای محبوب
- پرسیدن چند ترجیح اولیه
- استفاده از Query فعلی
- استفاده از رفتار همان Session
- ارائه دستهبندیهای قابلانتخاب
محصول جدید
هنوز هیچ کلیک، خرید یا امتیازی برای محصول ثبت نشده است.
در این شرایط میتوان از ویژگیهای محصول استفاده کرد:
- عنوان
- دسته
- توضیحات
- برند
- ویژگیها
- کاربرد
- تصویر
- Embedding
روش محتوامحور میتواند محصول جدید را پیش از جمعشدن داده رفتاری وارد پیشنهادها کند.
Embedding چه نقشی در سیستم پیشنهاددهنده دارد؟
Embedding آیتمها و نیاز کاربران را به نمایش برداری تبدیل میکند تا سیستم بتواند شباهت معنایی را بررسی کند.
برای مثال، عبارت زیر:
لپتاپ سبک برای برنامهنویسی و حمل روزانه
میتواند با محصولاتی تطبیق داده شود که در توضیحات آنها دقیقاً همین عبارت نوشته نشده، اما ویژگیهای مرتبط دارند.
Embedding در بخشهای زیر کاربرد دارد:
- بازیابی نامزدها
- یافتن آیتم مشابه
- تطبیق Query و محصول
- پیشنهاد محتوای مرتبط
- ساخت سیستم ترکیبی
- جستوجوی معنایی
گوگل در راهنمای بازیابی برای سیستمهای پیشنهاددهنده توضیح میدهد که Embeddingها میتوانند برای پیدا کردن آیتمهای نزدیک به ترجیح کاربر یا آیتم فعلی استفاده شوند.
برای آشنایی کاملتر میتوانید مقاله Embedding چیست؟ را مطالعه کنید.
معماری پیشنهادی برای سیستم پیشنهاد محصول
یک معماری کاربردی میتواند از این بخشها تشکیل شود:
کاتالوگ محصولات
+
تعاملات کاربران
+
Context فعلی
↓
Candidate Generation
↓
Scoring
↓
LLM Re-ranking
↓
قواعد کسبوکار
↓
پیشنهادهای نهایی
↓
ثبت بازخورد
کاتالوگ
اطلاعات واقعی محصولات را نگه میدارد:
- Product ID
- عنوان
- دستهبندی
- ویژگیها
- توضیحات
- موجودی
- قیمت
- وضعیت انتشار
Event Store
تعاملات کاربران را ثبت میکند:
- نمایش
- کلیک
- افزودن به سبد
- خرید
- حذف از سبد
- ذخیره محصول
- مدت مشاهده
- جستوجو
Candidate Generator
چند منبع مختلف میتواند نامزد تولید کند:
- محصولات محبوب
- محصولات مشابه
- جستوجوی معنایی
- فیلتر مشارکتی
- Session فعلی
- دسته موردعلاقه
Ranker
نامزدها را براساس احتمال ارتباط با کاربر مرتب میکند.
LLM Layer
مدل زبانی میتواند درخواست طبیعی را تحلیل، گزینههای محدود را دوباره رتبهبندی و دلیل پیشنهاد را تولید کند.
Business Rules
قواعد قطعی در این مرحله اجرا میشوند:
- حذف محصول ناموجود
- رعایت محدوده قیمت
- کنترل دستهبندی
- محدودکردن تعداد نتایج
- حفظ تنوع
- اولویتدادن به گزینههای قابلعرضه
آموزش ساخت پیشنهاددهنده محصول با Python و API درواره
در این مثال، فرض میکنیم سیستم فروشگاه قبلاً چند محصول واقعی را از پایگاه داده بازیابی کرده است.
مدل هوش مصنوعی فقط همین نامزدها را رتبهبندی میکند و اجازه ندارد محصول جدیدی ایجاد کند.
نصب کتابخانه
pip install openai
تنظیم متغیرهای محیطی
export DARVAREH_API_KEY="YOUR_API_KEY"
export DARVAREH_MODEL_ID="YOUR_MODEL_ID"
Model ID را از فهرست فعلی مدلهای درواره انتخاب کنید. مدلی مناسب است که در درک فارسی و تولید JSON عملکرد قابلقبولی داشته باشد.
تعریف نامزدهای واقعی
PRODUCTS = [
{
"id": "p-101",
"name": "فروشیار پایه",
"team_size": "1-10",
"features": [
"مدیریت سرنخ",
"پیگیری فروش",
"گزارش ساده"
],
"price_level": "economic"
},
{
"id": "p-102",
"name": "فروشیار حرفهای",
"team_size": "10-50",
"features": [
"اتوماسیون فروش",
"گزارش پیشرفته",
"مدیریت چند تیم"
],
"price_level": "professional"
},
{
"id": "p-103",
"name": "پاسخیار",
"team_size": "1-20",
"features": [
"مدیریت تیکت",
"پایگاه دانش",
"گزارش پشتیبانی"
],
"price_level": "economic"
}
]
در پروژه واقعی، این اطلاعات باید از پایگاه داده، موتور جستوجو یا Candidate Generator دریافت شوند.
ارسال درخواست به API درواره
import json
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["DARVAREH_API_KEY"],
base_url="https://api.darvareh.ir/v1"
)
MODEL_ID = os.environ["DARVAREH_MODEL_ID"]
def recommend_products(
user_request: str,
candidates: list,
limit: int = 3
) -> list:
prompt = {
"task": "rank_product_candidates",
"user_request": user_request,
"rules": [
"فقط از محصولات موجود در candidates استفاده کن.",
"شناسه محصول جدید تولید نکن.",
"حداکثر سه محصول پیشنهاد بده.",
"برای هر پیشنهاد دلیل کوتاه فارسی بنویس.",
"خروجی فقط JSON معتبر باشد."
],
"output_schema": {
"recommendations": [
{
"product_id": "string",
"reason": "string"
}
]
},
"candidates": candidates
}
response = client.chat.completions.create(
model=MODEL_ID,
temperature=0,
messages=[
{
"role": "system",
"content": (
"شما محصولات واقعی را براساس نیاز کاربر "
"رتبهبندی میکنید. فقط JSON معتبر برگردانید."
)
},
{
"role": "user",
"content": json.dumps(
prompt,
ensure_ascii=False
)
}
]
)
content = response.choices[0].message.content
result = json.loads(content)
allowed_ids = {
product["id"]
for product in candidates
}
validated = []
for item in result.get("recommendations", []):
product_id = item.get("product_id")
reason = item.get("reason")
if product_id not in allowed_ids:
continue
if not isinstance(reason, str) or not reason.strip():
continue
validated.append(
{
"product_id": product_id,
"reason": reason.strip()
}
)
if len(validated) >= limit:
break
return validated
اجرای مثال
user_request = """
برای یک تیم فروش پنجنفره نرمافزاری میخواهم
که مدیریت سرنخ و گزارش ساده داشته باشد.
قیمت اقتصادی برای ما مهم است.
"""
recommendations = recommend_products(
user_request=user_request,
candidates=PRODUCTS
)
print(
json.dumps(
recommendations,
ensure_ascii=False,
indent=2
)
)
چرا قبل از مدل، نامزدها را بازیابی میکنیم؟
ارسال کل کاتالوگ به مدل روش مناسبی نیست.
Candidate Generation قبل از فراخوانی مدل چند مزیت دارد:
- ورودی مدل کوچکتر میشود.
- مصرف API کاهش پیدا میکند.
- زمان پاسخ کوتاهتر میشود.
- محصولات نامرتبط زودتر حذف میشوند.
- مدل فقط گزینههای واقعی را میبیند.
- اعتبارسنجی Product ID سادهتر میشود.
- کنترل موجودی و قیمت در برنامه باقی میماند.
برای کاتالوگ کوچک میتوان از Query پایگاه داده استفاده کرد. برای کاتالوگ بزرگتر میتوان جستوجوی متنی، جستوجوی برداری یا مدل Retrieval اختصاصی به کار گرفت.
نقش مدل زبانی در این نمونه چیست؟
در کد بالا، مدل این وظایف را انجام میدهد:
- فهم نیاز فارسی کاربر
- مقایسه ویژگی نامزدها
- رتبهبندی گزینهها
- تولید دلیل کوتاه
- برگرداندن نتیجه ساختاریافته
مدل این وظایف را انجام نمیدهد:
- ساخت محصول جدید
- تعیین موجودی
- تغییر قیمت
- دریافت اطلاعات از پایگاه داده
- اجرای قواعد قطعی فروشگاه
- ثبت سفارش
این جداسازی باعث میشود پیشنهادها به کاتالوگ واقعی متصل باقی بمانند.
افزودن گفتوگو به سیستم پیشنهاددهنده
اگر درخواست کاربر کامل نیست، سیستم میتواند پیش از پیشنهاد سؤال کوتاهی بپرسد.
مثال:
کاربر:
برای تیمم یک CRM میخواهم.
سیستم:
تیم شما چند نفر است و گزارشگیری پیشرفته نیاز دارید یا ساده؟
کاربر:
پنج نفر هستیم و گزارش ساده کافی است.
سیستم:
سه گزینه مناسب را از کاتالوگ بررسی میکنم.
برای پیادهسازی این رفتار میتوان ابتدا اطلاعات موردنیاز را بهصورت ساختاریافته استخراج کرد:
{
  "team_size": 5,
  "required_features": [
    "مدیریت سرنخ",
    "گزارش ساده"
  ],
  "price_preference": "economic",
  "missing_fields": []
}
اگر missing_fields خالی نباشد، برنامه سؤال تکمیلی تولید میکند. در غیر این صورت، مرحله بازیابی محصول اجرا میشود.
استفاده از TensorFlow Recommenders
برای پروژههایی که داده رفتاری کافی دارند، میتوان مدل Retrieval و Ranking اختصاصی آموزش داد.
TensorFlow Recommenders یک کتابخانه متنباز برای ساخت سیستمهای پیشنهاددهنده است و بخشهایی مانند آمادهسازی داده، آموزش، ارزیابی و استقرار مدل را پوشش میدهد.
این کتابخانه برای پروژههایی مناسب است که:
- تعداد کاربران و آیتمها زیاد است؛
- تعاملات کافی ثبت شدهاند؛
- تیم داده و یادگیری ماشین وجود دارد؛
- مدل اختصاصی Retrieval یا Ranking نیاز است.
برای پروژه کوچک یا MVP، همیشه لازم نیست از ابتدا مدل Recommendation جداگانه آموزش دهید. میتوان با ترکیب موارد زیر شروع کرد:
- قواعد ساده
- محصولات محبوب
- جستوجوی معنایی
- فیلتر ویژگیها
- بازرتبهبندی با مدل زبانی
- ثبت بازخورد کاربران
سپس با افزایش داده و استفاده واقعی، معماری را توسعه داد.
چگونه کیفیت سیستم پیشنهاددهنده را ارزیابی کنیم؟
کیفیت یک پیشنهاددهنده فقط با مشاهده چند پیشنهاد ظاهراً مناسب مشخص نمیشود.
نرخ کلیک
چه درصدی از پیشنهادهای نمایشدادهشده کلیک میشوند؟
نرخ تبدیل
چه تعداد از تعاملات با پیشنهاد به اقدام مطلوب مانند خرید، ثبتنام یا مشاهده کامل منجر میشوند؟
افزودن به سبد
کاربران چند بار محصول پیشنهادی را به سبد اضافه میکنند؟
ارزش سبد خرید
آیا پیشنهادهای مکمل به افزایش ارزش واقعی خرید کمک کردهاند؟
پوشش کاتالوگ
سیستم چه بخشی از محصولات را در پیشنهادها نمایش میدهد؟ اگر همیشه چند محصول یکسان پیشنهاد شوند، بخش بزرگی از کاتالوگ دیده نخواهد شد.
تنوع
آیا پیشنهادها بیش از حد شبیه یکدیگر هستند یا انتخابهای متفاوت و معناداری ارائه میدهند؟
تازگی
آیا کاربران گزینههایی را میبینند که قبلاً با آنها تعامل نداشتهاند؟
کیفیت توضیح
آیا دلیل پیشنهاد واقعاً با نیاز کاربر و ویژگی محصول مطابقت دارد؟
زمان پاسخ
آیا پیشنهادها با سرعت مناسب نمایش داده میشوند؟
هزینه هر درخواست
فراخوانی مدل، جستوجو و رتبهبندی برای هر درخواست چه میزان هزینه ایجاد میکنند؟
ارزیابی آفلاین با داده تاریخی مفید است، اما آزمایش روی رفتار واقعی کاربران نیز اهمیت دارد.
چگونه سیستم پیشنهاددهنده را مرحلهای بسازیم؟
مرحله اول: تعیین هدف
مشخص کنید سیستم قرار است چه چیزی را بهبود دهد:
- کشف محصول
- کلیک
- خرید
- مشاهده محتوا
- تکمیل دوره
- استفاده از قابلیت نرمافزار
- بازگشت کاربر
مرحله دوم: انتخاب محل نمایش
پیشنهادها در کجا نمایش داده میشوند؟
- صفحه اصلی
- صفحه محصول
- سبد خرید
- نتایج جستوجو
- داشبورد
- پایان مقاله
- صفحه دوره
- چتبات
مرحله سوم: ثبت تعاملات
رویدادهای موردنیاز را با ساختار مشخص ثبت کنید.
مرحله چهارم: ساخت Baseline
ابتدا یک روش ساده مانند محصولات محبوب یا آیتمهای مشابه ایجاد کنید.
مرحله پنجم: افزودن Candidate Generation
چند منبع برای تولید نامزدها تعریف کنید.
مرحله ششم: رتبهبندی
نامزدها را با قواعد، مدل یادگیری ماشین یا ترکیب آنها مرتب کنید.
مرحله هفتم: افزودن مدل زبانی
مدل را برای درک درخواست، بازرتبهبندی محدود و توضیح پیشنهادها استفاده کنید.
مرحله هشتم: اعتبارسنجی
تمام Product IDها، قیمتها، ویژگیها و موجودی را با کاتالوگ واقعی تطبیق دهید.
مرحله نهم: اندازهگیری
عملکرد روش جدید را با Baseline مقایسه کنید.
مرحله دهم: بهبود تدریجی
منابع Candidate، مدل رتبهبندی، Prompt و قواعد بازرتبهبندی را براساس داده واقعی اصلاح کنید.
اشتباهات رایج در ساخت سیستم پیشنهاددهنده
شروع با معماری بسیار پیچیده
اگر محصول هنوز داده رفتاری کافی ندارد، ساخت مدل مشارکتی بزرگ نتیجه مناسبی ایجاد نمیکند. ابتدا با روشهای ساده شروع کنید.
استفاده از مدل زبانی بهعنوان کاتالوگ
مدل نباید نام، قیمت یا موجودی محصولات را از حافظه خود تولید کند.
ارسال تمام محصولات به مدل
ابتدا نامزدهای مرتبط را بازیابی و سپس تعداد محدودی را برای رتبهبندی ارسال کنید.
بهینهسازی فقط برای کلیک
پیشنهاد جذاب الزاماً به رضایت، خرید یا استفاده مفید منجر نمیشود. معیارها باید با هدف واقعی محصول هماهنگ باشند.
نمایش گزینههای بیش از حد مشابه
نتایج باید هم مرتبط و هم دارای تنوع مفید باشند.
نادیدهگرفتن کاربر جدید
برای کاربر بدون سابقه، راهبردهایی مانند محبوبترینها، Session فعلی و پرسش مستقیم درباره ترجیحها لازم است.
مخلوطکردن پیشنهاد و تبلیغ
اگر ترتیب نتایج براساس قرارداد تجاری یا کمپین تغییر میکند، این منطق باید از امتیاز ارتباط کاربر جدا و بهصورت شفاف در معماری تعریف شود.
ارزیابی با داده غیرواقعی
سیستم را با Queryها، محصولات و رفتارهای واقعی همان کسبوکار آزمایش کنید.
چرا API درواره برای سیستم پیشنهاددهنده مناسب است؟
یک سیستم پیشنهاددهنده مدرن ممکن است برای وظایف مختلف به چند مدل نیاز داشته باشد:
- مدل متنی برای فهم درخواست فارسی
- مدل Embedding برای بازیابی معنایی
- مدل قویتر برای بازرتبهبندی
- مدل چندوجهی برای تحلیل تصویر محصول
- مدل سریع برای پردازش پرتعداد
- مدل زبانی برای توضیح پیشنهاد
درواره یک API یکپارچه و سازگار با OpenAI ارائه میکند که امکان اتصال نرمافزار به مدلهای مختلف را سادهتر میسازد.
Base URL:
https://api.darvareh.ir/v1
مزایای این معماری:
- یک API برای مدلهای مختلف
- پرداخت ریالی
- امکان آزمایش چند مدل
- انتخاب مدل متناسب با هر مرحله
- مدیریت متمرکز مصرف
- کاهش وابستگی برنامه به یک مدل خاص
- اتصال به Python، JavaScript و ابزارهای سازگار
درواره خود کاتالوگ فروشگاهی یا Recommendation Engine آماده نیست. این پلتفرم لایه دسترسی به مدلهای هوش مصنوعی را فراهم میکند و باید به پایگاه داده، موتور جستوجو و منطق نرمافزار شما متصل شود.
برای شروع، در درواره ثبتنام کنید، API Key بسازید و Model ID مناسب هر وظیفه را از فهرست فعلی مدلها انتخاب کنید.
پرسشهای متداول
سیستم پیشنهاددهنده چیست؟
سیستم پیشنهاددهنده نرمافزاری است که از میان مجموعهای از محصولات، محتوا یا گزینهها، موارد مرتبطتر را برای کاربر انتخاب و رتبهبندی میکند.
سیستم توصیهگر چگونه کار میکند؟
معمولاً ابتدا تعدادی نامزد مرتبط پیدا میشوند، سپس نامزدها امتیازدهی و رتبهبندی میشوند و در مرحله آخر قواعد تکمیلی روی نتایج اعمال میشوند.
تفاوت سیستم پیشنهاددهنده و جستوجو چیست؟
جستوجو با Query مستقیم کاربر آغاز میشود، اما پیشنهاددهنده میتواند براساس کاربر، آیتم فعلی یا Context، بدون Query صریح نیز گزینه نمایش دهد.
فیلتر مشارکتی چیست؟
روشی است که از الگوهای تعامل کاربران و آیتمها استفاده میکند. اگر کاربران مشابه به آیتمهای مشابه علاقه نشان دهند، سیستم میتواند از این الگو برای پیشنهاد گزینههای دیگر استفاده کند.
سیستم پیشنهاددهنده محتوامحور چیست؟
این روش براساس ویژگی آیتمهایی که کاربر قبلاً پسندیده یا مشاهده کرده است، گزینههای مشابه را پیشنهاد میدهد.
آیا میتوان با مدل زبانی سیستم پیشنهاددهنده ساخت؟
بله، اما مدل زبانی بهتر است در کنار کاتالوگ، موتور بازیابی و قواعد کسبوکار استفاده شود. مدل میتواند نیاز را بفهمد، نامزدها را رتبهبندی و دلیل پیشنهاد را تولید کند.
آیا مدل هوش مصنوعی میتواند قیمت محصول را پیشنهاد دهد؟
قیمت قطعی باید از کاتالوگ یا پایگاه داده دریافت شود. مدل میتواند قیمتهای واقعی دریافتشده را مقایسه کند، اما نباید قیمت جدیدی از حافظه خود بسازد.
برای شروع به داده زیاد نیاز داریم؟
برای روشهای مشارکتی و مدلهای اختصاصی، داده رفتاری اهمیت دارد. اما میتوان نسخه اولیه را با محصولات محبوب، ویژگی آیتمها، Session فعلی و مدل زبانی ساخت.
Embedding در سیستم پیشنهاددهنده چه کاربردی دارد؟
Embedding برای یافتن آیتمهای مشابه، تطبیق درخواست طبیعی با محصولات و تولید نامزدهای معنایی استفاده میشود.
آیا API درواره برای پیشنهاد محصول قابلاستفاده است؟
بله. میتوانید از مدلهای متنی یا چندوجهی موجود در درواره برای فهم درخواست، استخراج ویژگی، بازرتبهبندی و توضیح پیشنهادها استفاده کنید.
جمعبندی
سیستم پیشنهاددهنده به کاربران کمک میکند از میان تعداد زیادی گزینه، محصولات یا محتوای مرتبطتر را کشف کنند.
معماری حرفهای معمولاً شامل این مراحل است:
- دریافت Context کاربر
- تولید نامزدها
- امتیازدهی
- رتبهبندی
- بازرتبهبندی
- اعمال قواعد کسبوکار
- نمایش پیشنهاد
- ثبت بازخورد
روشهای محبوبیتمحور، محتوامحور، مشارکتی، ترکیبی و Session-Based هرکدام برای شرایط متفاوتی مناسب هستند.
مدلهای زبانی نیز میتوانند لایه جدیدی به این معماری اضافه کنند: فهم درخواست طبیعی، رتبهبندی معنایی، گفتوگو با کاربر و توضیح دلیل پیشنهاد.
با استفاده از API درواره میتوانید مدلهای مختلف را از طریق یک API سازگار با OpenAI به سیستم پیشنهاددهنده خود متصل کنید و مدل مناسب هر مرحله را براساس کیفیت، سرعت و هزینه انتخاب کنید.
درواره؛ دسترسی یکپارچه به مدلهای هوش مصنوعی.
مقالات مرتبط
- Agentic Commerce چیست؟
- هوش مصنوعی در فروشگاه اینترنتی
- تولید توضیحات محصول با هوش مصنوعی
- Embedding چیست؟
- جستوجوی معنایی چیست؟
- Reranking چیست؟
- Structured Outputs چیست؟
- اتوماسیون هوش مصنوعی چیست؟
- API سازگار با OpenAI چیست؟
منابع
- Google for Developers: Recommendation Systems
- Google: Recommendation Systems Overview
- Google: Content-Based Filtering
- Google: Collaborative Filtering
- Google: Retrieval in Recommendation Systems
- TensorFlow Recommenders
- TensorFlow: Sequential Retrieval
- GR-LLMs: Generative Recommendation with Large Language Models
- مستندات API سازگار با OpenAI درواره
این مقاله صرفاً با هدف آموزش و اطلاعرسانی تهیه شده است. پیش از استفاده عملی، مستندات رسمی سرویسها و صفحه سلب مسئولیت را مطالعه کنید.